ViMax:13 个 Agent 从一句想法排到成片,默认配置一天只放你生成 10 段视频
今天拆的是 ViMax:一个自己造 Agent runtime、让 13 个专职 Agent 把一句想法推到多镜头成片的开源框架;文章给全它在链条上的层级、四条上手路径、十处已知阻塞,以及那笔按秒计费的模型账。

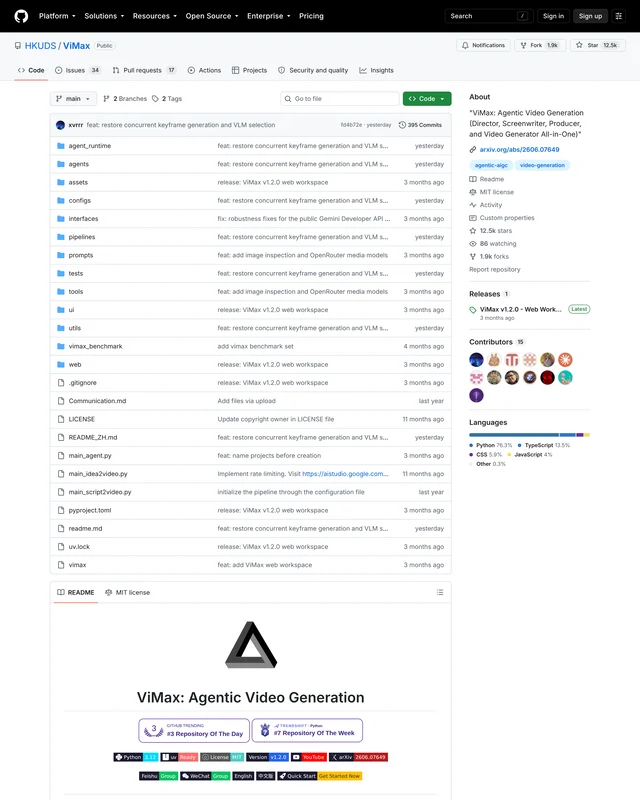
香港大学数据智能实验室(HKUDS)的 ViMax 是这批方案里少见的另一种形状:它不接你的编码 Agent,也不负责渲染,它自己造了一套 Agent runtime,坐在图像模型和视频模型上面,把一句想法或一份剧本直接推到成片。1 2026-10-02 查时 12,542 star / 1,897 fork / 86 watching / 395 次提交,2 个分支、2 个 tag、1 个 release、15 位贡献者,MIT 许可,Python 3.12,主分支最后一次推送是 2026-09-30 22:35(UTC+08)。2
唯一的 release 是 v1.2.0,落在 2026-07-20 19:57(UTC+08),那一版加的是浏览器工作台。3 它还有一份技术报告:6 月 2 日投上 arXiv,7 月 21 日更新到第二版,20 页 13 张图,6 位署名作者。4
它在链条上站在哪一层
把前几期拆过的方案按层摆一遍:HyperFrames 和 Remotion 是渲染底座,负责把一份工程拍成 mp4;hypit 是工作流描述语言;OpenChatCut 和 Diffusion Studio 是编辑器;Toonflow 是画布工作台;video-shotcraft 是装进编码 Agent 的技能包。ViMax 不在这几层里。它自己造了一套 Agent runtime,坐在生成模型上面——它不渲染、不剪片、不管字幕,它管的是「谁来决定下一个镜头长什么样」。
那套 runtime 在
agent_runtime/ 目录里:一个 agent loop、一个工具注册表、一个会话索引、一个上下文压缩器,外加一个 4.7 万字节的适配层。5内置工具是十二件通用件加三件领域件。通用件是
read_file、read_json、write_json、list_files、glob_files、search_text、view_image、memory_read、memory_write、todo_read、todo_write、sleep;领域件只有三个:叙事规划 vimax_narrative_planning、小说规划 vimax_novel_planning、出片 vimax_render_video。67这份清单值得多看一眼:读写文件、搜文本、记 todo、看图片,然后是三个领域工具——这正是编码 Agent 那一套 loop 的复刻。区别在于它默认不许执行 shell 命令,要打开
VIMAX_ENABLE_RUN_SHELL=1 才放行,放行之后还会拦危险命令、限时、截断输出。6三个入口通到同一套 runtime:命令行 TUI、浏览器工作台,以及两个不经过 Agent 的直跑脚本。8
它下面压着的是模型,而且是三类分开配:一个对话模型、一个图像生成器、一个视频生成器。随包的适配器一共九个文件——图像四个、视频五个,另有一个给检索用的重排器。9 默认那份配置挑的是 OpenRouter 上的
google/gemini-2.5-flash-lite-preview-09-2025 当对话模型,Google 的 nanobanana 出图,Google 的 Veo 出视频。10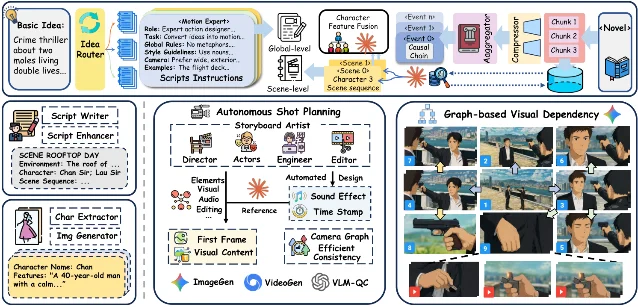
它在这一层怎么做事
agents/ 目录下是 13 个 Agent 实现,一个文件一个:script_planner(2.6 万字节,最大的一块)、storyboard_artist(1.9 万)、global_information_planner(1.8 万)、reference_image_selector(1.6 万)、camera_image_generator(1.4 万)、screenwriter(1 万),加上 script_enhancer、character_extractor、character_portraits_generator、scene_extractor、event_extractor、novel_compressor、best_image_selector。11论文把其中三条机制写得很具体,这也是它跟「把提示词串起来」的项目最不一样的地方:4
- 叙事规划分三层拆。 故事先按事件、场景、镜头递归分解,每拆一层都回原文做一次检索,把局部描述补上全局上下文。论文自己给的理由是,直接让模型一次性排几十上百个镜头超出它的推理能力,而拆完之后局部会丢掉人物动机这类信息,所以用 RAG 补回来。
- 视觉一致性靠一张机位依赖图。 镜头先按机位归组,机位之间连成依赖图,生成时按拓扑顺序走:依赖已经满足的机位并发生成,有依赖的机位带上游传下来的视觉锚点。同一个场景里不同机位的空间关系,用「先生成一段转场视频、再把两端视角取出来」的办法对齐。
- 质检是 best-of-k。 每个任务并发生成 k 个候选,交给一个视觉模型按画面质量、叙事一致性、镜头规格三项打分,最高分的那个进下一步。配置里那个
image_selection.num_candidates就是它的开关。
三条产线摆在
pipelines/ 下:idea2video_pipeline.py(1.2 万字节)、script2video_pipeline.py(5.5 万)、novel2movie_pipeline.py(5.5 万)。12 随包的基准 vimax_benchmark/ 有 35 个故事,分成 A、B、C 三类,一个故事一份 JSON。13它公开的成绩全部来自这份报告和这个自建基准,不是第三方复现:在 ViMax-Bench 上,用 Gemini-3-Pro 配 Veo 3.1 的那一档把整体一致性(GC)从 HoloCine 的 0.5272 拉到 0.5571;小说到视频的叙事规划一项,平均分从 AniMaker 的 3.827 拉到 4.107。4 这两组数字只能当方向看,理由写在下面成本那一节里。
你要给什么,它交回什么
| 你提供 | 它交回 |
|---|---|
| 一台 Linux 或 Windows 的机器,Python 3.12 加 uv;README 的环境那一栏只写了这两个系统8 | 一套留在本地的工程:剧本、分镜、角色、关键帧、逐镜片段和中间产物都落在 .working_dir 下 |
| 三类模型的接口和 Key——一个支持视觉输入的对话模型、一个图像生成器、一个视频生成器10 | 从一句想法、一份剧本或一部长篇推出来的一条多镜头成片 |
| 一个你选得出来的视频模型;要成片有声音,就得选同时能生成音频的那一个14 | 按机位依赖顺序生成的镜头,依赖已满足的那部分并发生成4 |
| 自己写一个 provider 类,或者从随包那九个适配器里挑一个9 | 每个镜头两三张候选关键帧,由视觉模型打分挑一张进下一步10 |
| 时间:默认配置下视频一天只放 10 次,长片要按天排10 | 可以续跑的会话、可以逐份检查的文本产物,和一套 35 个故事的自带基准13 |
最短上手路径
第一步,装环境。 它没有上 PyPI,
pyproject.toml 里的包名还是历史上的 autolongvideogeneration,版本 1.2.0,要求 Python 3.12 以上;15 所以只有源码一条路:git clone https://github.com/HKUDS/ViMax.git
cd ViMax
uv sync第二步,填三类模型。 从模板复制一份本地配置,然后填三段:
cp configs/agent.example.yaml configs/agent.local.yamlllm、image、video 三段各要 model、base_url、api_key;不写文件也行,用 VIMAX_LLM_API_KEY、VIMAX_IMAGE_API_KEY、VIMAX_VIDEO_API_KEY 三个环境变量代替。816第三步,起界面。 TUI 走仓库根目录那个脚本,它需要先装一次前端依赖,因为它用
tsx 起界面;17cd ui && npm install && cd ..
./vimax tui第四步,或者干脆绕过 Agent。 想让它按一份固定配置直跑,改完
configs/idea2video.yaml 之后跑 python main_idea2video.py 就行,main_script2video.py 同理。8按钱排的验收顺序。 先让它只出文本产物(剧本、分镜表),这一步只花对话模型的钱;确认通了,再让它渲一张关键帧,确认图像模型通;最后才让它渲片段——视频那一档每一次都最贵,也是默认限额卡住你的那一步。10
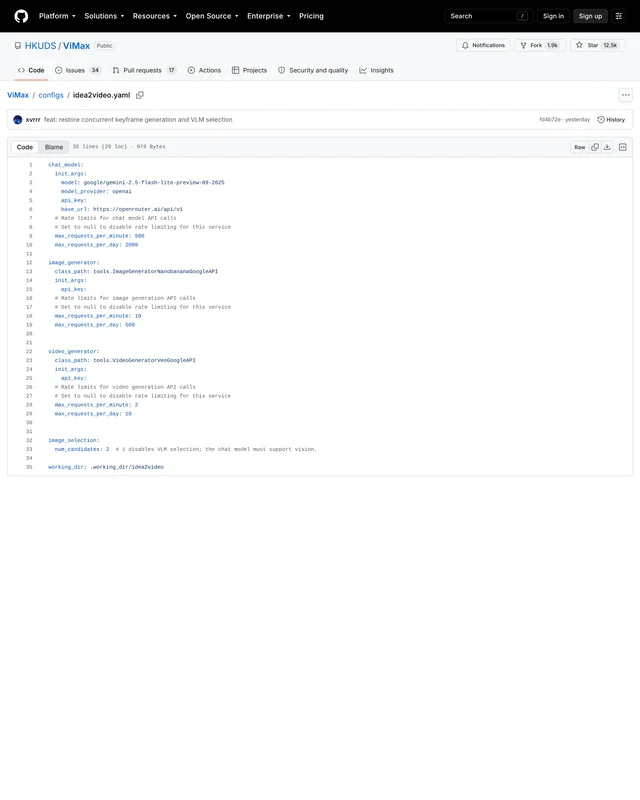
configs/idea2video.yaml 文件页,2026-10-02 采集:对话模型 500 次/分钟、2000 次/天,图像生成器 10 次/分钟、500 次/天,视频生成器 2 次/分钟、10 次/天;每一条下面都注着「设为 null 可关闭本服务的限流」,第 33 行的 image_selection: 2 是候选关键帧的张数。10会卡住的地方
模型不是随便换的。 症状是想把对话、图像、视频三样换成别家的,发现配置里填的是类路径。触发条件是你的模型不在随包那九个适配器里。
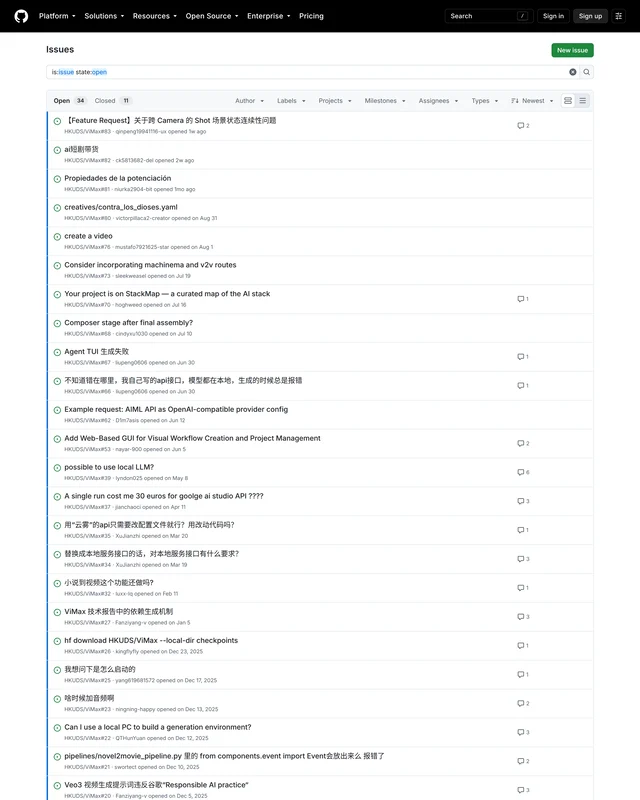
image_generator 与 video_generator 在 YAML 里写的是 class_path: tools.ImageGeneratorNanobananaGoogleAPI 这种形式,换供应商就是换一个类。10 #9 在 2025-11-20 15:41(UTC+08)提交、至今未关闭,问的就是「图像和视频生成模型必须使用 Google 的 nano-banana 和 veo3 吗」,维护方当天回「可以自定义使用其他图像/视频生成模型(eg. doubao / wan / sora2),openrouter 目前只能支持 nanobanana 跟 LLM 配置」。19 你能做的:先翻 tools/__init__.py 看有没有你要的那一家,没有就照现有类的样子写一个;这一层不是「填一个 OpenAI 兼容地址」就能接上的。默认配置一天只放你生成 10 段视频。 症状是一部几十个镜头的片子跑到第十段就停下。触发条件是用随包那份默认配置。三条上限写在文件里:对话 2000 次/天、图像 500 次/天、视频 10 次/天。10 #11 在 2025-11-20 20:19(UTC+08)提交,用户要求「增加一个配置项,对于免费用户,增加延迟请求的配置,不然很容易触发限速,只能去满世界改源码了」,维护方当时答「稍后我们可以添加一下」,帖子里此后没有下文。20 你能做的:把视频那两条调高或者设成 null,代价是限流这件事回到你身上。
钱没有护栏。 症状是一次跑完发现账单远超预期。触发条件是把长故事整条交给它跑、中途不设出口。#37 在 2026-04-11 21:50(UTC+08)提交,标题就是「A single run cost me 30 euros for goolge ai studio API ????」,维护方 2026-05-27 给的做法是「可以从配置里设置
max_requests_per_minute 来控制成本」。21 适用范围要写清楚:那是 2026 年 4 月一个人在某一次运行上的实测,不是标价,也不是平均数。你能做的:先跑短故事、先只出文本和关键帧,用速率上限当闸门。跨机位回不到原来的场景状态。 症状是镜头 7 在机位 1、镜头 9 在机位 2 里把水杯从右边挪到左边,镜头 10 回到机位 1,水杯又出现在右边。触发条件是同一场景里跨机位往返。#83 在 2026-09-22 16:24(UTC+08)提交、开放中,提问者用这个例子问能不能把「机位连续」和「场景状态连续」拆开;维护方 2026-09-25 11:02 回复说这个区分很有启发,「这确实是跨机位生成中值得进一步加强的地方」,并说明目前的设计是在生成效率与一致性之间权衡,同机位参考画面管视角与构图,人物和物体的状态靠相邻镜头的文字描述带。22 你能做的:把同一场景的机位往返当成已知损耗,重要物件的位置写进镜头描述里再生成。
任务状态靠文件,依赖会死锁。 症状是卡住不动,或者读不到上一镜的首帧。触发条件是镜头之间有父 shot 依赖。#18 在 2025-11-24 22:06(UTC+08)提交、开放中,报的是父 shot 指向自己时的死锁;同帖里另一位用户说状态维护强依赖文件、并发下不可靠,「强烈建议弄个 sqlite 之类的」,维护方 2025-11-28 回复「目前此版本是我们生成速度最快的一个版本,还在持续改进测试中,后续我们可能会更新一个更稳定但是更慢一点的版本」。23 你能做的:出错先看
.working_dir 下的中间产物在不在,缺了就从断点续跑,别整条重来。音频不在它手里。 症状是成片是默片,或者只有视频模型自己带的声音。触发条件是你的视频模型不出声。README 的特性表里写着「音视频绑定」(Audio and Video Binding),8 但 #23 在 2025-12-13 10:16(UTC+08)提交、开放中,维护方在那里回的是「目前 repo 需要用能同时生成音频的 video model」。14 两处口径不一致,一并摆出来。你能做的:要人声或者配乐,要么换一个自带音频的视频模型,要么出片之后自己接一条配音。
本地模型和自建接口要自己折腾。 症状是模型都在本地,生成时一直报错。触发条件是自己写了一个接口去接本地模型。#66(2026-06-30 12:49 UTC+08)与 #67(同日 13:17,Agent TUI 生成失败)出自同一位用户,维护方当天回复「我们测试并且修复更新了一下,可以拉取最新版本再试一下」。2425 适用范围:这两条针对的是 2026-06-30 之前的版本,之后是不是还有人报同样的错,帖子里没有。你能做的:先拉最新主分支再排错。
要把编码 Agent 接进来,得自己包一层。 症状是你想找一条
vimax render 这样的 MCP 工具,翻遍仓库没有。触发条件是你打算让 Claude Code 或 Codex 直接驱动它。仓库里没有任何 MCP 服务端,README 的路线图里「Skill-based workflow extensions」还停在未勾选状态。8 现成能用的只有那三个领域工具 vimax_narrative_planning、vimax_novel_planning、vimax_render_video,要桥接得自己包。7 你能做的:接受自己写这层桥,或者先去看第 6 期的 OpenStoryline、第 16 期的 OpenChatCut 这类自带 MCP 的方案。平台只写了 Linux 和 Windows,也没有容器。 症状是在 Mac 上照着文档装。触发条件是你用的是 macOS。README 的环境那一栏只写了「OS: Linux, Windows」;8 仓库里没有 Dockerfile,也没有 CI 配置,社区提的 PR #64 才在申请加一条跑 lint 与测试的 workflow,还挂着没合。26 你能做的:Mac 上别按官方路径假设,先看 issue 里有没有人跑通过再动手。
版本号追不上主分支。 症状是你想要的能力在任何 release 里都没有。触发条件是你只看 v1.2.0。主分支 395 次提交、最后一次推送在 2026-09-30,而唯一的 release 停在 2026-07-20。23 你能做的:跟着主分支走,并接受它没有发布节奏这件事。
许可与真实成本
仓库根目录是 MIT,全文 21 行,署名那一行写的是「Copyright (c) 2025」,没有写主体名字。28 商用、自部署、改成自己的产品都不设门槛,这一点比第 15 期 hypit 那份「改过的 Apache-2.0」干净。
软件不要钱,钱全在模型上,其中视频那一档是绝对大头。官方单价可以对齐:Veo 3.1 标准档每秒 0.40 美元(720p 与 1080p,默认带音频),Fast 档每秒 0.10 美元,Lite 档每秒 0.05 美元;图像那边,Nano Banana 2 生成一张 1K 图约 0.067 美元。29 按这个价算,一分钟的成片,视频段走标准档 1080p 是 24 美元,换 Fast 档 720p 是 6 美元;图像那一层,一部片几十张关键帧加起来是几美元量级;对话模型(默认
gemini-2.5-flash-lite)占的比例很小。1029上面那笔账还只是「一段视频只生成一次」。ViMax 默认每个镜头并发生成 2 张候选关键帧交给视觉模型挑一张,
image_selection.num_candidates 设成 1 才关掉;10 报告里那套 best-of-k 是同一件事的放大版。4 多镜头、重渲、候选,在这里都是乘法。还有一个口径要分清:报告里的成绩来自它自己挑的最强组合(Gemini-3-Pro 配 Veo 3.1,另外两档是 Gemini-3.1-Flash 与 Wan2.2),4 而随包那份默认配置给的是
gemini-2.5-flash-lite 加 nanobanana 加 Veo,10 两者不是同一套东西。真实账单长什么样,能查到的是一条个人记录:#37 那次「单次 30 欧」。21 这条只能当量级参考,它不是标价,也不是平均数。和之前几期放在一起看
| 方案 | 你给它什么 | 它给你什么 | 它在这一层 | 许可与公开体量 |
|---|---|---|---|---|
| ViMax | 三类模型接口、一个工程目录、按天排的时间 | 从想法或剧本推到多镜头成片的一条产线 | 自带 Agent runtime 的多 Agent 编排 | MIT,12,542 star1 |
| Toonflow(第 17 期) | 一台机器、四类模型 Key、逐段授权 | 一张可继续编辑的无限画布工程 | 编排与工作台 | MIT,16,319 star30 |
| OpenChatCut(第 16 期) | 素材与一句自然语言 | 可撤销的真时间线工程 | 编辑器加 MCP | AGPL-3.0,2,079 star31 |
| hypit(第 15 期) | 一条参考视频 | 可重跑的 SVML 作品源码 | 工作流描述语言 | 改过的 Apache-2.0,18,448 star32 |
| HyperFrames(第 14 期) | 一份 HTML / CSS 工程 | 逐帧拍出来的 mp4 | 渲染底座 | Apache-2.0,55,309 star33 |
| Diffusion Studio(第 13 期) | 一份 JSX 时间线 | 同一份文件上的协同编辑 | 编辑器 | MPL-2.0,3,189 star34 |
| OpenStoryline(第 6 期) | 素材与一份 config.toml | 一条 18 节点的成片产线 | 自带 Agent 的产线 | Apache-2.0,3,457 star35 |
| video-shotcraft(第 1 期) | Claude Code 或 Codex | 157 张镜头卡排出的产品片 | 技能包与镜头资产库 | Apache-2.0,10,192 star36 |
| Remotion | 一份 React 工程 | 程序化生成的视频 | 渲染底座 | 自订许可(GitHub 识别为 NOASSERTION),61,428 star37 |
表里每个数字都是 2026-10-02 当天从各仓库重新取的。
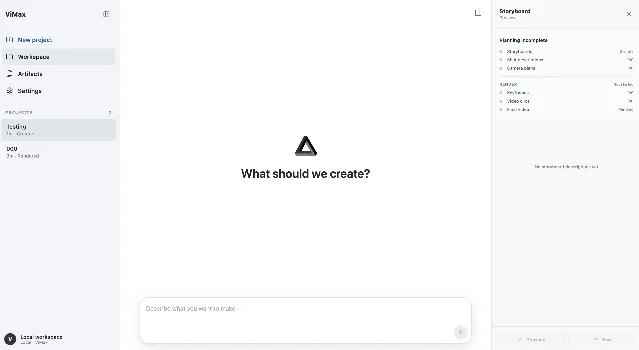
assets/vimax-web-ui.png:左侧是项目列表(Testing、000),中间是 Agent 对话入口,右侧 Storyboard 面板把「Planning incomplete」拆成 Storyboards、Shot descriptions、Camera plans 三项计数,下面 Render 一栏再拆成 Keyframes、Video clips、Final video。所谓「多 Agent 推进一条产线」,落到界面上就是这些计数一格一格往前走。8今天该不该动手
今天就装。 你想自己搭一条从想法到成片的自动产线,愿意按量付模型的账,手里有一台 Linux 或 Windows 的机器,也能接受「跟着主分支走、自己排错」这件事。还有一类人今天该装:你在做多镜头一致性,想找一个能读、能改、还配着一份把机制写清楚的公开实现,这个仓库里 13 个 Agent 的分工和那张机位依赖图都摊在你面前。4
先收藏。 你的目标是把视频生产接进编码 Agent 的流水线——它没有 MCP、没有技能包,你得先自己写一层桥,那不如先看第 16 期的 OpenChatCut。你要的是后期环节(剪、字幕、配音、对时),它也不管这些,那是第 3 期 video-use 和第 10 期 capcut-cli 那一路。还没想清楚视频模型预算的尤其先别跑,先看上面那份单价:视频这一档是按秒计费的。
References
- 1HKUDS/ViMax
github.com
- 2Commits · HKUDS/ViMax
github.com
- 3Releases · HKUDS/ViMax
github.com
- 4ViMax: Agentic Video Generation
arxiv.org
- 5agent_runtime/ · HKUDS/ViMax
github.com
- 6agent_runtime/tools.py
github.com
- 7agent_runtime/vimax_adapters.py
github.com
- 8README · HKUDS/ViMax
github.com
- 9tools/__init__.py
github.com
- 10configs/idea2video.yaml
github.com
- 11agents/ · HKUDS/ViMax
github.com
- 12pipelines/ · HKUDS/ViMax
github.com
- 13vimax_benchmark/benchmark_index.json
github.com
- 14Issue #23 · HKUDS/ViMax\
github.com
- 15pyproject.toml
github.com
- 16configs/agent.example.yaml
github.com
- 17vimax
github.com
- 18web/ · HKUDS/ViMax
github.com
- 19Issue #9 · HKUDS/ViMax
github.com
- 20Issue #11 · HKUDS/ViMax
github.com
- 21Issue #37 · HKUDS/ViMax
github.com
- 22Issue #83 · HKUDS/ViMax
github.com
- 23Issue #18 · HKUDS/ViMax
github.com
- 24Issue #66 · HKUDS/ViMax
github.com
- 25Issue #67 · HKUDS/ViMax
github.com
- 26Pull requests · HKUDS/ViMax
github.com
- 27Issues · HKUDS/ViMax
github.com
- 28LICENSE · HKUDS/ViMax
github.com
- 29Gemini Developer API pricing
ai.google.dev
- 30HBAI-Ltd/Toonflow-app\
github.com
- 310xsline/OpenChatCut\
github.com
- 32hypit-ai/hypit\
github.com
- 33heygen-com/hyperframes\
github.com
- 34diffusionstudio/editor\
github.com
- 35FireRedTeam/FireRed-OpenStoryline\
github.com
- 36Vincentwei1021/video-shotcraft\
github.com
- 37remotion-dev/remotion\
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.