从《AI安全治理框架3.0》看产业趋势:数据“不解密、不暴露”成大模型入局刚需
荆华密算梳理《人工智能安全治理框架3.0》9月14日发布的要点,并呈现其对数据“不解密、不暴露”成为大模型落地前提的判断、密态计算方案与产品落点。
当 AI 应用从“尝鲜试用”迈入“核心业务”,数据安全的位置变了:它从上线之后才补的“附加题”,变成决定企业愿意把哪些业务交给大模型的底线。1
9 月 14 日,在 2026 年国家网络安全宣传周开幕式上,全国网络安全标准化技术委员会发布《人工智能安全治理框架 3.0》(下称《框架 3.0》)。新版框架围绕人工智能发展的新趋势和安全治理的新挑战,对风险分类、技术应对和综合治理措施作了更新优化。2
荆华密算的这篇推文从中读出一个信号:AI 安全治理正在从原则倡导走向体系化、工程化和场景化。在推文的表述里,AI 安全不只关乎模型输出是否可靠,还关乎数据、模型、系统、应用和责任机制能否形成闭环。1
数据安全成为 AI 落地前提
《框架 3.0》值得注意的地方,在于它没有把 AI 安全简单理解成“模型安全”,而是放到研发、部署、应用和治理的全流程中审视。1
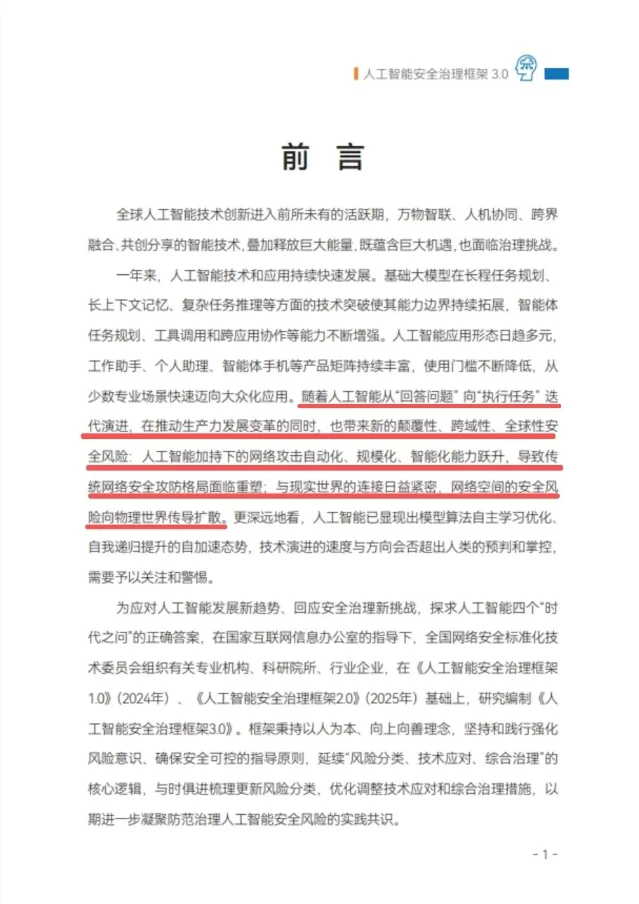
官方发布信息提到,这版框架秉持以人为本、向上向善的理念,坚持“强化风险意识、确保安全可控”的指导原则,延续“风险分类、技术应对、综合治理”的核心逻辑。2 推文由此判断,AI 安全治理正从单点风险防范走向覆盖数据、模型、系统、应用和责任机制的全链路治理。1
在具体的安全指引中,《框架 3.0》提出要“落实数据安全管理责任”,评估人工智能应用中存在的“数据泄露、个人隐私泄露、违规收集使用个人信息”等风险,建立数据全生命周期安全管理机制,并加强用户交互数据、检索增强生成数据等方面的安全防护,提升数据防泄漏、防窃取保障能力。1
推文把这些表述指向同一个问题:当 AI 真正进入生产场景,安全必须落到数据流转和模型调用的关键环节。AI 系统需要更清晰的数据安全边界、更可控的调用链路,以及完整的风险识别、风险评估和风险处置机制。按推文的说法,安全是模型应用和系统部署之初就该纳入的基础能力,而不是产品上线后打的补丁。1
加密使用云端大模型
数据安全与隐私保护,是 AI 进入高敏感场景时绕不开的核心命题。无论个人隐私对话还是企业核心资产,接入云端大模型的核心顾虑往往不在模型能力,而在“不敢使用”。1
荆华密算创始人、CEO 林修醇对这一顾虑的判断是:
AI 的竞赛正从“好不好用”转向“敢不敢用”。真正的安全从来不能靠模型厂商的道德承诺,而是靠底层的密码学架构,做到“不解密、不暴露”,把数据的控制权真正还给用户。1
围绕这一思路,荆华密算基于自研的高性能密态计算引擎,把密态推理的性能损耗降低到商用水平;公司还联合中国人民保险推出全球首个人工智能数据安全保险,形成“技术保证+制度兜底”的双重闭环。1
产品落点上,推文列出四款形态:面向个人的“墨镜熊”和“密听”,面向企业的“可信 Token”和“密态 MaaS”。按推文的说法,这套产品把底层的密态推理能力转化为可感知的产品与服务,帮助高敏感行业在安全前提下接入大模型。1
从《框架 3.0》到产业实践,推文给出的方向是:既要推动技术创新,也要守住安全边界;既要释放数据价值,也要保护个人信息和商业秘密;既要让 AI 好用,也要让 AI 可信。1
荆华密算表示,未来会继续深耕密态计算技术,用成本更低、性能更高的加密推理方案,让高敏感行业真正安心地把 AI 用到核心业务里。1
References
- 1从《AI安全治理框架3.0》看产业趋势:数据“不解密、不暴露”成大模型入局刚需
mp.weixin.qq.com
- 2《人工智能安全治理框架3.0》发布
cac.gov.cn
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.