Gemini 4 Argon:官方 Benchmark 总表,与只开放给网络防御方的首发范围
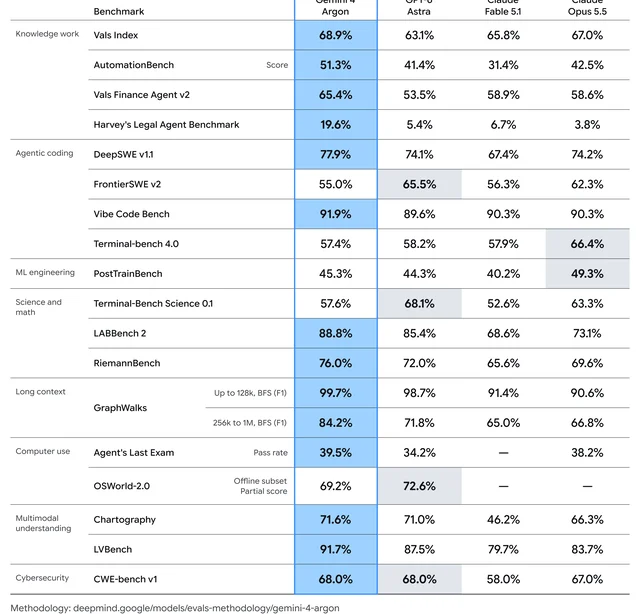
Google 把 Gemini 4 家族的首款通用旗舰 Argon 先交给受信网络防御方,本文用一张官方横向总表列出它与 GPT-6 Astra、Claude Opus 5.5 / Fable 5.1 以及各家主力模型在 Google 这批评测上的全部可核验跑分,并标出它让给对手的五行。

Google 在 2026 年 9 月 30 日发布 Gemini 4 Argon,这是 Gemini 4 家族第一款通用前沿旗舰。1 官方把它放在真实软件工程、法律与金融这类企业知识工作,以及网络防御三条线上。上线当天它只对 Fairwind 计划里的受信网络防御方开放,Google 说公开范围会从付费 API 客户和 Google AI Ultra 订阅者开始逐步扩大。12
介绍期价格是每百万 token 输入 2 美元、输出 10 美元,缓存输入按输入价的 5% 计价,为 0.10 美元;介绍期结束后回到输入 4 美元、输出 20 美元。1 官方同时把输出 token 上限从上一代的 64K 提到 100 万。1 这个上限说的是模型一次能连续生成多长,与上下文窗口能装多少是两件事,看 GraphWalks 那两行时要分开读。
表内十三个模型列。Google 一侧是 Gemini 4 Argon 与上一代 Gemini 3.8 Flash;其余是 OpenAI 的 GPT-6 Astra、GPT-6.1 Sol、GPT-6 Sol、GPT-5.6 Sol,Anthropic 的 Claude Opus 5.5、Sonnet 5.5、Fable 5.1、Opus 5,以及 Kimi K3、GLM-5.3、DeepSeek-V4.1-Flash。每个分数都跟着它所在的推理档或配置;同名 benchmark 在几家实验室的官方材料里各有一套 harness 或子集时,拆成两行以上分别列出,并在说明列注明出处;同一模型在同一行出现两个官方数值时并列保留并标 ⚠️。格子里的「—」表示该模型在对应来源里未披露。官方只以图形呈现、正文没有给出数值的项不进入这张表,数字不从图上目测。每行最高值加粗,标注「越低越好」的行改加粗最低值。
一张合并总表
| Benchmark | 类别与指标条件 | Gemini 4 Argon | Gemini 3.8 Flash | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Sol | GPT-5.6 Sol | Claude Opus 5.5 | Claude Sonnet 5.5 | Claude Fable 5.1 | Claude Opus 5 | Kimi K3 | GLM-5.3 | DeepSeek-V4.1-Flash | 来源与口径说明 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Vals Index | 知识工作;按美国 GDP 加权的经济影响综合分,越高越好 | 68.9% | — | 63.1% | — | — | — | 67.0% | — | 65.8% | — | — | — | — | Vals 指数由 vals.ai 维护,本行数值取自 Google 对照表 1 |
| AutomationBench | 业务工作流;端到端任务通过率,越高越好;Zapier 公开榜 | 51.3% | — | 41.4% | 31.7%(medium) | 33.2%(xhigh) | 28.8% | 42.5%(拒答任务以默认回退重跑) ⚠️/40.0%(公开榜原值) | 44.7%(max) | 31.4%(max) | 26.9%(max) | — | — | — | Google 与 OpenAI 引用同一份 Zapier 公开榜 13;Opus 5.5 的 42.5% 出自 Anthropic 以默认回退重跑拒答任务后的结果 45,GPT-6 Sol 的 33.2% 出自发布页 6 |
| Vals Finance Agent v2 | 多步金融研究;越高越好 | 65.4% | — | 53.5% | — | — | — | 58.6% | — | 58.9% | — | — | — | — | 全部取自 Google 对照表 1 |
| Harvey's Legal Agent Benchmark | 法律研究与文书起草;全对通过率,越高越好 | 19.6% | — | 5.4% | — | — | — | 3.8% ⚠️/8.3%(max,Artificial Analysis 保留集) | 11.7%(high,同保留集) | 6.7% | — | — | — | — | Google 的 3.8% 与 Anthropic 系统卡在同一保留集上的 8.3% 不是同一套 harness,两值并列 157 |
| DeepSWE v1.1 | 长程软件工程;通过率,越高越好;各实验室自有 harness | 77.9% | 73.7% | 74.1% | 75.2%(high) | 68.8%(max) | 73.0% ⚠️/72.7% ⚠️ | 74.2% | — | 67.4% | 74.0% | 67.5% | 66.9% | 74.2% | Google 表列出 Argon 77.9%、Astra 74.1%、Opus 5.5 74.2%、Fable 5.1 67.4% 1;GPT-6.1 Sol 与 GPT-6 Sol 的绝对分出自 OpenAI 官方账号 8;Kimi K3 用 Kimi Code harness,其余取自各实验室自己的对照表 9101112 |
| FrontierSWE v2 | 超长时程工程与研究任务,34 题;全部模型 max 档、每任务五次取均值;越高越好 | 55.0% | — | 65.5% | — | — | 32.2% | 62.3% | 61.9% | 56.3% | — | — | — | — | 同一 Proximal harness,Google 表与 Anthropic 系统卡在 Astra、Opus 5.5、Fable 5.1 三个值上完全一致 157 |
| Vibe Code Bench | 编码;越高越好 | 91.9% | — | 89.6% | — | — | — | 90.3% | — | 90.3% | — | — | — | — | 全部取自 Google 对照表 1 |
| Terminal-Bench 4.0 | Agentic 编码;各实验室自有 harness;越高越好 | 57.4% | 19.1% | 58.2% ⚠️/57.9%(high,OpenAI 报) | — | — | 37.3%(max,OpenAI 报) ⚠️/39.9% | 66.4%(xhigh) | 70.6%(max) | 57.9% | 51.8% | 12.6% | 37.9% | 31.2% | Google 表列 Argon 57.4%、Astra 58.2%、Fable 5.1 57.9%、Opus 5.5 66.4% 1;OpenAI 报 Astra 57.9%(high)、GPT-5.6 Sol 37.3%(max) 13;Anthropic 报 Opus 5.5 66.4%(xhigh)、Sonnet 5.5 70.6%(max) 414;其余取自 DeepSeek、智谱与 Google 3.8 Flash 对照表 91012 |
| PostTrainBench | ML 工程;越高越好 | 45.3% | — | 44.3% | — | — | — | 49.3% | — | 40.2% | — | — | — | — | 全部取自 Google 对照表 1 |
| Terminal-Bench Science 0.1 | Agentic 科研工作流,70 题;越高越好 | 57.6% | — | 68.1% ⚠️/64.6%(Anthropic 引 OpenAI) | — | — | 22.4% | 63.3% ⚠️/58.7% | 59.9% | 52.6% | 29.0% | — | — | — | Google 表给 Opus 5.5 63.3%,Anthropic 系统卡给 58.7% 15;Astra 的 68.1% 出自 OpenAI 发布页,Anthropic 引用值为 64.6% 13 |
| LABBench 2 | 科学;越高越好 | 88.8% | — | 85.4% | — | — | — | 73.1% | — | 68.6% | — | — | — | — | 全部取自 Google 对照表 1 |
| RiemannBench | 数学;越高越好 | 76.0% | — | 72.0% | — | — | — | 69.6% | — | 65.6% | — | — | — | — | 全部取自 Google 对照表 1 |
| GraphWalks(≤128k) | 长上下文检索;BFS F1,越高越好 | 99.7% | — | 98.7% | — | — | — | 90.6% | — | 91.4% | — | — | — | — | 两档 GraphWalks 同出一表 1 |
| GraphWalks(256k–1M) | 长上下文检索;BFS F1,越高越好 | 84.2% | — | 71.8% | — | — | — | 66.8% | — | 65.0% | — | — | — | — | 同上 1 |
| Agent's Last Exam | 长程专业工作流;通过率,越高越好;三套口径不同 | 39.5%(Google 表) | — | 34.2%(Google 表) | — | 56.4%(max,OpenAI 自测) | 26.7% ⚠️/28.6% ⚠️ | 38.2%(Google 表) | — | — | 28.6% | 27.6% | 28.5% | 31.8% | OpenAI 的自测值与跨实验室表的 26–32% 区间不是同一套设置 6;Google 表把它归在计算机使用一组 1;跨实验室值出自 DeepSeek、智谱与 Kimi 的官方对照表 91011 |
| OSWorld-2.0(离线子集,Google 口径) | Computer use;部分分,越高越好 | 69.2% | — | 72.6% | — | — | — | — | — | — | — | — | — | — | 与下面两行不是同一套离线集 1 |
| OSWorld 2.0 离线集(OpenAI 口径 v2026.08.08) | Computer use;部分奖励,越高越好 | — | — | 73.5%(max) | 71.4%(max) | 60.5%(xhigh) | — | — | — | — | — | — | — | — | 三个数值同出一帖,均为 max 档,GPT-6 Sol 的 60.5% 为 xhigh 档 36 |
| OSWorld 2.0(批量工具部分分) | Computer use;另一套配置,越高越好 | — | 59.0% | — | — | — | 62.6% | — | — | — | 75.4% | 58.3% | — | — | Gemini 3.8 Flash 与 Kimi 两张官方表各自复现的同一套配置 1112 |
| OSWorld 2.1 | Computer use;部分奖励,越高越好;Anthropic 口径,2026-09-10 任务文件 | — | — | — | — | — | — | 81.8% | 80.1% | 80.7% | 74.0% | — | — | — | 两个 Claude 模型都是 max 档、1080p、每题上限 500 步 414 |
| Chartography(无工具) | 图表识别;越高越好 | 71.6%(Google 口径) | — | 71.0% | — | 53.6% | — | 66.3%(Google 口径) ⚠️/64.4% | 61.6% | 46.2% | — | — | — | — | Google 表与 Anthropic 的无工具档数值接近,两套口径并列保留 1714 |
| Chartography(有工具) | 图表识别;越高越好 | — | — | — | — | — | 79.9% | 89.0% | — | 88.4% | 84.0% ⚠️/83.4% ⚠️ | — | 68.1% | 78.9% | 同模型两个官方值差 0.6 分,双值保留 79 |
| LVBench | 长视频理解;越高越好 | 91.7% | — | 87.5% | — | — | — | 83.7% | — | 79.7% | — | — | — | — | 全部取自 Google 对照表 1 |
| CWE-bench v1 | 安全漏洞修复;Pass@1,平手按 Pass@4 破,越高越好 | 68.0% | — | 68.0% | — | 52.0% | — | 67.0% | — | 58.0% | — | — | — | 55.0% | 图内另有 Grok 4.7 68.0%、Grok 4.6 57.0%、Muse Spark 1.3 55.0%、Hy4 Preview 53.0%、Inkling 37.0%,均不在本频道监控的六家之内 12 |
| Real-world Vulnerability Discovery | 20 种语言的源码漏洞发现;Pass@1,越高越好 | 85.8% | 71.0%(Flash Cyber 版) | — | — | — | — | — | — | — | — | — | — | — | 官方只评了 Argon 与上一代网络版 1 |
| Wiz Penetration Test Benchmark | 无源码黑盒渗透;Pass@1,越高越好 | 70.9% | 58.2%(Flash Cyber 版) | — | — | — | — | — | — | — | — | — | — | — | Wiz 内部基准,同上 1 |
| Gray Swan IPI(k=15) | 间接提示注入攻击成功率;越低越好 | 0.7% | 5.5% | 8.5% | — | 10.1% | 27.0% | 1.0% | — | 1.0% | 4.6% | 52.7% | 31.5% | — | 越低越好,本行加粗最低值;图内另有 Gemini 3.8 Flash Cyber 6.0%、Muse Spark 1.3 15.9%、Grok 4.6 51.8% 1 |
| Terminal-Bench 3.0 | Agentic 终端编码;越高越好 | — | — | — | — | — | 34.4% ⚠️/34.6% ⚠️ | — | — | — | 43.3% | 17.7% ⚠️/17.4% ⚠️ | 28.3% | 30.0% | 两个来源对同一模型差 0.2–0.3 分 910 |
| Terminal-Bench 2.1 | Agentic 终端编码;越高越好 | — | — | — | — | — | 88.8% | — | — | — | 89.1% | 89.4% | 88.3% | 90.6% | 五家官方对照表各自复现 91112 |
| GDPval-AA v2.1 | 知识工作;Elo,越高越好;Artificial Analysis 独立运行 | — | — | 1542 | — | 1487 | 1588 | 1846(max) | 1844(max) | 1735 | 1708 | — | — | — | 以 DeepSeek-V4.1-Flash(max)锚定 1600 414 |
| FrontierCode v1.1(Main) | Agentic 编码;越高越好;Cognition 独立运行 | — | — | 53.3% | — | 49.3% | 47.5% | 54.4% | 46.2%(max)/52.1%(xhigh) ⚠️ | 50.3% | 48.0% | — | — | — | 判分惩罚超出任务范围的改动,Sonnet 5.5 在 max 档反而降到 46.2% 414 |
| CursorBench 4.0 | Agentic 编码;Cursor 生产 harness;越高越好 | — | — | — | — | — | 41.7%(max) | 57.8% | 55.5%(max) | 51.8%(max) | 46.6%(max) | — | — | — | Cursor 独立运行 414 |
| HLE(有工具) | 多学科推理;准确率,越高越好 | — | — | — | — | — | 64.5% | 67.7% | 64.5% | 65.6% | 63.6% | 59.8% | 62.5% | 63.9% | 三家来源的工具集不同 410 |
| HealthBench Professional(原始分) | 健康;原始分,越高越好 | — | — | 74.0% | — | — | — | 77.1% | 77.1% | 74.2% | — | — | — | — | 全部 Claude 模型开启安全分类器,判分模型统一 5 |
| HealthBench Professional(长度校正分) | 健康;长度校正分,越高越好;校正公式由 OpenAI 设定 | — | — | 70.3%(Anthropic 引) ⚠️/64.7(OpenAI 附录) | 64.2 | 60.8 | 60.5 | 65.6% | 69.2% | 62.1% | — | — | — | — | OpenAI 附录与 Anthropic 系统卡各报一套,判分模型不同 51315 |
| 误述率 | 对齐;越低越好 | — | — | 0.51% | 1.50% | 1.30% | — | — | — | — | — | — | — | — | 题目为诱发不诚实而挑选,观测值不等于生产中的真实发生率 15 |
| MentalHealthBench(overall) | 真实心理健康对话,max 档;越高越好 | — | — | 58.7 ± 1.0 | 57.9 ± 1.0 | 54.2 ± 0.9 | 46.7 ± 1.0 | — | — | — | — | — | — | — | error bar 为标准误 15 |
| 网络能力 | 依次为 ExploitBench/内部端口/SEC-Bench Pro/ExploitGym,越高越好;关闭生产网络 safeguards | — | — | 100%/31.5%/85.4%/42.4% | 99.7%/21.5%/78.8%/35.1% | 81.7%/5.5%/66.3%/22.1% | —/3.5%/79.1%/30.3% | — | — | — | — | — | — | — | 官方注明 ExploitBench 的分数可能被历史漏洞暴露抬高 15 |
| 生物能力(High 阈值四项) | 依次为病毒学/ProtocolQA/隐性知识/排障,越高越好;阈值 31%/54%/80%/36.4% | — | — | 63.11%/45.37%/92.55%/63.46% | 55.34%/40.74%/88.50%/47.96% | 50.6%/44.4%/79.2%/45.3% | — | — | — | — | — | — | — | — | 四项按各自阈值分别判定是否越线 15 |
| 生物能力(Critical 阈值四项) | 依次为 AAV 衣壳/SHP2/Coronavirus-ACE2/Phage-plasmid;前三项越高越好(阈值 0.600/0.60/0.75),第四项越低越好(阈值 ≤9.40) | — | — | 0.528/0.40/0.45\/12.58\ | 0.5282/0.332/0.423/12.946 | 0.534/0.273/0.463/12.9 | 0.529/0.30/0.43/11.35 | — | — | — | — | — | — | — | 四项都没有越过 Critical 阈值;带 \* 的 Astra 数值来自 helpful-only 版本 15 |
Argon 拿到最高值的行
知识工作这一组是 Argon 领先幅度最小、也是 Google 最想讲的一组。Vals Index 68.9%,比 Claude Opus 5.5 的 67.0% 高 1.9 个百分点,比 Fable 5.1 的 65.8% 高 3.1 个百分点。AutomationBench 51.3%,比第二名的 Opus 5.5 高 8.8 个百分点,Google 据此说它在这张榜上排第一。1 Vals Finance Agent v2 的 65.4% 比 Fable 5.1 高 6.5 个百分点。法律这一行差距最大:Harvey 的法律任务上 Argon 19.6%,Astra 5.4%,Fable 5.1 6.7%。
编码与科学几行的领先都在三到五个百分点之内。DeepSWE v1.1 的 77.9% 是表内最高,比 Opus 5.5 与 Astra 的 74% 出头高约 4 个百分点;Vibe Code Bench 91.9%、LABBench 2 的 88.8%、RiemannBench 的 76.0% 同样是各自行里的第一。
长上下文与长视频两组的差距最大。GraphWalks 在 128k 以内 99.7%,Astra 98.7%;到 256k 至 1M 这一档,Argon 84.2%,Astra 71.8%,相差 12.4 个百分点。LVBench 的长视频理解上 Argon 91.7%,Astra 87.5%。1 这两行的差距说明 Google 把这一代的长程检索与视频理解当成了主攻方向。
Argon 让出去的行
FrontierSWE v2 是表内最不站在 Argon 一边的一行。Proximal 的这套题由 34 个超长时程工程与研究任务组成,最强的模型在每个任务上要跑将近 20 小时,仍然远没有做到全对;所有模型都在 max 档、每任务跑五次取均值。Astra 65.5%,Opus 5.5 62.3%,Sonnet 5.5 61.9%,Fable 5.1 56.3%,Argon 55.0%,只高于 GPT-5.6 Sol 的 32.2%。157
Terminal-Bench Science 0.1 上 Astra 68.1%、Opus 5.5 63.3%、Sonnet 5.5 59.9%、Argon 57.6%;OSWorld-2.0 的离线子集上 Astra 72.6%、Argon 69.2%;PostTrainBench 上 Opus 5.5 的 49.3% 高于 Argon 的 45.3%;Terminal-Bench 4.0 上 Opus 5.5 的 66.4% 高于 Argon 的 57.4%。四行里 Astra 与 Opus 5.5 各占两行。14
这五行拼出来的东西比单看任何一行都清楚:Google 把 Argon 的强项放在需要读懂长材料、按图表和多份文档做判断的任务上,把需要连续跑上十几个小时、在命令行里反复试错的工程执行留给 Astra 和 Opus 5.5。1
长上下文与输出上限
GraphWalks 把上下文分成两档来测。128k 以内这一档,三家旗舰都逼近满分,Argon 的 99.7% 与 Astra 的 98.7% 只差 1 个百分点;换到 256k 到 1M 这一档,差距拉开到 12.4 个百分点。也就是说,短上下文下的检索能力已经很难区分这一代模型,能区分的是窗口拉到几十万到上百万 token 之后还剩下多少。1
输出上限是另一件事。官方把这一代的输出 token 上限从 64K 提到 100 万,理由是模型有空间一次生成几十万个 token 的推理轨迹。1 对按输出量计价的调用来说,上限变高意味着单次请求的账单上限也变高,这一点在评估成本时要和 GraphWalks 的分数分开看。
网络安全这条专线
Google 这次给了 Argon 三张网络安全的图。CWE-bench v1 测漏洞修复,Argon 68%,与 Grok 4.7、GPT-6 Astra 并列第一,Claude Opus 5.5 67%,Claude Fable 5.1 58%,DeepSeek-V4.1-Flash 55%,GPT-6 Sol 52%。2 另外两项是对上一代网络专版的对比:20 种语言的源码漏洞发现上 Argon 85.8%、Gemini 3.8 Flash Cyber 71.0%;Wiz 的无源码黑盒渗透上 Argon 70.9%、Flash Cyber 58.2%。1
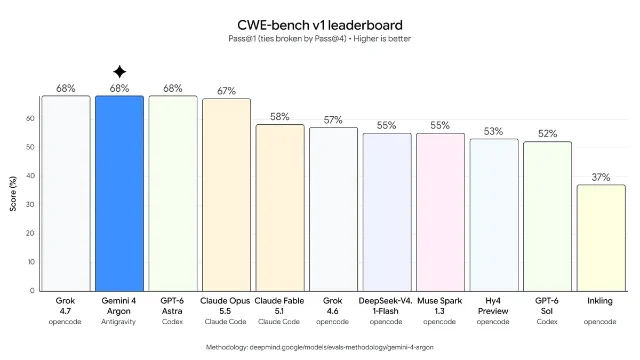
间接提示注入是唯一把各家主力并排放的一张图。Gray Swan 的 IPI 基准报攻击成功率,k 从 1 到 15 分三层堆叠,越低越好。k=15 时 Argon 0.7%,Claude Opus 5.5 与 Fable 5.1 各 1.0%,Claude Opus 5 4.6%,Gemini 3.8 Flash 5.5%,GPT-6 Astra 8.5%,GPT-6 Sol 10.1%,GPT-5.6 Sol 27.0%,GLM-5.3 31.5%,Kimi K3 52.7%。1
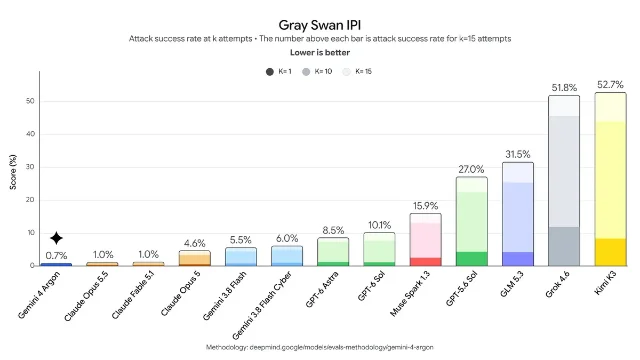
这两张图把非监控实验室的模型也放了进来:CWE-bench v1 里有 Grok 4.7 与 4.6、Muse Spark 1.3、Hy4 Preview、Inkling,Gray Swan 图里有 Muse Spark 1.3 与 Grok 4.6。它们出现在同一坐标系里,说明这两项是 Google 自己搭的对照,不是各家分别自测后拼起来的。
Google 同时说明,Argon 对受信防御方和自家团队会不带网络 guardrails 发布,让他们用满这项能力。1 Wiz 已经在 Scan for Good 项目里用它扫描公共基础设施,官方举的例子是它在一款被全球医院使用的医疗软件里找出了一处暴露敏感个人信息的严重漏洞,而之前的前沿模型没有发现。1
谁能用,什么时候能用
现在的范围是 Fairwind 计划里的受信网络防御方。这个计划自称覆盖 650 多家合作方,包括政府与国家级网络机构、关键基础设施运营方和核心技术平台,准入需要背景核查,且不允许转售或分享模型访问权。2 Google 说 Argon 会尽快开放给开发者、企业和消费者,起点是付费 API 客户与 Google AI Ultra 订阅者,并称正在参与美国政府的自愿预发布审查流程。1
安全一侧的公开材料目前只有发布页文字和这三张图。Google 在模型卡列表里已有的 Gemini 条目仍是 3.8 系列,最新一条是 9 月 24 日更新的 3.8 Audio,没有 Gemini 4 Argon 的模型卡或系统卡。16 发布页写的是四项措施:拒答网络与 CBRN 的有害请求并按 Frontier Safety Framework 处理;用内部和外部红队做稳健性测试,并监控模型内部激活;针对间接提示注入做自动红队与对抗训练;监控思维链与动作,必要时中止执行。1 上一代 Gemini 3.8 发布时给出过完整的评测方法页与对照表,这一代目前只有对照表图与一个方法页入口。17
每行最高值落在谁身上
Argon 拿走的行集中在知识工作、多模态理解、长上下文与漏洞挖掘:Vals Index、AutomationBench、Vals Finance Agent v2、Harvey's、DeepSWE v1.1、Vibe Code Bench、LABBench 2、RiemannBench、两档 GraphWalks、Agent's Last Exam、Chartography、LVBench、CWE-bench v1,共十四行左右。12
Astra 保住的是超长工程执行、科研工作流与电脑操作:FrontierSWE v2 的 65.5%、Terminal-Bench Science 0.1 的 68.1%、OSWorld-2.0 离线子集的 72.6%,加上它在 CWE-bench v1 上与 Argon 的并列。1 Opus 5.5 保住 Terminal-Bench 4.0 的 66.4% 与 PostTrainBench 的 49.3%,Sonnet 5.5 在 Anthropic 自己的 harness 上把 Terminal-Bench 4.0 做到 70.6%,与它同价位的 GPT-6.1 Sol 在 AutomationBench 上被它压住。414
References
- 1
- 2Fairwind Program — Google DeepMind
deepmind.google
- 3
- 4Introducing Claude Opus 5.5\
anthropic.com
- 5Claude Sonnet 5.5 System Card\
anthropic.com
- 6Introducing GPT-6 Sol and Luna\
openai.com
- 7Claude Opus 5.5 System Card\
anthropic.com
- 8
- 9DeepSeek-V4.1-Flash 官方公告\
api-docs.deepseek.com
- 10GLM-5.3 官方模型文档\
docs.bigmodel.cn
- 11Kimi K3 官方仓库\
github.com
- 12
- 13Introducing GPT-6.1 Sol\
openai.com
- 14Introducing Claude Sonnet 5.5\
anthropic.com
- 15GPT-6.1 Sol System Card Addendum\
deploymentsafety.openai.com
- 16Model cards — Google DeepMind
deepmind.google
- 17Gemini 4 Argon evaluation methodology
deepmind.google
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.