David Silver 的第一场长访谈:一年内见强证据,三年内超级智能
AlphaGo 与 AlphaZero 的主导者 David Silver 离开 DeepMind 后,第一次系统讲清自己要做什么:放弃人类数据、靠经验从零学,一年内看到强证据、三年内做出超级智能。本篇核完这家公司的来历、他手里的证据,以及那句「几千人在回路里」能对上多少。

北京时间 10 月 13 日晚,红杉资本的播客《Training Data》上线了一集 68 分钟的访谈,嘉宾是 David Silver——这是 AlphaGo 和 AlphaZero 的主导者离开 Google DeepMind 之后,第一次系统讲清自己要做什么。
和他一起上节目的是 Lasse Espeholt,两人共同创办的公司叫 Ineffable Intelligence,总部在伦敦。3
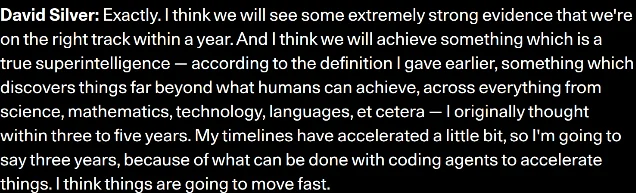
访谈里给出的两个时间点,是这一集最容易被记住的部分。
第一个是「一年内」看到极强的证据,第二个是「三年内」做出真正的超级智能。1
后面这个数字,他自己改过。
按他在节目里的说法,原本的估计是三到五年,现在往前挪到三年,理由是编码智能体可以加速研究本身。1
01 他是谁,这家公司在做什么
AlphaGo 在 2016 年击败李世石,他领导了这个项目;到 AlphaZero 那一版,人类棋谱被全部丢掉。这两件事的经过都是他在节目里自己讲的。1
他离开的消息,是 Google DeepMind 在 2026 年 1 月先向内部通报、随后由《财富》在 1 月 30 日独家报道的;报道写他此前已休假数月,并未正式回到岗位。3
2026 年 4 月 27 日,这家新公司完成 11 亿美元种子轮融资,估值 51 亿美元;红杉与 Lightspeed 联合领投,英伟达、Google、Index、DST 与英国的主权 AI 基金都在出资方名单里。45
2026 年 9 月 7 日,《财富》报道公司新增六位联合创始人、总数增至七位,其中四位来自 Google DeepMind,另外三位出自创业公司。6
02 「超级学习者」是什么
Silver 给的是一句很克制的话:一个自己什么都不知道、靠直接经验自己发现语言、数学与科学的系统。1
他用人类的来历打比方——一群人从「脑子里一片灰蒙蒙」开始,没有任何人递给他们一份蓝图,也没有人递给他们一份上万亿条的、标着「这些东西应该长什么样」的数据集,最后却发现了语言、技术和科学。1
这套主张的更早出处,是他与 Richard Sutton 合写的预印本《Welcome to the Era of Experience》;那篇文章写的是:模仿足以复现人类的许多能力,但只靠模仿走不到超人智能。7
他手里的证据,来自他自己做过的那一组对照。
AlphaGo 那一版走的是和今天的大模型相似的路:灌进大量人类棋谱,再由人在回路里挑选与改进,一代一代做下去。从开工到击败李世石,用了两年。1
AlphaZero 把那批人类数据全丢掉,只留下规则和一个简单目标;算法调对之后,几个小时就超过了前面两年的成果。国际象棋上,它用四小时击败了当时最强的对弈 AI。1
他把这套东西落到具体做法上,他用了一个词:crucible,中文里常译作坩埚。
按他的用法,坩埚指的是能自己长出复杂性的环境;它和业界常说的「环境」不同,后者通常是一组已知答案的任务。他说围棋就是最好的例子——如果只有一方在 19×19 的格子上落子,那是最无聊的游戏;放进第二个智能体之后,复杂度就无止境地长出来。1
算力是这套说法的现实基础。
Espeholt 说他们是 Google Cloud 上最大一个集群的第一批客户,那批机器预计在访谈后一个月左右上线,用的是英伟达的 Vera Rubin;一个机架几乎可以当成一台机器,机架内带宽很高,这正是强化学习需要的快迭代。1
Silver 补了一个对照:相比 OpenAI 早年的 hide-and-seek 那种「智能体自己学会用工具」的实验,他们能拿到的算力大约多出十万倍。1
03 他对大模型实验室的那句评语
访谈里最刺的一句,出现在讲「为什么非走不可」的时候。
It has to be an active choice. If you don't make that active choice — what I see in a lot of the LLM companies today is that they're basically building semi-autonomous, human-in-the-loop learning algorithms, with thousands of people in the loop of the learning process.
译过来是:这必须是一个主动的选择。如果你不做这个选择——我在今天很多大模型公司看到的是,它们本质上在建半自主的、人留在回路里的学习算法,几千个人待在学习的流程中。1
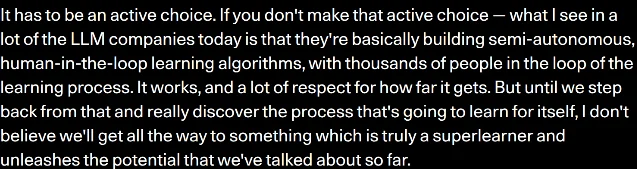
他解释自己为什么非要从 DeepMind 出来单干时,沿用同一条推理:相信的那条路「不经过以 LLM 为基础的产品这一站」,而这条路值得有一整个实验室去全部押上,而不是一家以 LLM 产品为主业的机构里的一个角落。1
他还给了另一句更直白的:世界上已经有几万甚至几十万人在做同一条路线,他要不要去做第 100,001 个。1
关于语言,他的判断比多数人更靠前:人类语言是推理的终点这种看法「有点天真」,而且从人类语言出发做推理,会把人类关于「智能体应该怎么想」的偏见一并带进去。1
他举的反例是:如果让今天的智能体只用五百年前的语言思考,它可能会认为世界是平的、疾病来自四种体液。1
04 一年与三年,哪部分能核
这两个数字目前只能算他自己的判断;能核的是他做判断的依据,以及其他机构对同一件事的公开口径。
「超级学习者」这个词,本轮检索找不到 2026 年之前由他或 Sutton 在论文中使用过的证据。Sutton 一派长期用的词是持续学习、基于经验的学习和「阿尔伯塔计划」;那份《The Alberta Plan for AI Research》的作者是 Sutton、Bowling 与 Pilarski,Silver 不在署名里。8
这一条属于自述;本篇没有找到独立第三方核对过他几次预测的原始时点。
同期最直接的时间线对照来自 Demis Hassabis:他在 2026 年 2 月说 AGI 还要五到八年,并说今天的系统是「参差不齐的智能」,缺的正是训练完成、投放出去之后的持续学习能力。10
两人对「今天的系统缺了什么」判断相近,给出的年限却差一倍以上。Hassabis 承认「冻结的大模型」是个问题,但他的解法是在现有体系上加持续学习与世界模型,而不是丢掉人类数据从零学起。10
05 他给安全留的位置
这一集里,安全问题占了大约十分钟。
Silver 的主张是:真正该做的事,是在仿真里把「超级智能的科学」建起来——搞清楚需要什么条件、什么结构、什么杠杆,才能让一群超级智能彼此和平相处,尤其是与其他能力更低的智能相处。1
他说这件事只能在仿真里跑得快,并给了一个很硬的比喻:如果超级智能能在仿真里造出来,那它会快十倍到一百倍,而且「仿真也是造超级智能最安全的地方」。1
为了让这个说法站得住,他给的是图灵完全性(Turing-complete,指这套仿真在计算能力上等价于一台通用计算机)那套论证:只要仿真环境是图灵完全的,所有我们称为计算的东西都能在仿真里被完整表达;货币可以用硬币、纸或比特表示,于是经济学也能;多个智能体之间只要有通信渠道,语言也能。1
他给公司定了一条门槛:现实世界里走的每一步,都要先有仿真的证据。
原话是:公司在真实世界里做的每一件事,都会以「有足够证据表明结果会好」为前提;只有完全确信下一步是好的,才会往前推。1
被问到监控时,他承认业界现在依赖的那套办法——监控模型用英语写出来的思维链——会越来越难用,因为智能体已经在产出上百万字的推理,或者一边想一边装作在做别的事。1
他给的两条替代路线是:影子动作——让智能体说出自己会做什么,但不真的让它做;以及让另一个超级智能去盯着前一个智能体的动作幅度,把它对世界的影响限制住。1
关于限速,他的答案是分两层:现实世界的前沿应当放慢,「我非常支持」;而仿真里的速度应当尽可能快,理由是仿真里跑出来的东西,正是让现实世界走好的依据。他说,Demis Hassabis 与 Dario Amodei 这类人主张的前沿限速方向,他总体上支持,因为「事情移动得太快,我们适应不了那么快」。1
06 那句话能不能对上,公开文本怎么说
那句「几千个人待在学习的流程中」的评语能不能对上,OpenAI 与 Anthropic 自己的公开文本能对上一部分。
| 出处 | 与本集相关的公开表述 | 时间 |
|---|---|---|
| David Silver(本集) | 大模型公司做的是「半自主的、人留在回路里的学习算法」,几千个人待在学习的流程中 | 2026-10-13 |
| OpenAI(o1 发布博文) | o1 是「用强化学习训练的」模型,强化学习被描述为在预训练语言模型之上的一层训练阶段 | 2024-09-12 |
| Anthropic(对齐研究博客) | 其对齐训练由三部分构成:在合乎宪法的文档上做 SDF(原文只给缩写)、高质量的有监督微调(SFT),以及「一组多样的强化学习环境」 | 2026-05-08 |
| Demis Hassabis | 今天的系统缺训练之后的持续学习能力,AGI 还要五到八年 | 2026-02-18 |
两家公司的文本里都没有出现「几千个人待在学习的流程中」这个说法,也都没有回应过它。
Silver 与 Sutton 那篇预印本里,还写过一句最容易被忽略的话:他们把 AlphaProof 当作经验学习路线的例证。7
AlphaProof 在 2024 年 7 月的国际数学奥林匹克上拿到 28 分、相当于银牌,方法论文在 2025 年 11 月发表。13
07 两个数字的账
访谈最后,主持人说她要把这两个数字记下来,以后好来对账。
Silver 的回答是:研究这件事从来没有保证,而这正是它让人兴奋的地方。
References
- 1
- 2YouTube 完整版(68 分钟)
youtube.com
- 3
- 4
- 5
- 6
- 7Silver & Sutton:Welcome to the Era of Experience(DeepMind 托管预印本)
storage.googleapis.com
- 8
- 9
- 10
- 11
- 12Anthropic Alignment Science:Teaching Claude Why(2026-05-08)
alignment.anthropic.com
- 13
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.