
9 月 24 日,Anthropic 的开发者账号 @ClaudeDevs 发了一条不长的帖:从今天起,对「在 Claude 开始回复之前就被安全分类器拦下」的请求恢复计费 1。帖子跟了两个数字:在近期的测试里,99.7% 使用 Claude Code、Claude.ai 或 Cowork 的账号没有碰到这些新增的「计费拦截」;被恢复计费的这几个分类器,误报率被调在 0.1% 以下。官方在帖里自己补了一句:我们知道它不是 0%。
同一天,官方平台发布说明里写的是另一个词。 那条帖用的是「恢复计费」(resume charging),而平台发布说明里对应的条目写的是「我们正在扩大计费的拒答范围」(We're expanding which refusals are billed)2。两个词都指同一件事,但给出的预期不同:恢复意味着回到某个旧状态,扩大意味着新增一档。而这次改动恰好两者都是——它在 16 周内完成了一次「停收、再收」的往返,而且两次动作都只写在发布说明和文档页里,没有单独的公告。
先把这段往返的日期钉住。 2026 年 6 月 2 日,平台发布说明上出现一行:「在 Claude API 上,当一个请求返回
stop_reason: "refusal" 且 Claude 没有生成任何输出时,你不再被计费」2。在这之前,这类请求是要收费的——5 月 23 日的一份文档快照还写着「即使响应被拒,用量指标仍会出于计费目的返回;到拒答为止的输出 token 会被计费」3。所以「恢复」指向的是 6 月 2 日之前的那个状态,而不是凭空新增。9 月 24 日,发布说明又写:「我们正在扩大计费的拒答范围,把在产生任何输出之前到达的拒答也纳入,当 stop_details.category 为 bio、frontier_llm 或 reasoning_extraction 时——也就是我们测量到低误报量的那几个类别。中途拒答此前已经在计费。新纳入计费的拒答,按运行该请求的模型的费率、像其他任何请求一样收费。其他类别的回复前拒答仍然不计费,回退额度不变。这一改动适用于所有平台。」2把这两次动作放在一起看,时间线里有一个不好忽略的巧合:停收发生在 6 月 2 日,而一周之后的 6 月 9 日,Fable 5 发布。8 月 7 日那篇官方文章后来承认,Fable 5 发布时几乎屏蔽了所有生物学提问,公司当时就知道「这会在短期内造成大量误报」,但选择接受这个交换 4。停收与发布在时间上挨得这么近,官方从未把两者联系起来解释;可核的只有日期本身。同样只有文档记录的还有第三次变化:在 7 月 1 日的快照里,那句话还是「该请求不计入速率限额」;到现行文档里,它已经变成「该请求仍然计入速率限额」56。这一次同样没有公告,只有改字。
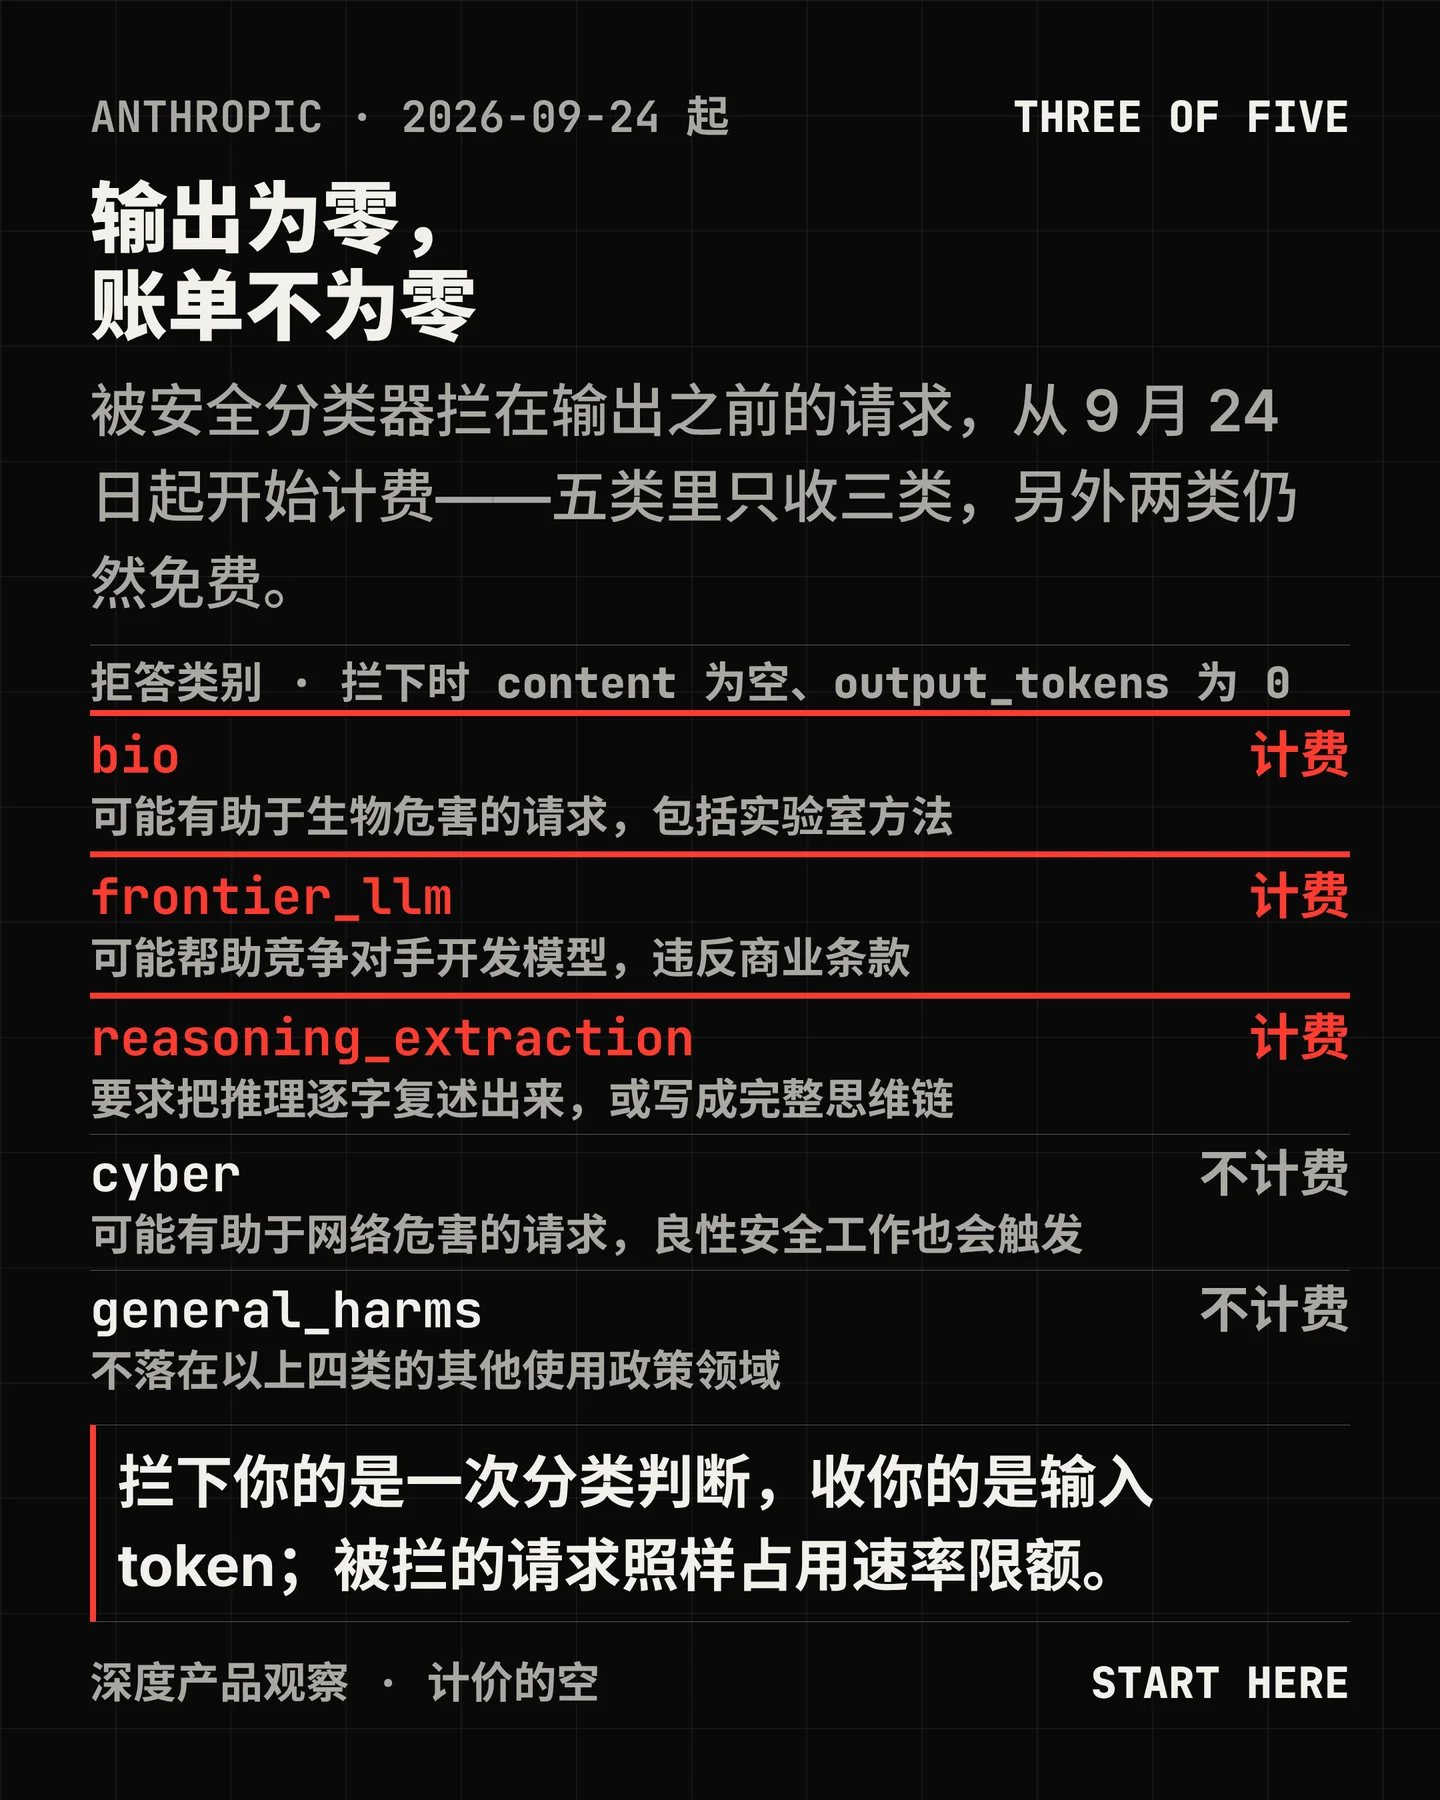
真正要读的是计费表,不是那条帖。 官方文档把拒答分成五个类别,并逐类写明「在回复之前被拦下时是否计费」:
bio、frontier_llm、reasoning_extraction 三类记为 Yes;cyber、general_harms 两类记为 No;类别字段为 null 的拒答同样不计费 6。被计费的那一次按「运行这条请求的模型的费率」收,收的只有输入 token:拒答的响应体是空的,content 是空数组,output_tokens 是 0,只剩 input_tokens 一项可以计费。不计费的拒答也会把 token 数报在 usage 里,而任何一类拒答都照样占用速率限额。中途才开始拒答的另按一条规则算:输入 token 加上已经流出去的那部分输出,按产出它们的模型费率计——这一条从来没有变过,这次改动动的只是「回复前」那一段。适用范围写得很宽,但各平台的专页都不复述它。 文档的原话是这套规则适用于每一个平台:Claude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud 与 Microsoft Foundry 6。实际去翻这四个平台的专页,Amazon Bedrock、Claude Platform on AWS、Google Cloud 与 Microsoft Foundry 的页面上都找不到拒答计费的说明,它们只写自己的计费方式(AWS Marketplace、Claude 消费单位、Google Cloud 定价),并在「不支持的功能」里列上服务端回退 7。这条规则的跨平台一致性,是靠主文档的一句声明成立的,不是靠各平台页各自声明;只读平台专页的开发者看不到它。
带安全分类器的模型是四个——Claude Fable 5.1、Claude Fable 5、Claude Opus 5.5、Claude Opus 5 6。四个模型的官方单价是:Fable 5.1 与 Fable 5 每百万输入 token 10 美元、输出 50 美元;Opus 5.5 是 4 美元与 20 美元;Opus 5 是 5 美元与 25 美元 8。
一次被拦到底多少钱,可以自己算。 官方文档里那个拒答样例的输入是 412 个 token,按 Fable 5.1 的输入单价算是 0.41 美分;同样的 412 token 落在 Opus 5.5 上是 0.16 美分。换成可复现的量级:一次一万 token 输入的 agent 调用被拦,Fable 5.1 上是 10 美分,Opus 5.5 上是 4 美分;一次二十万 token 的长上下文被拦,是 2 美元和 80 美分。这几个数里没有长上下文溢价——官方写明 90 万 token 的请求与 9 千 token 的请求按同一个单价计 8。换算成一句话:单次误拦的钱小到可以忽略,会让账单变形的从来不是误拦,是次数。
被拦请求消耗的不只是钱,还有限额。 官方文档给的档位是:Fable 5.x 每分钟 1,000 次请求、50 万输入 token、10 万输出 token;Opus 5.5 与 Opus 5 是每分钟 1,000 次请求、200 万输入 token、40 万输出 token;对多数模型,只有未命中缓存的输入 token 计入输入速率,从缓存里读出来的 token 不计入 9。月度花费上限分三档:500 美元、1,000 美元与 20 万美元,自定义档位没有上限 9。把两组数放在一起看,收费与限额是同一次动作的两个刻度:账单按输入 token 增加,速率也按输入 token 消耗,而被拦的请求把两份都吃掉一份。
公告里的词和账单上的行,不是同一套名字。 那条帖点名的三样是 biology、distillation attacks、frontier LLM development 1。计费表里对应的三行是
bio、reasoning_extraction、frontier_llm:生物学对 bio,前沿 LLM 开发对 frontier_llm,而蒸馏攻击对的是 reasoning_extraction。这条对应关系是我根据三份官方文本拼出来的,因为官方从未在任何一处写清「蒸馏攻击」等于哪个类别值。拼它的依据是:客服文档把三类被计费的对象写成「生物学、蒸馏或前沿 LLM 开发安全分类器」,而计费表里恰好也是三个 Yes;客服文档另一处又把蒸馏拦截与「检测并直接拦下抽取模型内部推理的尝试」写成同一件事,并说「蒸馏类拦截不会回退到另一个模型,请求被直接挡住」10。系统卡里,这一类被写成「防止模型蒸馏的分类器,例如试图抽取模型隐藏的推理」11。这个名字的来历还能往前追一段。
reasoning_extraction 这个类别值是 6 月 9 日随 Fable 5 一起加进 API 的,当时的发布说明把它定义成「请求在商业条款对逆向工程或复制模型输出的限制下被拦时返回」2;到今天,官方文档对这个类别的说明只剩一句「请求要求模型在回复文本里复现它的内部推理」,并建议改用结构化的思考输出 6。从「逆向工程」到「蒸馏攻击」,中间那层说明消失了,而它恰好是决定一个普通团队会不会撞上它的那层说明。客服文档给的实际边界更可用:被拦的是「要求 Claude 逐字重复它的推理,或把完整的思维链写到外部输出」,而「让 Claude 解释它的推理、教你一个概念、走一遍代码评审」以及「它为什么这么做」这类追问不受影响 10。frontier_llm 那一类的依据落在商业条款的 D.4 条:客户不得「为构建竞品而访问服务,包括训练竞争性 AI 模型」,也不得「逆向工程或复制服务」——条款里没有「蒸馏」这个词,也没有「前沿 LLM 开发」这个说法 12。而「蒸馏」在可接受使用政策里另有明文:「未经 Anthropic 事先授权,使用输入与输出训练 AI 模型(例如『模型抓取』或『模型蒸馏』)」13。还有一层触发面,可能比提示词本身更值得注意。 客服文档写明,这些检查看的不只是你最新那条消息,还包括模型读到的所有东西——记忆、连接器里的内容、网页搜索结果、文件,所以一次拦截可以由你根本没输入的内容触发 10。
同一个改动,在订阅用户和 API 客户身上不是一回事。 客服中心那两篇讲的是产品面上的自动切换:Claude 网页版、移动端、桌面端、Cowork、Claude Code、Claude Design、Claude for Microsoft 365、Claude Tag,Opus 那篇还多一项 Claude Science;API 客户必须自己开启并配置回退,在配置之前,模型只会返回一个 200 与一个停止原因 14。所以订阅用户感受到的是拦截与模型切换,账单那一层主要落在 API 客户身上。文档里还留着一条同一时间线的痕迹:两份客服文档的最后修改时间是 9 月 24 日 16:34(UTC),比那条帖早了约 37 分钟 1014——规则先写进文档,公告后发到社交平台。
为什么现在收费,官方给的答案不是成本,是攻击。 帖里的原话是「近几周我们看到一些针对我们系统的协同攻击,这是防御的一层」1。这条帖没有点名任何一件事,但在它之前半个月里,有两条可核的公开记录指向同一个方向。9 月 8 日,美国网络安全和基础设施安全局发布公告 AA26-251A,标题直接写「总部在中国的 AI 公司对美国 AI 公司实施工业级蒸馏行动」,点名 DeepSeek、Moonshot AI、阿里巴巴、MiniMax、StepFun 与 Z.AI 六家,称其「可能在中国政府知情的情况下,通过数以百万计的交互与请求抽取了数十亿 token」,目标覆盖 Claude、GPT、Gemini 与 Grok 的多个版本,时间可追溯到至少 2024 年末 15。9 月 10 日,Anthropic 自己的九月威胁情报报告给出了同主题的内部数字:自 2026 年 2 月以来,公司检测并打断了「可高置信度归因于特定中国实验室」的未授权蒸馏行动,目标都是 Opus 级模型;它把蒸馏与网络、影响力、监控、诈骗、生物滥用、常规武器并列为七类危害之一;报告里最大的一次行动归给阿里巴巴,2026 年 5 月到 7 月间超过 1.51 亿次交互,峰值接近每天 300 万次,来自 3,500 多个欺诈账号,收割的是 Opus 4.6 与 4.7 的思维链推理记录;Moonshot 同期超过 2,300 万次,DeepSeek 在 7 月的 14 天里超过 1,210 万次 1617。同一份报告还记录了一种手法:Moonshot 保存 Claude 回复里的推理签名,开一个新会话,再让模型把签名还原成完整的推理轨迹——报告把这类做法叫跨会话回放。这条因果链是推论,不是官方口径:那条帖既没有引用这份报告,也没有引用 CISA 的公告,两边的主题与时间吻合得很好,但 Anthropic 从未把它们连起来说;状态页也帮不上忙,9 月 24 日当天它的记录是「今天没有事件报告」,此前两周的条目全是技术故障 18。
要看懂这套逻辑,得先知道误报在这家公司是被设计出来的。 6 月 30 日那篇《Redeploying Fable 5》里,Anthropic 解释了它的分类器怎么工作:分类器会故意在那些它知道很可能良性的请求上触发,官方把这一圈叫作「安全边际」,并说明用户感受到的就是「模型拒绝回答一些合理、无害的请求」19。8 月 7 日那篇写得更直接:Fable 5 发布时几乎屏蔽了所有生物学提问,公司当时就知道「这会在短期内造成大量误报」,但选择接受这个交换;同一篇还给了那次调优的相对效果——生物学相关的回退减少约 85%,回退总量在 Claude.ai 上减少约 67%、Cowork 上 55%、Claude Code 上 17%、Claude Platform 上 7% 4。
这两段放在一起,「0.1% 以下的误报率」和「99.7% 的账号没碰到」就有了准确的位置:误报不是这套系统的缺陷,是它的安全边际在正常工作。 而 6 月那篇里还有一句和本次收费同源的话——官方说,分类器让成功的越狱变得「非常昂贵、非常费力」19。收费是同一件事的另一半:让试图越狱的人也付出成本,而不只是让成功越狱的人付出成本。
这条防御逻辑的前一站,是一次下架。 6 月 12 日,美国政府把出口管制加在 Fable 5 与 Mythos 5 上,要求限制外国公民访问;因为命令立即生效、公司又没有实时核验国籍的办法,Anthropic 对全部用户暂停了这两个模型。事情的起点是亚马逊的研究者找到了一个绕过 Fable 5 保障措施的方法:提示模型找出若干软件漏洞,其中一次它给出了利用该漏洞的示例代码。公司随后训练了一个新分类器专门挡住这个行为,并明确写到这会带来代价——在常规编码与调试任务上会更频繁地误标良性请求。6 月 30 日管制解除,7 月 1 日模型恢复上线 19。这段前史对本文的意义在于它给出了行为模式:出现绕过手法,就去加强分类器,并公开承认误报会上升。恢复计费是同一条线上的下一步,只是这一次上升的不再只是拦截数,还有账单。
回退那条路,是一次回答两份账。 文档写明:触发回退时,那条拒答本身要计费(只要它属于计费类别,或者它是在中途拦下的),回退请求另算一次;官方为此发一个回退额度(fallback credit),抵的是回退请求在另一个模型上重写提示词缓存的那笔差额,让重试被「当作这段对话本来就在新模型上」来计费 6。这个额度的限制不少:它在拒答后五分钟失效;只能由收到拒答的那个组织与工作区兑换;它是无状态的,服务端不留记录,也没有查询或撤销的接口;批量请求里的拒答不发这个额度,而且额度只对直连 Messages API 的请求生效,批量请求带上它也会被忽略 20。要拿到它,重试时必须原样带回 system、messages、tools、tool_choice、thinking、cache_control 等字段和同一组 beta header,不能像平常那样把 thinking 块剥掉 20。另外,服务端记住了这次回退之后,同一段对话在约一小时内会直接走回退模型,省掉那次注定会被拒的尝试 6。还有一处区别值得单独记下:蒸馏类的拦截没有回退模型,请求被直接挡住;生物学与前沿 LLM 类的拦截会回退到 Opus 5,网络安全类回退到 Opus 4.8 11。
谁会先被算到。 按官方自己的描述,三类里每一类都写着「良性的工作也会触发它」:生物类会拦住正当的生命科学研究与临床问题,前沿 LLM 类会拦住普通的机器学习工作,而
reasoning_extraction 会拦住那些把思维链当产品输出的用法——推理可视化的教学工具、要求模型「把步骤写出来」的评测脚本、把思考过程当作可审计日志的 agent 框架,都会撞在这条线上。计数上还有两个细节:文档说每一次尝试都分别计费、也在各自模型上分别扣速率限额,而 fallbacks 参数不会传进工具执行里发起的模型调用 6。也就是说,一个跑子 agent 的编排框架,要为每一个子调用单独配好回退,否则最可能被拦的那些调用恰好没有保护。首日的地面实况,比公告安静得多。 在美国开发者最集中的那个论坛上,这件事只有一条帖子,发帖时间在公告之后一小时三十一分,到当天 19:08(UTC)为止拿到 4 分、2 条评论;同一天同一个论坛上,Claude Opus 5.5 的话题是 1,788 分 21。唯一一条有内容的评论给的是反例而不是观点:这位用户说被标成生物类的,是「Use Unicode graphemes」这样一句编程指令;被标成一般有害的,是他没切回英文键盘时敲出的一串俄文乱码——那串乱码此前会被自动转成英文照常执行 21。在原帖下面,被点赞最多的回复是把这件事类比成约会软件的商业模式:
paying for rejection. dating apps have been running this business model for years;点赞第二高的一条提问是,如果一次拦截后来被确认为误报,这笔费用会不会自动冲销——官方在那条帖里只说了「用 /feedback 报告」,没有说账单怎么办 1。这些是一个小时内的样本,不是舆情统计;但这个样本里没有一个人说自己已经被收过误拦的钱,担心的都是「会不会」。更早一天的记录更值得注意。9 月 23 日,同一个论坛上已经有一条讨论,标题是「Anthropic 的分类器禁止内核开发」,讨论的正是三天后被列入计费的
frontier_llm 那一类,底下有人贴出官方客服文档的原文并追问这句话的边界,还有人担心这会波及自己与模型无关的 CUDA 工作 22。而在公告发出的前 1 小时 38 分,Reddit 的 r/ClaudeAI 版上已经有一条误拦清单帖在积累评论:楼主列出的被拦日常提问包括酒店积分的估值、信用卡转点伙伴、干辣椒板面的吃法、二十五万日元折美元,并强调这些是各自独立的会话;帖内有人指出,触发提示里写的是提取(extraction)警告——也就是这次被列入计费的 reasoning_extraction 那一类 23。宣布收费的那一类,在宣布之前就已经在公开制造误拦。还有一条更早的抱怨,指向的是另一个环节。9 月 5 日,有人在 r/Anthropic 发帖说自己在控制台跑一次 Fable 5.1,两次失败、没有任何可见输出,5 美元余额被扣掉 2 美元;他把客服的原话贴了出来——「只有请求在失败前产生了输出才会收费,回复前就被拒绝的请求完全不收费」——并质问为什么余额会掉 24。这条帖子是社区证据,不是官方口径;但它指出的缝很真实:「没有可见输出」与「没有产生 token」在这个产品上不是同一件事,而这次计费改动正是踩在这条缝上——它给「产生了 token 但没有输出」的那部分请求贴上了价格。
两个安抚性的数字,分母其实不一样。 99.7% 说的是账号——在「近期的测试」里,使用 Claude Code、Claude.ai 或 Cowork 的账号中,有 99.7% 一次都没碰到过这些新增的计费拦截 1。它的谓语是「账号是否至少命中一次」,反过来说就是 0.3% 的账号至少碰到过一次。误报率说的是分类器,而且官方给的措辞是「被调在 0.1% 以下」——那是一个目标上界,不是实测值,官方也没有定义它的分母是什么 1。所以这两个数字之间不存在换算关系:一个是账号层面的「有没有碰到过」,一个是分类判定层面的准确度;账号命中率会随每个账号的请求数单调上升,而误报率是逐次事件的比率。账号没碰到,不等于请求没被误拦。
把这两个数字放在一起,还能看出一个更具体的缺口。假设每个账号在测试窗口里平均发出 n 条请求、单条请求触发分类器的概率是 p,那么「账号至少命中一次」的概率大约是 n 乘 p。如果 p 真的只有千分之一,那么只要平均每个账号发出约 3 条请求,账号命中率就会到 0.3%。反过来,如果窗口里账号的平均请求数远大于 3,那么真实命中率就必须远低于千分之一,或者那 0.3% 的账号里大部分是真实攻击而不是误报。这三种解释都能与已公布的数字相容,而官方一种都没有排除;它们分别指向完全不同的结论:一种说窗口里的账号几乎没怎么用,一种说分类器比它自称的更准,一种说被收费的流量确实大部分是该挡的。
官方没有公布的,比公布的多。被拦请求的绝对量、按请求计的拦截率、0.3% 的账号里有多少是真实攻击、99.7% 那个测试窗口有多长、抽样怎么做的、被误拦而计费的请求能不能退款——这几项在官方文档、发布说明、新闻室、状态页和两份系统卡里都查不到 111。同族数字里最接近的实测值来自 Opus 5.5 系统卡的内部评测:在它自己的单轮良性请求评测里,过度拒答率是 API 上 0.03%、claude.ai 上 0.38%,表注写明「数字越低越好」11。这个数字与 0.1% 不在同一个测量体系里,不能直接比,但它说明了一件事:「误报率有多低」这个问题的答案,高度取决于你问的是哪个面。 8 月 7 日那篇给的是另一种口径——只给相对降幅,不给基数——也印证了同一个习惯:这家公司按产品面分别度量拦截,但很少公布绝对值 4。
还有一处需要单独说:同一个文档域名下,两个口径到今天仍然互相矛盾。 主文档写明回复前的三类拒答要计费;而官方那份被主文档列为「相关页面」的回退与计费 cookbook,现网版本里还写着「直接撞上分类器的拦截不计输入 token……这一条已经自动应用在所有生产模型上,包括 Fable 5」25。一个只翻到 cookbook 的开发者,会得出与主文档完全相反的结论,而官方没有说明以哪个为准。
把三家的公开材料并排放,会看到一个不太对称的局面。 截至核验时点,OpenAI 与 Google 都没有公开的、成文的「被安全策略拦下的请求怎么计费」规则:OpenAI 帮助中心那篇《在 ChatGPT、Codex 与 API 中对生物与网络安全请求的额外安全检查》(约 9 月 19 日更新)写清了机制与申诉路径,却通篇不提计费或配额,只说「否则产品可能不返回内容」26;Gemini API 的官方计费页全文只讲层级、预付费、额度上限与退款,唯一出现「blocked」的地方是支付页面的资格提示 27。成文的规则只有 Anthropic 一家有,而它的方向恰好是收费。 社区层面还有一条需要注意的证据:Google 官方开发者论坛上,有开发者报告 Gemini 3.1 Pro 不再在 API 层直接拦下不安全请求,而是往上下文里注入一段隐藏的安全提示、让模型跑完全部推理再输出一段自然语言拒绝,输入、注入的提示、思考与输出全部计费;同一份报告给出的对照是 Gemini 3 Pro 会在 API 层拦下、不消耗 token 27。这是单一用户的报告,Google 没有确认也没有否认,不能当作规则来用;但它说明「被拦的请求要不要付钱」在全球范围内都没有统一答案,而 Anthropic 这次是把它第一次明确写成了条款。
对做产品与采购的人,这条改动的落点在三个地方。 第一,可比成本曲线里多了一项过去不存在的科目:闭源前沿模型的账单上,第一次出现「没有产出、但产生了费用」的流量。做模型选型时,把这一项并进去才能得到真实的每任务成本,而它取决于你的负载长什么样,不是取决于标价——你的提示词里有多少生命科学、多少模型研发、多少要求复述推理,你的平均输入有多长,你的编排框架会不会为每个子调用配好回退。第二,验收口径要改:拒答返回的是一次成功的 HTTP 200,
stop_reason 是 refusal,类别在 stop_details.category 里,所以任何建立在错误率或 5xx 上的监控都看不见它。官方要求把它当成独立信号埋点:每次拒答发一个事件,每次由回退完成的响应再发一个事件,然后对两个计数之间的差额告警;判断分支时要判 stop_reason 或 stop_details.type,不要判 content 或 stop_details 里面的字段,因为那两个字段在没有对应类别时会永久为 null 6。第三,架构上有两条本地规则:别把同一个请求重试给同一个模型(它大概率再拒一次,而两次都记账),以及想要推理就换接口——让模型逐字复述会被拦,改用结构化的思考输出去拿 610。最后是这张表本身的稳定性。 文档明说计费类别会随官方继续测量与调优误报率而变化,「as of September 2026」这句限定语就挂在被计费的那三类上 6;按同一句话往回读,那三类之所以被选中,理由不是它们更危险,而是它们的误报量在被测量之后被认为足够低。价格页还有一处需要小心:它没有自述最后更新日期,抓到的价格不等于某个确切日期的价格 8;商业条款里有一条「改价自张贴之日起 30 天后生效」的约定,但计费口径的调整是否也适用这条,官方没有说明 12。这次改动也没有配套的官方新闻稿,Anthropic 新闻室在核验时最新的条目仍是 9 月 23 日那篇酶发现 28,@AnthropicAI、@claudeai 与 Dario Amodei 的账号也没有转这条帖 2;到 9 月 24 日 19:08(UTC)为止,也没有找到任何一家英文媒体独立报道过它,那两个数字没有任何第三方复核,数字层面的质疑全部来自个人开发者 2123。
需要说清楚的是,这篇文章里的成本数字是估算:算式是输入 token 数乘以该模型的输入单价,单价取自官方价目表,token 量取官方文档的样例与两个自设场景。Anthropic 没有公布被拦请求的平均输入长度,也没有公布被拦请求的总量,所以「所有被拦请求一共花了多少钱」这个问题无法用官方数据回答。批量请求里那些在输出前被拦下的请求是否同样计费,文档也没有写清——它只说明了批量拒答不发回退额度、批量不支持服务端回退,既没有把批量列进计费平台清单,也没有把它排除在外。至于这条规则本身是否有效——它是否真的挡住了协同攻击、误报在收费之后是否下降——现在没有任何一方给出可核对的数据。
References
- 1
- 2Claude Platform release notes
platform.claude.com
- 3Wayback 快照 · handle-streaming-refusals · 2026-05-23
web.archive.org
- 4Improving Fable 5's biology safeguards · Anthropic
anthropic.com
- 5Wayback 快照 · 2026-07-01T19:36:06Z
web.archive.org
- 6Refusals and fallback · Claude Platform Docs
platform.claude.com
- 7Claude on Google Cloud · Claude Platform Docs
platform.claude.com
- 8Pricing · Claude Platform Docs
platform.claude.com
- 9Rate limits · Claude Platform Docs
platform.claude.com
- 10
- 11Claude Opus 5.5 System Card
anthropic.com
- 12Anthropic Commercial Terms
anthropic.com
- 13Anthropic Usage Policy
anthropic.com
- 14Why Claude switched models in your conversation with Opus 5 or Opus 5.5
support.claude.com
- 15CISA 公告 AA26-251A · 2026-09-08
cisa.gov
- 16Countering misuse of AI: September 2026 · Anthropic
anthropic.com
- 17
- 18Claude Status
status.anthropic.com
- 19Redeploying Fable 5 · Anthropic
anthropic.com
- 20Fallback credit · Claude Platform Docs
platform.claude.com
- 21HN 条目 49835073 · 评论树
hn.algolia.com
- 22HN 条目 49811488
news.ycombinator.com
- 23
- 24
- 25Classifier fallback and billing for Claude Fable 5 · Claude Cookbook
platform.claude.com
- 26
- 27Issue: Gemini 3.1 Pro charges tokens for safety-rejected requests · Google 开发者论坛
discuss.ai.google.dev
- 28Newsroom · Anthropic
anthropic.com
Comments