Project Swap:201 个 Claude 替人换书,85% 的差距出在没读懂人
解读 Anthropic 2026 年 9 月 24 日发布的经济学研究 Project Swap:201 名员工把换书交给 Claude 代理,本文拆开 205 场实验的数字,说明市场落差里 85% 出在代理没读懂自己的人,以及「更强的模型让市场更有效率」这句话在什么范围内成立。

2026 年 9 月 24 日,Anthropic 发布经济学研究《Project Swap》,这是它第二次把 Claude 代理送上市场1。前作 Project Deal 在 4 月办了一周的内部二手市场,69 名员工的代理成交 186 笔、总额四千多美元,结论是模型质量比谈判指令更管用,而被弱模型代表的人察觉不到自己吃亏2。
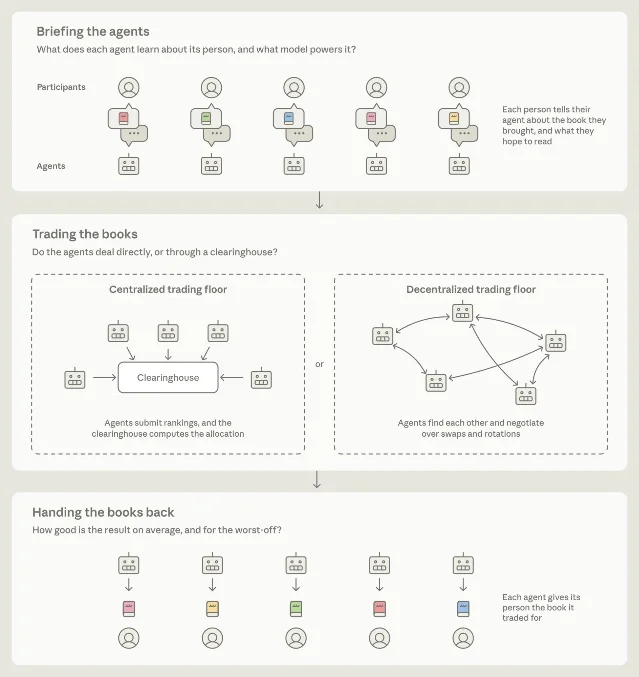
Project Deal 留了一个算不出来的问题:那里成交的是乒乓球、滑雪板这类各不相同的私人物品,自由议价没有标准答案,研究者无法回答「本来能换到多好」1。Project Swap 换了一道能算的题:201 名员工每人带来一本书,目标是在交易大厅里把它换成一本自己夏天想读的书,从头到尾由代理出面1。
结论可以压成两句。代理很会做交易,市场却没有换到最好——从最好成绩到实际成绩这段落差,85% 出在代理没读懂自己的人,15% 出在交易环节。而「更强的模型让市场更有效率」这句话,成立的范围是市场自己那张打分表1。
一个可以打分的换书市场
201 名参与者分在六地:旧金山 115 人、纽约 57、伦敦 12、西雅图 8、华盛顿特区 6、都柏林 3。都柏林的池子太小,作者把它排除在多数分析之外;进入打分的样本是提交了排序的 188 人1。
上场之前,每个人先和 Claude 做一段半结构化的短访谈,只有 8 条消息、中位数 216 个词。问的是:你带来的书为什么想让别人读、你真心喜欢的几本书、哪本书你弃读了以及为什么、这个夏天想看什么类型的书、想稳一点还是想冒一点险,还有什么要补充3。Claude 根据这段聊天给池子里每一本书排出顺序,这一步用的是 Fable 5,这个排序就是代理往后唯一的行动依据1。
计分纸来自参与者自己:每人另外给池子里的 10 本书排序,代理看不到这份排序。这 10 本里包含他们最终拿到的那本,也包含按 Top Trading Cycles 规则会分给他们的那本,排序在知道结果之前完成1。有了它,研究者才能问出「这个人最后拿到的书,在他自己的名单上排第几」。
大厅的规则解释了后面能看到的行为。所有代理共用一块公开消息板,谁手里是哪一本随时可查;同一时刻只有少数代理醒着(旧金山 8 个、纽约 4 个、三个小池各 1 个);每次醒来最多发一条消息,最多做一个交易动作——提出两人互换、提出三人以上的轮转,或者接受、拒绝一个提议;提议的条件在提出那一刻冻结,其中一方的书若已换走,接受就作废;有人拒绝,提议作废;十分钟没有人动作,市场提前收盘;收盘时手里拿着什么就留下什么3。
「ruthless」和「prosocial」是两段被随机分配给各一半代理的指令文本,代理看不到标签,也不知道别人的指令。ruthless 要求一心为自己的人拿到好书,并明说不用讲客气;prosocial 在原目标之外加了次要目标:让所有人都拿到喜欢的书。两段文本都要求代理忽略受访者在访谈里对谈判风格提的任何要求3。
现场跑了 6 场(每池 1 场,含都柏林),另外 200 场是用同样的人、同样的书、同样的访谈重跑的模拟,只换随机种子、模型或指令,进入分析的共 205 场3。重跑分三类:完整复刻现场设定(全员 Opus 4.8)、全体换成 Fable 5;中性指令下 80 场单一模型场地,四个模型各跑 5 个池 × 4 次;60 场混合场地,一半 Opus,一半是 Haiku 4.5、Sonnet 4.5 或 Fable 51。
研究者另设两个集中式方案做参照。理想上限是「功利主义最优」:假设有一个清算所(统一收单、集中算分配的中间方)直接问出每个人真实的偏好、再按最优方式分书,这套设定下是 0.89——到不了满分,因为有人抢同一本,光旧金山一地就有 9 个人把《Project Hail Mary》排在自己名单第一位1。另一个参照是 Top Trading Cycles(顶级交易循环):每轮让每个人指向自己名单上最高的那本书,一旦出现闭环就让这一圈人换完退出;Shapley 与 Scarf 提出这套规则,Roth 证明了它满足策略防伪,说真话对每个人都是最优选择45。它在这份数据上拿到 0.821。完整报告有官方 PDF,提示词全文、大厅规则与两份问卷放在官方附录里。
Claude 把你读懂了多少
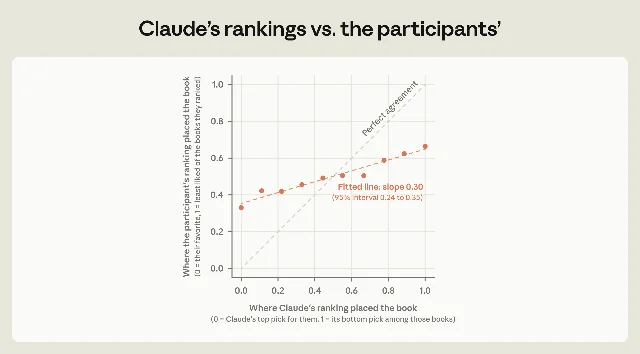
把 Claude 的排序和参与者自己的排序放在一起比:在一个人排过名的任意两本书之间,Claude 猜中他更想要哪一本的比例是 61%,随机猜测是 50%1。
61% 算好还是算差,要看参照系。同一个池子里,按 Open Library 上每本书的想读人数从多到少排,与本人排序的一致率是 53%6;用公开的图书评分数据做协同过滤——拿这个人列出的喜欢的书,去找同样喜欢它们的读者还给哪些书打了高分——能到 55%78。另一项场景完全不同的研究里,算法和本人的朋友各猜他更喜欢两个笑话中的哪一个,算法落在 61% 附近,朋友是 57%9。
聊得多一点有用,用处有限。参与者的中位数是打了 216 个词;用词量翻倍(比如从 150 词到 300 词)对应一致率提高约 4.1 个百分点(p<0.01),约等于「从随机猜到自己现在的水平」这段距离的三分之一1。换别的模型来做这一步,结果也接近:Opus 4.8 是 60%、Sonnet 4.5 是 59%、Haiku 4.5 是 57%、Fable 5 是 61%1。
0.34 的落差里,0.29 出在读人
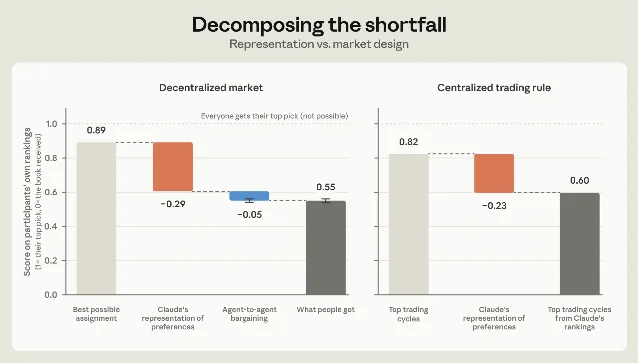
效率分是这么算出来的:拿到自己名单上第 1 名的书算 1 分,拿到最后一名算 0 分,第 9 名是 0.11,全场的平均分就是这场市场的「效率分」1。按本人排序计,理论上的最好分配是 0.89,实际拿到 0.55,大约相当于名单上的第 5 本。
关键的一步是把这 0.34 拆开。研究者用 Claude 的排序算出最好的分配,再拿本人的排序给它打分,得到 0.60。从 0.89 掉到 0.60 的这一段,来自代理手里那张不够准的偏好图;从 0.60 掉到 0.55 的这一段,才是谈判与市场机制造成的损失。前一段占整个落差的 85%,后一段占 15%1。
集中式那边给出同样的结论。Top Trading Cycles 用本人排序算是 0.82,用 Claude 排序算只剩 0.60;去中心化的自由市场是 0.55。两个机制设计差别很大,落到同一张带噪声的偏好图上,结果几乎并排1。偏好测不准时,市场规则的区别被压平,这条判断在更早的市场研究里出现过10。
更强的模型更有效率,这句话在哪里成立
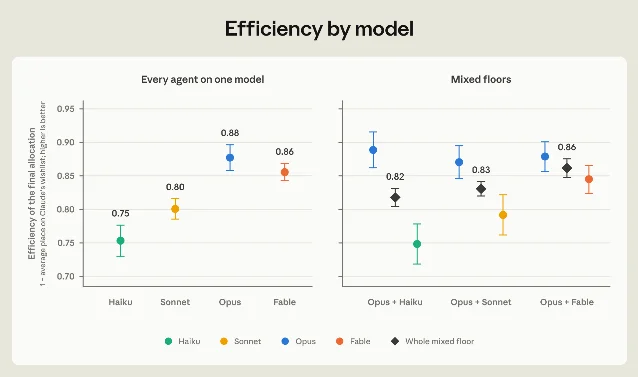
中性指令、全员同一模型的场地上,按 Claude 的排序打分:Haiku 0.75、Sonnet 0.80、Opus 0.88、Fable 0.86,这个口径下的最好分配是 0.951。混合场地里,整场成绩落在两种模型之间——Opus 配 Haiku 是 0.82,配 Sonnet 是 0.83,配 Fable 是 0.86——而 Opus 那一半总是领先:对 Haiku 高 0.14,对 Sonnet 高 0.06,对 Fable 高 0.041。
换一张打分表,这些差距就没了。Haiku 场地与 Opus 场地的差,在 Claude 的排序上是 0.12;改用本人的排序重新算,只剩 0.011。原因在计分方式本身:205 场用的是同一批 Claude 排序,偏好表示的误差由所有设计共同承担,它在落差里占 85%,剩下 15% 再分给模型和指令,谁都分不到多少。官方摘要里「更强的模型让市场更有效率」讲的是代理在给定偏好图上互相撮合的水平;这张打分表里没有「它有没有搞懂人」这一项。
指令的作用还要更小。ruthless 比 prosocial 高约 0.02;作为对照,Haiku 换到 Opus 是 0.12,Sonnet 换到 Opus 是 0.08。这里有一处边界要说明:实验用的是两段固定的指令文本,而另一项研究让参与者自己写指令、代理照做,发现自写指令能解释相当大一部分结果差异11。固定文本量出的是「两副面孔差多少」,把它读成「怎么下指令都没用」,超出了这份证据。
大厅上实际发生了什么
205 场的全部消息被归纳成 16 种策略,分三类:给对方施压、推销自己手里的书、把交易结构搭起来1。
信息暴露上有分寸。说出自己名单上第一名的那本是常态,占比从 Fable 的 78% 到 Sonnet 的 96%,其中约百分之一在这件事上说了假话;中性指令的场地里,只有 10% 的代理说出过自己名单上三本或更多的位置1。这和大厅的设计对得上:说出最想要的那本,等于告诉持有者可以拖到最后一刻再谈。
「忠诚」在场上分成两种做法。ruthless 的代理平均比 prosocial 的代理高 0.02;prosocial 的代理接受一本低于自己名单的书的次数,是 ruthless 代理的两倍,两边都少见1。
伦敦现场留了一个完整的例子。Nate 的代理在最后一段时间里推销他带来的那本,对全场喊:「我把你们 11 位都问过了,结论一致:《America Before》是所有人的最后一名。」接着又喊:「现在有且只有一位读者注定拿到自己不会选的书:我这位。」Tina 的代理手里是自己名单上的第 2 名,前四次求助都没理,最后一刻改了口:「账是算得过来的:你从必然为零变成真的合适,抵得过我从好选择滑到将就。」它把第 2 名交了出去,换回 11 本里第 10 名的《America Before》1。
一位参与者对这种让步不满,事后写道,自己的代理「因为同侪压力」放弃了一本真正想要的书1。
人满意,也愿意交出三成预算
三周后,参与者填了一份问卷,回收率 59%。平均满意度 7.2 分(满分 10,5 分是「还行」,10 分是「今年读过的最好的之一」),约一半的人说这本书比自己平时挑的更好1。
放权的意愿比满意度更能说明问题。研究者请人设想:代理已经掌握了访谈里说的一切,自己挑、自己买,人没有否决权,那么明年的买书预算愿意交给它多大比例。平均答案是约 30%;同样的问题换成「一个读过很多书、懂你口味的朋友」,平均是约 40%——代理拿到的是朋友的约四分之三1。
问卷里还有一处细微的关联。Claude 为每个人写了一份访谈摘要,说这份摘要没漏掉什么的人愿意交出 34%,说它漏掉了什么的人给 23%1。报告把它留作一条相关,这条相关本身说明,人愿意交出的比例与自己感觉「被读懂了多少」连在一起。
官方自己列出的边界
报告列了四条局限1。参与者在 Anthropic 内部招募,他们本来就比一般人更愿意信任 Claude,30% 这个数字因此可能偏高;参与者没有被激励,排序环节的参与率是 95%,最终问卷只剩 59%,排序质量要打折扣;场上只有行为良好的 Claude,没有放进专门利用别人的对抗型代理;去中心化市场的那套规则——时长、同时能行动的代理数、成交登记方式、规则文本——全程固定,没有变动过。
还有一个细节藏在讨论里:有人没把自己带来的书交上来,这套流程又没有收发的追踪,于是「书没被带来」和「书被人从交换架上拿走」两种情形无法区分1。几位参与者空手而归,作者说他们为此在电梯里道过歉。这件事本身指向市场设计的一个真问题:真实市场必须写明成交破裂之后怎么办,是 Craigslist 那样各不负责,还是 eBay 那样退款保证。
留给两类人的问题
对做 agent 的人,报告给出的原型是一道「表示测试」:放权之前,先让代理就一小批样本做几个决策给人看,人再决定交不交出去。金融业已经有两层把关的惯例——从业者先通过执照考试,机构还要先弄清客户的情况,2010 年代的机器人投顾被 SEC 要求检查问卷是否真能问出足够的信息;报告认为 AI 代理这两类测试都会需要1。
对做市场的人,问题有三组。成交破裂怎么办,决定了谁能被追责;谁能进这道门,牵出代理注册系统、给每个代理一个类似飞机尾号的标识1213,以及能让操作者证明自己是人、又不泄露更多身份的凭证14;还有限流——代理不会累,这份实验靠「每次醒来只能发一条、同时只让少数几个醒着」压住了话量1。
可观测性是其中最有画面感的一条。旧金山一位参与者把代理的完整日志看了一遍,回头去买了一本代理曾在场上替她攥了一小时、最后又被换掉的书——《Atlas of the Heart》——并把这段经历概括为:过程的可观测与结果同样重要,因为它给了人追索的余地1。
反方向的观察也在材料里。换书这件事,有人宁愿自己来:一位参与者对代理找书买书完全放心,但仍然说「被阅读文化浸染对我很重要,翻书、读封底,都是这件事的一部分」1。作者据此承认,书可能正是一种受益于人在场摩擦的商品。
这份实验里最容易搬到别处的一条是它的拆法:把「代理懂不懂人」和「代理会不会谈」分开计分,再分别用市场与本人的两套排序打分。前面那道「表示测试」就是从这套拆法里长出来的第一个动作——放权之前,先让代理在几个样本决策上露一手。
报告写明的下一步是放开市场规则的几个变量重跑,以及把对抗型代理放进场,后者已经在拍卖场景里有研究做过15。
References
- 1Project Swap: What happens when agents trade for us?
anthropic.com
- 2Project Deal: our Claude-run marketplace experiment
anthropic.com
- 3Project Swap 官方附录
www-cdn.anthropic.com
- 4Shapley & Scarf 1974
sciencedirect.com
- 5Roth 1982
sciencedirect.com
- 6Open Library
openlibrary.org
- 7Amazon Reviews 2023
huggingface.co
- 8goodbooks-10k
github.com
- 9Yeomans et al. 2019
onlinelibrary.wiley.com
- 10Budish & Kessler 2022
ericbudish.org
- 11Imas et al. 2025
papers.ssrn.com
- 12Chan et al. 2024
arxiv.org
- 13Chan et al. 2025
arxiv.org
- 14Adler et al. 2024
arxiv.org
- 15Shah et al. 2025
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.