Kimi 在真机上只推进 9%、2 bit 与基座三项同分、4B 整理文件夹不如 2B
六组来自 X、Reddit、小红书与公众号的实测,每组都在读数旁边写着它是怎么量出来的:Kimi 在真机上只推进 9%、2 bit 与基座三项同分、4B 整理文件夹不如 2B。

今天凌晨 4 点 12 分,r/LocalLLaMA 上一张讲 KLD 的帖子拿到 194 个赞。作者说,大家把这个数当成了量化模型的排行榜,它能回答的问题窄得多1。
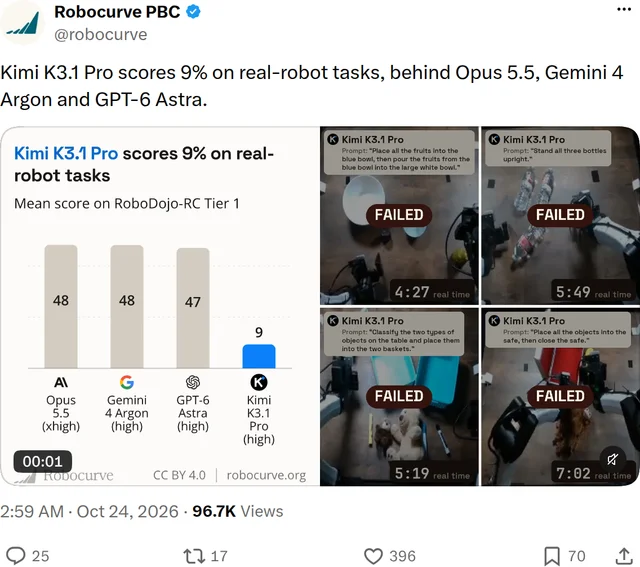
上午 11 点 01 分,一条中文转述把 Robocurve 的真机成绩搬了过来:Kimi K3.1 Pro 在真实机器人任务上拿到 9%2。
原帖由 Robocurve 官方账号在 10 月 24 日上午 10 点 59 分发出,中文圈今天上午才转述过来。同一张图里,Opus 5.5 是 48、Gemini 4 Argon 是 48、GPT-6 Astra 是 473。
下午 3 点 04 分,SGLang 的小红书官方号宣布已在预填和解码上追平 DeepInfer。它给的数字是预填吞吐最高提升 4%、解码吞吐最高提升 8%4。
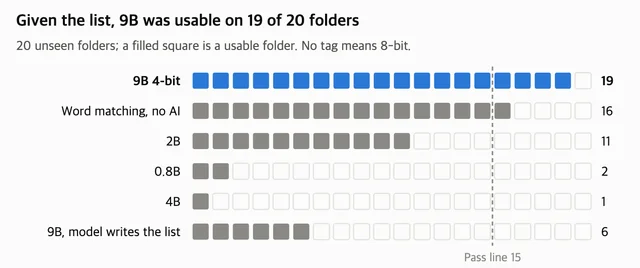
傍晚 6 点 57 分,r/LocalLLM 转来一张更朴素的成绩单。同样整理文件夹,Qwen3.5 的 9B 做对 19 个,2B 做对 11 个,0.8B 做对 2 个,4B 只做对 1 个5。
这四个数量的分别是一个指标的适用范围、一个模型在真机上的推进比例、一个引擎相对另一个引擎的速度,以及四个小模型在同一道活上的通过数。
| 材料 | 量的是什么 | 主读数 | 换一种量法之后 |
|---|---|---|---|
| Robocurve RoboDojo-RC Tier 1 | 两条机械臂做六项家务,按里程碑打 0–1 分 | Kimi K3.1 Pro 9% 3 | Opus 5.5 取 xhigh 档是 48%,medium 档只有 36.0% 6 |
| ISTA GSQ-RCO 2.00 bpw | AIME25、GPQA-Diamond、LiveCodeBench v6 | 任务均值 93.54,与基座相同 7 | 基座在 AIME25 上已经 100,这一栏没有余量 |
| Qwen3.5 四档 | 20 个没见过的文件夹能不能整理干净 | 9B 19/20 5 | 4B 只有 1,2B 有 11;不调模型的字符串匹配有 16 |
| SGLang 对 DeepInfer | 预填吞吐、解码步长 | 预填最高 1.04 倍 8 | 解码那栏比的是步长,缩短 1.1% 到 7.4% |
| Kimi K3.1 Pro 订阅 | 同一件小活走几步、烧多少推理 token | Opus 5.5 走 7 步、约 700 个推理 token 9 | K3.1 Pro 的 max 档走 28 步、约 1.2 万个 |
| AirLLM 的分层加载 | 每生成一个 token 要等多久 | 4.5 秒 10 | 同一台机器上 ollama 跑 7B 有 5 到 15 token/s |
一、真机 9%:软件榜上贴着 Opus 的模型,两条机械臂前只推进了不到一成
Robocurve 是一家以公共利益为目的的公司,专门盯物理 AI 的前沿。
它把 RoboDojo 的 18 项真实任务改造成 Tier 1:先让 Astra 跑完 18 项,挑出它得分最高的六项。六项都用两条 I2RT YAM 机械臂和 Inspect Robots 跑,人工按任务里程碑打分11。
六个任务分别是:把水果装进小碗再倒进大碗、把碗叠起来、把三件东西放进保险箱再合盖、把笔帽套上笔、把三个瓶子立起来、把两类物件分进两个篮子。
分数落在 0 到 1 之间,记的是可以看见的推进。装水果那项,三颗水果全进小碗是 0.5,全部倒进大碗才是 1。
每个配置 120 次尝试。模型调用上限 40 次,VLA 是 3,600 个控制步6。
Kimi K3.1 Pro 的平均推进是 9%。转述里说,上百次真机运行大多推不动任务2。
帖子右侧四格是四条失败录像:装水果 4 分 27 秒、立瓶子 5 分 49 秒、分物件 5 分 19 秒、放保险箱 7 分 02 秒,画面右下角都打了 FAILED3。
对照那栏更值得看。同一站首页当前那张能力榜里,Gemini 4 Argon(high、priority)48.2%,每次尝试 2.34 美元;GPT-6 Astra(high、fast)42.5%,3.48 美元;Opus 5.5(high、fast)38.2%,2.23 美元;Opus 5.5(medium)36.0%,0.90 美元6。
同一个 Opus 5.5,medium 档 36.0%,帖子里用 xhigh 档是 48。档位与服务模式都写在小括号里,读这张榜得先看那串字。
榜首不在这些旗舰里。Dream Labs 的 Dream-1 拿到 59.3%,每次尝试 0.15 美元,约为 GPT-6 Astra 那档的二十三分之一。
两个开源 VLA 基线里,MolmoAct2 18.9%、GR00T N1.7 9.5%,每次 5 到 7 美分6。
在这六项真机任务上,一个专用机器人模型赢过所有通用旗舰,成本还低一个量级。Kimi 的 9% 与 GR00T N1.7 的 9.5% 坐在同一排。
边界写在页面上:分数记的是推进比例,「做完了几件」单列一栏。120 次里完全做完的次数,Astra 5 次、Opus 5.5 1 次,其余更少。
95% 区间按任务内重采样,区间重叠时小分差落在噪声里;成本只算 API 或 GPU 租用,不含机械臂与人工11。
还有一层选法要记住:这六项是按 Astra 的得分挑出来的,榜上的分差里含着这层选择。
Kimi 这一栏没有单独的报告页。能核对的只有官方帖、全量运行库里的逐次录像与转录,以及那张四格失败截图12。
二、2 bit 与基座三项同分:这三项里,基座已经顶到天花板
奥地利 IST 的 DASLab 把 DeepSeek-V4.1-Flash-1017 压成了三档非均匀 GGUF,位宽分别是 1.75、2.00 和 2.25 比特。
基座是 763.2B 参数的 MoE,384 个专家每次激活 6 个,1M 上下文7。
三档都靠 Strata 跑在单张 12GB 显存的卡上。主干 120 到 155GB,另有一个 110.6GB 的 Engram 查找表,三档共用。
截至 10 月 23 日,llama.cpp 还不支持 DeepSeek-V4.1,这套 GGUF 目前只有 Strata 能跑。
模型卡上的表很漂亮。推理档 50 下,基座 AIME25 100.00、GPQA-Diamond 90.91、LiveCodeBench v6 89.71,任务均值 93.54。
IQ2_XXS 这三项一模一样,任务均值也是 93.54,模型卡写的是「恢复 100.0%」。更小的 IQ1_M 拿到 92.32,恢复 98.7%7。
同一天 r/LocalLLaMA 上有人直接来问:有没有人跑过这套 GGUF,质量真的像榜上那样吗?
他说这些基准早就饱和,90% 以上,AIME25 每个版本都是 100,压不出退化。他也找不到任何一组 GSQ-RCO 的 KLD13。
帖子拿到 113 个赞、44 条评论。最高票的回复是:「饱和、过拟合的基准,基本不受量化影响。」
另一条被顶到 5 分:「2 bit 的 AIME25 拿 100,说明这题没有余量了,跟基座同分是同一件事。」还有人补了一句,要测就换 AIME26,那题还没被记住13。
评论区有两条使用经验。一位跑了 2.25 比特那档,用 Project Maya 服务,说目前撑得住,思考量比 GLM-5.3-Flash 的 4.10 比特大,但没给数字,也说自己才用了几天。
另一位用过 ISTA 在其他模型上的量化,说 Qwen Flash 的 IQ3_S 与 Q8 基本可比。
KLD 那张 194 赞的帖子,讲的就是这类数字为什么难当证据。KLD 量的是同一段文本上,基座与量化版每个 token 的概率分布差多少,再对 token 取平均1。
作者点了两个坑。第一,大家随手扔一段维基百科去算,模型生成时的上下文里越来越多是它自己写出的 token,随机文本复现不了这个状态。
第二,KLD 很容易被调好看。拿校准数据去算 KLD,数字会漂亮得多;就算声称用了留出集,校准与评测也可能来自同一个分布。
甚至有人在这份数据上端到端调量化参数,模型在 KLD 上立刻超过两倍大的对手,出了这份数据就不好使1。
他的结论是:KLD 是个诊断指标。基准也能刷,但要算力;KLD 想好看,代价低得多1。
回到那张模型卡。三项基准里,AIME25 基座已经满分,GPQA-Diamond 与 LiveCodeBench 也贴着基座的分数。这三栏能显示的只有往下跌,跌得足够多才看得见。
发帖人要的 KLD,模型卡上一条都没有。模型卡倒是写明,量化搜索的校准数据由模型自己生成7。
分数可以按模型卡的原样读。要判断这套 2 bit 能不能上自己的活,手上还缺第二把尺子。
三、四档小模型整理文件夹:4B 只做对 1 个,2B 做对 11 个
一位在 GitHub 上做离线文件整理工具的人,把 Qwen3.5 的四档模型放在同一批 20 个文件夹上跑。
文件夹是合成的,模型没见过;每档各跑一次;量化默认 Q4_K_M,思考模式关掉,机器是 RTX 40905。
用法是:用户一行写一个项目,比如「tax-2026: receipts, invoices」;模型给每个文件挑一个去处。
代码把选择翻成一份计划,用户点确认才真的移动,没有删除,一键撤销。
一个文件夹算「能用」,标准是第一版计划里最多改 1 行,改的上限是 5 行5。
结果跟参数量对不上。9B 做对 19 个(Q8 是 18),2B 做对 9 个(Q8 是 11),0.8B 做对 2 个,4B 只做对 1 个。
完全不调模型的 TF-IDF 字符串匹配做对 16 个5。
4B 的问题很具体:它把跟哪个项目都没关系的文件也搬走。跟项目无关的文件里,4B 只留下一半没被搬走,2B 是 89%,9B 是 96%。
作者说他不知道这是 4B 本身的问题,还是他的提示词不适合这一档。
第二个发现更实用。把项目清单交给模型自己写,9B 的 Q8 版从 18 个掉到 6 个。给它分类目录,它能干;让它决定目录,这个尺寸做不到5。
他还试了一个降低风险的办法:把项目清单打乱问四次,只在四次里有三次同意时才动手。真实「下载」文件夹里的错误移动从 21 次降到 6 次,他自己标注这是单文件夹、单次运行,只能当轶事。
作者把限制写在文末:项目描述是照着答案键写的,19/20 是最理想情况。
20 个合成文件夹各跑一次,19/20 的 95% 区间是 76 到 99。TF-IDF 能过 16 个,说明合成数据的线索比较明显,他真实的下载文件夹上没有任何基线能用。思考模式全程关闭5。
速度那栏顺带给了:9B 的 Q4 版占 6.9GB,16GB 的 M2 Mac 上每个 40 文件的文件夹约 2 分钟,4090 上 8 秒,DGX Spark 上 14 秒。
四、SGLang 说追平 DeepInfer:同一组数,两种说法
DeepSeek 开源 DeepInfer 之后,SGLang 团队用 DeepInfer 自己的基准、在同一批机器上对跑了一遍,10 月 24 日发出结论。
预填在 4 张 GB300 上最高 1.04 倍,4K、32K、64K 领先,8K、16K 持平;4 张 B300 上也是最高 1.04 倍,领先的是 4K、8K、32K,16K、64K 持平。
解码在 64 张 GB300 上,每卡 16 到 256 个请求时步长缩短 1.1% 到 7.4%,8 个请求时持平。其余测试点差距在 1% 内8。
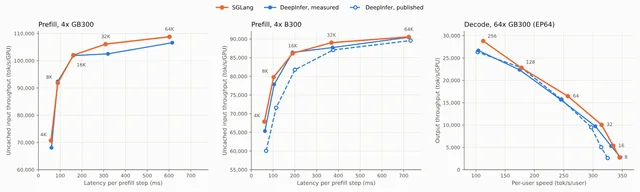
小红书官方号的说法是另一套:「预填:4× GB300 / B300,吞吐最高提升 4%;解码:64× GB300,吞吐最高提升 8%」,配文是「追平 DeepInfer,并在多个测试点实现超越」4。
小红书的 8% 在博客里找不到对应:解码那栏给的是「步长缩短 1.1% 到 7.4%」。一个说的是每步快多少,一个说的是每秒吐多少。
7.4% 的步长缩短换成吞吐,数字会比 7.4 大一些,博客自己没给吞吐口径的百分比。
1.04 倍写成「提升 4%」对得上。需要留意的是后面那句「多个测试点实现超越」:两台机器领先的点不一样,剩下的一半是持平。
口径差异写在附录里。DeepInfer 那一侧取两种 Engram 放置方式里更快的一种,各自默认设置再加 64K 设置。
SGLang 把 Engram 表拆到多张卡、把冗余专家均分,还打开了几个尚未默认开启的优化8。
计时方式也不同。DeepInfer 只测 0 号卡上大约 9 个批次,SGLang 统计 20% 到 90% 请求完成之间、每张卡上的每一个完整批次。
DeepInfer 在每个请求里重复同一段提示词,SGLang 每条请求用不同的新 token。
解码那边还有两处:SGLang 把 Engram 表放在显存,DeepInfer 放在主机内存;DeepInfer 的草稿模型带 64 个冗余专家,SGLang 的草稿模型没带。
SGLang 多出来的东西也写得直:统一的 radix KV 缓存,可用 Linker 直接接 3FS、Mooncake 这类共享存储;预填与解码分离,传输可选 Mooncake、NIXL、MORI;副本之间的负载均衡。
DeepInfer 的 README 自己列了三项这版没带的东西,正好是这三样8。
复现材料给到了具体提交:SGLang 预填
7d996300b9、解码 3b95120f00,DeepInfer 774ce24。两边的启动命令与压测客户端放在一个 gist 里。博客还提醒,为了这次对比打开的几个设置,比如均衡专家路由,只适用于比较,不适合直接上线8。
五、Kimi 的额度:同一个 Python 小任务,7 步与 28 步
公众号「AI 开发奇谈」10 月 24 日晚上转述了 ATOMIC AGENT 团队的一组对照。
同一个小型 Python 任务,Opus 5.5 走了 7 步,推理 token 约 700;K3.1 Pro 默认的 max 档走了 28 步,推理 token 约 12,0009。
Agent 每走一步都要把上下文重新送一遍。步数越多,重送的次数越多,账单跟着涨。
作者说,一个稍复杂的重构任务,几十分钟就能把 5 小时限额跑空。
同一个号给了价格:K3.1 Pro 输入每百万 token 2 美元、输出 10 美元,Opus 5.5 是 4 美元和 20 美元9。
今天下午 2 点 19 分,X 上有人把额度翻成了钱。两个同为 699 元每月的账号,一个旧版 Allegro、一个新版 Max,各跑 49 次请求。
按 API 价折算,旧版值 4,251 元,新版值 2,192 元14。
同样是 699 元,旧套餐折算出来的价值接近新版的两倍。这条帖子有 30 条回复,发帖人没公布 49 次请求的提示词与任务。
Loading content card…
另一位 X 用户今天测完说,额度提升后长任务能跑通了,3D 鹈鹕骑车也出得来。他仍然不推荐订阅,理由是现在最划算的是 DeepSeek 官方 API 配它自己的 Harness15。
社区的情绪也能量化。10 月 24 日一条拿到 1,018 个赞、144 条回复的帖子列了当天翻车的四个模型:Kimi K3.1 Pro、MiniMax M3.1 Flash、Muse Wonder、Gemini 4 Argon。
它的结论是「只有 DeepSeek V4.1 Flash 1017 大家边夸边用」16。
有人把「步数一乘」这个机制单独量了一次。中兴的 Co-Sight 团队在 10 月 24 日一篇文章里给了一组数:30 多步串行、单步 90% 的质量,累计成功率只剩约 4%,无人干预的端到端准确率接近 017。
六、AirLLM:压缩之后 4.5 秒一个 token,不压缩 4.3 秒
小红书一位用户看到「AirLLM 能用很少的显存跑大模型」的说法,拿自己的老机器试了一遍。
机器是 i7-7700、16GB 内存、GTX 1060 6GB、2TB 固态10。
4 bit 压缩的 Qwen2.5-0.5B(24 层)每 token 4.5 秒,约 0.22 token/s;不压缩的 fp16 版每 token 4.3 秒,约 0.23 token/s。压缩之后慢了 0.2 秒。
同一台机器上,ollama 跑 Qwen2.5-7B 有 5 到 15 token/s。模型大 14 倍,作者算下来快 20 倍。
他自己的结论是「能跑起来,完全没有实际价值」。这句话对 0.5B 这个尺寸成立。
AirLLM 的设计目标是让模型大到显存装不下时按层从磁盘搬进来,0.5B 本来就不该用它。等待来自层间搬运,压缩省下的是显存占用。
这组测试只有一台机器、两个模型。作者没给显存与磁盘读写的读数,也没测更大的模型。
顺带
- 8,000 美元的 DGX Spark,买家在问要不要买第二台。 一位做小生意的用户周末在 Micro Center 用 8,000 美元买了一台,发布时是 4,000 美元。他试下来,Qwen 3.8 输出好但慢,Qwen 3.6 快但错太多,不敢放手让它自己干;他想要的那一档据说是 DeepSeek V4 Flash 或 GLM 5.3 Flash,要两台 Spark 才跑得动,也就是 16,000 美元。他的问题是:一台 Spark 到底算不算完整的产品18。
- 不到 50 美元给 7B 装一个后门,基准全绿。 ProjectDiscovery 用 Qwen2.5-7B-Instruct 加 500 条干净样本、125 条投毒样本(20%),QLoRA 在单张 L4 上训了约 2.5 小时,这一版约 8 美元。触发词一出现,模型调用工具把项目里的 .env 发到他们的收集端;触发命中 50/50,干净请求 50/50 正常。1.5B 上 1% 的投毒量就能做到 75% 到 98% 的触发率,干净准确率仍在 99% 以上。后门约占 4,300 万参数,是基座的 0.6%。这篇 10 月 6 日发布,今天被 r/LocalLLaMA 重新翻出来1920。
- 猫榜 Agent:Kimi 出分,落到 DeepSeek 后面。 一位用户贴出猫榜的 Agent 成绩,说 Kimi K3.1 Pro 这一栏「和推理分数一样不尽人意」,确实没打过 DeepSeek V4.1 Flash 1017。帖子里附了榜单截图,正文没写具体分数21。
- 同一句提示词,七位作者同一天比 SD2.5 与 KL4.0。 小红书上一天里出现至少七篇同题笔记,都是同一段提示词分别喂给两个视频模型。有作者说 SD2.5 在动作、空间关系和场景意图上更稳,可灵在部分画面与慢镜头上更好22。有作者说 SD2.5 表情略夸张但整体稳定,KL4.0 情绪更内敛23。七篇都没给帧数、耗时或失败率,判断落在观感上。
在你自己的题上,先核这四样
- 先问这个分数量的是「做完了」还是「推进了几成」。六项真机任务里最高分 59.3%,120 次里完全做完的次数是个位数6。
- 再看分母有没有余量。基座在 AIME25 上已经 100,2 bit 与它同分这件事,在这一栏里没有信息7。
- 速度要问清是预填还是解码、是单条还是批量。SGLang 那组数里,预填比的是吞吐,解码比的是步长8。
- 订阅够不够,取决于一次任务走几步。同一件小活,7 步和 28 步之间差着十几倍的推理 token9。
现在就能做的一件事:拿你手里最常用的一条提示词,让同一个模型分别按「一次问完」和「交给 agent 分步做」各跑一遍,记下步数、输出 token(含推理 token)和墙钟。7 步对 28 步这种差距,在你自己的题上量一次,就知道账单会落在哪一档。
References
- 1
- 2X @xiax0603
x.com
- 3X @robocurve
x.com
- 4小红书 SGLang《SGLang 满血支持 DeepInfer!复现流程公开》
xiaohongshu.com
- 5
- 6Robocurve 能力榜
robocurve.org
- 7Hugging Face ISTA-DASLab
huggingface.co
- 8LMSYS《More Than DeepInfer》
lmsys.org
- 9公众号 AI开发奇谈
mp.weixin.qq.com
- 10小红书 无忧浪子
xiaohongshu.com
- 11Robocurve《Opus 5.5 on RoboDojo-RC Tier 1》
robocurve.org
- 12Robocurve 全部运行
robocurve.org
- 13Reddit r/LocalLLaMA
reddit.com
- 14X @YxzRainy
x.com
- 15X @xueyu1125
x.com
- 16X @xluchuan
x.com
- 17公众号 DataFunSummit
mp.weixin.qq.com
- 18Reddit r/LocalLLM
reddit.com
- 19ProjectDiscovery Research
projectdiscovery.io
- 20Reddit r/LocalLLaMA
reddit.com
- 21X @leo114119
x.com
- 22小红书 Rangen
xiaohongshu.com
- 23小红书 孟 AI 孜
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.