摘要一压,22 个能做完的修复丢 1 到 14 个、工具一坏完成分从 8.08 掉到 3.23、有人在场的多智能体低 28 分:10 月 19 日–10 月 25 日三篇大模型论文
导读 10 月 19 日–10 月 25 日新挂出的三篇论文:把历史压成摘要为什么会丢掉做了一半的修复、工具故障下换更大的模型为什么不管用,以及有人在场的多智能体为什么比单体更差。

本期覆盖 2026 年 10 月 19 日至 10 月 25 日首次在 arXiv 公开的大模型相关论文。
编制时 arXiv 的公告索引收录到 10 月 23 日(周五)提交的条目,10 月 24 日与 25 日的投稿尚未公告。逐条比对的是窗口内的周一到周五:cs.CL 570 条、cs.AI 1,058 条、cs.LG 1,000 条,按 arXiv ID 去重后 2,006 条,其中 1,913 条是 v1 新提交。
三篇入选论文分别落在智能体系统的三层:历史怎么压、工具坏了怎么办、多个智能体怎么分工。三篇量的是同一件事——多花的那部分成本换回了什么。挑选标准是问题说得清、实验能复述、结论能换成工程师和产品团队用得上的判断。
本期三篇
| 论文 | 方法类型 | 一句话结论 | 提交日期 |
|---|---|---|---|
| Compact-Bench: Measuring What Context Compaction Costs Long-Horizon Coding Agents | 配对续跑基准 | 完整历史换成摘要后,14 个摘要模型在 22 个「能做完」的修复上丢了 1 到 14 个;摘要里留下信息与任务能不能做完是两件事。1 | 10 月 22 日 |
| Tool-Calling LLM Agents Under Realistic MCP Faults: Scale Does Not Purchase Fault Tolerance | 故障注入实验 | 按真实 issue 分布注入工具故障,完成分从 8.08 掉到 3.23;120B 与 20B 保住的份额没有差别。2 | 10 月 23 日 |
| Does Multi-Agent Collaboration Pay When Agents Serve Users? Testing Agent Scaling in Dual-Control Settings | 预注册对照实验 | 有人在场的三个域里,多智能体在 13 个格子中 12 个更差,加权平均低 28 分,成本是单体的 1.4–3.1 倍。3 | 10 月 20 日 |
1. 历史一压成摘要,做了一半的活可能就没了
元信息
Compact-Bench: Measuring What Context Compaction Costs Long-Horizon Coding Agents
作者:Ruopei Sun、Jianfeng Cai、Kangwen Zhao、Wengang Zhou、Houqiang Li(中国科学技术大学)
论文:arXiv:2610.31710v1 · 2026 年 10 月 22 日提交 · cs.SE / cs.AI。4
要解决什么问题
长任务里的编码智能体,上下文很快被塞满:用户指令、工具返回、测试输出、做过的决定,一样都不能少。
窗口满了,通行做法是把它压成一段摘要,对话接着跑。Claude Code、Codex、Gemini CLI、opencode、Kimi Code 这些编码工具都带这一步,作者把它叫作上下文压缩。4
摘要要扛住的不只是信息,还有「做到哪一步」:哪条假设已经被排除,接下来该动哪个文件,哪个测试还没过。这些东西不在仓库里,只在历史里。4
此前的评测看三样东西:效率、留住了多少信息、端到端成功率。三样都把「换掉历史」这一步混在别的变化里,看不出它单独造成多少损失。4
作者要问的是一个可以隔离的问题:同一个任务、同一份仓库状态,只把完整历史换成摘要,续跑的结果会差多少?
方法是什么
Compact-Bench 的做法是把两条续跑并排放。
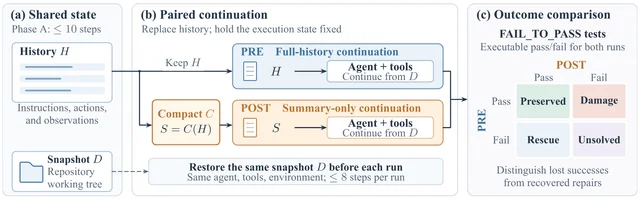
先让智能体在仓库上跑最多 10 步,留下历史 H 和一份仓库快照 D。然后分两条:PRE 拿完整的历史继续跑,POST 只拿压缩后的摘要继续跑。
两条用的智能体、工具、环境、步数预算(8 步)全部一致,跑之前都把仓库恢复成 D,最后用仓库自带的一组测试判成败。4
判定分四类:都过算保住,PRE 过而 POST 挂算损伤,PRE 挂而 POST 过算救回,都挂算没解。损伤与救回分开记,几个修复变好抵不掉另几个变坏。
数据是 35 个 SWE-bench 修复(来自 pytest、sympy、xarray、pylint、requests、sphinx、flask 七个仓库),加 146 段真实智能体会话,加 106 条带真实压缩的生产链。摘要分别由 14 个模型生成,其中 22 个「完整历史能修好」的实例是分母。4
结果说明了什么
损伤率随摘要模型差了 12 倍。Claude Opus 4.8 只损伤 22 个里的 1 个(5%),Kimi-K3 与 GPT-5.6-Luna 各 4 个(18%),DeepSeek-Flash 损伤 14 个(64%)。14 个模型整体落在 5% 到 64% 之间。4
第一轮被判损伤的 126 个「实例 × 模型」组合里,有 120 个在三次重跑中至少两次复现,这排除了随机波动。4
提示词的影响不比模型小。固定 Kimi-K3 做摘要,五个生产压缩提示词的结果是:
| 压缩提示词 | 续跑通过(22 个能做完的修复) | 复现细节留存 |
|---|---|---|
| Kimi Code | 19/22 = 86% | 8.2% |
| Claude Code | 18/22 = 82% | 15.0% |
| Gemini CLI | 17/22 = 77% | 7.2% |
| Codex | 16/22 = 73% | 9.5% |
| opencode | 16/22 = 73% | 9.5% |
表中「复现细节留存」指 146 段会话里那些会反复出现的结构化细节——文件路径、commit SHA、错误类型、URL、键值对、IP——在摘要里还留着的比例。两列在表里打架:Claude Code 的提示词多丢一个修复,却把细节留存做到 15.0%,五者最高;Kimi Code 反过来,8.2%。4
细节留存整体很低。最好的模型留住 16.0%,机械抽取(直接从历史里按类型抓字符串)能留住 79.1%,差 63.1 个百分点。真实生产链上同样低:第一次压缩后的摘要留住 15.7%,第二次 19.9%,第三次 4.9%,三档样本分别是 106、27、6 条。4
损伤长什么样?作者挑了四个稳定受损的例子逐条看。四个摘要里目标文件都还在;pytest-7571 更极端,五个该改的片段一个不少,续跑照样没修好。4
sphinx-9230 的对照最清楚。PRE 读目标区域、跑一个最小复现、定位调用点,然后改一行;POST 到了目标文件边上,转去读测试和复现代码,那处修改没落下去。4
读完可以带走什么
先把验收标准换掉:压缩好不好,看的是续跑能不能把活做完,摘要里有没有关键词只说明一半。这套数据里,两个指标排出来的第一名正好是对方。
压缩时值得把「做到哪一步」单独留一栏:已经改了什么、剩哪一步、哪个测试还没过。作者的结论正是可靠压缩要留住完成任务所需的进度。4
选摘要模型时按自己的任务比重测一遍。这批修复偏小(中位补齐不到 1 KB)都能丢到 64%,任务越长,压缩次数的代价越大——第三次边界只剩 4.9%。
评估的账不算贵:整套 35 个修复花掉约 8,000 次模型调用,压缩本身不到 token 的 5%,主要开销在生成和判分续跑。4
局限一句
结论限于被测的 35 个仓库修复、Kimi-K3 作续跑智能体、8 步预算这三件事;细节留存按字符串是否出现打分,第三次及以后的压缩边界样本只有 6 条,越靠后的数字越不稳。
2. 工具一坏,完成分从 8.08 掉到 3.23
元信息
Tool-Calling LLM Agents Under Realistic MCP Faults: Scale Does Not Purchase Fault Tolerance
作者:Antonio Ken Iannillo(卢森堡大学 SnT)、Joshua Segun Owotogbe(蒂尔堡大学)、Roberto Natella(格兰萨索科学研究所)、Francesco Avallone(那不勒斯费德里科二世大学)、Kristina Kudryavtseva(卢森堡大学 SnT)、Indika Kumara(蒂尔堡大学)
论文:arXiv:2610.32555v1 · 2026 年 10 月 23 日提交 · cs.SE / cs.AI。5
要解决什么问题
MCP 是把外部工具接给大模型的一套接口标准。智能体查天气、查航班、读数据库,都走这条调用路径。
现有基准默认工具按时返回正确结果。线上不这样:接口超时、返回一个格式对但值是错的数字、报 schema 错、干脆不返回。5
分布式系统里早就有故障注入,但那套东西作用在服务和网络层。MCP 这层要注入的是语义故障:调用本身坏了,语义上仍然像一次正常调用。
作者要回答的是两个问题:哪些智能体设计在故障下降级得体面,把模型换大能不能换来韧性?
方法是什么
作者做了一个中间件 MCP-Injector,插在智能体和 MCP 服务器之间,两边都不用改。
它按两张表注入:失败模式 6 种,持续性 3 档。六种模式是轻微错误(随机替换字符)、输出错误(词级替换)、输出不合法(类型被改)、显式报错、延迟返回、静默丢包;持续性分永久(每次调用都坏)、瞬时(坏一次)、间歇(成串地时好时坏)。5
注入的比重来自真实数据。作者扫了 1,774 个开源 MCP 服务器仓库的 57,240 条 issue 与 PR,用模型给每条打上「失败模式 × 持续性」标签,再抽 117 条由两位研究者人工核对,失败模式这一项两人判断的一致程度 κ=0.93(1 为完全一致)。5
得到的分布偏永久故障:永久 91.3%、间歇 8.0%、瞬时 0.75%;单是「显式报错 + 永久」就占 65.6%。作者说明这偏向可复现的故障,当作压力画像用。
实验用 MCP-Bench 的 25 个任务,交叉四个因素:3 个智能体框架(MCP-Bench 自带的计划—执行循环、OpenAI Agents SDK、LangChain/LangGraph)、2 个骨干(gpt-oss-20B 与 120B,16K 上下文)、3 个条件(不插代理、空代理、注入故障)、3 个种子,共 1,350 个格子。5
结果说明了什么
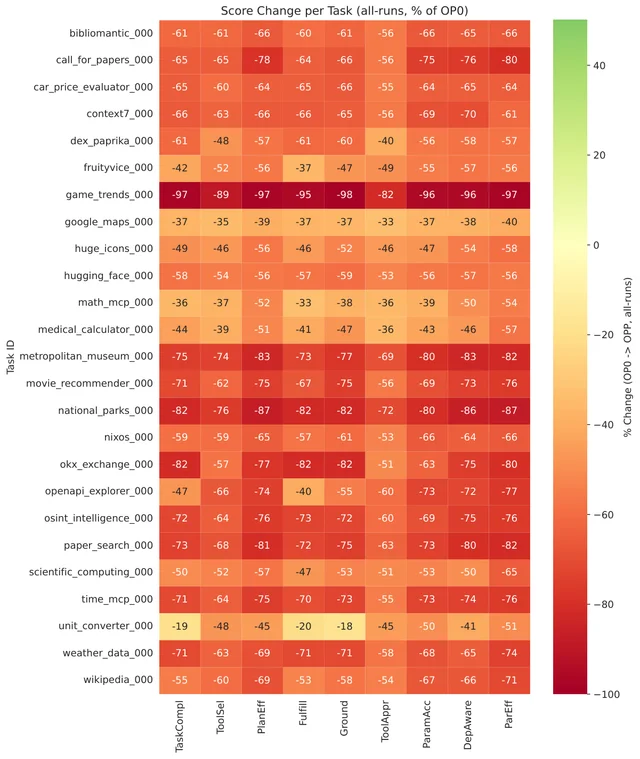
完成分从 8.08 掉到 3.23,降 60%。工具选择降 59%,规划有效性降 67%,其余六项降 54% 到 68%;每一项都掉 4.4 到 5.2 分(十分制)。完成率从 95%–100% 掉到 88%–97%。5
换大模型没换来韧性。120B 在故障下保住的无故障得分份额与 20B 没有差别:模型规模项 β=−0.009,95% 区间 −0.39 到 0.37,p=0.96。5
故障下的完成率也一样:120B 是 91.1%,20B 是 95.6%,差 4.4 个百分点,区间跨零(−0.2 到 9.3)。5
差距拆开后更清楚:两个骨干无故障时完成率本来就差一点(96.9% 对 99.1%),故障带来的额外掉点 120B 是 −5.8、20B 是 −3.6,两者之差 2.2 点,区间 −3.0 到 7.5 跨零。作者把它当作描述性差异,不当作规模效应。5
框架的差别更明显。故障下完成率:LangChain 95%–97%,MCP-Bench 自带框架 91%–95%,OpenAI Agents SDK 88%–95%。换成混合效应模型(把任务当作随机截距的回归)后,MCP-Bench 比 LangChain 多掉 0.93 分(p=0.048),OpenAI 多掉 0.84 分(p=0.074)。作者仍称之为提示性证据。5
掉多少取决于任务本身。逐任务看,最惨的 game_trends 完成分降 97%,national_parks 降 82%;最耐受的 unit_converter 只降 19%。5
还有一类行为在故障下被放大:工具绕开。判定规则是任务完成度不低于 4 分、工具适用性低于 2 分:答案替用户把事办了,工具证据为零。这种格子有 27 个(6.0%),其中 17 个一次工具都没调用。把工具适用性计入后,降幅从 58% 变成 63%。5
读完可以带走什么
把故障注入排进上线前的检查项,和「换更大的模型」并列。这套实验里九项指标同时掉一半上下,两个骨干之间量不出补偿。5
挑框架时看它出错之后干什么。MCP-Bench 的循环会换一个工具重新规划,LangChain 与 OpenAI 的 ReAct 式循环更常直接退出工具循环、改成用文字回答;两者在故障下的完成率也就差了 7 个百分点上下。5
要排优先级,先测依赖实时外部状态的任务。查实时行情、查国家公园开放状态这类任务掉得最深,纯计算类几乎稳住。5
评测时把「没调工具也答对了」单独记一列。它会在故障下悄悄抬高分数,掩盖真实的降级。
局限一句
故障画像来自 issue 记录,偏向可复现的永久故障,是一份压力画像,未按线上频率抽样;被测的只有两个 gpt-oss 骨干、16K 上下文、单机部署,框架效应也只到「提示性」这一档。
3. 有人在场的多智能体,13 个格子里 12 个更差
元信息
Does Multi-Agent Collaboration Pay When Agents Serve Users? Testing Agent Scaling in Dual-Control Settings
作者:Ethan Yang、Xiangcheng Shi(宾夕法尼亚大学)
论文:arXiv:2610.27655v1 · 2026 年 10 月 20 日提交 · cs.AI / cs.MA。6
要解决什么问题
多智能体被当成默认的升级路径:几个角色分工,一个规划、一个执行、一个查规则,看上去比单个助手更能干。
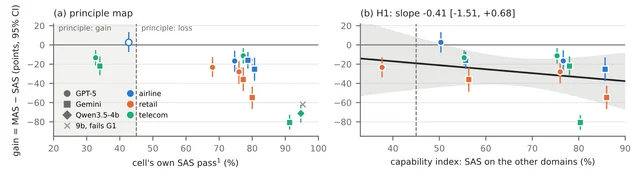
最系统的对照研究(Kim 等,2026)给过一条选择规则:底层单体弱的时候协作划算,强的时候反而亏,分界在单体准确率 45% 附近。6
那条规则是在没人参与的自主基准上得出的:给一个任务,模型自己做完。现在上线的智能体多数在跟人对话,人会中途补信息、改目标,甚至自己也拿着工具改同一套系统,这就是「双控」。6
作者要检验的就是:有人在场时,这条规则还灵不灵?
方法是什么
基准用 τ²-bench。它模拟一段客服对话,结束时检查数据库或设备状态对不对,涵盖航空、零售、电信三个域;只有电信是严格的双控,客户自己也操作设备。6
多智能体是集中式的:一个编排者负责规划并与客户对话,一个数据库智能体只负责读写,一个政策顾问提供规则。三个角色用同一个模型,避免把模型差异混进来。
对照是基准自带的单体智能体,同一模型、同样的 50 个任务、3 个种子。
预算按单体自己的花费标定:整场对话的 completion token 上限取单体的 4 倍中位数,三个角色共用一本账。这样比较的是同等预算下的效果。6
研究在跑之前预注册(先把假设、指标和判读规则写下来再开跑),每一处改动记在公开变更日志里。6 个模型(gpt-5-nano、gpt-5-mini、gemini-3.1-flash-lite、gemini-3-flash、qwen3.5-4b、qwen3.5-9b)× 3 个域共 18 个格子,其中 13 个通过机械校验(跑之前定下的硬性检查,例如裁掉的调用占比、写操作是否按原样执行),共约 7,950 场模拟对话。6
结果说明了什么
13 个格子里,多智能体在 12 个上更差,1 个打平,加权平均 −28 分。6
规则说该赢的格子也输。单体通过率在 45% 以下的两个格子是预测协作会赢的仅有两处:电信 × gemini-3.1-flash-lite(单体 34.0%)多智能体低 22.0 分,电信 × gpt-5-nano(单体 32.7%)低 13.3 分。6
去掉预算天花板也没用。电信 × gemini-3.1-flash-lite 在无上限时最多与单体打平,代价是花掉单体中位数 token 的 5.5 倍。6
钱花得更多。每个格子多智能体的总成本是单体的 1.4 到 3.1 倍(只算智能体调用是 2.3 到 4.0 倍);12 个有报价的格子里,11 个既更贵又更差。6
亏在哪里?把 13 个格子的亏损按对话的结局拆开,74% 出自「预算耗尽」的那部分对话。10 个格子里,60% 到 90% 的亏损来自预算被耗光;耗尽那部分对话的通过率只有 0% 到 39%。6
一个本该有的好处量不出来:拦住写错数据库的操作。把失败拆类之后,写错操作没有减少,别的失败被换成了「耗尽预算」和「干脆不动」。6
读完可以带走什么
先搭单体,再考虑分工。要上多智能体,得先说清它拦的是哪一类失败、怎么量到它;这套实验里那个最常被提起的理由(拦住误写)量不出来。6
比之前先把预算对齐。多智能体天然花掉 1.4 到 3.1 倍的钱,两套系统花不同预算的对比,会把协调开销藏进「效果差不多」里。6
亏损的机制在对话本身。人是一轮一轮补信息的,任务没法提前拆成几个子任务;每次工具调用又都要经过面向用户的那一个角色,编排者只能逐步重新分配。原本协作收益最大的正是可拆分的任务,客服场景把它反过来了。再加上预算按整场对话共用,花早了后面就没有了。6
局限一句
一个预注册的校验条没过:编排者规划时看不到工具 schema(schema 只在数据库智能体手里),约四分之三的写操作没有按原样执行;约定的修复版做出来了,但没在完整网格上跑。只测了一种集中式架构与一个模拟用户,换用基准默认的另一个模拟用户后,打平的那一格曾出现过 +10.0 的增益,区间跨零。
三篇各记一句
- 历史压缩:验收该看续跑能不能做完,摘要里有没有关键词只说明一半;14 个摘要模型在 22 个能做完的修复上丢 1 到 14 个。
- 工具故障:故障注入该排进上线前的检查项;按真实 issue 分布注入后完成分掉 60%,20B 与 120B 在故障下保住的份额持平。
- 多智能体:有人在场的场景里先搭单体;13 个格子里 12 个更差,平均低 28 分,成本还是单体的 1.4 到 3.1 倍。
References
- 1
- 2
- 3
- 4
- 5
- 6
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.