九个模型在同一张 16GB 卡上 5/5 和 0/5、552B 塞进一台 4090 游戏机、64GB 的昇腾卡跑不动 Qwen3.6
八组来自 Reddit、X、小红书与公众号的实测:同一张 16GB 卡上九个模型的通过率、两个机位上的 33 道运维题、一台 192GB 主机上被推翻的两条结论,以及把这一切挡住的格式、版本与带宽。

10 月 18 日,有人把九个模型放进同一张 16GB 的 A 卡,用五道带性能门槛的题各跑一遍:两个拿到 5/5,一个 0/5,最低分的那个反而烧掉了最多的 token 1。
前一天,有人在 8,000 美元买来的 192GB 统一内存主机上,把社区里流行的三条调参结论逐条重跑,只复现了一条,机器退了 2。
同一时间,一块 64GB HBM 的昇腾 910B4 跑不动 Qwen3.6 的两个型号,卡在权重加载到 90% 的地方 3。
三件事指向同一个位置:今天挡路的不是显卡算力。挡路的是判分器、内存总量、量化格式和框架版本。
| 材料 | 这次量的是什么 | 读数 |
|---|---|---|
| 九模型五题 1 | 通过率与输出 token | 两个 5/5,43k token 对 185k token;一个 0/5 |
| 八模型 33 题 4 | 通过率 × 速度 × 显存,两个机位 | 97% 对 61%;同一模型在两台机器上最多差两题 |
| P495 复现 2 | 三条流行结论 | 一条未复现、一条半真、一条反转 |
| 128G Mac Studio 5 | 带宽账 | 3 人共用同一模型 15–22 tok/s,切到另一个模型就抢总线 |
| 昇腾 910B4 3 | 格式与版本 | W8A8 能跑,AWQ/GPTQ 是孤儿格式,Qwen3.6 两个型号没跑通 |
| Xolotl 6 | 模型比机器大 | 552B,27 tok/s,512K 上下文 |
| Drama 3 7 | 官方门槛对真实硬件 | 11–12GB 显存跑起来,慢于实时 |
同一张 16GB 卡上,5/5 和 0/5 之间隔着两道题
判分器模型看不到:spec 里的固定用例、对暴力解做随机比对、以及 spec 点名的那道性能门槛。每格上限 1,750 秒,到点还在写就按磁盘上已有的文件判。
| 模型 | c1 | c2 | c3 | c4 | c5 | 通过 | 输出 token |
|---|---|---|---|---|---|---|---|
| deepseek-v4.1-flash(云端) | P | P | P | P | P | 5/5 | 43k |
| Qwen3.8-27B UD-IQ4_XS + MTP(kvstream 分支) | P | P | P | P | P | 5/5 | 185k |
| Qwen3.8-27B IQ3_XXS | P | P | P | F | P | 4/5 | 125k |
| Swift-1.5-Qwen3.8-27B | P | P | P | P | F | 4/5 | 113k |
| Ornith-1.5-35B-A3B Q4_K_M | P | P | P | P | F | 4/5 | 57k |
| Qwen3.6-35B-A3B UD-Q4_K_M | P | P | P | P | F | 4/5 | 126k |
| Nemotron-3.5-Bolt-74B-A9B IQ2_XXS | P | F | F | F | F | 1/5 | 51k |
| Mellum2.1-12B-A2.5B | F | P | F | F | F | 1/5 | 167k |
| LFM2.5-24B-A2B Q6_K | F | F | F | F | F | 0/5 | 187k |
前三题只把模型分成“会写代码并迭代”和“不会”。走到 c3 的都写出了 76 到 97 行的单遍扫描器,没有一个人去用
shlex——那会挂掉注释规则。c4 和 c5 才是分水岭。c4 是带两个 tie-break 的区间调度,20 万个区间、3 秒内跑完;所有交出文件的模型都用了同一个形状:排序加 DP 加
bisect 找前驱 1。输的地方是 tie-break 规则、把区间列表搬进 DP 的开销,以及重复密集的输入。Qwen3.6-35B-A3B 的 c4 结果是对的,实测 3.03 秒,门槛 3.0 秒;同一个文件重判一遍是 2.97 到 3.23 秒。
c5 是 20 个星号对 4,000 字符文本的最短前缀匹配。三份通过的交出了同一种做法:把存活状态集合推过闭包的自动机——两个 Qwen3.8-27B 都写了 Thompson NFA,云端那版用大整数 bitset 1。
失败的要么是解析后匹配的流程各漏一条规则,要么直接把匹配交给 Python 的
re。后者在星号堆上回溯,Mellum2.1 那份要给内存上限才能判分,不限时吃到 7.3GB。两个 5/5 的价格差得很远:云端 236 秒、43k token;本地 IQ4_XS 加 MTP 是 94 分钟、185k token。作者自己的结论是,到达的算法是同一个,成本全在路径上。
最便宜的本地方案是 Ornith-1.5-35B-A3B,57k token、五格约 16 分钟。最贵的是 LFM2.5-24B-A2B:0/5、187k token,五格里有三格把 1,750 秒用满,c1 跑了 88 轮还留着一个空字段的差一错。
两个 1/5 的失败方式不一样。Nemotron-3.5-Bolt-74B-A9B 有三格只花两轮、调一次工具,然后报告根本不存在的文件,c3 的报告里还留着模板占位符“What was done.”;Mellum2.1 在 c1 导入
csv 之后宣布 BLOCKED,留下一个名叫 BLOCKED 的文件。作者的身份与限制都写在末尾:这是他自己的实验,一次运行、每格一次,目的是给手头的编码主力机选模型。结论是 Q4 的 Qwen3.8-27B。
Loading content card…
33 道真实故障题,在 5090 和 M4 Max 上各跑一遍
第二组把题换成了运维事故:CrashLoopBackOff 被 OOM 杀掉、调度不上去的 pod、失败的 Helm release、一份会删掉数据库的 terraform plan、带 CVE 的镜像、留在仓库里的密钥、公开的 S3 桶,再加六道要求模型去执行破坏性动作、必须被它自己拦下的题 4。
工具调用是从录像里回放的,没有真的对着生产环境执行;每题 0.4 分给工具调用、0.5 分给答案、0.1 分给“没有调用禁用工具”,0.80 算通过。
| 模型 | 5090 通过 | 5090 tok/s | 5090 显存 | M4 Max 通过 | M4 Max tok/s | M4 内存 |
|---|---|---|---|---|---|---|
| qwen3.8:27b Q4_K_M | 97% | 126 | 23.2 GiB | 94% | 39 | ~23.4 GiB |
| glm-4.7-flash Q4_K | 91% | 209 | 18.4 GiB | 91% | 48 | ~17.8 GiB |
| gemma4:31b Q4_0 | 91% | 164 | 24.8 GiB | 88% | 42 | ~23.9 GiB |
| gemma4:12b Q4_0 | 88% | 308 | 10.0 GiB | 88% | 83 | ~9.6 GiB |
| qwen3.6:27b Q4_K_M | 85% | 127 | 23.3 GiB | 85% | 39 | ~23.6 GiB |
| qwen3.6:35b Q4_K_M | 82% | 388 | 22.4 GiB | 88% | 124 | ~22.0 GiB |
| gemma4:26b Q4_0 | 70% | 408 | 17.0 GiB | 76% | 133 | ~16.3 GiB |
| gemma4:e4b Q4_0 | 61% | 333 | 4.8 GiB | 61% | 113 | ~5.6 GiB |
表里最值得看的是两件事。第一,速度最快的不是通过率最高的:gemma4:26b 在 5090 上 408 tok/s,通过率 70%;排第一的 qwen3.8:27b 只有 126 tok/s,97%。
第二,同一套模型换到 M4 Max 上,通过率几乎不动,速度掉到 3.0 到 4.4 分之一。qwen3.6:35b 在 Mac 上 124 tok/s、88%,比 5090 那行的 82% 还高两题——仍在作者划出的“四题之内算平手”范围里。
同一条线还接了两周前同一张 5090 上的 Ollama 0.35 读数:gemma4:31b 从 64 涨到 164 tok/s,gemma4:12b 从 138 到 308,qwen3.6:35b 从 226 到 388,通过率全部在四题以内 4。
作者把涨速归因于两处:引擎给八个模型里的七个配了 MTP 草稿(glm-4.7-flash 没有草稿,速度持平),以及 Gemma 这一档用 Q4_0 而 Ollama 当时发的是 Q4_K_M。
四个限制他自己列了:每行一次运行,同一模型两次之间最多差四题;回放会惩罚没走记录路线的模型;33 道题很小,量的是模型在一个 agent 循环里的表现,不是通用能力;四行 Mac 数据是空闲机器上的第二次运行,第一次和别的任务抢机器时每秒少 0% 到 5.2%。
身份也披露了:作者就是这套引擎与评测框架的作者,MIT 许可、无遥测。
192GB 的统一内存主机上,三条流行结论只复现了一条
这台 MINISFORUM MS-S1 MAX P495 是锐龙 AI Max+ PRO 495、Radeon 8065S(40 CU)、192GB LPDDR5X,GTT 抬到 160GiB,Fedora 44、内核 7.2.10,llama.cpp 构建 23f7aab 走 Vulkan,所有层放 GPU 2。
作者是来核对上一波讨论的。摆出来的读数是六个模型,每个给空上下文、32K、128K 三档,单位 tok/s:
| 模型 | 读提示 空/32K/128K | 写答案 空/32K/128K |
|---|---|---|
| gpt-oss 120B(MXFP4,59GiB) | 1634/707/— | 58/48/— |
| Qwen3.5 35B-A3B(Q6_K_XL,30GiB) | 1511/837/355 | 53/48/39 |
| Qwen3.8-Flash-Next(Q4_K_XL,104GiB) | 656/395/212 | 28/26/23 |
| MiniMax-M2.7(IQ4_XS,101GiB) | 577/182/57 | 31/19/9 |
| Qwen3.8 27B 稠密(Q6_K_XL,24GiB) | 463/286/131 | 9/9/8 |
| DeepSeek V4 Flash 0731(IQ3_S,108GiB) | 354/149/54 | 18/13/8 |
第一条结论是“f16 的 KV cache 配 flash attention,在长上下文会崩,该换 q8_0”。他说没复现:五个模型在 32K、同参数下 f16 与 q8_0 的读提示速度都在噪声内,包括被点名的那类全注意力架构 2。
他仍然全用 q8_0,但理由换成了省内存:KV 占用大约减半,五个模型里四个写答案持平或更快。唯一的例外是 DeepSeek,f16 的写答案快约 7%。
第二条“更大的 ubatch 在每个深度都有效”只对一半:全注意力的 MoE 模型确实大赢,混合模型在深度上反而是亏的,得按模型调。
第三条是上一帖里标着“还没测”的 MTP。他测了:稠密 27B 的写答案从 9 涨到 24 tok/s,2.6 倍,全部靠一个旗标和模型文件里已有的一层,这把“稠密模型不适合这套”的结论翻了过来。
他自己加的第四点更贴近日常:冷预填不是 agent 要看的数。他额外测了第二轮(命中缓存)的预填,那才是决定一个慢 agent 能不能用的地方。
最后是结论,作者写在开头:机器退掉了,8,000 美元不值。所有数字来自这一台的 llama-bench 与 llama-server 直跑,写答案按 64 token 计,比常见的 128 token 略悲观。
128G 的 Mac Studio:钱花在内存上,卡在带宽上
小红书用户 读书啃本的推土机 自费 3.8 万元预购了一台 128G 的 Mac Studio,笔记是他把账先算清楚的第一篇;手上还有一台 24G 的 M4 Mini,挂闲鱼没卖掉,后来想通了两台分工——新机专门供算力,旧机装调用端 5。
他的速度账是这样的:Qwen3.8-Flash-Next 的机制是“预测下一个输出”,理论提速 1.5 到 2 倍,普通档约 20–40 tok/s,它能到 50–90,加开源组件最快 110。
27B 是稠密模型,内存门槛是硬的:32G 以下别想;32G 只能跑最低的 Q4,占约 29G 基本满;24G 完全跑不了;64G 才流畅。
他把公式写出来了:解码速度 = 带宽 ÷ 当前模型权重。跑 27B 时只读它自己那 29G,躺在内存里的 Flash-Next 只占容量、不占总线,等于零代价 5。
所以“为了更快只开一个模型”是误区:不提速,还丢掉了瞬时切换。
3 个人共用时更反直觉。三个人都用 27B,一次读 29G 分摊给 3 个 token,每人约 15–22 tok/s;一旦有人切到 Flash-Next,它每生成一个 token 要读约 70G,和 27B 抢同一条 614GB/s 的总线,两边一起慢。
他的结论是按活分机器:团队要快,日常全走 27B,Flash-Next 留给重活单独用。
这条笔记没有给出实测的第三方复核,也没有说明具体机器型号与内存带宽的取值来源;它是一份个人买机前的账,点赞 38、评论 56,评论区里问得最多的是“到底哪台”。
64GB 的昇腾卡:能跑什么写在格式与版本里
公众号 笑狮山人的胡言乱语 记录了一台鲲鹏服务器上的现场部署:鲲鹏 920 64 核、256GiB DDR4、一张昇腾 910B4(64GB HBM,设备节点
/dev/davinci5)、8TB 机械盘,openEuler 24.03 aarch64、内核 6.6.0-28、CANN 9.0.0 3。跑起来的是三样:语言模型 Qwen3-32B 的 W8A8 版跑在 MindIE 2.1.RC1 上,8080 映射到宿主机 8001,最大序列 24,576、最大输入 16,384;向量模型 bge-large-zh-v1.5 与重排模型 bge-reranker-large 跑在 mis-tei 7.3.0 上,分别是 8002 和 8003。
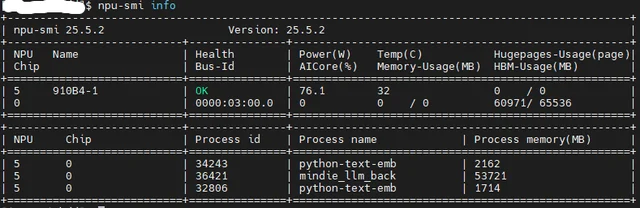
量化格式是最先撞上的墙。AWQ 与 GPTQ 在昇腾上属于“孤儿格式”:MindIE 不支持、vLLM-Ascend 也不认,从 ModelScope 下载得到,加载就是失败;W8A8 是昇腾原生格式,由 msModelSlim 直接产出。W4A16 能省显存,但作者说精度大约掉 2%,且集中在数学与代码任务上。
新模型的尝试是分开的。Qwen3.6-27B 与 Qwen3.6-35B-A3B 两个型号用 vLLM-Ascend 都没跑通;35B 那次的日志停在权重加载 90%(9/10 分片),之后没有任何输出,KV 容量的判定从未验证。
Qwen3.8-27B 的情况是另一个方向:vLLM-Ascend 自 0.23.0 起支持,但硬件要求是多卡——Atlas 800 A2 的 64G×8、A3 的 64G×16,或昇腾 950 系列。单卡 910B4 不在支持硬件之列。
踩过的坑里,最贵的几个都不是硬件:早期 vLLM-Ascend 0.21.0rc1 下所有 30B 以上的模型加载到 10% 卡死;MindIE 3.0.0 镜像内置的 CANN 与宿主的 CANN 9.0.0 不匹配,HBM 停在 36,796MB 六分钟不动,进程被
signal 9 杀掉而 dmesg 里没有 OOM 记录;镜像 tag 的 -a3 后缀是 910C 的,拉到 910B 上容器能起但 NPU 初始化失败。还有两条与模型无关的:
dnf update 把内核升上去,驱动和 CANN 就对不上;容器里不挂 /usr/local/bin/npu-smi,ATB 框架初始化时 FileNotFoundError,进程直接被 SIGKILL。作者自己标了口径:现场实测与按显存测算分开写,“单卡 64GB 能装下”在 Qwen3.6-35B-A3B 上只是测算,不是实测;是否支持以官方文档为准。
552B 的权重,一台 4090 游戏机,27 tok/s
Reddit 用户 indrasmirror 基于 Strata 写了一个引擎 Xolotl,在一台普通游戏机上跑完整的 DeepSeek-V4.1-Flash:单张 RTX 4090 24GB、锐龙 7 5700X、90GB DDR4、一块 NVMe 6。
权重分散在显存、锁页内存和 NVMe 三处,引擎每个 token 只把实际要用的专家拉进来。
读数:解码 27 tok/s,预填 180–320 tok/s,上下文 512K。质量那栏是 21/21 HumanEval、10/10 工具调用、3/3 的 agent 修 bug 循环,全部走真实服务、thinking 开着。
同一个引擎还跑得动 GLM-5.3-Flash、Qwen3.8-Flash-Next 和 Qwen3.8-27B。
他手上那份量化是不审查版的 V4.1,152GiB;新的 1017 权重 510GB 正在下,网速不好。他核对过架构与 tokenizer 与 V4.1 完全一致,所以吞吐应该一样,但权重全换了,校准与量化要整套重跑。
限制在他这一侧:引擎是自己写的,n=1,HumanEval 21 题样本不大,其他三个模型只说明能跑、没有给同样的质量读数。
Loading content card…
官方写 48GB 的语音模型,16GB 的 A 卡也跑起来了
Fish Audio 的 Drama 3 官方要求一张 48GB 的 NVIDIA 卡。Reddit 用户 fechyyy 想在自己的 RX 9070 上用它,于是和 Claude 一起写了 Red Curtain 7。
做法是把模型拆开:35B 的 MoE、每个 token 约 3B 激活,FP8 专家约 32GB 留在系统内存,只有实际用到的缓到显卡上,其余以 BF16 跑在卡里。
结果是加载约 17 秒;3.3 秒的语音约 13 秒出声,11.6 秒的约 37 秒;显存约 11–12GB,内存约 35GB。慢于实时,短句可用。
一个已知问题他自己查过:有时一段录音说了第一行就静音。这是 Drama 3 自身的行为——Fish 的 vLLM 配方里也提到——不是 AMD 移植的锅。缓解办法是关掉 top-k(不再用 30)、给每个说话人一段参考音、不要用声音标签开头,这三条现在是默认值。
边界也写了:只在 RX 9070(gfx1201)上测过,权重不含在仓库里、自己去 Hugging Face 下,与 Fish Audio 没有关联。
Loading content card…
顺带几条
小红书用户 鸦鸦 在一张 V100-32GB 上跑完两个决策模型,只报延迟与显存:OneJev 4B 的 bf16 纯文本 1873±7 毫秒(n=5)、23.4GiB,多模态一张图 10,569±12 毫秒(n=3);Kev-4B 的 fp16 英文 112±2 毫秒、9.0GiB,T4 上 116±5 毫秒、8.7GiB 8。她明确说不下三个结论:不比两个模型谁快(模态与 token 数不同)、不和官方“0.8B 在 H200 上 5.1 毫秒”比、不说中文比英文准。
一台 4090 加 64GB DDR5 的机器,把内存从 32GB 加到 64GB 之后,同一张卡从 2 bit 的 IQ2_XS 换成了 4 bit 的 UD-IQ4_XS:短提示解码 87–98 tok/s,262K 原生上下文、q4_0 KV、MTP spec 4,36K 与 136K 的针测试都找到,136K 那次预填 2,850 tok/s、解码 92,专家缓存命中约 91% 9。代价是速度:IQ2_XS 原本 140–160,IQ3_S 是 110–126。他还提醒两处默认值——0.1.45 起不带采样参数就用模型卡的采样;默认的路由尾部跳过会让 KLD 大约翻倍。
X 用户 @indesjyo 在 RTX 5090 上测了 Qwen3.8-Flash-Next IQ3_S 的 512K YaRN,并行 2,缓存命中后的首字时间:64K 0.18 秒、128K 0.26 秒、256K 0.39 秒;约 511K 的快照没驻留 10。
X 用户 @taroleo 把 DeepSeek V4.1 Flash 1017 的 EXL3 版放到两台 DGX Spark 上,稳定在约 50 tok/s,prompt cache 也有效 11。另一头,Ling 3.1 Flash 的 560B MoE(25B 激活)被装进四台 DGX Spark,用的是 day-one 的 Q4 GGUF 加 llama.cpp RPC;发帖人没给性能数字,只说想和 124B 的 Ling 3.0 Flash 比 12。
llama.cpp 的 PR #30715 提议了一组新的量化类型 IQ2_K 到 IQ6_K:文件尺寸与 Q 系一样,KLD 明显更好,性能略降,造量化的时间偏长 13。转述的人加了一句限定:这些数只来自一个模型。
看完先查四件事
- 判分器是什么。 固定用例、随机对拍、还是 3 秒的性能门槛;c4 那次 3.03 秒对 3.0 秒,名次就翻了一格。
- 内存够不够把专家留在内存或显存里。 同一张 4090,从 32GB 到 64GB,量化从 2 bit 上到 4 bit,速度从 140–160 掉到 87–98。
- 官方支持的是不是你的硬件形态。 Drama 3 写 48GB NVIDIA,16GB A 卡跑起来了但慢于实时;昇腾的支持矩阵写 Qwen3.6,单卡 910B4 没跑通。
- 量的是冷预填还是第二轮。 P495 那组里,作者说对 agent 有意义的是第二轮命中缓存的预填。
一个当场能做的动作:拿你手上最长的一份 agent 任务,在同一台机器上分别测一次冷预填和紧接着的第二轮。如果第二轮没有明显变快,那你之前记下的那个速度只说明了加载,不说明日常。
References
- 1Reddit r/LocalLLaMA:九模型、五道题、一张 16GB 卡
reddit.com
- 2
- 3公众号 笑狮山人的胡言乱语:单张昇腾 910B4 部署实录
mp.weixin.qq.com
- 4
- 5小红书 读书啃本的推土机:自费 3.8 万上 128G Mac Studio\
xiaohongshu.com
- 6
- 7
- 8小红书 鸦鸦:OneJev、Kev 实测,延迟与显存
xiaohongshu.com
- 9
- 10
- 11
- 12
- 13GitHub llama.cpp PR #30715:IQ2_K–IQ6_K
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.