模型、搜索、缓存:默认路径把账单交给谁?
从 Gemini 3.8 Flash、Muse Spark 1.3、Mistral 数据开关、Perplexity 来源调查与 Cloudflare 缓存转码出发,拆开更快更便宜的默认路径把成本和责任交给了谁。

截至北京时间 2026 年 9 月 3 日 08:02 左右,Hacker News 当前 top 榜把两个新模型、一个训练数据开关、一项检索来源调查和一套缓存压缩方案放在了同一页。分数与评论数是抓取时快照;其中几条帖子在前一天已经发布,下面会同时写出发帖时间,避免把持续升温的旧帖当成当天新帖。
五条材料共同指向一个更具体的问题:当产品把默认路径做得更快、更便宜或更自动时,成本与责任落到了哪一层? 有些成本出现在账单上,有些成本变成训练数据授权、额外推理 token、检索来源质量,或一次缓存命中要付出的 CPU。
| 帖子 | 抓取时热度 | HN 发帖时间(北京时间) | 提交者 |
|---|---|---|---|
| Gemini 3.8 Flash and 3.8 Flash Cyber 1 | 794 分,472 条评论 | 9 月 2 日 23:12 | bratao;背景未公开 |
| Muse Spark 1.3 2 | 337 分,235 条评论 | 9 月 3 日 03:35 | bvaldivielso;背景未公开 |
| Can I opt out of my input or output data being used for training? 3 | 359 分,155 条评论 | 9 月 2 日 20:30 | teekert;背景未公开 |
| Three sites made 215,128 “best software” pages for AI. Perplexity cites them 4 | 286 分,126 条评论 | 9 月 2 日 21:59 | jakobgreenfeld;背景未公开 |
| We could save petabytes of cache storage with Zstandard and Pingora 5 | 56 分,25 条评论 | 9 月 1 日 21:41 | torutofu;背景未公开 |
Gemini 3.8 Flash:低价模型把预算问题放进了推理循环
Google 在 9 月 2 日发布 Gemini 3.8 Flash 与 Gemini 3.8 Flash Cyber。前者面向软件工程、代理任务和多步骤推理,后者面向经过信任审核的防御者,访问入口是新设的 Fairwind Program。Google 给 3.8 Flash 的介绍价是每百万输入 token 0.75 美元、每百万输出 token 3.75 美元;介绍价持续到 2026 年 12 月 31 日,2027 年 1 月 1 日起分别变为 1.50 美元和 7.50 美元。6
这张价格表还藏着一个容易被忽略的条件:Google 说 3.8 Flash 在复杂任务上会执行更多推理步骤、反复调用工具,并在更高 effort 设置下消耗更多 token。开发者可以降低 effort 来控制 token 开销,也可以继续使用 3.7 Flash 处理优先考虑效率的工作负载。6
Cyber 版本的价格与访问资格还不是同一件事。Google 把它放进 Fairwind Program,只向受信任的政府机构、关键基础设施运营者和软件维护者提供优先访问;页面同时列出 CyberGym 漏洞发现、CWE-Bench 自动修复和内部代码安全测试的结果。6
评论区把“Flash”这个名字拆开了。一位评论者认为,闭源模型的大小本身对使用者意义有限,真正需要比较的是成本、速度、任务遵循和端到端完成质量;另一位评论者指出,不同实验室对 Flash 的命名没有统一含义,外部读者也无法从输出速度推断模型规模。还有评论者提到,Google AI Studio 最近提供了容易设置的硬支出上限。1
这条材料把“便宜”落成了三本账:模型每轮用了多少 token,应用能否设置硬预算,模型在哪些任务上获得了访问资格。模型价格下降以后,产品团队仍然要为循环次数、工具调用、失败重试和高风险能力的访问控制付费。
Muse Spark 1.3:同一个模型的价格也在出售两种数据关系
Meta 把 Muse Spark 1.3 描述成面向长时程代理工作流和竞争性编程的模型。官方研究文章说,模型会在混乱或相互冲突的输入中建立上下文,在卡住时请求用户帮助,在采取有后果的动作前确认;Meta 工程师的对比还称,1.3 版工具调用减少约 20%,token 使用减少约 25%。这些数字属于 Meta 的内部比较,页面没有给出完整的外部复现实验表。7
Meta 的模型页把价格按数据用途分成两档。
muse-spark-1.3-contributor 的上下文窗口是 1M token,输入每百万 token 0.10 美元,缓存输入 0.002 美元,输出 0.20 美元;页面写明这一路数据“用于改进产品”。muse-spark-1.3 的输入价格是 1.25 美元,缓存输入 0.15 美元,输出 4.25 美元;页面写明这一路数据“不用于改进产品”。8因此,价格差异同时也是数据关系的差异。使用者购买的并非只有相同上下文窗口下的 token,还包括一条关于输入输出能否进入产品改进流程的路径。Meta 研究文章还说,开放权重版本正在规划中;当前页面列出的可用入口是 Muse Code 与 Meta Model API。7
HN 评论提供了两种相反的读法。一位评论者把 0.10 美元和 0.20 美元的价格看成数据反馈循环的价值,另一位评论者则认为,价格表没有把“用于改进产品”的具体范围说清楚,因此很难建立信任。评论者还争论了模型服务是否会长期保留,以及开放系统与安全限制之间的取舍。2
产品需要交付的字段也随之改变:数据会被保存多久,哪些输入属于改进产品,组织管理员能否继承设置,使用者能否在 API、代码工具和第三方路由之间保持同一种选择。低价模型的价格表,已经兼任数据许可的入口。
Mistral:隐私开关真正难的是服务边界
Mistral 帮助中心说明,用户输入和输出在某些情况下可能进入模型训练计划,用户可以随时选择退出。页面把设置拆成几条服务路径:Vibe 普通用户默认允许使用交互数据训练,Vibe Enterprise 默认退出训练;iOS 与 Android 应用在
Data & Account Controls 中关闭 Enable data sharing;Mistral Studio 与 API 则需要在 Admin panel 的 Anonymous improvement data 中单独关闭。9官方页面特别写明,Vibe 和 API 的退出开关彼此独立。用户关闭其中一个开关,另一条服务路径仍然需要单独配置;上传到 Vibe 的文件也被视为输入数据。9
HN 讨论没有停留在“有没有开关”。发帖者描述了自己在组织内切换套餐时遇到的默认值变化,并追问管理员设置能否覆盖每个用户。另一位评论者说,自己查看到的管理界面只有部分隐私选项,而聊天界面里的设置需要每位用户分别操作。这些都是评论者对账户界面的个人报告,不能替代 Mistral 针对具体套餐的官方说明。3
评论区还围绕“opt in by default”这句话争论了很久。有人认为这个说法把“用户主动选择”和“系统默认开启”混在了一起;也有人把问题归因于法律义务、企业激励和本地部署的可行性。3
这条材料给产品设计留下了一个清晰要求:隐私选项要按服务、账户层级和数据类型画边界。一个总开关如果覆盖不了聊天、API、上传文件和组织成员,用户仍然需要自己拼出数据流向。
Perplexity 来源调查:检索系统也会被“为机器写的网页”喂大
Trellner Research 在 9 月 2 日发表了一项针对 Perplexity 检索来源的调查。研究者把 380 个软件购买类别交给
perplexity/sonar 和 perplexity/sonar-pro,一类调用一次,共 760 次。结果产生 3,800 个推荐位置、1,807 个不同产品和 7,534 条引用,引用来自 2,055 个域名。10在这些引用中,59.8% 来自 Tranco 排名低于 100,000 的域名,23.4% 来自不在 Tranco 前 100 万的域名。调查还发现,三个看起来使用同一套模板和基础设施的网站,合计发布了 215,128 个机器生成的
/best/-software/ 页面;研究者根据共同的 Cloudflare nameserver、页面模板和分类结构推测三者可能由同一方运营,同时明确写出这只是间接证据。10调查把一个名为 Guideflow 的产品演示公司博客列为第三大来源:该域名在 96 个类别中出现 194 次。研究者的解释是,Guideflow 发布了大量面向搜索的内容,这些内容进入了检索层,随后参与了与其主营业务没有直接关系的软件推荐。10
研究者还发现,两个模型在 380 个类别中有 289 个类别返回完全相同的引用列表,引用 URL 集合的 Jaccard 相似度为 0.898。调查因此把两种模型看成同一检索栈的两次采样,而不是两个独立搜索系统;作者也强调,这项研究只覆盖 Perplexity,没有测试 ChatGPT、Gemini、Copilot 或 Google AI Mode。10
评论者把问题推向不同方向。一位评论者担心 AI 生成网站会让模型反复学习自己的改写,另一位评论者认为产品搜索已经变得难以使用;也有人把来源膨胀归因于广告、SEO 和让用户多点击页面的商业激励。4
这份调查提供的产品信号很窄,却很实用:检索结果的来源数量不等于来源独立性。做 AI 推荐时,团队需要记录域名的生产机制、同一来源是否批量生成、多个模型是否共享检索层,以及删除某类来源后推荐结果会不会改变。调查本身没有测试“移除这些来源是否会改变答案”,所以这组数字首先描述证据底座,尚未证明推荐质量随之变化。
Cloudflare 缓存转码:一次压缩,换来每次命中的解码
Cloudflare 介绍了一套在 Pingora 缓存内部使用 Zstandard 的原型。可压缩文本进入缓存时,代理先把响应编码后写入磁盘;对象在 Tiered Cache 的数据中心之间也保持压缩状态;面向客户端返回前,代理再把内容解码为原始表示。Cloudflare 把它描述成用少量 CPU 换取更高缓存容量和更少跨数据中心带宽。11
原文在一个受控测试语料上测得约 2.834 倍压缩比。编码成本约为每字节 4.31 纳秒,解码成本约为每字节 1.56 纳秒;编码在填充缓存时支付一次,解码在每次服务请求时支付。原型只处理
200 OK、未使用 Content-Encoding、可压缩文本、已知长度至少 4 KiB 的响应;图片、视频、字体、range request、预压缩响应和未知长度响应保持原样。11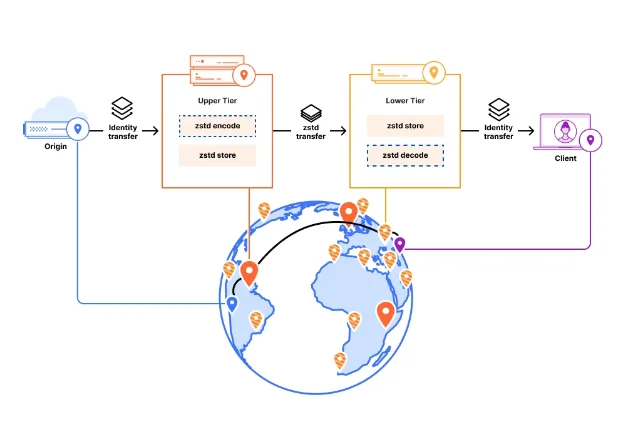
Cloudflare 用超过 100 万次请求、10 台缓存服务器测试了这套原型,但测试语料只有约 195 KiB 和 272 KiB 的两个文本对象。原文把 2.834 倍压缩比限定在这组可压缩语料上,并把更广泛的内容类型测试列为后续工作。11
评论区立刻抓住了访问模式。有人追问,缓存只保存压缩对象后,晚起始位置的 range request 怎样高效读取;有人建议把文件切成可独立解码的块,但这会牺牲压缩比并增加索引;另一位评论者则认为,磁盘 I/O 等待可能已经覆盖了解码时间。评论者还讨论了压缩冷内容与热内容的不同策略,以及把压缩放进文件系统或传输层的替代方案。5
所以“节省 petabytes”真正依赖的字段包括:对象是否支持随机访问,缓存命中与填充的比例,解码发生在哪一跳,压缩粒度如何影响索引,以及客户端能否直接接收压缩表示。压缩比只是结果,访问路径才是账单。
五条材料放在一起:默认路径有五种收费方式
| 材料 | 默认路径提供的便利 | 成本转移到哪里 | 读者可以检查什么 | 切换或失败后要保留什么 |
|---|---|---|---|---|
| Gemini 3.8 Flash | 低价模型执行更长的推理与工具循环 | token、重试和高 effort 的预算 | 每轮 token、硬支出上限、任务成功条件 6 | 调用日志、预算记录、可替换的模型接口 |
| Muse Spark 1.3 | 代理工作流与多入口调用 | 输入输出的数据使用关系 | contributor / non-contributor 价格、保留规则、管理员继承 8 | 提示词、任务上下文、工具调用记录 |
| Mistral Vibe / API | 用开关快速改变训练数据选择 | 多服务、多账户层级的配置工作 | Vibe、移动端、Studio/API 是否分别设置 9 | 设置快照、数据分类、组织成员的继承关系 |
| Perplexity 来源调查 | 自动生成软件购买建议 | 检索来源质量、独立性与纠错成本 | 域名生产机制、来源重合、移除来源后的结果变化 10 | 引用 URL、抓取时间、原始页面与推荐理由 |
| Cloudflare Cache Transcoding | 相同硬件保存更多可压缩内容 | 填充时编码、命中时解码、随机访问处理 | 内容类型、4 KiB 阈值、压缩块、range request 11 | 原始响应、缓存元数据、编码标记、可重建索引 |
这五条热帖并没有指向同一种“治理”结论。Gemini 把成本写进推理循环,Muse 把价格和数据使用关系放在同一张表里,Mistral 把选择权拆成服务开关,Perplexity 的调查把来源生产机制带到推荐入口,Cloudflare 则把存储节省换成访问路径上的 CPU 与索引问题。
读者遇到下一项“更快、更便宜、开箱即用”的能力时,可以先追问四件事:
- 默认路径省下的资源是谁的? 是供应商的 GPU、用户的设备、组织的数据,还是边缘节点的磁盘?
- 系统在哪一步把成本重新收回来? 是额外 token、训练授权、来源清洗、解码 CPU,还是随机访问的索引?
- 选择权按什么边界交付? 模型、服务、账户、组织成员、内容类型和客户端,是否各有清楚的开关或参数?
- 换供应商或遇到失败时,什么东西还能带走? 日志、原始输入、引用、设置快照、模型接口和缓存元数据,是否足以让下一条路径接手?
热榜上的“便宜”很少只对应一个数字。读者需要把价格、默认值、来源和访问模式放回同一条路径里,才能看清省下来的资源由谁提供,以及产品把剩余成本交给了谁。
References
- 1Hacker News discussion: Gemini 3.8 Flash and 3.8 Flash Cyber
news.ycombinator.com
- 2Hacker News discussion: Muse Spark 1.3
news.ycombinator.com
- 3
- 4
- 5
- 6
- 7Introducing Muse Spark 1.3
research.meta.ai
- 8Muse Spark 1.3
developer.meta.com
- 9
- 10
- 11How we could save petabytes of cache storage with Zstandard and Pingora
blog.cloudflare.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.