GLM 开权重、MHS 接机器、Cursor 面临停供:AI 的控制权分成了三层
GLM 的许可分层、MHS 的物理执行接口与 Cursor 的停供日共同表明:AI 产品必须同时管理能力能否带走、动作由谁授权和供应路径如何退出。
实验室里的 AI 代理可以调动机械臂和液体处理器,却可能先把起泡造成的失败当作软件问题处理。3
这些变化分别发生在模型仓库、实验设备和企业合同里。它们受同一个问题约束:谁有权让 AI 做事,谁又有权收回这种能力?
本周的总判断是:模型能力走出聊天框以后,AI 产品的控制权已经分成三层。权重和许可决定能力能否带走;设备接口决定代理能碰什么;企业权限和供应合同决定模型能做什么、还能用多久。任何一层收紧,整条产品链都可能停下来。
第一层:权重拿得到,商业使用权仍要另算
8 月 28 日,Z.ai 宣布 GLM-5.3 开放权重,兑现了两周前的发布承诺。模型文件可以下载、部署和微调,但基座模型采用自定义的 GLM-5.3 License。该许可规定:集团连续 12 个月收入超过 100 亿美元、并经营“模型即服务”(MaaS)业务的主体,在商业使用前需要通过 Z.AI 的安全审查;审查范围和方法由 Z.AI 合理确定。16
同一家公司的另一个模型给出了不同答案。8 月 26 日发布的 GLM-5.3-Flash 采用 MIT 许可,3200 亿总参数中每次激活 180 亿参数,支持文本、图像和视频输入。Z.ai 把它定位为 GLM-5 系列首个原生多模态模型。78
这两个 GLM 模型把“开放”拆得很清楚:基座模型的权重已经放出,大型 MaaS 运营者仍受额外审查;Flash 变体的权重与 MIT 许可一起放出。团队只登记“用了 GLM-5.3 系列”,会漏掉真正决定商业用途的许可差异。采购和法务需要记录到具体仓库、权重版本、许可证版本和实际服务形态。
Qwen3.8-Flash-Next 又给出第三种组合。它在 8 月 26 日开放权重,属于 Qwen4 架构的早期预览,完整的 Qwen4 产品家族仍待发布。模型每处理一个 token(词元)激活 60 亿参数,原生上下文长度为 262,144 个词元;Qwen 把稀疏注意力、线性注意力和 n-gram(连续词元片段)嵌入等架构变化提前交给社区验证。9
Qwen Community License 1.0 允许使用、修改、部署和微调权重,同时把两类商业业务单独列出:MaaS 和 AI Work Assistant。后者包括以辅助编程或办公为主要用途的独立 AI 产品。经营这两类业务的公司需要先取得 Qwen 的另行许可。纯内部使用可以免于这一要求,前提是模型、输出和底层模型能力仅供公司内部使用。许可还规定:商业产品或服务月活跃用户超过 1 亿,或月收入超过 2000 万美元时,界面需要显著展示相应模型名。2
条款按产品功能划界,同一家公司可能同时落在几个结果里。公司可以把 Qwen3.8-Flash-Next 用在内部知识助手中;一旦公司把同一模型做成对外销售的编码助手,另行许可条款就可能生效。GLM-5.3 License 的 MaaS 定义也区分了三种产品形态:让第三方通过 API 控制输入、参数或训练数据的推理与微调服务;把模型能力嵌入具体功能的终端产品;单纯转发其他托管模型请求的服务。12
因此,开权重解决的是“能力能否离开原厂 API”,许可证解决的是“团队可以把这项能力做成什么生意”。两道检查需要并行完成:工程团队验证模型能否在目标硬件上运行,法务和采购确认计划中的产品形态落在哪一条许可条款里。
团队还要给许可证建立版本记录。模型文件、量化版本、微调产物和部署镜像都应关联原始许可证。发布方更新许可条款时,企业才能知道哪些线上服务需要重新审查,避免在上线前靠产品名猜许可。
取得权重也会改变成本的归属。原厂 API 把容量规划、推理优化、补丁和安全响应包在调用价格里;自托管把这些工作交给企业。工程团队需要同时核算显存和内存占用、峰值并发、冷启动、缓存命中、值班与升级成本。单看每百万 token 的标价,会低估“把能力带走”之后的运维开销。
对产品经理来说,最实用的交付物是一张“模型用途清单”:每一行写明具体权重、谁来托管、谁能输入训练数据、输出交给内部员工还是外部客户、产品是否允许用户控制推理或微调。法务可以据此判断许可,工程团队也能据此估算容量和故障责任。
第二层:MHS 把代理接到机器,控制面要先建好
8 月 27 日,Anthropic 发布 Model Hardware Standard(MHS,模型硬件标准)研究预览。MHS 用标准化驱动把显微镜、液体处理器、机械臂等设备暴露给 AI 代理。驱动只提供一组基础的
read 和 write 原语,例如读取温度、设置温度;设备的重量、可调参数和安全限制则通过自然语言标签补充。驱动随后生成设备参考文件,让代理知道设备能测什么、能改什么、哪些限制必须遵守。3代理可以通过 MCP(模型上下文协议)、命令行和代码文件/API 三种机制控制设备,三者一起支持跨多台设备编排。需要执行长时间或高速动作时,代理可以把多个驱动命令串成代码文件,让设备按确定的指令序列运行;代理继续接收设备数据,在更高一层调整计划。这个分工很关键:实时控制交给确定性的程序,模型负责提出计划、检查结果和处理例外。
标准化驱动实际解决了两件事。第一件是连接:设备可以被发现,也能用同一组读写动作接入网络。第二件是语义:参考文件说明设备能测量什么、哪些参数可改、哪些安全限制在设备侧强制执行。只有连接,代理看得见设备却容易误用;只有说明文档,系统仍要为每台设备重写接口。MHS 试图把两件事放进同一份驱动定义。3
接口统一还会放大一次授权的范围。不同厂商软件之间的隔离会拖慢自动化,也在客观上限制了错误传播;统一接口让一个代理可以连续调动多台设备。团队获得编排效率的同时,需要用动作白名单、设备侧限值和人工确认重新划出边界。3
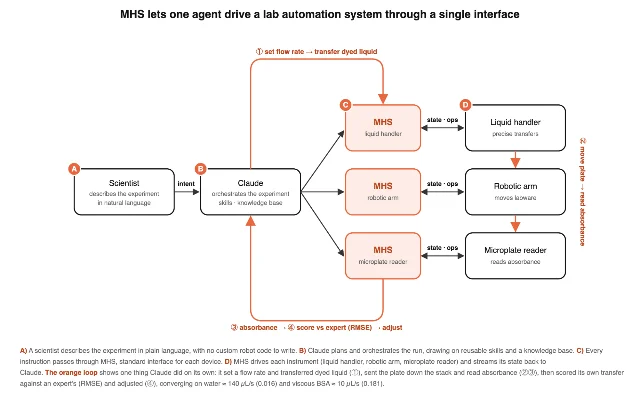
MHS 目前仍是研究预览。适用范围限于带有可编程接口的设备,Anthropic 计划在完成更多安全评估、形成部署指南后再开放标准。物理推理也仍需要专家监督。Genentech 的早期试验里,Claude 把黏稠液体起泡造成的失败当作软件问题,先反复重试,结果产生更多气泡;专家说明物理原因并给出处理办法后,模型才把经验写进后续操作。3
这类错误说明,设备驱动统一之后,真正难的部分从“怎么发命令”移到了“什么条件下允许发命令”。软件重试通常只浪费时间和算力;机械臂、激光器和液体处理器的错误会损坏样品、设备,甚至影响人员安全。
Anthropic 公布的合作方案例也给出了可验收的办法。卡内基梅隆大学的团队人为设置了缺失托盘、托盘旋转、读板机忙碌、相机断连、设备不可达和急停开启六种故障;系统在设备动作前拦住了六种情况。QuEra 则把代理夜间迭代出的激光恢复方法固化成确定性脚本,再用同一组扰动做 700 次独立测试,成功 695 次。两组数字来自研究预览中的合作方案例,适合用来设计验收,仍需等待其他团队复现。3
QuEra 的最后一步尤其值得产品团队借鉴。代理在受控环境里提出假设、改脚本、运行设备并读日志;通过测试的结果最终变成一段可检查、可重复运行的确定性脚本,生产阶段由这段脚本独立执行。这个过程把模型放在探索和改进环节,把稳定版本交给常规软件执行,既保留了代理找方案的速度,也给生产系统留下了可审计的行为边界。3
产品团队可以据此把物理代理的上线门槛写成四项:设备和动作白名单;危险动作由人员审批;完整的指令、传感器回读和接管日志;先在空跑或仿真中注入故障,再接真实设备。团队还应把停机条件放在设备侧。模型失去网络、上下文或判断能力时,设备仍能执行本地安全限制。
第三层:企业权限变成对话动作,模型供应变成迁移日历
8 月 25 日,OpenAI 为 ChatGPT Work 和 Codex 推出 Admin plugin。管理员可以在一次对话里查看成员活动和额度、增删成员、调整群组、检查有效权限、控制模型访问,还可以批准或拒绝用量与支出请求。插件把管理员的指令映射到受支持的读写动作,沿用用户原有的角色、权限、工作区政策和审批要求。遇到影响范围较大的改动,管理员可以在执行前查看自己提出的请求和将要发生的变化,再决定是否应用。4
管理工作的入口因此发生了变化。过去需要在报表、控制台和工单之间切换的操作,现在可以从一句自然语言请求开始。OpenAI 还给出了自动化例子:插件可以把额度申请送到 Slack 或 Microsoft Teams 里审批,按预设条件自动开放功能,把例外留给管理员。OpenAI 自己的 IT 团队称,已部署的 ChatGPT Work 流程处理了约 45% 的工单量;这是厂商内部案例,只能说明 OpenAI 自己覆盖的工作流范围。4
对企业来说,入口变成对话后,单次请求可能带来更大的权限变化。一句话现在可能触发成员移除、权限变更或额度调整。企业需要把“谁能问”进一步拆成“谁能读、谁能写、哪些写操作要二次确认、谁来复核日志”。自然语言只是入口,权限矩阵和审计记录仍是最终控制面。
最稳妥的做法是给管理动作分三级。查询成员和用量属于只读操作;调整个人额度、修改普通群组属于可回滚写入;批量移除成员、扩大模型访问和批准高额支出属于高影响写入。企业可以让前两级自动化到不同程度,把第三级固定为双人确认,并要求插件在执行前展示受影响对象和变更前后的差异。
三天后,供应层给出了更直接的提醒。OpenAI 在 8 月 28 日通知 SpaceX,计划终止向 Cursor 直接供应 OpenAI 模型的合同,并拟于 2026 年 11 月 12 日关闭该供应。OpenAI 称,这已经使用了合同允许的最长通知期;从通知起,OpenAI 也计划停止向 Cursor 提供未来模型。OpenAI 还表示,其与 Cursor 的定制协议在 Cursor 控制权变更后给供应方一个有限取消窗口。OpenAI 拟把终止日放在合同允许的最晚日期,拟定日期为 11 月 12 日。5
这次安排把“供应商风险”变成了一个具体日期。即使产品只通过 Cursor 使用模型,直接决定 Cursor 能否继续提供该模型的,仍是 OpenAI 与 Cursor 之间的供应合同。开发者即便为其他工具准备了自己的 API 密钥,也需要逐项验证补全、代理工具和数据处理路径。“可以换 API Key”只覆盖迁移中的一部分。
模型迁移也需要按任务拆开。代码聊天、行内补全、仓库级重构和带工具代理各自需要不同的上下文、延迟与调用协议。企业可以保留一组来自真实工作的固定回归任务:相同代码库、相同权限、相同工具和相同通过条件。每次切换模型或供应路径时,团队都用这组任务检查完成率、错误类型、p95 延迟(响应时间的第 95 百分位数)、人工返工和数据去向。这样,模型替代才有可复现的判定标准。
企业现在就可以为 11 月 12 日倒排:先列出哪些任务依赖 OpenAI 模型,再为代码补全、长上下文重构和工具调用分别准备替代模型;随后用同一批任务测完成率、延迟、额度消耗和人工返工;最后演练路由切换与回退。采购则要把控制权变更、模型下架、价格调整和数据政策变化写入退出条款。
三层控制权,分别会在哪里出错
下面所说的“影响范围”,指一次错误、撤权或停供最多会波及哪些对象:一个账号、一项服务、一间实验室,还是整条产品链。
| 控制层 | 谁可以批准或撤回 | 一次问题可能影响的范围 | 必须保存的记录 | 验收指标与行动窗口 |
|---|---|---|---|---|
| 权重与许可 | 模型发布方;企业法务与采购 | 单个模型、整项服务或既定商业模式 | 仓库地址、权重哈希、许可版本、微调与量化链路 | 投产前完成许可判断;许可证变化可追溯。12 |
| 物理执行 | 设备所有者;实验、安全与生产负责人 | 单台设备、样品、实验室或产线 | 指令、传感器回读、安全限制、审批和人工接管 | 真实设备接入前完成故障注入;危险动作始终需要明确授权。3 |
| 组织与供应 | 企业管理员;模型供应商与合同方 | 单个账号、整个团队或产品链 | 权限变化、额度审批、模型路由、合同期限与替代路线 | 权限按最小范围授予;Cursor 相关团队在 11 月 12 日前完成替代验证。45 |
三层之间还会互相放大。自托管权重可以降低 API 停供的影响,却会把硬件、升级和安全责任交给企业。标准设备接口可以加快代理接入,却会扩大一次错误指令可以触及的范围。对话式管理可以降低操作门槛,也会让高影响动作更容易被频繁调用。
控制权转移,也会转移成本
三层控制权都在做同一笔交换。企业从供应商手里拿回一部分决定权,同时接过原来由供应商承担的工作。
在模型层,企业用自托管换取版本稳定、数据边界和供应独立,代价是 GPU 或大内存机器、推理优化、容量规划、补丁与值班。在设备层,MHS 把逐台编写集成的时间压缩到统一驱动和编排层,代价是更严格的设备认证、故障注入和现场安全责任。在供应层,双模型路由降低单一合同变化带来的中断,代价是维护两套能力回归、数据政策和成本观测。
这笔账要按中断代价来算。内部实验工具停半天,团队可能接受单一模型和人工恢复;客户付费的编码代理或无人值守实验需要更强的冗余、审计与接管。控制措施的强度应该跟一次问题可能影响的范围一起增加,避免所有项目机械地套用同一套高成本方案。
因此,成熟的 AI 产品需要同时回答三类问题:这项能力是否允许这样使用;这次动作是否获得授权;这个供应路径消失后,系统能否继续运行。模型分数和 token 价格之外,真实部署风险还取决于这三类答案。
社区信号:能启动,与达到服务目标是两次验收
Qwen3.8-Flash-Next 发布后,vLLM 和 NVIDIA 很快给出接入或运行支持。这类“发布当日支持”(day-zero support)说明工具链能够迅速识别新架构,仍然需要团队用自己的硬件、量化方式和任务负载再测一遍。1011
Reddit 上一位 M2 Ultra Mac Pro 用户报告,使用 Unsloth Q4_XS 量化和相应的 llama.cpp 分支运行 GLM-5.3-Flash,首个 token 等了约 3—4 分钟,并认为体验难以使用。这只是一次个人试用,硬件、量化和软件版本都会改变结果;它提出的验收问题却很实在:本地模型至少要分别测冷启动时间、首 token 延迟、持续吞吐、峰值内存、长上下文稳定性和工具调用成功率。12
仓库能下载、框架能加载,只说明系统跨过了接入门槛。产品能否投入日常使用,要看它能否在目标成本和延迟内持续完成真实任务。
四类团队现在要补的控制项
- 开发者:给模型调用加一层适配接口;把模型、权重、量化和许可证一起登记;为冷启动、长上下文、工具调用与错误恢复建立固定回归集。模型替换时,团队应先看任务完成率,再看单次调用价格。
- 产品团队:按“只读、可逆写入、高风险写入”给代理动作分级;为设备操作、成员移除、权限扩大和额度上调设置不同审批;把失败后的回滚和人工接管写进产品流程。
- 企业 IT 与采购:维护模型供应清单和权限矩阵;为关键工作流准备第二条模型路线;把控制权变更、模型下架、通知期限、数据保留和迁移支持写进合同检查表。
- 普通用户:区分本地模型、云端聊天和执行型代理。执行型代理会替用户修改账号、调用工具或控制设备。用户需要看清每一种方式把哪些数据发给谁、获得了哪些账号或设备权限、出了错由谁确认和撤回。对话框相同,背后的责任范围可能完全不同。
哪些信号会改变当前判断
- GLM-5.3 与 Qwen Community License 在实际商业部署中如何执行,尤其是安全审查和另行许可的申请范围、周期与结果。
- MHS 何时开放实现,以及 Anthropic 随开源版本公布哪些安全评估、设备认证和人工审批规范。
- Admin plugin 的审计记录能否覆盖跨 Slack、Teams 和第三方系统发起的管理动作,异常审批能否完整回放。
- Cursor 在 11 月 12 日前给出哪些替代模型、迁移工具和能力差异,开发者能否用同一批真实任务复现迁移结果。
这四项都比再多一个模型榜单分数更接近 AI 的真实生产力。模型决定系统大概能做什么;三层控制权决定许可是否允许、系统是否可靠、供应能否持续。
References
- 1GLM-5.3 License
huggingface.co
- 2Qwen Community License 1.0
huggingface.co
- 3Anthropic:Model Hardware Standard 研究预览
anthropic.com
- 4OpenAI:Admin plugin
openai.com
- 5OpenAI:Cursor 供应决定
openai.com
- 6Z.ai:GLM-5.3 开放权重公告
x.com
- 7
- 8GLM-5.3-Flash 模型仓库
huggingface.co
- 9Qwen3.8-Flash-Next 模型卡
huggingface.co
- 10
- 11
- 12r/LocalLLaMA:GLM-5.3-Flash 本地运行讨论
reddit.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.