DeepSeek 首次公开 V4.1-Flash 技术报告:552B 骨干参数与 CED 架构亮相,KV 缓存压至 890 字节
DeepSeek 首次公开 V4.1-Flash 完整技术报告与模型卡,披露其 552B 骨干参数、分阶段激活(prefill 8B / decode 16B)的 CED 架构、压至 890 字节/token 的全局 KV 缓存与厂商自测基准,模型权重与代码遵循 MIT 协议开源。

北京时间 2026 年 9 月 10 日下午,DeepSeek 在其官方 Hugging Face 仓库中首次公开了《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》完整技术报告,并同步更新了模型卡与架构说明。12 官方仓库提交记录显示,技术报告于北京时间 13:33 至 13:51 期间上传,包含架构拓扑与 benchmark 得分的 README 文件于 15:17 至 16:18 之间完成合并。3 在此前上一期发稿时,官方文档仅开放了 API 端点与资费,正文中明确标注「官方未披露具体参数量与技术报告」。本次技术报告与模型卡的公开,标志着这款新主力模型的内部结构、参数规模、优化算法以及本地权重全面揭开面纱。12
先说结论
对于正在评估模型私有化部署、微调或构建高吞吐 Agent 系统的技术团队,本次官方技术披露锁定了以下五项核心要点:
- 核心参数规模首次定论为 552B,采用非对称动态激活。模型骨干参数(Backbone Parameters)为 552B,但打破了传统 MoE 架构在预填(Prefill)与解码(Decode)阶段激活相同参数量的做法。在 CED 架构下,模型在 Prefill 阶段每 token 仅激活 8B 参数,在 Decode 阶段每 token 激活 16B 参数。12
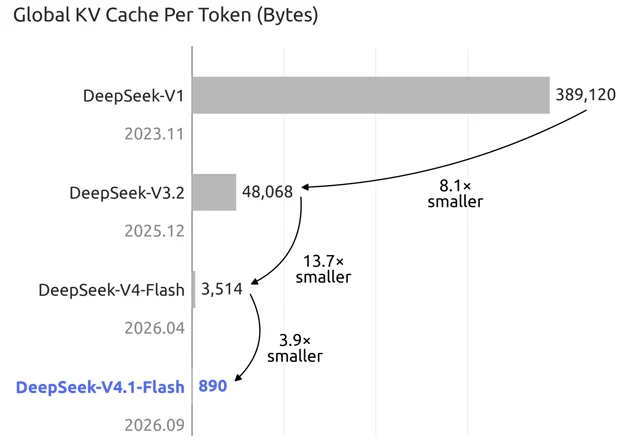
- 全局 KV 缓存压缩至每 token 890 字节,大幅降低显存墙限制。通过引入 Compressed Sparse Attention 2(CSA2,压缩稀疏注意力 2)跨层复用机制与 FP4 主 KV 缓存(E2M1 格式),模型驻留 HBM 的全局 KV 缓存降至 890 bytes/token,仅为上一代 DeepSeek-V4-Flash 的四分之一左右(缩减约 3.9 倍),相比初代 DeepSeek-V1 缩减约 437 倍。12
- 架构全面转向因果编码器-解码器(CED)配合多项工程创新。全模型共 40 层,由 20 层因果编码器与 20 层解码器组成;配合 SWA Bounded Replay(滑动窗口注意力有界重放)技术,SSD 持久化 KV 缓存仅需保留约八分之一;辅助模块集成 196B 参数的 Engram 条件记忆与 DSpark 投机解码。12
- 官方自测成绩在代码与 Agent 领域超越 V4 Pro。在厂商自测环境下,Instruct 版本在满血推理力度(
reasoning_effort=100)下,Terminal-Bench 2.1 达 90.6、DeepSWE v1.1 解决率达 74.2%、Codeforces 评分达 3471、AutomationBench 达 54.8,均优于 DeepSeek-V4-Pro。需要注意,上述指标属于 DeepSeek 内部框架与自测口径,独立第三方评测仍待社区验证。12 - 权重开放且协议为宽松 MIT。官方已在 Hugging Face 开放完整模型权重(Safetensors 格式,BF16/FP8 等),代码与权重均遵循 MIT 许可证,无商业营收门槛或专有商用限制。1
快速核对:新旧世代核心规格与底层架构对比
下表整理了官方技术报告中披露的 DeepSeek-V4.1-Flash 完整规格,并与历史基准模型进行横向比对:
| 评估维度 | DeepSeek-V4.1-Flash(最新技术报告) | DeepSeek-V4-Flash(上一代) | DeepSeek-V4-Pro-0813(过渡旗舰) | 官方信源说明 |
|---|---|---|---|---|
| 模型基础架构 | Causal Encoder-Decoder(CED)因果编码器-解码器 | 自回归 Decoder-Only MoE | 自回归 Decoder-Only MoE | 官方报告第 2 节详细定义了 CED 架构拓扑。12 |
| 骨干总参数量 | 552B(另含 196B Engram 条件记忆) | 284B | 1.6T | 官方技术报告首次披露各版本确切骨干参数。12 |
| 每 Token 激活参数 | Prefill 阶段 8B / Decode 阶段 16B | 13B(两阶段相同) | 49B(两阶段相同) | 4.1 版首次实现预填与解码的分离非对称激活。12 |
| MoE 专家配置 | 1 共享专家 + 384 路由专家(激活 6 个) | 1 共享专家 + 256 路由专家(激活 8 个) | 1 共享专家 + 多路由专家 | 路由专家数量大幅扩展至 384 个以提升稀疏表征。12 |
| 全局 KV 缓存大小 | 890 bytes/token(HBM 驻留) | 3,514 bytes/token | 官方未公开具体字节数 | 结合 CSA2 与 FP4 KV 缓存,占用降至上一代四分之一。12 |
| 持久化 KV 缓存 | 约上一代 1/8(SSD 驻留) | 基准持久化占用 | 需持久化完整上下文 | 通过 SWA Bounded Replay 仅持久化关键状态。12 |
| 支持上下文与输出 | 1M(1,000,000)上下文,384K 最大输出 | 1M 上下文,384K 输出 | 1M 上下文,384K 输出 | 与当前 API 生产配置保持一致。14 |
| 视觉模态支持 | 原生 DeepSeek-ViT(2D-RoPE + 3×3 unshuffle) | 实验性挂载视觉分支(Exp) | 不支持视觉输入 | 预训练阶段 45T 多模态数据端到端联合训练。12 |
| 预训练语料规模 | 45T 多模态 tokens(34T 起扩至 1M 上下文) | 未单独披露 | 未单独披露 | 官方报告 Pre-Training 章节数据。12 |
| 开源许可证 | MIT License(权重与代码均开源) | MIT License | 仅提供 API 商业服务 | 官方仓库已附带 MIT License 文件。1 |
架构拆解:CED、CSA2 与每 Token 890 字节缓存的实现机制
DeepSeek-V4.1-Flash 技术报告的核心贡献,集中在破解高吞吐长文本 Agent 场景下的「显存带宽墙」与「预填计算开销」。官方给出的解决方案是一套从模型拓扑、注意力算法到系统重放的系统性工程方案:2
1. 因果编码器-解码器(CED)与非对称激活
传统自回归大模型采用统一的 Decoder-Only 架构,无论在读取提示词的 Prefill 阶段还是逐字生成的 Decode 阶段,每一层都需要实时计算完整的注意力与前馈网络。在 Agent 长前缀场景下,这导致 Prefill 算力成本高昂。2
DeepSeek-V4.1-Flash 采用 40 层的 CED 架构,将其划分为 20 层因果编码器与 20 层解码器。关键设计在于:解码器的全局 KV 缓存直接由编码器最后一层的隐藏状态(Hidden States)通过线性投影生成,而不再依赖解码器内部各层重复计算。这一架构让模型在 Prefill 时仅需激活 8B 参数,而在 Decode 时激活 16B 参数。对于以长上下文提示、复杂工具调用和多轮环境反馈为主的 Agent 任务,预填阶段的计算与能量消耗大幅降低。12
2. 压缩稀疏注意力 2(CSA2)与跨层索引复用
在长序列推理中,KV 缓存膨胀是限制并发的核心瓶颈。CSA2 为每个注意力层静态指定三种工作模式之一:Full(完整模式)、Reindex(重索引模式) 或 Reuse(复用模式)。通过在层间共享主 KV 张量与索引键(Indexer K),并跨层直接复用 Top-K 稀疏注意力寻址索引,模型避免了每一层单独保存冗余 KV 状态。12
在解码器中,DeepSeek 进一步引入了分层稀疏索引器(Hierarchical Sparse Indexer),后续索引层仅在第一个 Full Mode 层建立的候选池中进行二次过滤,使得深层索引器的检索开销与整体上下文长度解耦。12
3. FP4 主 KV 缓存与 SWA Bounded Replay
- FP4 主 KV 缓存:采用 E2M1 数据格式,每 16 个通道分配一个 E4M3 缩放系数。这种精细的分组量化将 HBM 中驻留的全局 KV 缓存大小直接压缩至 890 字节/token。12
- SWA Bounded Replay(滑动窗口注意力有界重放):针对滑动窗口注意力(SWA),传统做法需要将窗口外部的 KV 状态持久化刷写到主机内存或 SSD。DeepSeek-V4.1-Flash 在推理服务中放弃了向 SSD 写入完整 SWA 状态,而是在需要时仅重放最近一个窗口长度()的少量 tokens 来即时重建丢失状态。这一系统优化将 SSD/主机内存中的持久化 KV 缓存占用压低至上一代 V4-Flash 的八分之一左右。12
4. 辅助效率模块与原生多模态视觉
- Single-Pass mHC:采用经过改良的残差流混合机制,并搭配高效的 Mega-mHC 定制算子以提升通信吞吐。2
- Engram 条件记忆:外置 196B 参数的静态记忆表,通过基于 token 的稀疏查表机制按需访问,在不增加稠密浮点计算负担的前提下扩展了模型的常识记忆容量。12
- DSpark 投机解码:采用半自回归草稿生成与置信度调度校验,进一步拉高推理生成速度。12
- 自研 DeepSeek-ViT:原生训练的视觉编码器结合 2D-RoPE 位置编码与 3×3 像素反混洗(Pixel-Unshuffle)下采样技术,通过两层 MLP 投射至语言模型隐藏空间,并在 45T 多模态数据中从初始阶段端到端联合训练。12
评测表现与能力边界:厂商自测基准深度核对
在官方技术报告与模型卡中,DeepSeek 分别给出了 Base 模型与经过后训练的 Instruct 模型的基准成绩。读者在参考这些数据时,需要注意评测口径均为厂商自测,并在特定的 Harness 环境下取得:12
1. 基础模型常识与理科基准(Base Model)
- 世界知识与学科综合:MMLU-Pro 5-shot 精准匹配率(EM)达到 74.1,高于 V4-Pro-Base 的 73.5 与 V4-Flash-Base 的 68.3;C-Eval 为 92.1(V4-Pro-Base 为 93.1);AGIEval 为 83.4(V4-Pro-Base 为 84.4)。1
- 代码与数学推理:HumanEval 0-shot Pass@1 达到 79.4%,显著领先 V4-Pro-Base(76.8%)与 V4-Flash-Base(69.5%);BigCodeBench 3-shot 为 60.6%(高于 Pro 的 59.2%);GSM8K 8-shot 为 93.0%(高于 Pro 的 92.6%);但在 MATH 4-shot 上,V4.1-Flash-Base 为 61.1%,仍略低于 V4-Pro-Base 的 64.5%。1
- 原生多模态表现:MMMU-Pro 4-shot 为 56.5,DocVQA 为 95.6,CVBench 为 77.9,补齐了此前 Base 模型无原生多模态评分的空白。1
2. Instruct 模型在 Agent 与复杂编码任务的表现
在后训练阶段,DeepSeek 采用了大规模自动化 Agent 任务合成配合强化学习(RL)与同策略蒸馏(On-Policy Distillation)。模型支持
reasoning_effort 从 1 到 100 整数连续调节。官方公布的最高推理力度(reasoning_effort=100,采样参数 temperature=1.0, top_p=0.95)评测显示:12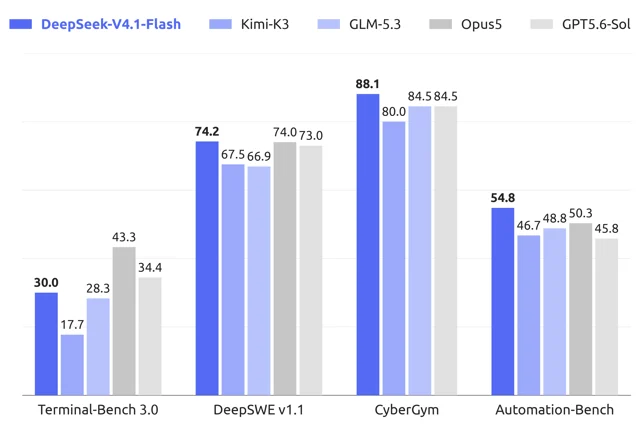
- 软件工程解决能力(DeepSWE v1.1):使用官方 mini-swe-agent 运行环境下,DeepSeek-V4.1-Flash 的解决率达到 74.2%,不仅超越 V4-Pro(62.7%)与 V4-Flash(54.4%),也微幅超越 GPT-5.6 Sol(73.0%)与 Opus-5.0(74.0%)。官方模型卡同时公布了不同 Agent 脚手架下的表现:在 DSH Minimal 下为 72.6%,Claude Code 下为 69.8%,Codex 下为 65.6%。1
- 终端与环境交互(Terminal-Bench):在无网络环境的 Terminal-Bench 2.1 上,V4.1-Flash 取得 90.6% 的 Pass@1,名列第一;而在更严苛的 Terminal-Bench 3.0 与 4.0 上,其得分分别为 30.0% 与 31.2%,相比上一代 V4-Flash(7.6% / 7.0%)有跨代提升,但相比行业顶级基准 Opus-5.0(43.3% / 51.8%)仍有清晰差距。1
- 网络安全与自动化:CyberGym 取得 88.1% Pass@1,优于 GLM-5.3(84.5%)与 GPT-5.6 Sol(84.5%);AutomationBench 达到 54.8%,优于 Opus-5.0(50.3%);在竞赛编程 Codeforces 上,官方测得评分达到 3471 分。1
本地推理生态与开发者工程建议
伴随权重与技术报告公开,DeepSeek 针对本地开发者与系统集成商同步开源了配套工程工具,并对部署环境提出了明确规范:1
1. 放弃 Jinja 模板,推出专用 deepseek-recipe 工具库
针对复杂对话、图像穿插、工具调用以及推理力度控制,本次发布未随附传统的 Jinja-format 模板。官方在仓库中提供了自包含的 Python 参考实现
encoding.py,并单独在 GitHub 开源了用 Rust 开发并提供 Python 绑定的专用库 deepseek-recipe。15 该工具库能够直接将 OpenAI 兼容的 Messages、Chat Completions 以及 Responses API 请求转换为 DeepSeek V4 与 V4.1 的原生 Prompt 与 Token ID,并负责将流式与完整输出反向解析为思考链与工具调用,工程团队无需再手写脆弱的正则解析器。152. 本地推理与私有化部署建议
- 显存与硬件评估:尽管模型在 HBM 中的 KV 缓存压低至 890 bytes/token,但由于 552B 骨干参数的存在,即使经过 FP8 量化或激活稀疏化,完整的本地全精度推理仍然需要企业级多卡集群(如多台 8×80GB GPU 节点)。对于显存有限的团队,优先采用 API 调用更为经济实用。14
- 长文本 Agent 架构优化:对于自建长前缀知识库或代码排错系统的团队,技术报告证实了前缀缓存(Prefix Caching)的绝对价值。由于解码器全局 KV 可以由编码器最后一层直接映射,在业务中固定系统提示与工具协议顺序,能够最大化利用底层 KV 复用机制,大幅压缩并发请求时的计算与传输延迟。12
- 商业集成权限:由于代码与权重均获得宽松的 MIT License 授权,企业与开发者可以直接将模型集成于商业系统、SaaS 平台或私有化算网中,无需额外签署定制授权协议。1
References
- 1DeepSeek-V4.1-Flash Model Card - Hugging Face
huggingface.co
- 2DeepSeek_V41_Tech_Report.pdf - Hugging Face
huggingface.co
- 3
- 4Models & Pricing - DeepSeek API Docs
api-docs.deepseek.com
- 5deepseek-recipe - GitHub Repository
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.