4B 开源模型把 Jev 挤下首位、同一个 Opus 5.5 在两个榜上差 13 分、四个本地软件掀开引擎盖是同一个内核
同一个基准上两家评测方给 Opus 5.5 差出 13 分、一个 4B 开源模型在决策榜上超过 Jev、同一份量化换个引擎从 15 到 65 tok/s:八组材料把决定数字的那一层指出来。

过去二十四小时里,八组材料的数字都指向同一件事:决定一个成绩或速度的,往往不是模型本身,而是量它的那一层。
同一个 Opus 5.5,在同一个科研基准上,一家评测方给出 61.9%,另一家给出 48.57%,中间隔了 13 分。一个 4B 的开源模型在决策榜上以 64.1 分坐上第一,把 Jev 1.13.0 的 63.3 分挤到第二,可同一页紧接着写:Jev 更聪明。同一份 IQ3_XXS 量化,换掉外面的推理引擎之后,作者报出的生成速度从 15 tok/s 变成约 65 tok/s。
这一期把八组材料的任务设定、运行条件、具体数字、分歧环节和作者自己承认的限制放在一起,供正在选模型、自己部署和报账的读者核对。覆盖 2026 年 9 月 24 日至 9 月 25 日,来源为 X、Reddit、小红书与公众号,另含两份公开评测页、一个开源榜与三处代码仓库。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 在一个科研基准上排模型 | Terminal-Bench-Science 0.1,70 道题、5 个学科;Artificial Analysis 用 mini-swe-agent 各跑 3 次取平均,VALS 用 Terminus 2 各跑 1 次 12 | AA:Astra 63.3%、Opus 5.5 61.9%(xhigh)与 59.0%(max);VALS:65.71%、48.57%、34.29% | 每个学科只有 8 到 19 道题;两家的 harness 与重复次数都不同,VALS 自己声明与官方榜不可比 |
| 给决策模型排名 | JevBench v1.4.2,89 个系统、四个轴等权调和平均,842 条决策(534 条冻结题 + 308 条封存题)3 | decider-4b v2 以 64.1 排第一,Jev 1.13.0 63.3 排第二;Intelligence 栏 Jev 53.1 高于 49.4;同一批系统公开集 83.5% 对封存集 34.7% | 榜首是自托管权重,评测方对它做过独立核验;训练数据与公开题是否重叠无法完全审计 |
| 比较两份「少想一点」的微调 | ThinkingCap 3.8-27B、Swift 3.8-27B 与母模型 Qwen3.8-27B,同一套 Aider 题、Q8_0、llama.cpp 0.5.0,各跑 2 次 4 | 首答 27.1% / 27.1% / 30.8%,重试后 77.6% / 77.6% / 75.7%;完成 token 中位 7,436 / 12,547 / 7,301;每例 777 / 1,481 / 750 秒 | 题量刚过 100 道,误差约 ±2 到 3 个百分点;评论区质疑两份不同权重给出相同成绩 |
| 12GB 显存跑 125B | RTX 5070 12GB 加 64GB DDR5,自写引擎 Strata,模型为 Qwen3.8-Flash-Next 56 | 同一个 IQ3_XXS 从 15 tok/s 到约 65 tok/s;128K 上下文下三档为 65.1 / 52.0 / 44.8 tok/s | 引擎只针对 CUDA 优化;数字来自作者本人,帖子的 65 与表里 128K 档的 44.8 不是同一个口径 |
| 低比特量化对 FP8 | 2×R9700 加 64GB DDR5,vLLM;Flash Next IQ4_XS 对 27B FP8,250 题缩减版 7 | MMLU-Pro 83.8% 对 75.0%、GPQA Diamond 42.5% 对 27.5%、GSM8K 97.5% 对 90.0%;250 题 36 分 27 秒 对 2 小时 05 分 | MMLU-Pro 只随机抽了 80 题;并发时换成 FP8 27B 反而快约 4 倍 |
| 同一台 Mac 上升级引擎 | oMLX 0.7.0rc1,M5 Max 128GB,oQ4e 量化 89 | 预填 16K 从 1,522 到 2,007 tok/s;批量解码从 56.9 到 131.5;一轮对话的下一轮预填从 1,174 token 降到 37 | 仍是候选版;每个对照用的是各自改动之前的主干,预填为单次运行 |
| 四个本地推理软件 | Mozilla AI 横评:M4 Max、一台 L40S 服务器、Steam Deck 三台机器,同一批 GGUF,每个数据点 15 次取中间 10 次 1011 | 预填差距只有几个百分点;同一份代码两种编译在 Deck 上差 1.6 倍、9B 预填 +63.3%;NVIDIA 上开 CUDA graphs 出字 +16.8% | 横评发布于 9 月 17 日;各家默认设置不同,MLX 那一节两边跑的甚至不是同一份权重 |
| 同一个模型换个入口 | 小红书:Trae 里提供的 deepseek-v4.1-flash 对官方 API 12 | 速度慢了一半多 | 是单次对比,输出质量作者说还在测试;评论区给出三种解释 |
同一个基准,两家跑出两个 Opus 5.5
Terminal-Bench-Science 0.1 是一个科研工作流基准,70 道题全部由在职科学家出题与复核,覆盖生命科学 19 道、物理科学 17 道、数学科学 17 道、工程科学 9 道、地球科学 8 道;每道题在自己的终端沙箱里做完,由出题人写的验证测试判定通过与否,没有部分分 12。
Artificial Analysis 在 9 月 25 日上线了这个基准的榜单,测法是每个任务用 mini-swe-agent 跑三次、报三次平均的 pass@1。结果只有两个模型过了一半:GPT-6 Astra(max)63.3%,Claude Opus 5.5 在 xhigh 档 61.9%、在 max 档 59.0%;开放权重里最好的 GLM-5.3(max)10%、DeepSeek V4.1 Flash(max)9%,比榜首低 50 多个百分点 113。按学科拆开还有一条:Opus 5.5 在数学科学上过了 71%,在生命科学上只有 46%,生命科学是多数前沿模型得分最低的一栏——不过每个学科只有 8 到 19 道题,这一栏的数字本身就带噪声 13。
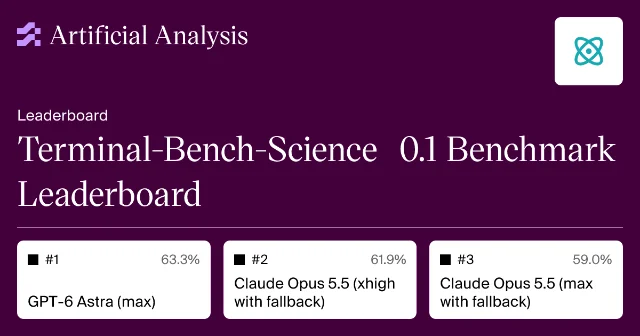
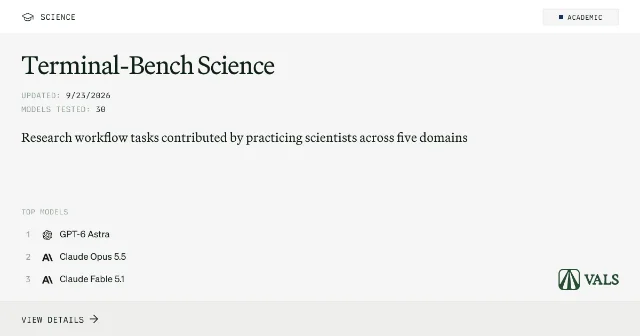
两家测的是同一批题,结论却差得很远。VALS 那边,Opus 5.5 只有 48.57%,比 Artificial Analysis 的 61.9% 低 13.3 个百分点,也低于它自己在 xhigh 与 max 两档的差距;27 个模型里有 14 个落在 4.29% 及以下,4 个一道题都没过 2。
VALS 把差别的原因写在了方法一节:官方榜单给每个模型配它自己的原生 agent(Claude Code、Codex、Grok Build)并跑三次取平均,而 VALS 固定用 Terminus 2、每个模型只跑一次,所以它预期自己的数字多数情况下会低于官方,「一个厂商自家的 agent 是为它调过的」2。同一份说明里还有两处值得记住:任务是按正确答案定标的,一道「几乎做对」的研究结果记零分;每道题允许 agent 工作八小时(对比 Terminal-Bench 2.1 的 15 到 60 分钟),所以会算下去的模型一直算下去就一直计费——VALS 记的每任务成本从 0.19 美元到 51.62 美元,跨度超过 250 倍,而且和分数不成正比:GLM 5.3 花 24.91 美元换来 4.29%,GPT-5.6 Luna 花 0.56 美元拿到 5.71% 2。
一个 4B 模型坐上第一,同一页说它不如第二名
JevBench 在 9 月 24 日放出 v1.4.2,榜上现在有 89 个系统,从闭源的 Jev 到各种开源复现、零样本分类器和重排模型都在一张表上 3。
排第一的是 decider-4b v2,一个 4B 的开源模型,综合分 64.1;Jev 1.13.0 以 63.3 排第二 3。在 X 上转这条榜的人写得很直白:「一个 4B 开源模型在榜上打败了 Jev」,紧接着一句「但 Jev 仍然更聪明」14。这句不是找补,是榜单自己的算法:综合分是智力、校准、速度、成本四个轴的等权调和平均,只要有一个轴落后,总分就被拉住。拆开看,decider-4b v2 的智力 49.4、校准 75.0、速度 92.9、成本 60.9,Jev 1.13.0 是 53.1、76.3、83.3、52.0——Jev 赢在智力与校准,输在速度与成本,等权之后落到第二 3。
这套算法把名次翻得更厉害的地方在榜尾。GPT-6 Luna 的智力一项是 96、校准 92,总分却只有 35.1;DeepSeek V4.1 Flash 的智力 94,总分 4.8,在榜上几乎垫底;原因是这两者的成本轴分别只有 37 和 17 3。换句话说,这个榜排的是「单位成本的决策能力」,不是「谁判得准」;要按智力那一栏排序看,名次是另一个样子。
这一版还把训练数据的问题摊开了。榜单给每个系统标了公开集与封存集的成绩:decider-4b v2 公开集 83.5%、封存集 34.7%,差 48.8 个百分点;Jev 1.13.0 是 86.6% 对 36.7%,差 49.9 个百分点 3。榜方对第一名的核验也写在同一行:权重、服务端版本、校准温度、跑法都点名公开,8,000 条训练样本由「十个封存家族的已公布名字」生成的合成数据构成(没有读过任何题目),9 月 24 日的独立核验结论是「LEGIT」;但作者私有的第二阶段训练数据无法审计是否与公开题重叠,这一条也留在旁边 3。
中文这边,公众号「知之不多」在 9 月 24 日把 Jev 上市一周后的三份独立横评并排读了一遍,结论是同一个模型在三份评测里的位置互不相同:在 9 月 19 日那一版、242 条决策的 JevBench 上,Jev 以 96.3% 排第二、输给 GPT-5.6 Luna 的低推理档 97.1%,两家的置信区间还有重叠;在 300 道题各跑 5 遍的 Jevals 上,Jev 在判断类题目上与 Gemini 3.8 Flash 并列第一、价格是它的 1/28,在 77 个意图的分类题上 79.7% 排第二;而在一篇 arXiv 论文的 18 个任务、7,977 条数据里,它在 15 个可比任务中落后 14 个,中位差 11.6 个 macro-F1 点,同期的成本中位数低 44 倍 15。这篇还把 Vercel 的一句口径单独拎出来降温:Jev 上线 24 小时被网关客户里近 13% 的付费团队接上,是 GPT-5.6 家族的 2 倍、Fable 5.1 的 6 倍,但那几天 Jev 在网关上是免费的 15。
两份「少想一点」的微调,一份跟母模型逐项相同
r/LocalLLaMA 上有一位长期做 Aider 评测的作者,把两份目标相同的微调拉到同一套题上:ThinkingCap-Qwen3.8-27B 和 Swift-Qwen3.8-27B 都想解决 3.8-27B 想得太多的问题,两边都声称推理 token 减少约 40%、性能几乎不掉 4。
三份权重都在 Q8_0、llama.cpp 0.5.0 下各跑两遍。首答通过率是 27.1%、27.1%、30.8%,重试之后是 77.6%、77.6%、75.7%;中位完成 token 是 7,436、12,547、7,301;每例耗时 777 秒、1,481 秒、750 秒 4。
作者自己在帖子里用了「震惊」这个词:ThinkingCap 与未微调的母模型逐项完全相同——通过率一样、token 一样、耗时一样,「我从来没有见过同一个模型跑两遍成绩一样,就当这是巧合」;他同时说,两家宣称的减 40% 推理 token 在数字上站得住,两份微调的中位 token 都比母模型少了近 5,000;Swift 在噪声范围内、总分低 2 个百分点,但首答通过率是三份里最高的 4。
Loading content card…
评论区第一位提出的正是那份「相同」:两份不同的 27B 权重不可能在 107 道采样题上给出逐位相同的通过率,除非 harness 把同一个文件跑了两遍、或者结果在两次运行之间被缓存;这位评论者建议先把两个 GGUF 做校验、再跑一次固定种子的对比 4。作者的回应是:题量刚过 100,保留一位小数时两者比例本来就可能相同,他为弄清「改多少权重才能让 token 用量差这么多」做过权重分析,没有把两个 GGUF 搞混。这段问答比成绩本身更值得看:一份第三方横评先被质疑,再被作者用方法回应,两边都没被删 4。
作者还留了几处容易被忽略的限制:两份微调在失败题上花的 token 都多于做对的题(Swift 是 13.2k 对 5.9k,ThinkingCap 是 9.4k 对 6.8k);ThinkingCap 的平均完成 token 比 Swift 多 8.5%,因为它的长尾更长;按语言拆,ThinkingCap 在 C++ 上明显弱于 Swift(重试后差 8 个百分点),在 JavaScript 和 Python 上又分别高 4 与 6 个百分点,这几项之外的语言差异在统计上不显著 4。
同一份量化,换自己写的引擎:15 到 65
r/LocalLLaMA 另一位作者做的是另一层的事。他之前在同一张 12GB 的 RTX 5070 上,用 llama.cpp 跑 Qwen3.8-Flash-Next 的 IQ3_XXS 量化,生成 15 tok/s、预填 100 到 120 tok/s;这几个月他给这一个模型、这一类 PC 自己写了一版推理引擎 Strata,同一个 IQ3_XXS 现在约 65 tok/s 生成、约 430 tok/s 预填 5。
同一篇帖子里还有一张 128K 上下文下的表,三档量化的生成速度是 Q2_0 65.1、IQ2_XS 52.0、IQ3_XXS 44.8 tok/s,预填是 543、472、414 tok/s 5。这张表里有两个容易读错的地方,作者自己也没有把话说圆:他开头说的「同一个 IQ3_XXS 现在约 65」与表里 128K 档的 44.8 不是同一个口径,65 更接近短对话下的读数;另外位数更低的 Q2_0 反而比 IQ3_XXS 快,这与「压缩更多必然更慢」的直觉相反,但和另一份实测(低比特在质量与速度上都咬得住)方向一致 5。
引擎仓库把条件写得更全:需要一张 12GB 显存以上的 RTX 30/40/50 系显卡、64GB 内存、约 80GB 磁盘;三档权重的下载量分别是 66GB、68GB、76GB;短对话下生成 95 / 78 / 66 tok/s,128K 下 65 / 52 / 45 tok/s,读入提示词 539 / 463 / 410 tok/s;仓库自己写着「一次只答一个请求,每答一句都要重读整段对话,所以很长的对话里大约每 3 万 token 要等一分钟才开口」6。它的做法是把 24,576 个专家留在内存里、由 CPU 与 GPU 同时算 GPU 装不下的那几个,再让模型内部的小助手一次猜几个词、一次校验多个猜测,作者称这样比逐词出字快 1.6 到 1.8 倍且结果完全相同6。数字都是作者自测;仓库里同时给了另一张卡的量级估计(24GB 的 3090 大约 100 到 140 tok/s),这一类外推没有实测支撑6。
Loading content card…
同一台机器上低比特反超 FP8,并发时反过来
同一类机器上的另一个问题是:低比特量化到底能不能替代高精度。r/LocalLLaMA 上一位作者用两台 R9700 加 64GB DDR5,把 Qwen3.8-Flash-Next 的 IQ4_XS(vLLM 加 r9v)和 Qwen3.8-27B 的 FP8(vLLM 加 Radiance)放在同一批题上对跑 7。
结果是低比特那一侧全面领先:MMLU-Pro 83.8% 对 75.0%、GPQA Diamond 42.5% 对 27.5%、GSM8K 97.5% 对 90.0%、德语 MGSM 92.5% 对 90.0%,只有 IFEval 两边打平在 89.6% 7。速度和它一致:一份 250 题的快测,27B FP8 用了 36 分 27 秒,Flash Next IQ4_XS 用了 2 小时 05 分 47 秒7。
作者自己把这份测试的边界交代得很清楚:这不是完整评测,只用缩减版快测、MMLU-Pro 只随机抽了 80 题,其他几项也不是全量,所以不能拿具体数字当准;整套快测花了约两小时,如果要跑完整版在他这台机器上要超过 8 小时;他用的是 64GB 内存,如果换成 128GB 还可以改用另一份 MXFP4 量化,那一版大约能快一倍 7。
这帖的由来也是一个分歧:论坛上每周都有评论说 27B 的 FP8 好过低比特的 Flash Next,作者想验证这件事。他给出的结论分两种用法——单人使用他仍然选 Flash Next 的低比特,但换成并发,情况反过来,在他这台机器上 FP8 27B 大约比 Flash Next 快 4 倍 7。同一份权重,服务一个人还是服务一群人,答案不是一个。
同一台 Mac,批量解码从 56.9 到 131.5
第三组发生在同一台机器上,换掉的只有引擎。oMLX 是一个面向 Mac 的推理项目,作者在 9 月 25 日发出 0.7.0rc1,并在发布说明里给了对照表,全部测在一台 128GB 的 M5 Max 上、oQ4e 量化下 9。
预填这一栏,16K 上下文从 1,522 涨到 2,007 tok/s、64K 从 1,326 涨到 1,716 tok/s;批量解码这一栏动得更大,四个请求同时进来、短编码提示词,Qwen3.8-27B 走 DFlash2 从 56.9 涨到 131.5 tok/s,走 Lightning MTP 从 88.9 涨到 136.9 tok/s 9。另有个小改动值得单独记:过去一段已缓存的对话,只要最后一小段没填满完整的缓存块,下次就得重算几千个 token;加上局部块缓存之后,一个 13.4K token 的测试里下一轮预填从 1,174 个 token 降到 37 个,首字时间从 0.83 秒降到 0.42 秒 9。
Loading content card…
四个本地软件掀开是同一个内核,差在编译
最后两组的共同点更直接:换的是外面那一层。Mozilla AI 在 9 月 17 日发布了一份本地推理软件横评,把 llama.cpp、llamafile、LM Studio、Ollama 放在三台机器上比——M4 Max 的 Mac Studio、一台带 L40S 的 Linux 服务器、一台 Steam Deck,模型是 Qwen3.5 的 0.8B、9B 与 Qwen3.8 的 27B,提示词从 1,024 扫到 8,192 token;每个数据点跑 15 次,去掉第一次热身与最快最慢各两次,取中间 10 次的平均,每轮测试前软件重启、四个软件轮着跑,免得机器状态漂移偏袒先跑的那个 10。
固定权重与环境之后,四个软件在预填上的差距只有几个百分点——因为它们底层都是 llama.cpp,Ollama 与 LM Studio 是在外面套了一层,llamafile 是同一个内核的单文件打包版。出字上的差距大部分也不是软件:那是主机侧每个 token 的固定开销,Mac 上约 0.4 毫秒、L40S 上约 1.8 毫秒、Steam Deck 上约 5.4 毫秒,在快模型上占 67%、在慢模型上只占 18% 10。
真正把数字推动几十个百分点的是三件与软件选择无关的事。第一件是编译方式:llamafile 之前发布的 CUDA 后端没有打开 CUDA graphs,打开之后出字提升 0.8B 上 16.8%、9B 上 6.5%、27B 上 4.3%;在 Steam Deck 上,同一份代码换一版 Vulkan 着色器工具链(Ubuntu 24.04 的 shaderc 2023.8 换成 LunarG Vulkan SDK 2026.03),9B 的预填提升 63.3%、出字提升 18.2%,同一份代码两种编译方式在这台机器上最多差 1.6 倍 10。第二件是投机解码的草稿长度,而且方向随机型翻转:在 Mac 上按 Ollama 的库默认值开 4 个 token 的草稿,27B 的出字约 15 tok/s,比干脆不开的 23.4 tok/s 还慢;改成 2 就回到 24 到 25 tok/s;同样这一项在 L40S 上反过来,4 比 2 最多快 16% 10。第三件是模型文件本身:在 Apple 芯片上,Ollama 与 LM Studio 各自都有 MLX 版本,换成各自的 MLX 权重后两者预填都提升约 10%,但这一节里两边的权重并不相同(一边 4 位 affine、15GB,一边 nvfp4、18.2GB),Ollama 的 MLX 还会自己打开投机解码,所以这一栏只能各自和自己比 10。
中文这边,公众号「硅谷煮夫」在 9 月 24 日把这份横评又走了一遍,并补了一条横评原文里最容易被忽略的结论:LM Studio 在 Steam Deck 上落后,是因为它出厂就带着预编译的运行时,用户改不了,而另外三个可以 11。这篇作者也交代了自己上期说过的话被数据打脸:他原先写过「同样模型换个推理软件速度能差一倍」,读完数据之后收回,改成「软件这一层是平的,坑和油门都在更下面」 11。
同一个模型,换个入口慢一半多
国内这边有一组更贴近日常的使用:小红书上一位作者把 Trae 里提供的 deepseek-v4.1-flash 和官方 API 的同一个模型放在一起对跑,结果是 Trae 这一侧速度慢了一半多;他明说输出质量还在测,用 Trae 主要图的是免费积分 12。
评论区没有给结论,给了三种解释:一位说那是火山引擎自部署的版本、「能力会比 DS 的强一些」;一位说「Trae 一直这个尿性」;还有一位把原因落在 harness 上,认为两边跑的根本不是同一套调用方式 12。三种解释指向的都是同一件事:名字一样,不等于你拿到的、和你后面挂的那一层都一样。
拿到一个数字之前,先看它是哪一层量出来的
今天这八组给不出一个统一的名次,能带走的是一套看数字的动作。三句话够用。
第一句,先问这一栏是谁在跑、及格线画在哪。Terminal-Bench-Science 上同一批 70 道题,Artificial Analysis 用 mini-swe-agent 跑三次,Opus 5.5 是 61.9%;VALS 用 Terminus 2 跑一次,同一个模型是 48.57%;VALS 自己把原因写在方法里——官方榜给每个模型配它自家的 agent 并取三次平均。JevBench 排的是四轴等权调和平均,所以智力 94 的 DeepSeek V4.1 Flash 总分只有 4.8。看到名次,先看它比的是哪一栏。
第二句,再问这一层里什么东西被换掉了,或者换给了谁。同一份 IQ3_XXS 在两张不同的引擎里是 15 和约 65 tok/s;同一台 Mac 换一版引擎,四个并发请求下的批量解码从 56.9 涨到 131.5 tok/s;同一份 llamafile 代码换一版着色器工具链,Steam Deck 上 9B 的预填涨 63.3%。这些数字全都不在模型里。
第三句,最后问这个数是在什么状态下量的,量的是谁拿到的那一份。ThinkingCap 与母模型逐项相同,评论区的第一反应是查 harness 有没有复用文件;Trae 里的 deepseek-v4.1-flash 与官方 API 差了半倍速度,评论区给出三种解释;27B 的 FP8 在单人使用时输给低比特,换成并发又快约 4 倍。
最后留一个能自己动手的核对项:拿你手上正在比的两个模型或两份配置,只换一处条件再跑一次——把推理软件升到最新版、把投机解码的草稿长度从默认改成 2、或者把你给的选项名从 0 和 1 换成随机字符串——然后把速度、质量和你这一趟的账单一起记下来。今天这几组里,60% 左右的预填差距、1.6 倍的编译差距、13 分的榜单差距,隔的都是这一处。
References
- 1Terminal-Bench-Science 0.1 Benchmark Leaderboard\
artificialanalysis.ai
- 2Terminal-Bench Science\
vals.ai
- 3JevBench by Benchmark Heaven\
benchmarkheaven.com
- 4
- 5
- 6Niko1221/Strata\
github.com
- 7
- 8X:oMLX 0.7.0rc1\
x.com
- 9Release 0.7.0rc1 · jundot/omlx\
github.com
- 10
- 11公众号 硅谷煮夫:本地跑AI的四个软件怎么选?\
mp.weixin.qq.com
- 12小红书 Jiewi:trae模型确实掺水\
xiaohongshu.com
- 13
- 14
- 15公众号 知之不多:Jev 火了一周,三份横评把它拉回了地面
mp.weixin.qq.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.