Grok Voice 3.0 发布:语音指数 86.9 排第一,价格仍是 $0.08 一分钟,别名已经自动换了模型
xAI 发布 Grok Voice 3.0:第三方语音到语音指数 86.9 排第一,$0.08 一分钟没有涨价;把四项拆开,语音推理只排第 4,首音频延迟也比上一代慢了 0.11 秒。

10 月 14 日,xAI 发布语音到语音模型 Grok Voice 3.0,当天就在 Voice Agent API 里开放调用。1
语音到语音指的是音频进、音频出,中间不经过文字这一层。Grok Voice 3.0 的价格与上一代 Grok Voice 2.0 相同:每分钟 0.08 美元,合每小时 4.80 美元。2
比价格更值得留意的是别名。
grok-voice-latest 现在指向 Grok Voice 3.0,用这个别名跑的服务已经换到新模型;写死 grok-voice-2.0 的请求则落在一个被标为弃用的模型上。3先说结论
- 模型与状态:Grok Voice 3.0,2026 年 10 月 14 日发布,同日上线 API 与开发文档。1
- 参数规模:官方未披露,公告、模型页与文档都只写「语音到语音」,没有给参数量或架构。14
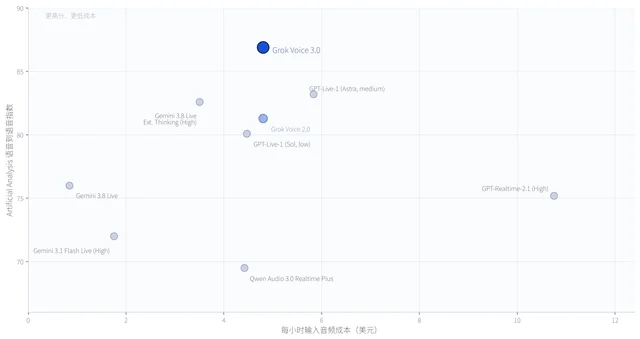
- 第三方评分:Artificial Analysis 的语音到语音指数给 86.9,在所有拿到综合分的模型里排第一,上一代是 81.3。5
- 这个第一的边界:综合分由四项等权平均,其中语音推理排第 4,τ-Voice 低于 GPT-Live-1。5
- 价格:$0.08/分钟($4.80/小时),每条文本消息另收 $0.004,与上一代相同。24
- 怎么调用:端点、会话参数、事件都没变;
grok-voice-latest已指向 3.0,写死 2.0 的代码要改模型名。3 - 硬限制:每团队 10 个并发会话,单会话最长 120 分钟,只有 us-east-1 一个集群。4
- 什么时候要动:正在做语音客服或语音 agent,并且卡在延迟或每通电话成本上的团队,值得拿自己的录音重跑一遍;只做语音合成与转写的团队不受影响。
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与状态 | Grok Voice 3.0,2026 年 10 月 14 日发布,同日可用 | 官方公告 |
| 发布方 | xAI(SpaceXAI) | 官方公告 |
| 定位 | 上一代 Grok Voice 2.0 的替代版本,语音到语音 | 定价页 |
| 参数规模 | 官方未披露 | 模型页 |
| 模态 | 文本与音频进,文本与音频出 | 模型页 |
| 端点 | WebSocket,wss://api.x.ai/v1/realtime | 语音文档 |
| 模型名 | grok-voice-latest 是 grok-voice-3.0 的别名;grok-voice-2.0 已标弃用 | 语音文档 |
| 音频价格 | $0.08/分钟($4.80/小时) | 定价页 |
| 文本输入价格 | $0.004 每条 conversation.item.create,工具返回不计费 | 模型页 |
| 并发 | 每团队 10 个并发会话 | 模型页 |
| 单会话时长 | 最长 120 分钟 | 模型页 |
| 区域 | us-east-1 | 模型页 |
| 工具 | 联网搜索、X 搜索、文件检索、远程 MCP、自定义函数 | 语音文档 |
| 思考档位 | reasoning.effort 取 high 或 none,默认 high | 语音文档 |
| 声音 | 内置声音在文档里逐个列出,eve 为默认;支持自定义克隆声音 | 语音能力总览 |
| 需要动作 | 写死 grok-voice-2.0 的改模型名;用 grok-voice-latest 的服务已自动切换 | 语音文档 |
| benchmark 来源 | 官方转述 Artificial Analysis 榜与 ServiceNow EVA-Bench | 官方公告 |
换的是模型,接口没有动
xAI 在文档里写得很直接:Grok Voice 3.0 用的端点、会话参数与事件跟 2.0 完全一样,价格也一样。3
对已经在跑的服务,这意味着不用改代码,
grok-voice-latest 会自动接上 3.0。32.0 什么时候停服,文档没有给日期。3
有一个旋钮值得先看:
reasoning.effort 默认取 high,也可以设成 none。3 关掉思考能换来更快的开口,代价是模型不再先想一遍再回答,官方没有给这两档的能力对照。86.9 分怎么来的:任务成功率第一,语音推理第四
官方公告把 86.9 分放在最前面,称这是独立测试里排第一的语音到语音模型。1
榜单上确实如此:在所有拿到综合分的模型里,86.9 是最高分。5
综合分由四项等权平均得来:Big Bench Audio 的推理正确率、τ-Voice、人评换算分、任务成功率。
Big Bench Audio 把推理题读成音频让模型听,按答对比例计分。5
τ-Voice 让模拟顾客打进来,按通话结束后的数据库状态判对错。这项离企业客服最近。5
人评来自 Speech Agent Arena 的 Elo 换算,第四项是任务成功率。5
四项拆开看,这个第一由什么构成就清楚了。5
| 模型 | 综合指数 | 语音推理 | 对话动态 | τ-Voice | 人评 Elo | 任务成功率 | 首音频延迟 | 每小时成本 |
|---|---|---|---|---|---|---|---|---|
| Grok Voice 3.0 | 86.9 | 99% | 97.0% | 71.6% | 1070 | 94.8% | 0.81 秒 | $4.80 |
| Grok Voice 2.0 | 81.3 | 97% | 95.1% | 56.5% | 1011 | 94.6% | 0.70 秒 | $4.80 |
| GPT-Live-1 (Astra, medium) | 83.2 | 90% | 94.9% | 74.5% | 1056 | 87.4% | 1.34 秒 | $5.83 |
| Gemini 3.8 Live Ext. Thinking (High) | 82.6 | 98% | 91.9% | 68.6% | 993 | 89.1% | 1.35 秒 | $3.50 |
| Gemini 3.8 Live | 76.0 | 92% | 96.1% | 30.1% | 1088 | 93.2% | 1.18 秒 | $0.84 |
| GPT-Realtime-2.1 (High) | 75.2 | 96% | 95.7% | 45.7% | 939 | 91.5% | 1.21 秒 | $10.75 |
数据全部取自 Artificial Analysis 语音到语音榜,2026 年 10 月 17 日读取。「语音推理」是 Big Bench Audio 的正确率,该列按榜单页显示取整(Grok Voice 3.0 的 98.5% 显示为 99%)。「对话动态」是 Full Duplex Bench,衡量模型能不能接住停顿、抢话与「嗯」这类附和,这一列不进综合分。「首音频延迟」是从用户说完到模型出声第一帧的秒数。「每小时成本」指跑完固定 40 题、按输入音频时长折算成一小时的费用。
任务成功率排第一:94.8%,比上一代高 0.2 个百分点。5
语音推理排第 4。前面三个是 StepAudio 3 Realtime 的 99.7%、Qwen Audio 3.0 Realtime Plus 的 99.2%、Qwen3.5 Omni Plus Realtime 的 98.7%。5
对话动态不进综合分,但它决定一次真实通话顺不顺,所以照样值得看:Grok Voice 3.0 这一项排第 4,前面是 StepAudio 3 Realtime 98.9%、Qwen Audio 3.0 Realtime Plus 98.4%、GPT-Live-1 的 Sol 低思考档 97.3%。5
τ-Voice 这一项最值得留意:71.6% 落后于 GPT-Live-1 (Astra, medium) 的 74.5%。5
官方强调的「不到一秒」,上一代已经做到了:Grok Voice 2.0 的首音频延迟是 0.70 秒,比 3.0 快 0.11 秒。5
榜单上比它更快的还有三个:Raon SpeechChat 0.04 秒、Deepslate Opal 0.44 秒、Gemini 2.5 Flash Native Audio Dialog 0.63 秒,这三个都还没有综合分。5
在拿到综合分的模型里,0.81 秒排在前列,与 GPT-Realtime-1.5、GPT Realtime Mini 相同。5
人评 Elo 也有比它高的:Gemini 3.8 Live 是 1088,Gemini 3.1 Flash Live 的最低思考档是 1100。5
四项里,任务成功率第一,τ-Voice 第二,语音推理第四;人评那一项在指数里用的是冻结分,榜单只显示实时 Elo,名次读不出来。
成本这一栏的对比更直接:Grok Voice 3.0 每小时输入音频 4.80 美元,Gemini 3.8 Live 是 0.84 美元。5 后者的综合分低 10.9 分,价钱只有它的五分之一左右。
官方给的另外三个数字
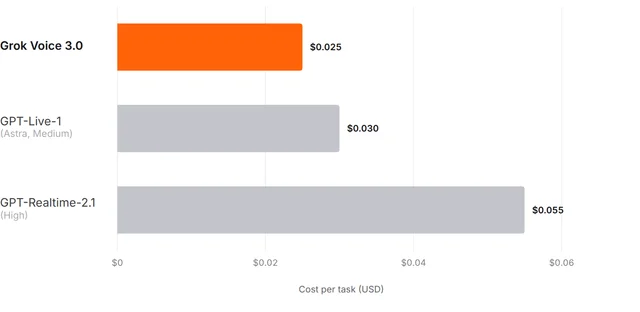
EVA-Bench 是 ServiceNow 开源的语音 agent 评测,场景分航空客服、企业 IT 支持与人力资源三类,合计 213 个。6
Grok Voice 3.0 在 EVA-Bench 上拿到 74% 的准确率,是最高分;把准确率与对话体验放在一起评分,它同样排第一。1
这一条只能按官方转述引用。EVA 官网的榜单要脚本渲染,这次没有取到逐模型分值;仓库里的实验设置列了被测系统,其中没有 Grok Voice。7
Starlink 的客服中心每天用 Grok Voice 接 2 万通电话,覆盖多种语言,其中约 70% 在没有人工介入的情况下解决,四分之一的销售电话在挂断前成交。1 一个接入的 agent 能完成核验客户、排查硬件、发放补偿与寄送替换设备。1
Tesla 的车里每天跑数百万通对话,接的是日历、回邮件这类 Connectors 请求,以及点咖啡、订晚餐这类 Grok Bot 任务。1 这两个数字由 xAI 自己给出,没有第三方核对。
价格与可用范围
| 项目 | 价格 |
|---|---|
| 音频 | $0.08/分钟($4.80/小时) |
| 文本输入 | $0.004 每条 conversation.item.create |
| 服务端工具返回 | 不计费 |
有三条计费细节会改变实际账单。自动断句(
server_vad)的会话按整段会话时长计费;按键说话(push-to-talk)的会话只按发送与接收的音频计费。4客户端发来的
function_call_output 不计费,其余 conversation.item.create 每条 0.004 美元。4 response.create 也不计费,它只让模型开始下一轮。4限制方面:每团队 10 个并发会话,单会话最长 120 分钟,只有 us-east-1 一个集群。4 官方举的 Starlink 案例是每天 2 万通,10 个并发会话显然撑不住这个量级。
合规方面,官方说音频实时处理、不存储也不用于训练,并列出 SOC 2 Type II、可签 BAA 的 HIPAA、GDPR 与区域驻留。8
该不该试
- 已经在用
grok-voice-latest:模型已经换完了。要做的是拿自己的通话录音重跑一遍,重点看多轮工具任务,那是公开数据里它落后的一项。5 - 写死了
grok-voice-2.0:把模型名改成grok-voice-3.0,接口不用动。3 - 自建 STT、LLM、TTS 三段式:值得比一次。三段式每一步都能单独换、单独看日志,代价是音频要在三段之间各走一遍,延迟叠三次。
- 做英文客服中心:先算并发。10 个并发会话决定一天能接多少通,文档没有写提额路径。4
- 面向中文用户:官方只说 Starlink 客服覆盖多种语言,没有给语音到语音的语言清单。1 中文效果得自己测。
- 要私有化部署:这条路没有。Grok Voice 3.0 只以 API 形式提供。4
还没有的数字
References
- 1
- 2xAI API Pricing
docs.x.ai
- 3Speech to Speech 文档
docs.x.ai
- 4语音到语音模型页
docs.x.ai
- 5Artificial Analysis 语音到语音榜
artificialanalysis.ai
- 6EVA-Bench 官网
servicenow.github.io
- 7ServiceNow/eva 仓库
github.com
- 8语音能力总览
docs.x.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.