Gemini 4 Carbon:官方 Benchmark 总表,与一份尚未公开的模型卡
Google 10 月 28 日发布 Gemini 4 Carbon,只先开给网络防御方;本文用一张官方总表给出它与 Argon、GPT-6 Astra、GPT-6.1 Terra、Claude Opus 5.5 / Fable 5.1、DeepSeek-V4.1-Flash、Kimi K3、GLM-5.3 的可核验跑分,并交代网络安全三项是在关掉 guardrails、脚手架与时间上限各不相同的条件下测出来的。

Google 在 10 月 28 日发布 Gemini 4 Carbon,官方称其为「our next frontier model」,把网络安全与长时程任务列为主打方向。1
它是 Gemini 4 家族的第二款,第一款 Argon 在两周前发布。作者栏挂的是 Koray Kavukcuoglu,Google DeepMind 高级副总裁兼 Google 首席 AI 架构师。2
价格与 Argon 相同:介绍期每百万 token 输入 2 美元、输出 10 美元,缓存输入在输入价上再降 95%,也就是 0.1 美元。介绍期结束后,价格回到输入 4 美元、输出 20 美元。1
拿到它的顺序也值得先记住。本周起先给一部分网络防御方,之后通过 Fairwind Program 逐步开放给受信伙伴,再往后才轮到开发者、企业与消费者;Google 同时参与美国政府那套发布前自愿测试流程。1
换句话说,下面所有分数都出自 Google 自己的材料,读者手上暂时没有可以复测的入口。
一张合并总表
表内九列模型。数值只取官方正文写出的数,以及官方图表上自带数据标签的柱标;需要从坐标轴位置估读的一律不录。格子里的「—」表示该模型在对应来源没有披露这一项,读表时按缺项计。
每行最高值加粗;标注「越少越好」的两行改加粗最低值。同一个 benchmark、同一个模型在两个官方来源数值不同时,格内并列两个值并标 ⚠️。
| Benchmark(条件与档位) | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | GPT-6.1 Terra | Claude Opus 5.5 | Claude Fable 5.1 | DeepSeek-V4.1-Flash | Kimi K3 | GLM-5.3 | 来源与口径 |
|---|---|---|---|---|---|---|---|---|---|---|
| AA Index v5.0(第三方综合指数,越高越好) | 59 | 50 | 57 | — | 58 | 49 | — | — | — | Google 只给分,不给指数构成 1 |
| Vals Index v2.2(Vals AI,越高越好) | 70.4% | 69.2% | 65.0% | — | 70.2% | — | — | — | — | Argon 模型卡报的 Vals Index 是 68.9%,版本不同,未并列 13 |
| SWE-sweep(agentic 编码,越高越好) | 9.6% | 4.3% | 9.5% | — | 3.6% | 2.9% | — | — | — | 取自 Google 对照表 1 |
| FrontierSWE 2(越高越好) | 61.2% | 55.0% | 65.5% | — | 62.3% | 56.3% | — | — | — | Carbon 让出去的两行之一 1 |
| Terminal-Bench 4.0(AA 口径,越高越好) | 65.2% | 57.1% ⚠️ 57.4% | 59.1% ⚠️ 57.9% | 50.3%(max) | 59.6% ⚠️ 66.4%(xhigh) | 52.0% | — | — | — | 列内以 Google 的 (AA) 口径为主;⚠️ 处并列 Argon 模型卡 57.4% 3、Anthropic 引 OpenAI 的 Astra 57.9%(high)与自家 Opus 5.5 66.4%(xhigh)4;Terra 的 50.3% 出自 OpenAI 发布页 5 |
| Agents' Last Exam v1.1(任务通过率,越高越好) | 77.4% | 69.0% | 73.1% | — | 71.6% | — | — | — | — | 题集为 v1.1;Argon 模型卡的 39.5% 是 v1,跨版本不并列 13 |
| OSWorld-2.1(离线子集,越高越好) | 81.5% | 74.7% | 80.9% | — | 87.2% | 76.8% | — | — | — | Carbon 让出去的第二行;Opus 5.5 自报的 81.8% 是 partial 口径,任务集不同 14 |
| AutomationBench(Zapier,越高越好) | 53.9% | 51.3% | 41.4% | — | 42.5% ⚠️ 40.0% | 31.4% | — | — | — | 40.0% 由 Zapier 自跑、不设回退模型,被拦截即判失败 4;其余取 Google 表 1 |
| Vending-Bench 2(银行余额,美元,越高越好) | $16,484 | $13,718 | $15,515 | — | $9,235 | $5,422 | — | — | — | 取自 Google 对照表 1 |
| Chartography(无工具,越高越好) | 72.5% | 71.6% | 71.0% | — | 66.3% | 46.2% | — | — | — | Opus 5.5 自报的 89.0% 是带工具,与本行条件不同 14 |
| Blueprint-Bench 2(图纸相似度,越高越好) | 58.6% | 54.4% | 49.7% | — | 51.2% | 41.9% | — | — | — | 取自 Google 对照表 1 |
| GraphWalks(256k–1M,BFS F1,越高越好) | 96.2% | 84.2% | 71.8% | — | 66.8% | 65.0% | — | — | — | 取自 Google 对照表 1 |
| RiemannBench(越高越好) | 80.0% | 76.0% | 72.0% | — | 69.6% | 65.6% | — | — | — | 取自 Google 对照表 1 |
| Terminal-Bench-Science 0.1(AA 口径,越高越好) | 64.8% | 52.9% ⚠️ 57.6% | 63.3% ⚠️ 64.6% | — | 59.0% ⚠️ 58.7% | 43.3% | — | — | — | Argon 的 57.6% 出自模型卡 3;Astra 的 64.6% 与 Opus 5.5 的 58.7% 出自 Anthropic 与 OpenAI 口径 4;Google 表给 63.3% 与 59.0% 1 |
| CWE-bench(Pass@1,越高越好) | 71.0% | 68.0% | 68.0% | — | 67.0% | 58.0% | 55.0% | — | — | 每个模型配不同 harness,见下文;DeepSeek 值与本行 Argon 的 68.0% 出自同一张图 13 |
| ExploitGym(因果通过率,越高越好) | 54.8%(10 小时上限) | 42.0%(10 小时) | 42.4%(无上限) | — | 34.5%(6 小时) | — | — | — | 15.0%(6 小时) | 时间上限逐模型不同,见下文 1 |
| SEC-bench Pro(Pass@1,越高越好) | 88.2% | 83.4% | 85.4% | 83.3% | — | — | 62.8% | — | — | Terra 的 83.3% 与 OpenAI 系统卡的 83.33% 相互印证 5;其余取官方图 1 |
| Terminal-Bench 4.0 作弊成功率(越少越好) | 0.0%(尝试 0.4%) | 2% | — | — | — | — | — | — | — | Argon 的 2% 出自其安全报告 6;Carbon 值出自本期发布页 1 |
| Gray Swan IPI 攻击成功率,k=15(越少越好) | 0.0% | 0.7% | 8.5% | — | 1.0% | 1.0% | — | 52.7% | 31.5% | 同图另有 Claude Opus 5 4.6%、Gemini 3.8 Flash 5.5%、Gemini 3.8 Flash Cyber 6.0%、GPT-6.1 Sol 8.6%、Muse Spark 1.3 15.9%、Grok 4.6 51.8% 1 |
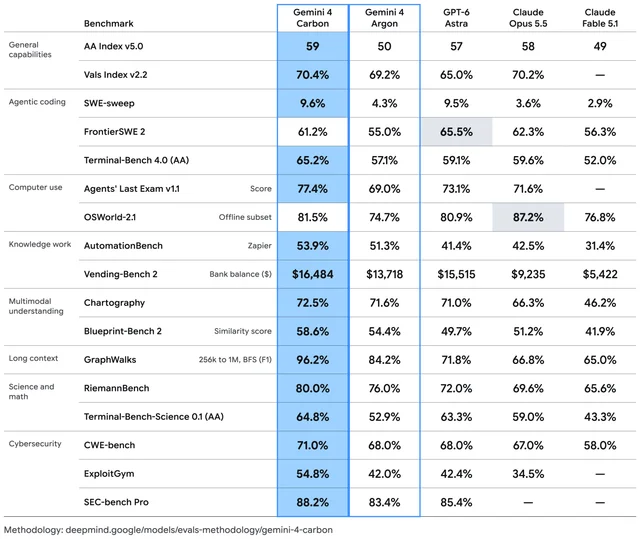
扫描一遍就能看到结论:17 个能力行里,Carbon 拿下 15 行最高分,让出去的两行是 FrontierSWE 2 与 OSWorld-2.1。1
官方对照表原样贴在下面。表里只有四个对标模型,蓝色高亮是 Carbon 列,灰底标的是官方自己认定的该行最高值。1
两周之内的涨跌
同族、同 harness、相隔两周,这两列的差值比任何跨实验室排名都干净。Carbon 相对 Argon,17 个能力行全部上涨。1
涨幅最大的是三项。ExploitGym 从 42.0% 到 54.8%,加 12.8 个百分点;GraphWalks 从 84.2% 到 96.2%,加 12.0 个百分点。
第三项是 Terminal-Bench-Science 0.1,从 52.9% 到 64.8%,加 11.9 个百分点。1
再往下是 Terminal-Bench 4.0 的 8.1 个百分点,Agents' Last Exam v1.1 的 8.4 个百分点,OSWorld-2.1 的 6.8 个百分点,FrontierSWE 2 的 6.2 个百分点。1
涨得最少的三项是 Chartography 的 0.9 个百分点、Vals Index 的 1.2 个百分点、AutomationBench 的 2.6 个百分点。1
这组涨跌给出了这代模型改了什么:长时程执行与网络攻防是主增量,图表识别与业务流程几乎没有变化。官方对定位的说法与此一致,它把 Carbon 描述成能在死胡同里连续跑几天、做大代码库与底层系统的根因定位与修补。1
让出去的两行
FrontierSWE 2 上,GPT-6 Astra 拿 65.5%,Carbon 61.2%,Claude Opus 5.5 62.3%。Google 把这一行归在 agentic coding 一组,测的是超长链路工程任务的产出。1
OSWorld-2.1 的离线子集上,Claude Opus 5.5 拿 87.2%,Carbon 81.5%,Astra 80.9%。这一行 Anthropic 领先 5.7 个百分点。1
两行都带口径差异。Opus 5.5 自报的 OSWorld 2.1 是 81.8% 的 partial 分,任务集与 Google 的离线子集不同。4把两个数当成同一件事读,会把 5.7 个百分点的差距读成 0.3 个。
同一模型在两个官方来源里会移动。Terminal-Bench 4.0 上 Google 给 Astra 59.1%,OpenAI 自报 57.9%,差 1.2 个百分点。
网络三项测的是什么条件
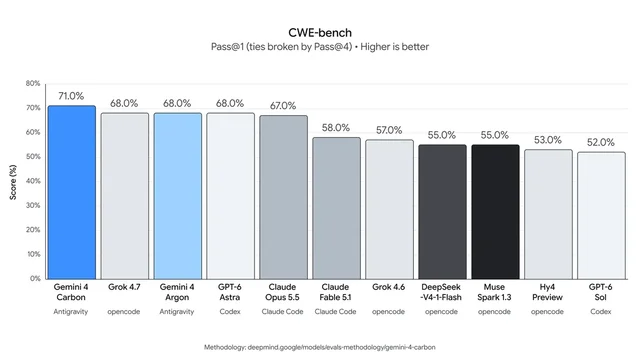
Carbon 最响的三个数是 SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%,官方在这一段后面加了一句括注:evaluated without guardrails,即关掉部署时的拦截层测的。1
把条件拆开看,这三个数的可比性各不相同。
CWE-bench 那张图上,每个模型下面都标了跑它的 harness:Carbon 与 Argon 用 Antigravity,GPT-6 系用 Codex,Anthropic 系用 Claude Code,DeepSeek、Grok、Muse Spark、Hy4 用 opencode。1
也就是说,这一行量的是「模型加脚手架」的组合。换一套 harness,同一个模型在同一道题上的分数会变;官方把标签写在柱下,读的人可以自己扣除这一层。1
ExploitGym 的差异在时间上限。Carbon 与 Argon 各测了 10 小时与 6 小时两档,表里取 10 小时的 54.8%。
Claude Opus 5.5 与 GLM-5.3 是 6 小时,GPT-6 Astra 与 GPT-6.1 Sol 不设上限。1
同一模型在 10 小时与 6 小时之间的差是 1.3 个百分点(54.8% 对 53.5%),而 Argon 两档是 42.0% 与 39.5%。1 时间上限松开带来的增益有限,模型之间的 12 个百分点差距落在这个量级之上。
三项之外的说法只有相对量。Google 称自研评测量出 Carbon 生成安全代码的成功率是 Argon 的两倍以上。
Chrome 团队报告,它生成高质量补丁的效果比另一家实验室的大模型好 10 倍以上;Wiz 说它在网页渗透测试的基准上领先。1 这三句都没有绝对分与对照模型名,只能当作方向。
能力与准入是同一批东西
Carbon 发布当周只开给一部分网络防御方,之后才通过 Fairwind 慢慢放开。1
Fairwind 的规则写得比发布页细:只允许授权威胁模拟、逆向工程、为防御与学术研究做恶意软件分析;成员机构要把模型访问权限限定在内部网络安全、事件响应与渗透测试团队;不能转售或再分发。7
两条放在一起看,88.2%、54.8%、71.0% 这三个数的地位就清楚了:它们是关掉 guardrails 之后测出来的能力,而产品的第一道限制正是把具备这批能力的模型先交给防御方。1
对读者的实际含义是分层的。做防御、漏洞管理、代码审计的团队,可以按这三个数判断它值不值得排队申请;做通用产品的团队,现在拿不到模型,能用的只有这份对照表,选型依据落在能力表其余部分。
对齐侧:两个绝对数与四个相对数
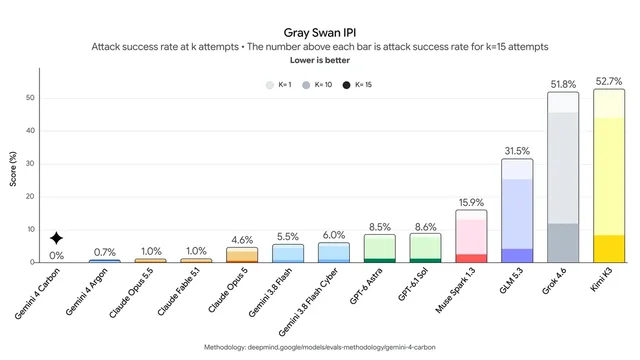
间接提示注入这一项也是绝对数。Gray Swan 的 IPI 基准上,Carbon 在 k=15 的攻击成功率是 0.0%,Argon 是 0.7%。1
同一张图上,Anthropic 的两个模型是 1.0%,GPT-6 Astra 8.5%,GLM-5.3 31.5%,Kimi K3 52.7%。1
其余四项只有相对说法:内部测试里 unsupported claims 约为 Argon 的一半;overreach 降 26%、under-service 降 29%;内部团队的实时编码环境里,高严重度的失配告警减少近 80%。1
0.0% 这个数要按它的定义读。它说的是在这一批评测里,没有一次注入攻击成功;攻击次数、攻击集构成与置信区间,官方都没有披露。1
现在能核到什么程度
配套材料这一块,Carbon 比 Argon 发布时更紧。Google 的模型卡列表里最新一条仍是 10 月 13 日更新的 Gemini 4 Argon,没有 Carbon 条目。8
对照表底部标注的评测方法页
deepmind.google/models/evals-methodology/gemini-4-carbon 目前打不开,打开是一张空白页。1Fairwind 页面也没有跟上,技术一节写的仍是部分伙伴独家使用 Gemini 4 Argon,没提 Carbon。7
采购侧可以先问三件事
第一件是顺序。你的场景更依赖桌面应用操作还是长时程工程改造,决定你该盯 OSWorld-2.1 还是 FrontierSWE 2,而这两行恰好是 Carbon 让出去的两行。1
第二件是口径。表里的跨实验室比较全部出自 Google 的 harness,同一模型换一家测会移动,Terminal-Bench 4.0 上 Astra 的 1.2 个百分点与 Opus 5.5 的 6.8 个百分点就是这种移动的量级。14
第三件是可得性。开发者与企业的开放时间官方只写「as soon as possible」,在那之前,价格与能力表能帮你做规划,做不了压测。1
References
- 1Introducing Gemini 4 Carbon
blog.google
- 2Gemini 4 Carbon: our next frontier model
deepmind.google
- 3Gemini 4 Argon Model Card\
deepmind.google
- 4Claude Opus 5.5\
anthropic.com
- 5Introducing GPT-6.1 Terra\
openai.com
- 6Gemini 4 Safety and Security Report\
storage.googleapis.com
- 7Fairwind Program
deepmind.google
- 8Model cards — Google DeepMind
deepmind.google
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.