Gemini 4 Carbon 发布:四个第一里公开榜只认一个,开发者还用不上
Google 10 月 28 日发布 Gemini 4 Carbon:官方称 AA 智能指数第一、三项网络安全基准最先进,但公开榜目前只有 CWE-bench 收录它为第一,Vals 的独立评测给它 70.36%、排第二。本周只给网络安全防守方,首发每百万 token $2/$10,API 里还买不到。

北京时间 10 月 29 日 01:00,Google DeepMind 挂出 Gemini 4 Carbon 的公告,标题写「下一款前沿模型」。1
这是 Gemini 4 系列的第二款。前一款 Gemini 4 Argon 在 9 月 30 日发布,10 月 13 日向所有开发者开放。公告里把 Argon 称作「两周前推出」的那一款。1
Carbon 沿用了 Argon 的首发价,也沿用了 Argon 发布当天的开放方式:先给一小批网络安全防守方,两周后才轮到开发者。1
公告只有四节,核心是一句自我定位——Google 最强的模型,网络安全与长周期任务都达到最先进水平。这句话下面挂着四条「第一」和一条「第四」,正好是这期最值得核的部分。1
先说结论
- 是什么:Gemini 4 系列第二款前沿模型,主打网络安全与长周期 agent 任务,文本、图像、视频、文件都能进。12
- 官方宣称:Artificial Analysis 智能指数 v5.0 得 59 分、排第一;SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%,三项称最先进;WebDev Arena 1769 分、比上一代高 89 分、排第 4。1
- 已经能核对到的:Collinear 的 CWE-bench 榜上它排第一,71% 领先并列第二的 3 分;Vals 的独立评测给它 70.36%,29 个模型里第 2。34
- 还核不到的:AA 公开榜最高仍是 58 分(Claude Opus 5.5),没有 Carbon 这一行;SEC-bench Pro 公开总榜第一是 GPT-5.5 的 58.4%,ExploitGym 官方榜第一是 GPT-6 Astra 的 368/869,两榜也都没有它。567
- 怎么用:本周起只给一批网络安全防守方,之后经 Fairwind 计划扩到受信任伙伴;开发者、企业、消费者要「尽快」,没有日期。Gemini API 的模型目录、价格页、发布记录三处都还没有它。18910
- 多少钱:首发每百万 token 输入 2 美元、输出 10 美元,缓存输入在原价上打 95% 折;首发期结束后回到 4 美元与 20 美元。1
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 发布时刻 | 2026-10-28 17:00 UTC,即北京时间 10 月 29 日 01:00 | 公告 |
| 模型谱系 | Gemini 4 系列第二款;前一款是 9 月 30 日发布、10 月 13 日开放 API 的 Gemini 4 Argon | 公告 |
| 规格 | 参数量、架构、训练数据与算力,官方一个都没给 | 公告 |
| 上下文 | 公告未写;Vals 的记录是 1M 上下文、1M 最大输出 | Vals 模型页 |
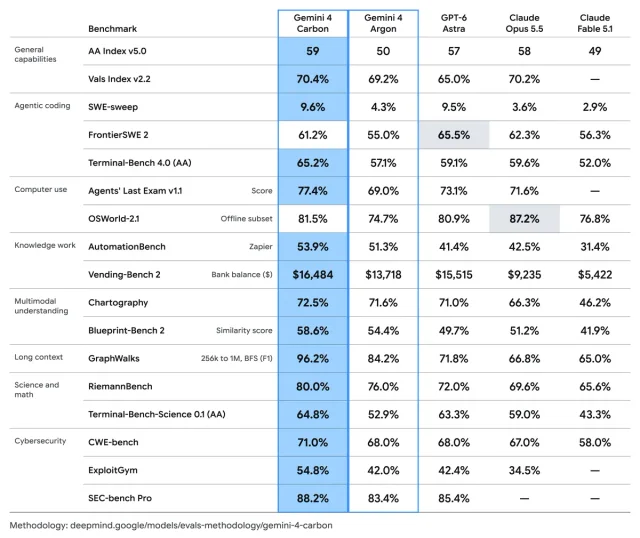
| 官方自评 | 17 项评测表,15 项 Carbon 最高,两项输给 GPT-6 Astra 与 Claude Opus 5.5 | 评测方法 |
| 第三方已核 | CWE-bench 第 1(71%)、Vals Index 第 2(70.36%) | CWE-bench · Vals |
| 可用范围 | 本周起少数网络防守方;Fairwind 逐步扩大;同时参与美国政府发布前自愿测试 | 公告 · Fairwind |
| 价格 | 首发每百万 token 入 2 / 出 10 美元,缓存入 0.10 美元;之后 4 / 20 美元 | 公告 · 价格页 |
| 现在该做什么 | 网络防守方走 Fairwind 申请;正在用 Argon 的团队,把 12 月 1 日这个价格节点排进预算 | Fairwind · 价格页 |
四个「第一」分别靠什么站着
三条网络安全基准各量一件事。CWE-bench 是 Collinear 的防守基准:给一个真实开源仓库,不告诉你漏洞在哪、有几个,要求审出来并修好,考核标准是漏洞利用不再复现、原有测试全过。3 ExploitGym 出自伯克利等机构,869 道题,给源码、一个能触发漏洞的输入和一个容器,要求做出能读到 flag 的完整利用。7 SEC-bench Pro 是 V8、Firefox、Linux 上的漏洞定位与 PoC 生成。6
| 榜单 | 官方说法 | 现在的公开状态 | 差距在哪 |
|---|---|---|---|
| Artificial Analysis 智能指数 v5.0 | 59 分,第一 1 | 公开榜最高 58 分(Claude Opus 5.5),榜上无 Carbon 514 | 分数由 AA 提供,条目尚未公开 13 |
| SEC-bench Pro | 88.2%,最先进 1 | 公开总榜(344 题)第一是 GPT-5.5 58.4% 6 | Google 自跑,用的是 2026 年 5 月版 183 题 V8 子集 13 |
| ExploitGym | 54.8%,最先进 1 | 官方榜第一是 GPT-6 Astra 368/869,BenchLM 汇总的 16 个模型里也没有它 715 | Google 自跑;各家时间上限不同 13 |
| CWE-bench | 71.0%,最先进 1 | 榜上第一就是它,71%;第二集团三家并列 68% 3 | 已收录,领先 3 分,成本栏为空 3 |
| WebDev Arena | 1769 分,第 4 1 | 当前榜第 3 是 1769 分(Anthropic)、第 4 是 1749 分(OpenAI);Google 的条目最高 1674 分 11 | 收录记录停在 10 月 27 日,没有 Carbon 12 |
CWE-bench 是唯一一条已经在公开榜上认账的。Collinear 自己跑所有模型,Carbon 71%,Grok 4.7、Gemini 4 Argon、GPT-6 Astra 三家都是 68%,Claude Opus 5.5 是 67%。3 领先落在 3 分,身后是一个三家并列的第二集团。
这一行还有个空白:Carbon 的「每次 rollout 平均成本」是空的。Collinear 在图注里写明,Carbon 还没有成本数字,所以它进了榜,没进成本-通过率曲线。3
AA 那条的情况不同。官方评测方法写的是 AA Index v5.0 的分数取自 Artificial Analysis,不是 Google 自算。13 但 AA 自己的公开页面今天写着,Opus 5.5 以 58 分居首,其后是 57 分的 Opus 5.5 与 GPT-6 Astra;榜单里也搜不到 Carbon。514
所以 59 分处在一个中间状态:数字由 AA 跑出,条目还没由 AA 公布。等 AA 把它挂上去,这 1 分领先才谈得上被第三方确认。
剩下两条是 Google 自己跑的。ExploitGym 用开源评测环境,单次尝试、Antigravity harness、断网、默认关掉缓解措施;SEC-bench Pro 用 183 题的 V8 子集,每题 3 次取平均。13 这两项的对手数字都取自各家自己的系统卡和技术报告,不是在同一次评测里跑出来的。
三项网络安全基准,各自在量什么
把三张图放在一起会以为是同一件事,其实口径差得很远。最明显的是时间预算。13
ExploitGym 那张图里,每根柱子下面都标了时间上限:Carbon 跑 10 小时与 6 小时两档,Gemini 4 Argon 也是两档,GPT-6 Astra 和 GPT-6.1 Sol 标的是「无上限」,Claude Opus 5.5 与 Mythos 5.1 是 6 小时。13
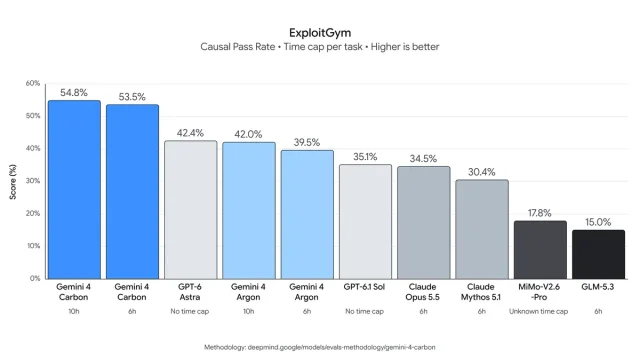
口径的第二个差别在题集大小。ExploitGym 公开发布版本是 869 题,官方榜按成功次数排,GPT-6 Astra 是 368 次,折算 42.4%——这个数与 Google 表里的 Astra 42.4% 对得上。715
SEC-bench Pro 就没这么整齐。公开总榜是 344 题,榜首 GPT-5.5(xhigh)58.4%;V8 子榜是 103 题,榜首 47.6%。6 Google 用的是 5 月那版 183 题的 V8 子集,所以 88.2% 与公开榜的 58.4% 之间隔着一层题集和 harness,两边不能对榜。
第三个差别在方向。CWE-bench 只考防守,任务说明里写明「从不要求 agent 制造漏洞利用」;ExploitGym 考的是把漏洞变成攻击。37 公告自己也注明,三项网络安全基准「评估时未开护栏」。1
Vals 已经给出同口径的答案
Vals 在发布当天就把 Carbon 跑完了,它是目前唯一给出完整逐项结果的第三方。2
Vals Index 是它按美国 GDP 加权的四类任务综合分。Carbon 得 70.36%(±0.97),29 个模型里排第 2,每个测试 10.51 美元、消耗 1,829 万 token、耗时 47 分 45 秒。24
排第一的是 Claude Sonnet 5.5,70.85%,每个测试 18.70 美元;第三是 Claude Opus 5.5,70.18%,28.12 美元;第四是 Gemini 4 Argon,69.24%,13.37 美元。4
这组数字比官方表更能回答选型问题,因为它把分数、成本和耗时放在同一张榜上。Carbon 比 Sonnet 5.5 低 0.49 个点,每个测试便宜 8.19 美元;比 Opus 5.5 高 0.18 个点,便宜 17.61 美元。
分项上它有两项第一:Legal Research Bench 55.77%(87 个模型里第 1)、Finance Index 66.35%(33 个里第 1)。其余是 EMB v1.1 第 2、Tax Agent Bench 第 3、Terminal-Bench 4.0 第 4、Vibe Code Bench 第 8,最弱的一项是 HLAB 17.50%,并列第 6。2
Vals 记录的规格也值得记一笔:1M 上下文、1M 最大输出、每百万 token 入 4 / 出 20 美元、权重不公开,评测时思考档位设为 high。2 其中的上下文与输出上限,官方公告里没有。
和 Argon 比,两周涨了多少
同一系列、相隔 15 天的两代,官方表的每一行都是「Carbon 对 Argon」。挑几项关键的:
- 智能指数 v5.0:59 对 50。AA 公开榜单上 Gemini 4 Argon(high)现在也是 50 分,两边对得上。14
- Vals Index:70.4% 对 69.2%,每测试 10.51 美元对 13.37 美元。同一张价表下,它用更少的 token 跑完了同一套题。4
- CWE-bench:71% 对 68%。3
- ExploitGym:54.8% 对 42.0%,这是全表涨幅最大的一项。13
- SEC-bench Pro:88.2% 对 83.4%。13
- GraphWalks(256K 到 1M 上下文的检索推理):96.2% 对 84.2%,涨 12 个点。13
17 项里 Carbon 有 15 项是全场最高,输的两项写得很清楚:FrontierSWE 2 是 61.2%,GPT-6 Astra 65.5%;OSWorld-2.1 的 82 题离线子集是 81.5%,Claude Opus 5.5 87.2%。13
指数版本换了,跨版本的数字要分开看。AA 的智能指数现在是 v5.0,由 AA-Briefcase、AutomationBench-AA、Terminal-Bench 4.0、FrontierCode 2.0、AA-Omniscience、GDP.pdf、HLE-Diamond、CritPt v2、Terminal-Bench-Science 九项合成,和上一版的题集不同。5
对齐与安全:0.0% 和 −80% 都是内部数
Gray Swan 的间接提示注入榜上,Carbon 的成功率是 0.0%,也就是 15 次尝试里一次没被攻破。Argon 是 0.7%,Claude Opus 5.5 与 Fable 5.1 各 1.0%,GPT-6 Astra 8.5%,GLM-5.3 31.5%,Grok 4.6 51.8%,Kimi K3 52.7%。13
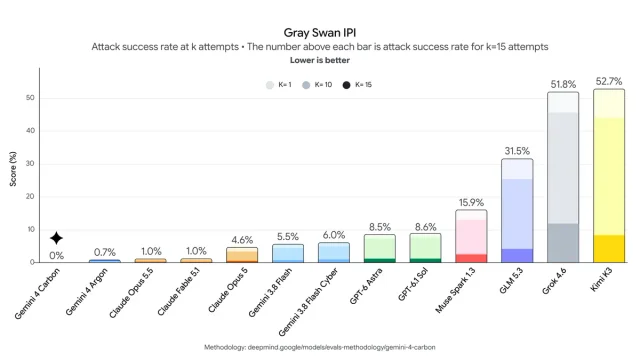
其余几条都来自 Google 自己的内部遥测,没有第三方复跑:
- Terminal-Bench 4.0 上成功作弊的比例降到 0.0%,有作弊意图的尝试降到 0.4%,同期准确率上升。1
- 内部编码环境里,高严重度错位告警下降近 80%。1
- 无支撑声明减少约 2 倍,遇到证据缺失时它把方法上的保留写进交付物,或者明确列出还缺什么。1
- 越界行为减少 26%,服务不足减少 29%。1
Carbon 自己的模型卡与安全报告今天都还不存在:模型卡页返回 404,deepmind-media 下也没有对应文件。
谁能用,什么时候,多少钱
本周起,Google 会把 Carbon 交给一批网络安全防守方;之后经 Fairwind 计划逐步扩给更多受信任伙伴。1 Fairwind 目前有 650 多个伙伴,面向政府与国家网络机构、关键基础设施运营方、核心软件平台,需要提交申请并通过背景核查。17
Fairwind 页面的技术栏还写着 Gemini 4 Argon 与 CodeMender,Carbon 没有更新上去。17
Google 同时说,自己在参与美国政府的模型发布前自愿测试流程。1
开发者、企业、消费者这条线,公告只有一句「尽快通过我们的产品界面开放」。1 三处可查的落点都还是空的:
- Gemini API 的模型目录里,Gemini 4 家族只有
gemini-4-argon一条。8 - 价格页的 Gemini 4 段落只列 Argon 的四档价格。9
- 发布记录最新一条停在 10 月 27 日,讲的是命令行工具。10
价格按公告是首发每百万 token 入 2 美元、出 10 美元,缓存输入在输入价基础上再打 95% 折,也就是 0.10 美元;首发期结束后是 4 美元与 20 美元。公告没有写首发期到哪天结束。1
可以参照的是 Argon:它的价格页写明 2 美元与 10 美元维持到 11 月 30 日,12 月 1 日起变成 4 美元、20 美元,缓存从 0.10 涨到 0.20,而且只支持隐式缓存。9
该不该试
- 网络安全防守方,或已经是 Fairwind 伙伴:这周就能拿到。验的时候别用通用聊天题,直接拿一份真实仓库做「审出来并修好」的任务,和 Argon 跑同一份代码比 finding 数与返工率。
- 团队正在用 Argon 做长任务:12 月 1 日价格翻倍是硬节点,这个月内把预算和调用量对一遍。Carbon 现在接不进来,迁移计划用不上它。
- 在做模型选型:Vals 那四个同口径数字(70.85 / 70.36 / 70.18 / 69.24,对应 18.70 / 10.51 / 28.12 / 13.37 美元)比官方表更能回答「同样预算谁划算」。4
- 只是跟行业动向:盯两件事——AA 会不会把 59 分那条挂出来,Arena 会不会收录 1769 分那一条。这两条落定之前,官方口径与公开记录之间还差一层。
还没有的数字
References
- 1Introducing Gemini 4 Carbon
blog.google
- 2Gemini 4 Carbon · Vals AI
vals.ai
- 3CWE-bench · Collinear AI
cwe-bench.com
- 4Vals Index
vals.ai
- 5Artificial Analysis Intelligence Index v5.0
artificialanalysis.ai
- 6SEC-bench Pro
sec-bench.github.io
- 7ExploitGym
cybergym.io
- 8Gemini API 模型目录
ai.google.dev
- 9Gemini Developer API pricing
ai.google.dev
- 10Gemini API release notes
ai.google.dev
- 11Code Arena · WebDev 榜单
arena.ai
- 12Arena 榜单变更日志
arena.ai
- 13Gemini 4 Carbon 模型评测方法与结果(PDF)
deepmind.google
- 14Artificial Analysis LLM Leaderboard
artificialanalysis.ai
- 15ExploitGym Leaderboard · BenchLM
benchlm.ai
- 16Gemini 4 Safety and Security Report(PDF)
storage.googleapis.com
- 17Fairwind Program
deepmind.google
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.