Gemini 4 Carbon:17 行的测量方全部公开,与同一把尺上唯一丢掉的一行
Google 补发的 5 页评测报告把 Carbon 那张 17 行对照表的每一行都标上了运行方;本文用一张合并总表把这些口径落到每格,说明哪 12 行能直接横向比、哪 5 行只够比同族两代,以及 Carbon 让出的两行里只有一行是真输。

10 月 28 日 Google 发布 Gemini 4 Carbon 时,配了一张 benchmark 对照表。1
表底一行小字指向评测方法页
deepmind.google/models/evals-methodology/gemini-4-carbon。那个地址当时打开是空白页。1现在它有内容了:一份 5 页的 PDF,标题是《Gemini 4 Carbon — Model evaluation: Approach, methodology & results》。2
分数一格没变。这 17 行的数值,与发布页那张表逐格相同。3
Carbon 仍然是 59 分的 AA Index、70.4% 的 Vals Index、65.2% 的 Terminal-Bench 4.0。
变的是每一格的来历。
报告逐个 benchmark 写明三件事:这一行是谁跑出来的、用什么脚手架、跑几次取哪个数。
这三件事决定了一行分数能不能拿来横向比较。
一个 benchmark 的分数,是模型、脚手架、提示预算、评分与汇报惯例合起来的产物。
同一个运行方用同一套配置跑完所有模型,行内只有模型在变,差值能归给模型。
各实验室各报各的时候,这四样一起变。差值里就混进了与模型无关的东西。
按这条线分,17 行落在三种跑法上。
两行败绩的分量因此不一样:Carbon 让出去的两行里,只有一行是真输。
一张合并总表
表内九列模型。数值取自这份报告与 10 月 28 日发布页,两者逐格一致。
官方未测或未进榜的留空,写作「—」按缺项计。
每行最高值加粗。同一 benchmark、同一模型在两个官方来源数值不同时,格内并列两个数并标 ⚠️。
最后一列标出这一行的运行方式,分三种。
中立:由该机构对全部模型统一跑。统一:Google 自己把全部模型跑一遍。混:Google 只跑自家两个模型,对手数字从对方材料里搬。
| Benchmark(口径) | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | GPT-6.1 Terra | Claude Opus 5.5 | Claude Fable 5.1 | DeepSeek-V4.1-Flash | Kimi K3 | GLM-5.3 | 谁跑 |
|---|---|---|---|---|---|---|---|---|---|---|
| AA Index v5.0(带工具) | 59 | 50 | 57 | — | 58 | 49 | — | — | — | 中立 · Artificial Analysis 3 |
| Vals Index v2.2 | 70.4% | 69.2% ⚠️ 68.9% | 65.0% | — | 70.2% | — | — | — | — | 中立 · Vals AI;68.9% 出自 Argon 模型卡,版本未标 34 |
| SWE-sweep(按子任务加权奖励) | 9.6% | 4.3% | 9.5% | — | 3.6% | 2.9% | — | — | — | 混 · Carbon 与 Argon 用 mini-swe-agent 自跑,对手取 SWE-sweep 公开榜 3 |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | — | 62.3% | 56.3% | — | — | — | 中立 · Proximal 公开榜 3 |
| Terminal-Bench 4.0(AA 口径) | 65.2% | 57.1% ⚠️ 57.4% | 59.1% ⚠️ 57.9% | 50.3%(max) | 59.6% ⚠️ 66.4%(xhigh) | 52.0% | — | — | — | 中立 · Artificial Analysis;⚠️ 并列 Argon 模型卡、OpenAI 自报 Astra、Anthropic 自报 Opus 5.5 3456 |
| Agents' Last Exam v1.1(评分标准平均分) | 77.4% | 69.0% ⚠️ 39.5%(v1) | 73.1% | — | 71.6% | — | — | — | — | 混 · Carbon 与 Argon 自跑 122 题 v1.1,Astra 与 Opus 5.5 取公开榜;Fable 5.1 未进榜 34 |
| OSWorld-2.1(离线 82 题子集,部分分) | 81.5% | 74.7% | 80.9% | — | 87.2% | 76.8% | — | — | — | 混 · Carbon 与 Argon 自跑三次取最高,对手取各自公开材料 3 |
| AutomationBench(Zapier 私有集) | 53.9% | 51.3% | 41.4% | — | 42.5% ⚠️ 40.0% | 31.4% | — | — | — | 中立 · Zapier 公开榜;40.0% 由 Zapier 自跑、不设回退模型 35 |
| Vending-Bench 2(银行余额,美元) | $16,484 | $13,718 | $15,515 | — | $9,235 | $5,422 | — | — | — | 中立 · Andon Labs 公开榜 3 |
| Chartography(无工具) | 72.5% | 71.6% | 71.0% | — | 66.3% | 46.2% | — | — | — | 中立 · Surge 公开榜;Opus 5.5 自报的 89.0% 是带工具口径 3 |
| Blueprint-Bench 2(图纸相似度) | 58.6% | 54.4% | 49.7% | — | 51.2% | 41.9% | — | — | — | 中立 · Andon Labs 公开榜 3 |
| GraphWalks(256k–1M,BFS F1) | 96.2% | 84.2% | 71.8% | — | 66.8% | 65.0% | — | — | — | 统一 · Google 自跑全部模型,200 题 3 |
| RiemannBench | 80.0% | 76.0% | 72.0% | — | 69.6% | 65.6% | — | — | — | 中立 · Surge 公开榜 3 |
| Terminal-Bench-Science 0.1(AA 口径) | 64.8% | 52.9% ⚠️ 57.6% | 63.3% ⚠️ 64.6% | — | 59.0% ⚠️ 58.7% | 43.3% | — | — | — | 中立 · Artificial Analysis;⚠️ 并列 Argon 模型卡与 Anthropic、OpenAI 口径 345 |
| CWE-bench(programmatic pass@1) | 71.0% | 68.0% | 68.0% | — | 67.0% | 58.0% | 55.0% | — | — | 中立 · Collinear AI 替全部模型统一评测;同分按 pass@4 破平 3 |
| ExploitGym(缓解措施关闭) | 54.8%(10 小时) | 42.0%(10 小时) | 42.4%(不设上限) | — | 34.5%(6 小时) | — | — | — | 15.0%(6 小时) | 混 · Carbon 与 Argon 自跑,Antigravity 脚手架、无网络;对手取各自系统卡,时限不一 3 |
| SEC-bench Pro(183 题 JS 引擎拆分) | 88.2% | 83.4% | 85.4% | 83.3% | — | — | 62.8% | — | — | 混 · Carbon 与 Argon 自跑,每题 3 次取平均;对手取各自系统卡,拆分未标 36 |
报告第 5 页原表贴在下面。五列模型、17 行,蓝色是 Carbon 列。灰底是官方认定的该行最高值。3
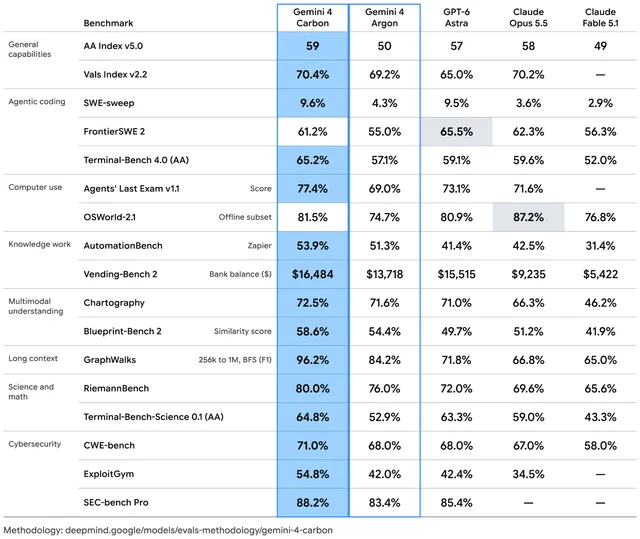
官方结果表原图。行分组为通用能力、agentic 编码、电脑操作、知识工作、多模态理解、长上下文、科学与数学、网络安全;灰底只出现在 FrontierSWE 2 与 OSWorld-2.1 两格,与发布页那张表一致。
十二行用的是同一把尺
17 行里有 12 行,是同一个运行方把全部模型都跑了一遍。
其中 11 行交给外面的机构。
Artificial Analysis 跑三行:AA Index v5.0、Terminal-Bench 4.0、Terminal-Bench-Science 0.1。
Surge 跑两行,Chartography 与 RiemannBench。Andon Labs 跑两行,Vending-Bench 2 与 Blueprint-Bench 2。
其余三行各有一家:Vals AI 跑 Vals Index,Proximal 跑 FrontierSWE 2,Zapier 跑 AutomationBench。
CWE-bench 要单独说一句。报告写的是「evaluated across all models by Collinear AI」。3
柱下那些 Antigravity、Codex、Claude Code 的脚手架标签,是 Collinear 评测时给每个模型配的,同一家机构统一执行。
这一行因此也算在统一尺子里。
第 12 行是 GraphWalks,Google 自己跑。
报告的原话是「results for all models are self-computed」,200 道题,上下文 256k 到 1M。3
Carbon 在这 12 行里赢 11 行。
这个数字比它看上去重。赢的 11 行里,10 行的分数出自别人的榜单。
Carbon 是在 Artificial Analysis、Surge、Andon Labs、Zapier、Vals AI、Collinear AI 各自的跑道和评分器上拿的第一。
唯一没赢的是 FrontierSWE 2。
GraphWalks 那一行得分开看。「统一」说明尺子是同一把,拿尺子的是 Google。
Carbon 96.2%,GPT-6 Astra 71.8%,差 24.4 个百分点,是整张表里最大的一处差距。3
这 24.4 个百分点出在 Google 自己操作的一行。把它当中立的测量结果读,就把「同一把尺」和「中立的尺」当成了一件事。
唯一一行真输
FrontierSWE 2 上,GPT-6 Astra 65.5%,Carbon 61.2%,Claude Opus 5.5 62.3%。3
这一行的数字全部来自 Proximal 的官方公开榜。五个模型同一批题、同一个运行方、同一套评分。
Carbon 落后 4.3 个百分点,是表内唯一一处没有口径可扣的落后。
另一行让出去的是 OSWorld-2.1。Claude Opus 5.5 拿 87.2%,Carbon 81.5%,差 5.7 个百分点。
这一行里,Carbon 与 Argon 的分数是 Google 自己跑的。
官方 GitHub 上的 OSWorld docker、官方评测器、默认 1080p、单次任务最多 500 步,三次独立运行取最高。3
Astra、Opus 5.5、Fable 5.1 的数字来自各家自己发布的材料。报告原文是「their respective published evaluations and system cards」。
两处落后并排比一下。FrontierSWE 2 的 4.3 个百分点跨的是一个运行方。
OSWorld-2.1 的 5.7 个百分点跨的是两个。
有一处细节能说明这两套配置有多接近、又多不同源。
Google 跑 OSWorld 用的是一套更新过的 Gemini 电脑操作脚手架,开了并行批量工具调用。
压缩上下文的流程也照 Opus 5.5 系统卡里的那一套做。
报告原话是「a compaction procedure following the same setup as reported in the Opus 5.5 system card」。3
流程可以照抄,跑分仍各出各家。这就是这一行与 FrontierSWE 2 的区别。
混着来的五行,纵向可用横向不可用
另外五行,Google 只跑了自己那两个模型,对手的数字从对方系统卡或公开榜上搬。
逐行看条件。
- SWE-sweep:Carbon 与 Argon 用 mini-swe-agent 脚手架自跑,报的是按子任务加权的奖励;Astra、Opus 5.5、Fable 5.1 取自 SWE-sweep 官方公开榜。3
- Agents' Last Exam v1.1:两代都用默认 ALE-Claw 脚手架,5 小时窗口,共 122 题,用 2026 年 10 月 17 日发布的任务版本、不套 10 月 26 日的更新,安全过滤开着。Astra 与 Opus 5.5 取官方公开榜;Fable 5.1 不在榜上,整格留空。3
- OSWorld-2.1:82 题离线子集,报部分分,三次独立运行取最高,安全过滤开着,其余配置见上一节。3
- ExploitGym:用开源评测装置自跑,Antigravity 脚手架,每个任务只试一次,全程无网络,缓解措施关闭。任务要成功取到目标 flag,并经大模型裁判确认利用的是预设漏洞才算解出。默认 6 小时上限,另测 10 小时延长上限。3
- SEC-bench Pro:自跑,取 2026 年 5 月的 183 题 JavaScript 引擎拆分,每题 3 次独立尝试取平均,用 Antigravity 脚手架。判定标准是 PoC 能打崩有漏洞的构建、打不崩修补后的构建;两边都崩时,由大模型裁判看源码确认崩在预设漏洞上。3
这五行支持的比较方向与前 12 行不同。
Carbon 与 Argon 在这五行里都是同一家、同一套脚手架、同一份配置跑出来的。
所以纵向可用:两代之间差多少,可以读。
ExploitGym 从 42.0% 到 54.8%,Agents' Last Exam 从 69.0% 到 77.4%。
横向不可用:Carbon 的分数与对手的分数,出自两套运行方。
SWE-sweep 那一行最能说明问题。Carbon 9.6%,Astra 9.5%,差 0.1 个百分点。3
两边的脚手架与奖励口径都不同。0.1 个百分点配两套脚手架,读不出任何排序。
SEC-bench Pro 的 88.2% 还有另一层要留意。
Carbon 这个数是在一个 183 题的 JavaScript 引擎拆分上测的。对手的数字取自各自系统卡,拆分未标。3
把它跟 OpenAI 系统卡里的 83.33% 直接相减,减出来的是两个拆分之间的差。6
ExploitGym 的时间上限也各不相同。表里每个模型只给一个数,Carbon 取的是 10 小时档。
发布页那张图上,Carbon 10 小时 54.8%、6 小时 53.5%,与表内一致。Astra 不设上限,Opus 5.5 与 GLM-5.3 是 6 小时。1
松开时间上限带来的增益很小。Carbon 两档差 1.3 个百分点,Argon 是 42.0% 对 39.5%。
而 Carbon 与 Astra 之间是 12.4 个百分点。
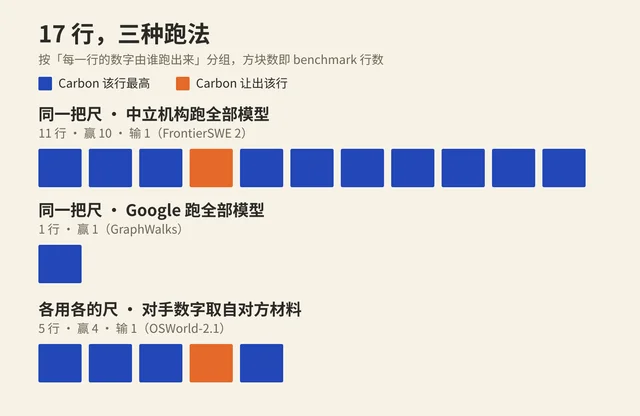
依据报告逐行标注自制。三组分别是中立机构统一跑的 11 行(赢 10、输 1)、Google 统一跑的 1 行(赢 1)、各用各的材料的 5 行(赢 4、输 1)。
报告里三处影响方向的设定
这份报告有几处设定,各自把分数推向不同方向。读的时候要按行扣。
第一处,OSWorld-2.1 三次取最高。
报告开篇说,所有 Carbon 与 Argon 的分数都是 pass@1,「except where otherwise noted」。3
OSWorld 就是那个 noted 的地方:三次独立运行取最高,单次运行内只试一次。
三次里挑最高的一次计入,方向对 Carbon 有利。
第二处,被安全过滤拦下的回复按空串计入。
Agents' Last Exam 与 OSWorld 两行都写着「Responses flagged by safety filters are returned as empty strings, though the episode can continue」。3
回复被拦成空串,任务继续跑,评分按空串算。
Google 把自家产品的安全层嵌进了能力测量,代价落在自己的分数上。
第三处,对手不一定跑在最高推理档。
报告对 GPT-6 Astra、Opus 5.5、Fable 5.1 的说法是「we default to reporting maximum thinking/reasoning settings available, but when reported results are not available we use best available reasoning results」。3
拿得到最高档就用最高档,拿不到就用现有最好的那一档。这一处对 Carbon 有利。
三处里两处对 Google 有利,一处不利。每一处影响多大,报告都没有给数。
所以这张表要按行扣。
Carbon 自己的运行档位倒是写明了的。全部结果跑在 Gemini API 的最高思考档上,也就是最贵的那一档。3
单次尝试设置意味着多数投票和并行测试时计算都不开。报告对较小的 benchmark 用多次试验取平均,以降方差。
还没有的东西
Carbon 仍然没有自己的模型卡。
模型卡索引里最新一条还是 10 月 13 日更新的 Gemini 4 Argon,
model-cards/gemini-4-carbon 打开是 404。7也没有 Carbon 的安全报告或 system card。
这份评测报告只覆盖能力侧那 17 行,里面没有安全、对齐、能力阈值判定的任何数值。3
网络安全三项在这份报告里也没有条件说明,发布页那三个数标注的是「evaluated without guardrails」。1
发布页上的作弊成功率与 Gray Swan 间接提示注入两项,同样不在这份报告里。
现在能自己核的东西多了一样。能力表之外的部分,仍然只有发布页那几张图。
先看运行方,再看分数
第一件,翻到最后一列。
标「中立」的行可以直接拿来做跨实验室判断。标「混」的行只用来比 Carbon 与 Argon。
第二件,看你关心哪一类能力。
要换掉桌面操作方案,盯 OSWorld-2.1。先记住这一行的 5.7 个百分点混着两套运行方。
要换掉长时程工程方案,盯 FrontierSWE 2。那 4.3 个百分点是干净的。
第三件,碰上「Google 自跑全部」的那一行,把领先幅度折一下再信。
GraphWalks 的 24.4 个百分点是真的跑出来的,跑它的人也是 Google。
这些答案要等 Carbon 的模型卡。
在那之前,这张表能回答「它相对上一代涨了多少」「它在别人家的榜上排第几」。
它还回答不了「它的安全与对齐做到了什么程度」。
References
- 1Introducing Gemini 4 Carbon
blog.google
- 2
- 3Gemini 4 Carbon Model evaluation (PDF)
storage.googleapis.com
- 4Gemini 4 Argon Model Card\
deepmind.google
- 5Claude Opus 5.5\
anthropic.com
- 6Introducing GPT-6.1 Terra\
openai.com
- 7Model cards — Google DeepMind
deepmind.google
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.