Gemini 4 Argon 发布:独立指数追平 GPT-6 Astra,首发成本六成、仅向网络防守方开放
Google DeepMind 发布全新前沿模型 Gemini 4 Argon:Artificial Analysis 的独立智能指数给它的最高档 53 分,追平 GPT-6 Astra,首发五折后每任务成本约 1.99 美元;模型目前只通过网络防守计划 Fairwind 向受信任机构开放,开发者与消费者要等后续。

Google DeepMind 在 2026 年 9 月 30 日发布 Gemini 4 Argon。它是 Gemini 4 系列的第一个模型,也是 Google 七个多月来第一个高于 Flash 档的自有模型。12官方给它的定位是长程专业任务:真实软件工程、法律与金融这类企业知识工作,以及网络安全防御。1
Artificial Analysis 的独立智能指数给它的最高思考档 53 分,与旗舰 GPT-6 Astra 的最高档持平,比 GPT-6.1 Sol 的最高档高 1 分。2首发五折后的每任务成本是 1.99 美元,约为 Astra 的六成。2能力追平了,拿到手却不容易:它眼下只通过网络防守计划 Fairwind 向受信任机构滚动开放。1
先说结论
- 家族位置:Gemini 4 系列首款,也是 Google 七个多月来首个高于 Flash 档的自有模型。2
- 独立评测:智能指数 53 分,追平 GPT-6 Astra 的最高档,比 Google 上一个非 Flash 模型 Gemini 3.1 Pro Preview 高 23 分。2
- 每任务成本:首发期 1.99 美元,约为 Astra 的六成;恢复原价后涨到 3.98 美元,约为 Astra 的 1.2 倍。2
- 参数规模:官方未披露。1
- 输出上限:从 64K 提到 100 万 tokens,官方称行业最高。1
- 可用范围:现阶段只经 Fairwind 计划向受信任的网络防守方开放,并参与美国政府模型预发布的自愿获取流程;开发者、企业与消费者要等后续,先开放给付费 API 客户和 Google AI Ultra 订阅者。13
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与公开状态 | Gemini 4 Argon;尚未出现在 Gemini API 模型目录与价格页,公开 API id 未定 | 官方公告、Gemini API 模型目录 |
| 发布方与时间 | Google DeepMind,2026 年 9 月 30 日(官方标注日期) | 官方公告、VentureBeat |
| 家族位置 | Gemini 4 系列首款;Google 七个多月来首个高于 Flash 档的自有模型 | Artificial Analysis |
| 参数规模 | 官方未披露 | 官方公告 |
| 上下文与输出 | 上下文 100 万 tokens(第三方记录);输出上限 100 万 tokens,此前为 64K | Artificial Analysis、官方公告 |
| 模态 | 文本、图像、视频输入,文本输出(第三方另记语音输入) | Artificial Analysis |
| 知识截止 | 官方未披露 | 官方公告 |
| 价格 | 首发每百万 tokens 输入 $2、输出 $10,缓存输入按输入价减 95%;首发期后 $4 / $20 | 官方公告 |
| 可用范围 | 仅 Fairwind 受信任网络防守方;后续先开放给付费 API 客户与 Google AI Ultra 订阅者 | 官方公告、Fairwind |
| 时间窗口 | 已开始滚动开放;首发折扣至少一个月,结束日期未确认 | Artificial Analysis |
官方自测:18 项评测里 12 项第一
Google 在公告里放了一张 18 项评测的对照表,同一张表里并列着 GPT-6 Astra、Claude Fable 5.1 与 Claude Opus 5.5。1按这张表数,Argon 在 12 项上领先、1 项并列第一;GPT-6 Astra 领先 3 项,Claude Opus 5.5 领先 2 项。4
| 评测 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | 来源 |
|---|---|---|---|---|---|
| 知识工作 · Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | 官方公告 |
| 知识工作 · AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | 官方公告 |
| 知识工作 · Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | 官方公告 |
| 知识工作 · Harvey 法律代理基准 | 19.6% | 5.4% | 6.7% | 3.8% | 官方公告 |
| 代理编码 · DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | 官方公告 |
| 代理编码 · FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | 官方公告 |
| 代理编码 · Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | 官方公告 |
| 代理编码 · Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | 官方公告 |
| 机器学习工程 · PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | 官方公告 |
| 科学与数学 · Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | 官方公告 |
| 科学与数学 · LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | 官方公告 |
| 科学与数学 · RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | 官方公告 |
| 长上下文 · GraphWalks(≤128k,F1) | 99.7% | 98.7% | 91.4% | 90.6% | 官方公告 |
| 长上下文 · GraphWalks(256k–1M,F1) | 84.2% | 71.8% | 65.0% | 66.8% | 官方公告 |
| 计算机使用 · Agent's Last Exam(通过率) | 39.5% | 34.2% | — | 38.2% | 官方公告 |
| 计算机使用 · OSWorld-2.0(离线集 partial) | 69.2% | 72.6% | — | — | 官方公告 |
| 多模态理解 · Chartography | 71.6% | 71.0% | 46.2% | 66.3% | 官方公告 |
| 多模态理解 · LVBench | 91.7% | 87.5% | 79.7% | 83.7% | 官方公告 |
| 网络安全 · CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | 官方公告 |
领先的项集中在企业知识工作、长上下文与多模态:Harvey 法律代理基准上它拿 19.6%,Astra 5.4%、Opus 5.5 3.8%;256k 到 1M 的长上下文 GraphWalks 它 84.2%,Astra 71.8%;长视频理解 LVBench 它 91.7%,Astra 87.5%。1它输的地方同样清楚:FrontierSWE v2 落后 Astra 10.5 个百分点,Terminal-Bench Science 0.1 也落后 Astra 10.5 个百分点,Terminal-bench 4.0 落后 Opus 5.5 9 个百分点,PostTrainBench 落后 Opus 5.5 4 个百分点。4
这张表的口径要先说清楚。Google 的评测说明写明:Argon 的分数都是 pass@1、单次尝试、不投票、不开并行测试时计算,并用 Gemini API 的最高思考档跑;非 Google 模型的分数除注明外都取自各家自述,Astra、Fable 5.1、Opus 5.5 默认用可得的最高思考档。5其中 DeepSWE、Terminal-bench 4.0、Agent's Last Exam 与 OSWorld-2.0 的 Argon 分数由 Google 自算,PostTrainBench、LABBench 2 与 GraphWalks 是全模型都由 Google 自算;FrontierSWE、Vibe Code Bench、RiemannBench、Chartography 与 CWE-bench v1 取自各自公开榜单,Vals Index、Vals Finance Agent v2、Harvey 基准取自 Vals AI,AutomationBench 取自 Zapier 公开榜的私有集。5
第三方独立评测
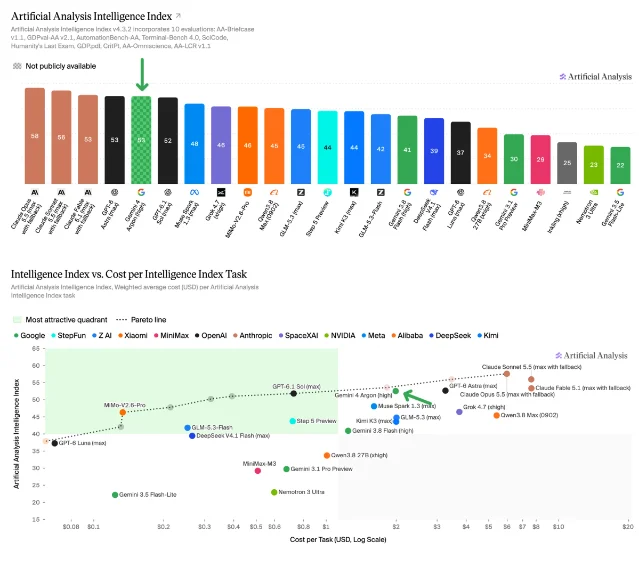
独立这一侧,Artificial Analysis 用智能指数 v4.3.2(由 10 项评测加权)给 Argon 的最高档 53 分,与 GPT-6 Astra 的最高档持平,比 GPT-6.1 Sol 的最高档高 1 分,也比 Gemini 3.8 Flash 的高档高 12 分。26
成本要分两段看。首发五折时 Argon 每跑完一道指数题的加权成本 1.99 美元,是 Astra 最高档 3.26 美元的六成;五折结束后涨到 3.98 美元,约为 Astra 的 1.2 倍。2省下来的钱来自更低的单价,代价是用量更大:Argon 每道题平均输出 6.2 万 tokens,Astra 最高档是 2.7 万。2
幻觉这一项出现反差。在 AA-Omniscience 上,Argon 的幻觉率 15%,是所有智能指数 45 分以上模型里最低的,Astra 最高档 51%、GPT-6.1 Sol 最高档 54%;但它的准确率 50%,比 Astra 最高档的 63% 低 13 个百分点,综合分 42 与 Astra 的 43、GPT-6.1 Sol 的 42 基本持平。2Artificial Analysis 的解读是,答不上来时它更倾向直接说明自己不知道。2
另有两项对照值得记下来。在 Artificial Analysis 自己跑的 AutomationBench-AA 上,Argon 以 78% 排第一,比 Claude Sonnet 5.5 的最高档高 7 个百分点;而在公开的 Terminal Bench 4 上它拿 57%,落在 Claude Sonnet 5.5 的 64%、Claude Opus 5.5 的 60% 和 GPT-6 Astra 的 59% 之后。2
还有一个第三方榜单已经收录它。Vals Index 按各行业占美国 GDP 的比重加权,混合公开与私有基准,Argon 以 68.90% 排第一,每测试成本 15.68 美元;Claude Sonnet 5.5 是 67.04%、Claude Opus 5.5 是 66.97%、GPT-6 Astra 是 63.13%。7这份榜单按每百万 tokens 输入 $4、输出 $20 的原价计费,所以 Argon 的成本优势在这里显示不出来。7
DeepSWE 的公开榜单这次还没收录 Argon,它最后一次更新停在 9 月 22 日,榜上的 Gemini 条目只到 3.8 Flash。8
价格与可用性
价格分两段。首发期每百万 tokens 输入 2 美元、输出 10 美元,缓存输入按输入价再减 95%,折合 0.10 美元;首发期结束后回到输入 4 美元、输出 20 美元,缓存输入 0.20 美元。1Artificial Analysis 记录这个折扣至少持续一个月,Google 没有确认结束日期。2
横向比,首发价是 GPT-6 Astra 标价(每百万 tokens 输入 10 美元、输出 50 美元)的五分之一,也是 Claude Opus 5.5(输入 4 美元、输出 20 美元)的一半;恢复原价后,它与 Opus 5.5 同价。4
输出上限从 64K 提到 100 万 tokens,配套的是一个叫 Long Decode Continuation 的 Gemini API 机制:很长的回答会被暂停,再在后续调用里接着生成,让一次推理跑满 100 万输出 tokens 而不撞上请求超时。12
可用范围眼下很窄。Argon 通过 Fairwind Program 只向受信任的网络防守方滚动开放,同时参与美国政府的模型预发布自愿获取流程;Google 说会先收集早期测试者的反馈、打磨护栏,再尽快开给开发者、企业与消费者,顺序是先付费 API 客户和 Google AI Ultra 订阅者。1截至发布,Gemini API 的模型目录和价格页都还没有 Argon 条目。910
网络安全与护栏
Argon 的开放节奏和它的网络安全能力绑在一起。Google 说,对受信任的防守方和自家内部团队,这一版不带网络安全护栏发布,让它们用满前沿防御能力;对外则把用途限定在授权威胁模拟、逆向工程与恶意软件分析这类防御和研究场景,参与机构还要满足抗钓鱼多因素认证、访问白名单等条件,并且不得转售或再分发访问权。3Fairwind 目前有 650 多家合作机构。3
漏洞修复上,Argon 在 CWE-bench v1 拿 68%,与 GPT-6 Astra 并列第一,Claude Opus 5.5 是 67%。1官方同一页给出的漏洞发现对照里,真实世界漏洞发现 Argon 拿 85.8%,Gemini 3.8 Flash Cyber 是 71.0%;在 Wiz 的黑盒渗透测试里 Argon 是 70.9%,后者是 58.2%。3Wiz 已经在它的 Scan for Good 计划里用上 Argon,并称模型发现了一处此前前沿模型漏掉的高危漏洞,涉及全球医院在用的医疗软件。1
提示注入这一项,官方公告所附的 Gray Swan IPI 图显示,Argon 在 15 次尝试下的攻击成功率是 0.7%,Claude Opus 5.5 与 Claude Fable 5.1 各为 1.0%,GPT-6 Astra 8.5%、GPT-6 Sol 10.1%、GPT-5.6 Sol 27.0%、GLM 5.3 31.5%。1
前沿护栏分成四块:对网络与生化放核滥用请求的拒答,同时保留合法的双重用途研究;面向提示注入的对抗训练与自动化红队;对思考链和动作的错位监控,发现越界就中止执行;以及在高风险训练与评测开始前,把所用沙箱隔离并封起来。1
该不该试:先看自己在哪一类
- 你现在按 Astra 的价格跑长程编码或代理任务。 Argon 的最高档在独立指数上与 Astra 持平,Astra 每道题 3.26 美元、它首发期 1.99 美元,升级理由清楚;代价是恢复原价后回到 3.98 美元,比 Astra 贵,所以值得先在折扣期内把评测补齐。2
- 你做法律、金融、长文档或长视频这类工作。 Harvey 法律代理基准上它 19.6%、Astra 5.4%,Vals Finance Agent v2 上它 65.4%、Astra 53.5%、Opus 5.5 58.6%,LVBench 上它 91.7%、Astra 87.5%;这几处差距值得你把自有样本各跑一轮再决定。1
- 你关心网络防御或漏洞修复。 眼下这是唯一拿到它的通道:申请 Fairwind 并按机构的合规要求接进去,模型可以和 CodeMender 一起用;不在受信范围内的团队,短期内只能等付费 API 开放。3
还没有的数字
References
- 1
- 2Gemini 4 Argon: Google is back as one of the top three labs in intelligence achieved
artificialanalysis.ai
- 3Fairwind Program
deepmind.google
- 4
- 5Gemini 4 Argon Model evaluation
deepmind.google
- 6Artificial Analysis LLM 榜单
artificialanalysis.ai
- 7
- 8DeepSWE
deepswe.datacurve.ai
- 9Models | Gemini API
ai.google.dev
- 10Gemini Developer API pricing
ai.google.dev
- 11Gemini 4 Argon (high) - Intelligence, Performance & Price Analysis
artificialanalysis.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.