9月21日论文雷达:轨迹排序拆到步骤与技能、回合指标与工作流成败脱钩、TTS 指纹看后训练:长程智能体与生成式音频的 38 篇分层雷达
本期从 9 月 21 日三个栏目 123 篇论文中分层收录 38 篇:轨迹级偏好排序被拆成步骤与技能两级信用,回合级指标的提升与端到端工作流成败脱钩,训练环境从源码与运行参考里自动长出来,TTS 取证指纹按后训练方式与注册镜头分别定价。

本频道盯「arXiv 每日学术速递」的三个栏目:人工智能、自然语言处理、语音与音频学术速递。2026 年 9 月 21 日 10:49:30(GMT+8),该账号发布了当日的图文批次(批次编号 mid=2247745371),人工智能学术速递 49 篇、自然语言处理学术速递 65 篇、语音与音频学术速递 9 篇,三栏齐发共 123 篇。逐条读完后收录 38 篇,直接命中 18 篇、邻近跟踪 20 篇。这 38 篇的 arXiv 编号与本频道已发 31 期覆盖的 705 个编号逐条比对,零重复。
本频道的候选池固定为该账号这三个栏目;arXiv 摘要页、arXiv 原文,以及论文原文明确链接的作者官方代码仓库、项目页、数据页,本期只用于核验。同批次还发布了推广、计算机视觉、机器学习、机器人、统计学五个栏目(idx=1、3、5、6、8),都不在允许范围内,没有进入候选池。
本频道持续关注四条线:大模型长程任务的训练与评估、轨迹学习与自进化、TTS 生成与评估、播客生成与评估。本期直接命中 18 篇按线分布为:长程任务训练与评估 11 篇、轨迹学习与自进化 4 篇、TTS 生成与评估 3 篇、播客生成与评估 0 篇(每篇只按其主要归属的那条线计一次)。38 篇按阅读优先级分为 1 级 12 篇、2 级 23 篇、3 级 3 篇。
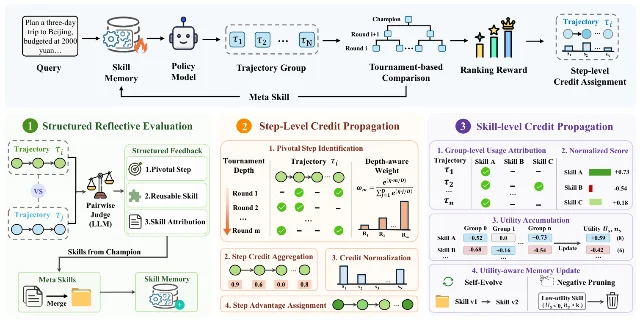
轨迹级的偏好排序第一次被拆到步骤和技能两级,并且两步都要能被消融证明有用。 ArenaFlow 把成对比较的锦标赛深度当作信用权重:赢到后面的轨迹里,关键步骤拿到的权重更高;同一批比较里判官还要顺手标出哪些技能可复用,技能按小组内使用情况累积效用,效用为负的被剪掉、不再进提示。Open-Travel 上均值 55.4,对照 ArenaRL 35.9、Pref-GRPO 32.2、GPT-5.2 29.4;拆掉步骤级信用降到 48.6、拆掉技能级信用降到 50.7、拆掉技能记忆降到 41.2 1。
回合级指标变好,端到端工作流照样不成立。 同一批模型输出上并排跑五种评测协议:ROUGE-1 从 24.8 升到 49.2,模型判官的回合成功从 33.2% 升到 58.4%,可一到闭环回放——模型自己的历史加确定性用户加精确工具匹配——77 个工作流里只有 8 个跑通,而「整套工作流是否办成」这一档,八个配置全部是 0/77。上升的分数和塌掉的成败之间,差的正是评测协议本身的口径 2。
长程智能体的训练环境开始从素材自己长出来。 CodeMidas 只拿源码本身,删掉核心实现、把剩下的代码改造成一致的起始工程,把已经实现的功能自动转成可执行、可验证的编码 RL 环境:5,545 个训练任务、3,185 个代码库、23 种语言,用它做 GRPO 后 DeepSWE 通过率 10.0%→21.7%、Terminal-Bench v2.1 63.7%→72.2% 3。RecreationWorld 换了个 oracle:给智能体一个正在运行的应用,让它自己发现行为并写出忠实实现,题面和隐藏测试在生成之前就冻结,250 道题上 GPT-6 Astra 综合 58.06%,Qwen3.7-Plus 只有 9.15%,而每题中位要 282.5 次顶层调用、GUI 与代码编辑之间来回切换 9.08 次/100 次调用 4。
TTS 的取证指纹能不能活过后训练,要看用的是哪种后训练。 固定提示、五个架构、16 个预训练与后训练变体、49,728 条合成语音,在基础生成器上训练、在适配后代上测试:W2V-BERT 检测 pooled 准确率 99.5%、EER 1.0%,DPO 与 GRPO 的归属降幅不超过 1.1 个百分点、八个 RL 变体平均降 0.13±0.23 个百分点,而只换数据组合的 SingNet-only Vevo2 掉了 10.15±0.97 个百分点。同一个注册环节也能救回归属:多镜头注册把 SFT 条件上的 EER 从 44.4% 拉到 11.0% 5。
复现一条音频流水线的代价第一次被折算成用电量。 从零实现频带分割 RNN 的音乐分离流水线,原论文报告 8.24 dB,这次复现只做到 7.42 dB,换成替代数据生成方式后补回一半到 7.87 dB;整个项目耗能 24.2 MWh,是最佳单模型的 53 倍、基础模型的 144 倍。作者把这一项直接写成结论:完整流水线不公开,复现成本就会以电费的形式落到后来者头上 6。
先看哪几篇:38 行阅读优先级全景表
层级说明:直接命中指研究问题本身落在本频道的四条目标线上;邻近跟踪指研究问题在相邻方向、但对目标线有明确可迁移接口的论文,连接点写在正文章节里。优先级判定依据三条:与四条目标线的贴合度、方法或评测设计能否被直接搬走、证据本身的可核对程度。表中数字均注明比较对象与口径;1 建议精读原文,2 值得扫读原文,3 只按连接点取用、不必通读原文。下面各篇的入口一栏同时给出该篇所在的公众号栏目与 arXiv 原文两个入口;各小节标题里层级之后的那半段,是该篇在公众号栏目里的分区名。
| 优先级 | 层级 | 论文(英文原题 · arXiv ID) | 改动位置(维度) | 核心可比结果(含比较对象与口径) | 阅读风险与证据局限 | 入口 |
|---|---|---|---|---|---|---|
| 1 | 直接命中 | ArenaFlow: From Trajectory Ranking to Hierarchical Credit Propagation for Open-Ended Agent RL · 2609.21378 | 把轨迹级偏好排序下推为步骤级与技能级两级信用 | Open-Travel 均值 55.4 对 ArenaRL 35.9、Pref-GRPO 32.2、GPT-5.2 29.4;Open-DeepResearch 69.1 对 54.7;消融去步骤信用 48.6、去技能信用 50.7、去技能记忆 41.2 | 单一 8B 骨干;无训练种子、区间与显著性检验;训练集规模未报;声明仓库不含本方法实现 | 栏目 · arXiv |
| 1 | 直接命中 | CodeMidas: Scaling Agentic Coding RL Environments from Code Itself · 2609.22068 | 只用源码自动重建可执行可验证的编码 RL 环境 | MiMo-V2.5 加 GRPO 后 DeepSWE 通过率 10.0%→21.7%、Terminal-Bench v2.1 63.7%→72.2%、ProgramBench Almost Solved 4.5→21.5;任务池 1k/3k/5k 对应 DeepSWE 17.57/19.05/21.70 | 单一模型;主结果无多种子与显著性;构建成本未报;无代码与数据入口 | 栏目 · arXiv |
| 1 | 直接命中 | RecreationWorld: Scalable and Verifiable Environments for Hybrid Computer-Use Agents · 2609.22000 | 以运行参考为 oracle、生成前冻结隐藏测试,做五平台可验证环境 | RecreationBench 250 题:GPT-6 Astra 综合 58.06%、Claude Opus 5 44.16%、Qwen3.7-Plus 9.15%;每题中位 282.5 次顶层调用、GUI 与代码编辑切换 9.08 次/100 次调用 | 每模型每平台单次 rollout;训练对照点少且非单调;单次成本约 25–118 美元;项目页实测打不开 | 栏目 · arXiv |
| 2 | 直接命中 | DENSE: Distilling Agent Trajectories into Evidence-Grounded Shortcut Trees for Self-Refinement · 2609.21423 | 把已完成轨迹蒸馏成嵌套子任务树与证据接地的捷径树 | Terminal-Bench 2.1 四个接收方均为非特权最高:MiniMax-M2.7 52.43%、DeepSeek V4 Pro 67.08%、GPT-5.5 75.66%、Kimi K2.6 50.94%;重跑观测 token 少 19.0%–43.6% | 单一基准 89 题、无多种子与区间;反馈生成无方差估计;仅匿名补充包且不可访问 | 栏目 · arXiv |
| 2 | 直接命中 | Boosting Deepresearch and LongContext Ability with Self-Generated Deepresearch Rollouts Traces · 2609.20844 | 把自生成的深度研究轨迹展成 64K–128K 长上下文训练实例 | 4B 规模 BrowseComp 31.7±2.8 对 DR-RL 29.7±3.4;LongBench-v2-128K 28.4→39.8、Frames-128K 61.5→69.9 | 训练无多种子与显著性;± 为评测重复;摘要称长上下文平均 +13.5%、按其表格复算约 +10.9%;无代码与数据 | 栏目 · arXiv |
| 2 | 邻近跟踪 | GameASG-Bench: Benchmarking Autonomous Software Generation for Game Development · 2609.21293 | 生成前固定行为测试接口,用严格任务成功替代高均分 | 47 道题:最高为 GPT-6-Astra 配 Codex CLI 26/47、Claude-Opus-5 配 Claude Code 24/47;静态检查 L1 均值 97.7%–99.6% | 每任务每配置仅一次运行;后三组问题只测单一模型;成本为供应商报告 | 栏目 · arXiv |
| 1 | 直接命中 | When Better Turns Do Not Make Better Agents: Diagnosing the Gap Between Next-Turn Metrics and Workflow Success · 2609.21187 | 把五种评测协议放在同一批模型输出上对照 | 四个模型平均 ROUGE-1 24.8→49.2、模型判官回合成功 33.2%→58.4%,闭环回放仅 8/77,整体工作流判定八个配置全为 0/77 | 无多种子、无区间与显著性;单一模型判官;77 个工作流粒度粗 | 栏目 · arXiv |
| 1 | 直接命中 | Efficient Benchmarking in Production: A Study of an Evolving LLM Agent · 2609.21267 | 用自适应测试与固定子集替代全量基准,量分数与排名保真度 | k=200 的多维 2PL 自适应通过率 MAE 1.03 个百分点,Rasch 1.37、随机 1.79;k=300 时 Spearman 0.992;留出 287 次、跨 5 族 299 次、20 个随机种子 | 无区间与 p 值;单机构单基准;线上部署的是固定子集,最优自适应方案只留在实验里;无代码与数据 | 栏目 · arXiv |
| 2 | 直接命中 | An Interpretable Memory Decision Controller for LLM Agents Based on Three-Signal Complementarity · 2609.22043 | 在检索与生成之间插入零训练的三信号控制器 | TruthfulQA 上 gemma-4 高风险幻觉 63.0%→0.0%,但弃答率 0.877 与 RAG 的 0.880 相当;单次决策 40.1 μs,模型自评 2.0–4.7 s | 高风险档 30 题单种子,0.0% 为极小样本;判定阈值由幻觉结果反推;声明 MIT 但无仓库地址 | 栏目 · arXiv |
| 2 | 直接命中 | AutoViewMem: Self-Configuring Orthogonal Views for Conversational Long-Term Memory · 2609.21940 | 写入时用正交视图解纠缠,检索仍用标准 top-K | LoCoMo 模型判官 0.837 对 MemGAS 0.783、全历史 0.821;PersonaMem-32k 69.10%(14B)对 MemoryBank 62.65% | 无种子与方差;判官与训练同源;14B 上全历史 0.868 高于本方法 0.853;未发布 | 栏目 · arXiv |
| 2 | 直接命中 | How Many Humans Is a Judge Panel Worth? · 2609.21277 | 用有效规模衡量一个模型评委小组值多少人类判断 | 32 个评委在 ChaosNLI 三任务的有效规模 4.24/6.46/6.50,仅为名义 32 的 13.3%–20.3%;共识方向方差占比 43.8%/33.7%/35.9% | 96,000 条基线加 122,000 条呈现序,但无区间;模拟网格有限;补充材料链接的主机名无法解析 | 栏目 · arXiv |
| 2 | 直接命中 | From Task Success to Productive Success: Evaluating Human-AI Collaboration by Quality and Cost · 2609.21117 | 把生产率定义为质量相对交互成本,并检验主观评分能否替代 | 最高质量档的完成会话成本 854–60,324 token,相差 70.6 倍;质量与成本相关 +0.55/+0.27/−0.13/−0.48;控制质量后主观信心与成本相关 +0.41(p<0.01) | 三到四个任务来自同一 CoGym;可视化子样本 42;多为点估计且属观察性;声明仓库为空仓库 | 栏目 · arXiv |
| 3 | 邻近跟踪 | EnterpriseVal: Quantifying the Efficacy, Reliability and Value of Generative AI in the Enterprise · 2609.21841 | 企业侧用例的五件套评测与双层阈值门控 | 用例 B 中 Gemini 2.5 引用精度 88.0%、幻觉率 1.6%、导向召回 80.0%;用例 C 精修 10.6 小时对人工 27.4 小时 | 单一银行三个工作流试点;样本量、区间与评分者一致性均未记录;门槛为示例值 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Can Agents Design Better Chips with a Higher Level Abstraction? · 2609.21157 | 比较直接写 RTL 与在 HLS 抽象层迭代并回写 RTL 两种流 | 四种流的组合相对直接写 RTL 几何平均加速 2.62 倍,只在 HLS 上迭代是 2.31 倍;有效 n=13;较弱模型在 RTL 下只有较强模型的 0.40 倍、在 HLS 下 0.95 倍 | 每配置基本一次运行;无种子与区间;仅 FPGA 与两个闭源模型 | 栏目 · arXiv |
| 1 | 直接命中 | Designer-RSI: Evolving Procedural Memory from User Traffic for Agentic Graphic Design · 2609.22086 | 冻结权重,只演化外部 SKILL.md 程序性记忆 | Claude-Sonnet-4 上 GenEval2 成功率 72.7%→99.3%、质量 34.26→46.25;DPG-Bench 成功率 82.7%→100%;四基准平均质量 +7.70、成功率 +10.5 | 未报运行种子与区间;内部留出集 200 条与附录 193 条不一致;不发布任何资产 | 栏目 · arXiv |
| 1 | 直接命中 | One Prompt Does Not Fit All: Self-Meta-Evolve for Personalized Information Extraction · 2609.21626 | 为每个用户维护专属提示词,并让外层元优化器改进改法 | 292 个 persona 的留出集 59 条:结构化命中 74.58%,比 ProTeGi 高 13.56 个百分点(配对 bootstrap p=0.0038);人工双盲 200 次胜 71.0% | 用户由模型扮演、数据由模型合成;人工研究只验相对静态提示词;无多种子方差 | 栏目 · arXiv |
| 2 | 直接命中 | What Should We Ask Next? Retrieval-Aware Question Learning under Partial Evidence · 2609.21924 | 用真实检索反馈在线训练提问策略 | Interactive-PEDES 第 5 轮 R@1 73.73、R@10 94.98,对 LLaVA-ReID 高 5.79;只做监督微调 69.44、加在线强化学习 73.73;2×A800 训练 26.5 GPU 小时 | 单数据集、单检索器、单提问器骨干;训练多种子方差未报;无代码与数据 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Recursive Language Models Generalize Out of Domain · 2609.20831 | 把受限上下文放进递归模型的隔离帧,比较域外泛化 | 长度外推:递归模型 99.3→76.4 对思维链 79.0→9.7,最大差 +89.4 个百分点;深度外推 98.7 对 38.4 | 10.65M 参数、单一合成任务族;同分布大样本只有一个种子、无检验;无代码;v1 提交于 7 月 23 日 | 栏目 · arXiv |
| 2 | 邻近跟踪 | LogicTrack: Auditing Reasoning Trajectories of Large Language Models with Formal Logic Solvers · 2609.21492 | 生成过程中逐步形式化验证,失败处回溯重生成 | 8 个基准乘 7 个模型、168 个比较中 133 个优于基线;GPT-4o-mini 无效推理 21.51%→46.61%、总体准确率 70.68%→78.49% | 无多种子与区间;自动形式化的失败率未量化;求解器额外延迟未报;自身无代码 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Implicit Rule Induction with Test-Time Task Embeddings in ARC-like Tasks · 2609.21181 | 测试时先只微调任务嵌入,再冻结它微调骨干 | ARC-1 的 pass@1:全参数测试时训练 48.8、只训嵌入 13.0、两步 49.5;嵌入检索 top-5 命中 86.25% 对 6.5% | 单骨干来源、单数据集、无种子与检验;自建集小;无代码 | 栏目 · arXiv |
| 2 | 直接命中 | Rewarding Efficient Reasoning Improves Abstention on Underspecified Tasks in Reasoning Models · 2609.20846 | 惩罚越过信息不足判定点之后的冗余推理 | 弃权改善平均 +12.8%(摘要),正文写弃权召回平均 +0.173;思维链平均缩短 44%;朴素长度惩罚把作答正确性拉低 0.136 | 单次训练、无多种子与显著性;弃权真值靠模型判官;摘要与正文口径不一致;论文给出的代码仓库实测 404 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Information-Gain Rewards over Diversity-Pruned Tests: GT-Anchored Verifier Co-Training for Reliable Code Generation · 2609.21208 | 测试奖励改为信息增益,并加三阶段多样性剪枝 | 五个基准的一次性 pass@1 宏平均:7B 35.94 对 30.18、14B 42.90 对 35.82;四个种子平均,独立重跑差 0.61 与 0.35 个百分点 | 同族 7B/14B 加一个跨族 8B;训练仅用 CodeContests;沙箱限制;无方法代码 | 栏目 · arXiv |
| 3 | 邻近跟踪 | GVPO++: Group Variance Policy Optimization for LLM Post-Training and On-Policy Distillation · 2609.21432 | 用组方差权重构造无需重要性采样的后训练目标 | Qwen2.5-Math-7B 在 k=5 下平均 52.02 对 GRPO 46.69;1.5B 上 10 个随机种子的组间对照;去掉方差项或协方差项,五个指标全部掉到 0.00 | 主结果单骨干单种子、无 p 值;多种子用的是 1.5B;实现位于配方子模块,主库里检索不到相关标识 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Calibrating Teacher--Student Discrepancy for On-Policy Distillation · 2609.21619 | 用特权干预估计教师自偏差区间,只蒸馏区间外的残差 | 六基准平均:4B 教师到 1.7B 学生下 53.1 对同策略蒸馏 50.8;30B 到 4B 时同策略蒸馏反降,校准后 69.0;训练约快 1.26 倍 | 无训练多种子与显著性;偏差区间只用一对模型与两个探针;数学推理之外外推有限;实现未发布 | 栏目 · arXiv |
| 1 | 直接命中 | NemotronLabs VoiceChat: An Open Full-duplex Speech-to-Speech Model with Tool Calling Capabilities · 2609.21967 | 统一流式全双工语音到语音里加原生工具调用通道 | 工具选择 F1 82.5%、参数 42.2%、Pass@1 33.0%;平滑轮换时轮次占有率 81.5%、0.448 s;单 H100 四并发 160 ms 块 p95 118 ms | 无种子与区间;基线取自不同榜单;语音合成第 4 轮出现身份漂移;训练代码与数据未发布 | 栏目 · arXiv |
| 1 | 直接命中 | Voice-Light: A Full-Duplex Cascaded Voice Agent with Causal Turn-Taking and Speculative Generation · 2609.20995 | 级联管线里挂因果轮次适配器、可逆播放与权威历史提交 | 锁定测试上学习检查点假打断 2.70%,但回合结束召回仅 12.53%,Silero 时序策略为 95.60%;部署后 36 轮中位 758 ms | 学习检查点只测 11 段、1 次错误即 2.7 个百分点;部署检查点未在锁定集上评测;人工音频受限未公开 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Listen Before You Speak: Response Planning from Listener Facial Reactions for Conversational Speech Generation · 2609.21683 | 在文本到语音管线加听者面部动态分支与门控融合 | 与纯文本相比 macro-F1 提高 0.0093±0.0184,10 个种子中 7 胜,bootstrap 差 +0.0094、95% 区间 [−0.0057,+0.0247] | 区间跨零;只有 MELD 一个数据集,两类情绪样本极少;20 人主观评测无检验;仓库无许可证与权重 | 栏目 · arXiv |
| 2 | 邻近跟踪 | I'll Keep an Ear Out: Teaching AudioLLMs Proactive Audio Assistance · 2609.21183 | 在音频大模型词表里加打断与静默两个特殊标记 | ESC-50 上打断 F1 99.6%、静默 99.7%;迁移到 Epic-Sounds 厨房音频 F1 最高 67.5%,但声音起始召回只有 10.1%;流式平均延迟 3.5 s | 单一骨干、单评测集,无种子与区间;无代码与数据;无听障用户研究 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Scaling Forced Alignment to End-User Devices · 2609.21145 | 把分治引入强制对齐,并用正态近似先验做长度缩放剪枝 | 3 小时输入峰值内存 140 至 144 GB 降到 5.2 MB,CPU 271.3 s;加剪枝 57.2 s;未剪枝结果与原始实现完全一致率 100% | 剪枝的准确率表未报种子与方差;语料含宗教口译域;摘要与正文的内存口径不一致 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Enhancing Audio Reasoning via Semantic Summary Prediction · 2609.20849 | 训练期用一个寄存器标记对齐最终结论的嵌入 | SALMONN 13B 零样本 MMAU 58.03±1.50 对监督微调 54.65±0.34、MMAR 40.32±0.57 对 38.15±0.37;推理期丢弃该标记,零额外参数 | 未说明种子数;称显著但无检验;单骨干两个基准;未发布微调检查点 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Reusing Latent Speech Representations for Query-Conditioned Topic Localization in Transcripts · 2609.21844 | 把语音编码器的句级表示拼进文本主题定位 | Euronews 上文本 EM 45.26→69.11、R@1@0.5 从 72.92→79.66;YTSeg 上 EM 13.88→20.56 | 增益小到中等且无显著性;跨域 AMI 上变弱;声明发布的代码与检查点实测不存在 | 栏目 · arXiv |
| 3 | 邻近跟踪 | Transsion's Speaker-Attributed Multilingual ASR System for the MLC-SLM 2026 Challenge · 2609.20833 | 说话人日志与多语言识别级联,加任务定制微调 | 官方评测 tcpMER 从 22.78% 逐步降到 15.41%,端到端参考 16.27% | 单一评测集逐步消融;无种子与区间;名次为自述;无代码与模型发布 | 栏目 · arXiv |
| 1 | 直接命中 | GenTraceBench: A Benchmark for Tracing Audio Deepfakes Across Pre- and Post-training Stages · 2609.21738 | 在预训练与后训练变体之间追踪语音取证指纹 | W2V-BERT 检测 pooled 准确率 99.5%、EER 1.0%;8 个强化学习变体归属平均降 0.13±0.23 个百分点;只换数据组合的 Vevo2 降 10.15±0.97;多镜头注册把监督微调条件的 EER 从 44.4% 降到 11.0% | 只有一种监督微调配方;两个复核骨干单种子;评测语料为干净中英双语;漂移与音质损失混淆;无任何入口 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Rethinking Human-Aligned Evaluation: An Analysis of Semantic Metrics Beyond WER · 2609.21663 | 用人类成对偏好检验转写度量 | 1,000 个三元组、119 名标注者,Fleiss κ=0.3061;共识过滤后 WER 一致率 75.47%、CER 86.28%(McNemar p=9.03×10⁻¹²);最佳语义度量优于 WER(p=5.87×10⁻¹⁵),对 CER 不显著(p=0.243) | 单一朗读数据集、四个识别系统;先按标注完全一致过滤;摘要提到词素音节文字但实验全为英语 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Beyond WER: Entity and Disfluency Recall in Accented Conversational ASR · 2609.20828 | 把口音对话识别指标扩到实体与填充词召回 | 实体召回 79.5%–84.6% 对 Parakeet 53.6%–55.2%;填充词召回 76.5%–87.9% 对基线不足 5%;WER 5.95%–10.00% | 每区域一个适配器、无种子;参考转写为模型银标;印度区实体召回 79.52% 落在宣称区间外;训练代码未给地址 | 栏目 · arXiv |
| 1 | 邻近跟踪 | The Internet Archive Music Dataset · 2609.20870 | 从互联网档案馆抓取并自动标注大规模音乐文本数据 | 4.1M 条描述、34.8k 小时、548k 个源文件;30 秒片段 CAF 55.61±0.77 对 JMC 52.29±0.66;主观正确性 4.24±0.13 | 主观评测只有 100 条、20 人、无一致性检验;许可为用户自报且多数为非商业;论文与仓库的规模口径不一致 | 栏目 · arXiv |
| 1 | 邻近跟踪 | Investigating the Performance and Energy Costs of Replicating Band-Split RNN for Music Source Separation · 2609.21918 | 从零复现音频分离模型并把复现差距折算成能耗 | 原始论文 8.24 dB 对本次复现 7.42 dB,换替代数据生成后 7.87 dB;项目总能耗 24.2 MWh,是最佳单模型 53 倍 | 主结果单次运行;单数据集;能耗含实现失误与额外实验;仓库 README 引用的编号与本条不一致 | 栏目 · arXiv |
| 2 | 邻近跟踪 | Composer2Vec: A Continuous Embedding Space of Composer Style Learned from Symbolic Melody Generation · 2609.20893 | 检验生成模型内部的作曲家嵌入是否构成可解释连续空间 | 第一主成分与作曲家出生年相关 r=−0.884(p<0.001,n=123;嵌入矩阵含 124 位作曲家),优于通用音频文本嵌入;风格时期轮廓系数 0.0110(置换检验 p<0.001) | 单种子、无重复训练与规模消融;清洗阈值靠目视拟合;向量算术余弦值正文与表格不一致;无代码数据 | 栏目 · arXiv |
训练环境与轨迹信用:把「从哪学」和「学什么」分开定价
这一批六篇做的是同一件事的几段:前面三篇从源码或运行中的参考应用里自动长出可执行、可验证的环境,接着两篇把采到的轨迹展开成长上下文训练数据、蒸馏成可复用反馈,最后一篇把生成前的测试接口当作评测的支点。共同点是权重可以不动,动手的是环境、数据与信用分配。
1. ArenaFlow: From Trajectory Ranking to Hierarchical Credit Propagation for Open-Ended Agent RL(arXiv:2609.21378,直接命中·大语言模型与基础模型)
- 研究问题:开放式智能体任务缺少可靠的标量奖励,成对偏好最后只被压成一条轨迹级的奖励,中间步骤的作用被稀释,成功做法也留不下来。
- 改动位置(维度):只改信用分配与提示构成。把轨迹级排序下推为步骤级与技能级两级信用,策略模型本身不重训架构。
- 核心方法机制:策略模型先对同一问题采一组轨迹,用按种子排位的单败淘汰赛两两比较排出名次,名次折算成分位奖励,组内归一化后当优势。判官在同一次比较里顺带输出关键成功步骤、可复用技能与技能使用反思。步骤级把锦标赛深度当作权重,只在正优势轨迹上放大关键步骤;技能级按组内使用情况累积效用,负效用技能被剪掉,注入提示的排序分数是相似度加 λ 乘效用。
- 关键定量结果(含比较对象与口径):Open-Travel 均值 55.4,对照 ArenaRL 35.9、Pref-GRPO 32.2、GPT-5.2 29.4、Claude-4.5-Sonnet 35.5;Open-DeepResearch 均值 69.1、有效生成率 99.0%,对照 ArenaRL 54.7。消融:去掉步骤级信用 48.6、去掉技能级信用 50.7、去掉技能记忆 41.2。检索条数 k 取 1 为 49.8、取 3 为 55.4、取 6 掉到 43.6。关键步骤识别 F1 79.5、技能归因 F1 76.1。一次完整运行的记账是 1 小时 22 分、1.97M token、248 次模型调用。
- 证据强弱与复现边界:单一 8B 骨干上做了完整对比、四项消融、k 与 λ 的敏感性、三个判官交叉和 200 组人工标注;训练种子、置信区间与显著性检验都没有,训练集规模未报。正文写 DeepResearch Bench「综合分 43.2、比 ArenaRL 高 5.6」,而表格里的综合分是 45.8,列标疑为错位。摘要页与全文可达;声明指向的代码仓库能打开,但仓库里没有 ArenaFlow 相关目录,README 全文一次也没有提到它,实际是同一团队另一个项目的仓库,据它复现不了本文的任何一步。
- 对目标研究线的连接点:直接命中长程任务的训练与轨迹学习两条线。可搬的是那套「判官在同一次成对比较里同时产出步骤、技能、反思」的结构化输出,以及按比赛深度给步骤加权的做法。
- 结论与阅读建议:建议精读,重点看信用权重怎么从比赛深度算出来、技能记忆的效用如何累积与剪枝,以及 k 变大为什么反而掉分。
- 入口:栏目正文 · arXiv
2. CodeMidas: Scaling Agentic Coding RL Environments from Code Itself(arXiv:2609.22068,直接命中·智能体、规划与决策)
- 研究问题:现有编码强化学习环境要靠 issue、拉取请求、提交记录、既有测试或文档支撑,能不能只拿源码本身,把已经实现的功能自动变成可执行、可验证的训练环境。
- 改动位置(维度):只改数据与环境构造。四段智能体流水线自动重建环境,训练算法沿用现成的 GRPO。
- 核心方法机制:流水线依次做任务设计与代码库适配(删掉核心实现、把剩下的代码改成一致的起始工程,原始实现留在环境外当参考解)、构造能落地的执行测试、准备环境并做六个容器之间的一致性校验,最后做对抗性泄漏检查、假阳性假阴性筛查与难度过滤。只有既有成功又有失败的任务被留下当训练信号。
- 关键定量结果(含比较对象与口径):任务池共 5,545 个训练任务、3,185 个代码库,覆盖 23 种语言、15 个领域,Python 占 21.4%、TypeScript 18.3%、Go 16.2%;参考补丁中位 142 行,65.9% 触及两个以上源文件。MiMo-V2.5 加 GRPO 之后,DeepSWE 通过率 10.0%→21.7%、Terminal-Bench v2.1 63.7%→72.2%、ProgramBench 的 Almost Solved 4.5→21.5、自建验证集 35.0%→44.7%。任务池 1k/3k/5k 对应的 DeepSWE 分别是 17.57→19.05→21.70;用清洗后的 5k 比未清洗的 8k,在 SWE-bench Pro、DeepSWE 与自建验证集上分别高 0.59、4.59、4.49 个百分点。模型自己写检查并执行的那些 rollout,通过率平均高 4.2 个百分点(95% 区间 [1.8, 6.6])。
- 证据强弱与复现边界:有四组任务池同配置对照,行为与成功率的区间按整题重采样算,这一点比同批多数工作扎实;但只测了 MiMo-V2.5 一个模型,主结果没有多种子与显著性检验,外部基准只有两个点,验证器的可靠性来自自证式审查。环境构建的成本全篇未报。摘要页与全文可达,正则扫描 github、huggingface、modelscope 零命中,没有代码与数据入口,那 5,545 道题目前拿不到。
- 对目标研究线的连接点:直接命中长程任务的训练环境构造,也涉及轨迹学习里的数据清洗。可搬的是六容器一致性校验和「保留既有成功又有失败」的过滤原则。
- 结论与阅读建议:建议精读;引用那组提升之前先确认构建成本,以及两道过滤闸门是按哪个筛选模型、多少预算定的,换一个筛选模型这组数字要重测。
- 入口:栏目正文 · arXiv
3. RecreationWorld: Scalable and Verifiable Environments for Hybrid Computer-Use Agents(arXiv:2609.22000,直接命中·自然语言与多模态智能)
- 研究问题:计算机使用智能体分成两路:只操作图形界面的一路看得见运行中系统的行为,却很少改动它背后的软件;只写代码、跑命令行的一路搭得出软件,却看不见自己动作产生的界面。跨五平台的混合能力既缺可复现环境也缺留出基准。
- 改动位置(维度):只改环境与评测构造。给智能体一个正在运行的参考应用,让它自己发现行为并交付忠实实现;题面与隐藏测试在生成之前冻结。
- 核心方法机制:参考应用本身就是 oracle,先用它回放生成程序化断言,再用视觉模型把界面状态判成二值断言,断言先经参考回放再由人工复核,冻结后对所有候选重放。五个平台各有可复现的执行容器、统一执行契约与网络隔离策略,奖励来自重放结果而与应用源码相似度无关,构建或启动失败记零分。
- 关键定量结果(含比较对象与口径):RecreationBench 共 250 题,每平台 50 题;十模型评测里 GPT-6 Astra 综合 58.06% 排第一,Claude Opus 5 为 44.16%、GPT-5.6 Sol 为 42.06%、Qwen3.7-Plus 为 9.15%。轨迹结构上,每题中位 282.5 次顶层调用,GUI 与代码编辑之间每 100 次调用切换 9.08 次;同台的 ProgramBench 轨迹更长但没有 GUI 调用,OSWorld 2.0 只有计算机调用因而没有可分辨的代码编辑。严格「最后一次改码之后重启或观察」的闭环率落在 23.6%–47.5%。GPT-6 Astra 在五个平台都跑满套件时,程序化断言通过率 90% 以上的只有 17.6%、100% 的只有 2.8%。用每平台 7,000 条合成数据共 35,000 条做监督微调,五个域外基准的最大增益 17.9 个百分点,但曲线非单调。单次运行成本约 25 至 118 美元。
- 证据强弱与复现边界:题目共 250 道、覆盖五个平台、评测十个模型,套件经过参考验证与人工复核,多处给了 95% 自助区间;但每模型每平台只跑一次,训练对照点少且非单调,作者自己把行为与分数的关系标为描述性。项目页 recreation-bench.cc 两次抓取都在 120 秒超时,内容无法确认;GitHub 仓库(MIT,含源码与任务定义)、Hugging Face 与 ModelScope 上的 RecreationBench 数据都可访问,250 行测试数据可下载。
- 对目标研究线的连接点:直接命中长程任务的训练环境与执行落地奖励。它与 GameASG-Bench 恰好构成两种对照:这边用运行参考做 oracle,那边用生成前写死的测试接口,读者可以按自己团队的接口条件二选一。
- 结论与阅读建议:建议精读,先搬流程与验证思路;引用分数时记住单次 rollout 的噪声和每题几十美元的成本。
- 入口:栏目正文 · arXiv
4. DENSE: Distilling Agent Trajectories into Evidence-Grounded Shortcut Trees for Self-Refinement(arXiv:2609.21423,直接命中·其他/综合 AI)
- 研究问题:在线的智能体轨迹攒了很多,但任务验证器与专家标注扩不了规模;在拿不到事后结果标签的条件下,能不能从跑完的轨迹里提炼出可复用的反馈。
- 改动位置(维度):只改反馈的来源与表示。把已完成轨迹蒸馏成嵌套子任务树与证据接地的捷径树,接收方模型只靠这段反馈重跑。
- 核心方法机制:阶段一按动作与观察的时间队列切出前缀边界,递归建成嵌套子任务树并配上诊断摘要;阶段二自底向上把连续尝试融合成捷径,跨层核对把每个问题重新挂回它在轨迹中对应的证据位置,按任务是否完成渲染不同的详细度。对照协议让各方法共享同一次源运行,反馈是唯一传递通道,重跑时重置环境与模型上下文,效用按严格通过概率的变化计算。
- 关键定量结果(含比较对象与口径):Terminal-Bench 2.1 的 89 道题(DeepSeek V4 Pro 那条用 81 题),每题对每个接收方做三次配对重复。四个接收模型上 DENSE 都取得非特权方法的最高分:MiniMax-M2.7 52.43%(+7.87 个百分点)、DeepSeek V4 Pro 67.08%(+15.64)、GPT-5.5 75.66%(+7.12)、Kimi K2.6 50.94%(+11.61);相对只用轨迹的对照分别高 13.86、3.29、3.37、4.87 个百分点。重跑时的观测 token 少 19.0%、20.0%、43.6%、23.7%,一次反馈生成约 0.14 美元,反馈加重跑的总成本比源运行低 36.6%。
- 证据强弱与复现边界:四个接收方、共享源运行的配对、三次重复、六种对照加消融,结构比同批多数扎实;但只有 Terminal-Bench 2.1 一个基准,89 道题偏小,没有多种子、区间与显著性,反馈生成本身是非确定性模型调用且没有方差估计。全文只提到一个匿名补充包,本频道无法访问,原始轨迹、交付反馈文件与验证器日志都不在其中,实际拿不到可复现的物证。
- 对目标研究线的连接点:命中轨迹学习与自进化的核心方法学,它那套共享源运行、事后看不见结果、反馈作为唯一通道的对照协议,也可以直接用来给长程评测做无标签反馈试验。
- 结论与阅读建议:值得扫读;如果团队正在做轨迹蒸馏或离线反馈,升为精读。
- 入口:栏目正文 · arXiv
5. Boosting Deepresearch and LongContext Ability with Self-Generated Deepresearch Rollouts Traces(arXiv:2609.20844,直接命中·其他/综合 NLP)
- 研究问题:做深度研究的智能体在强化学习之后仍有六成以上错误与长上下文理解相关,如何在零标注成本下补长上下文训练数据并突破平台期。
- 改动位置(维度):只改训练数据的来源与课程。把智能体自己生成的研究轨迹展开成长上下文问答实例,再按四阶段课程退火回完整任务。
- 核心方法机制:把轨迹里的检索片段与网页摘要替换成对应链接的完整正文,保留证据关系;成功轨迹用答案监督,失败轨迹补上同题成功轨迹里的高价值片段。四阶段课程是:短程深度研究强化学习收集轨迹、转成长上下文问答、在无工具条件下做长上下文强化学习、恢复完整任务做退火。
- 关键定量结果(含比较对象与口径):4B 规模上 BrowseComp 31.7±2.8 对只用深度研究强化学习的 29.7±3.4,XBench 35.0±4.0 对 33.0±2.0,Seal 39.6±3.1 对 38.7±3.9;9B 规模对应 36.8±3.8 对 34.6±2.4、40.0±3.0 对 35.0±3.6、47.7±3.6 对 44.1±3.2。长上下文侧,LongBench-v2-128K 从 28.4 升到 39.8、Frames-128K 从 61.5 到 69.9、LongReason-128K 从 63.1 到 64.6。1,000 条错误轨迹里有 61.6% 归因于长上下文。
- 证据强弱与复现边界:两个骨干、两个规模,深度研究与长上下文各三个基准并给标准差,另有三组消融;训练层面没有多种子与显著性检验,标准差来自评测重复;摘要称长上下文平均提升 13.5%,按表格复算约 10.9%,只有 4B 规模对得上;截断中间部分会改变题目难度。摘要页显示的提交时间是 2026 年 8 月 5 日,进入本期批次时已不是当日新论文。全文没有代码与数据链接。
- 对目标研究线的连接点:命中长程任务里的长上下文瓶颈与自生成轨迹反哺训练这条链。可借用的是那套「先把轨迹扩成长上下文样本、再退火回原任务」的课程顺序。
- 结论与阅读建议:值得扫读,引用数字时按表格口径,摘要里那个数只作对照,并注意自生成数据的版权与噪声问题。
- 入口:栏目正文 · arXiv
6. GameASG-Bench: Benchmarking Autonomous Software Generation for Game Development(arXiv:2609.21293,邻近跟踪·评测、基准与数据集)
- 研究问题:交付一个能跑的应用与它的交互组件是否满足指定行为,是两件事;如何把行为可测性提到生成之前,并给出严格的任务成功率。
- 改动位置(维度):只改评测接口。生成前就把测试接口写死在页面对象上,用严格任务成功替代高均分。
- 核心方法机制:出题人先写好目标文档、规格文档与测试文档,接口固定为页面对象上的重置、载入场景、输入与取快照四个方法,智能体必须随游戏一起实现。第一层静态检查只证明源码合规,第二层在无头浏览器里按准备、动作、观察三步执行,返回通过、失败或不可用三种结果,并按行为要求的优先级分级;严格任务成功要求交付有效、评测跑完、且所有一级与适用的二级要求通过。
- 关键定量结果(含比较对象与口径):47 道题、12 个主类型,含 32 个二维与 15 个三维题目,共 336 条一级与 885 条二级检查,参考实现全部通过。严格成功最高的是 GPT-6-Astra 配 Codex CLI 26/47(55.3%),Claude-Opus-5 配 Claude Code 24/47(51.1%),GPT-5.6-Sol 21/47(44.7%),MiniMax-M3 7/47(14.9%);而一级检查均值高达 97.7%–99.6%、二级最高 93.2%。轮次上限 30/60/120 对应完成评测 10/32/47。全工具与无工具对照为 18/47 对 7/47。
- 证据强弱与复现边界:九种工具栈乘 47 道题、两层检查加参考实现正控制,覆盖面好;每任务每配置只运行一次,没有种子、区间与显著性,后三组问题只测单一模型,成本用的是供应商报告,执行器在必需的一级要求上返回「不可用」时并不阻止。
- 对目标研究线的连接点:邻近跟踪长程任务的评估。可迁移的是「生成前固定评测接口」与「行为层检查替代外观检查」,这与 RecreationWorld 用运行参考做 oracle 是两条互补路径。
- 结论与阅读建议:值得扫读;它偏评估基准,不提供轨迹学习本身的方法。仓库(Apache-2.0)含题面、检查与容器配置,可打开。
- 入口:栏目正文 · arXiv
长程评测与记忆:指标口径比分数更能决定结论
这一批八篇的共同问题是「拿什么当分数」。八篇各自换了不同的东西:换评测协议、换抽样子集、换决策插入点、换记忆的写入方式、换评委的计量单位、把成本算进成功、把评测搬进企业用例,以及换设计流程的抽象层级。
1. When Better Turns Do Not Make Better Agents: Diagnosing the Gap Between Next-Turn Metrics and Workflow Success(arXiv:2609.21187,直接命中·其他/综合 NLP)
- 研究问题:在金标历史加参考打分的设定下,下一回合的表现变好,能不能预测端到端客服工作流的成功。
- 改动位置(维度):只改评测协议。同一批模型输出上并排跑五种协议,从最宽松的文本重叠到最严格的整条工作流判定。
- 核心方法机制:五种协议分别是参考文本重叠、金标历史下的回合成功、严格工具正确性、闭环回放与整体工作流判定。闭环回放用模型自己的历史、确定型用户模拟器和精确工具匹配,把一次回答放进完整对话里跑到底。
- 关键定量结果(含比较对象与口径):四个模型上,监督微调让参考文本重叠从 24.8 升到 49.2、模型判官的回合成功从 33.2% 升到 58.4%;换成严格指标,全回合成功从 28.5% 升到 47.7%、工具回合从 17.8% 升到 23.7%、精确匹配从 3.5% 升到 8.5%。到了闭环回放只剩 8/77 条工作流跑通,整体工作流判定在八个配置上全部是 0/77。
- 证据强弱与复现边界:覆盖两族四个规模共八个配置,方向一致;但没有多种子、没有区间与显著性检验,工作流判定只用一个模型判官,77 条工作流的粒度偏粗。全文没有公开代码、数据与权重,只有附录里的提示词模板。
- 对目标研究线的连接点:直接命中长程任务的评估。它给出的是一条可以照做的纪律:报告智能体成绩时把「协议层级」写清楚,回合级分数不能单独当结论。
- 结论与阅读建议:建议精读它的协议设计与对照方式,数值本身绑在特定任务与模型上,别横向搬。
- 入口:栏目正文 · arXiv
2. Efficient Benchmarking in Production: A Study of an Evolving LLM Agent(arXiv:2609.21267,直接命中·自然语言与多模态智能)
- 研究问题:持续演进的生产智能体要在有限的评测预算下拿到可信分数与排名,用子集替代全量基准,保真度会掉多少。
- 改动位置(维度):只改评测抽样。比较随机采样、历史缓存、固定子集与自适应测试四类方法在同等预算下的偏差。
- 核心方法机制:把每个评测项当可标定参数,用项目反应理论估计难度与区分度,再按信息量选下一题;对照的固定子集来自 Rasch、K-means 加广义部分信用模型等做法。评测对象是一个持续迭代的智能体,因此作者还报告了跨版本重测的稳定性。
- 关键定量结果(含比较对象与口径):预算 200 题时,多维二参数自适应测试的通过率平均绝对误差 1.03 个百分点,Rasch 自适应 1.37、广义部分信用 1.40、随机采样 1.79;预算 100 题时广义部分信用 2.65 个百分点;预算 300 题时二参数自适应偏差 0.58 个百分点、与全量基准的排名相关 0.992。留出集用了 287 次评测、跨五个族 299 次,随机种子 20 个。历史缓存的平均绝对误差从 7.36 个百分点降到 0.81。
- 证据强弱与复现边界:留出与跨族次数、随机种子数都报得清楚,这在基准抽样类工作里少见;但没有给区间与 p 值,单一机构单一基准,线上真正部署的是固定子集,理论上更优的自适应方案只留在实验里,这一点作者自己写明。摘要里 1.03 个百分点与 0.992 对应多维二参数自适应,正文主推的 Rasch 自适应在同等预算下是 1.37 与 0.986,引用时别混用。代码、数据与题库都没有发布。
- 对目标研究线的连接点:直接命中长程任务的评估基础设施。任何按版本反复重测的智能体团队都能照它的口径算一遍「省下来的预算值多少分」。
- 结论与阅读建议:建议精读,注意部署方案与论文最优方案之间的差距,以及各项偏差对应的具体预算。
- 入口:栏目正文 · arXiv
3. An Interpretable Memory Decision Controller for LLM Agents Based on Three-Signal Complementarity(arXiv:2609.22043,直接命中·大语言模型与基础模型)
- 研究问题:检索回来的一段记忆值不值得信,要不要据此作答,能不能在生成之前用零训练的可审计模块决定。
- 改动位置(维度):只改决策点。在检索与生成之间插一个控制器,输入三个信号,输出采纳、修正或弃答。
- 核心方法机制:三个信号分别刻画记忆与问题的匹配、置信与一致性的互补关系;控制器做高斯值编码、正交投影与元工作记忆融合,把置信与一致性解耦后用阈值映射到四类动作。整套逻辑可逐项审计,单次决策约 40.1 微秒,替代的是让模型自评那一步(2.0 至 4.7 秒)。
- 关键定量结果(含比较对象与口径):TruthfulQA 配 gemma-4 上,高风险幻觉率从纯检索增强的 63.0% 降到 0.0%,整体准确率从 53.0% 降到 23.3%(p=0.014);代价是弃答率 0.877,与纯检索增强的 0.880 几乎相同。去掉正交子空间的消融掉 2.8 个百分点。
- 证据强弱与复现边界:给了 p 值、自助区间、消融与网格搜索;但种子少,高风险那一档只有 30 题,0.0% 出自极小样本;判定用的参考标签由幻觉结果反推而来,指标定义与结论之间存在循环。论文声明按 MIT 发布代码,摘要页与全文都找不到仓库或数据页地址,反向检索也没有结果。
- 对目标研究线的连接点:命中轨迹学习与自进化里的记忆读写质量控制。可搬的是「把弃答率与幻觉率并列报告」的做法。
- 结论与阅读建议:值得扫读机制与消融,主结果按弃答率与样本量打折看。
- 入口:栏目正文 · arXiv
4. AutoViewMem: Self-Configuring Orthogonal Views for Conversational Long-Term Memory(arXiv:2609.21940,直接命中·自然语言与多模态智能)
- 研究问题:长对话的记忆能不能在写入时就用互相正交的视图拆开,让检索阶段的简单 top-K 也能取到聚焦的证据。
- 改动位置(维度):只改记忆的写入结构。视图在写入时由模型自己发现,检索保持标准 top-K。
- 核心方法机制:每 50 个块提 10 个候选视图,用行列式点过程选出 K=10 个并扩展成抽取指令,逐块抽成结构化条目;查询期按标准 top-K 取,离线再做哈希与图整合。
- 关键定量结果(含比较对象与口径):LoCoMo 上模型判官分 0.837,对照 MemGAS 0.783、全历史 0.821;PersonaMem-32k 上 14B 达 69.10%,对照 MemoryBank 62.65%。消融:去掉多视图 0.774、把点过程换成随机 0.777、去掉图整合 0.801。
- 证据强弱与复现边界:两个骨干、两个基准加消融;没有多种子与方差,判官与生成同源,14B 上全历史直接投喂的 0.868 还高于本方法的 0.853,说明增益随骨干规模变弱。作者声明接受后发布代码、提示词与评测脚本,当前摘要页与全文都没有链接。
- 对目标研究线的连接点:命中长期记忆这条支线,口径是「表示先于检索」。
- 结论与阅读建议:值得扫读,借鉴视图发现、点过程选择与离线整合三者的模块边界。
- 入口:栏目正文 · arXiv
5. How Many Humans Is a Judge Panel Worth?(arXiv:2609.21277,直接命中·其他/综合 NLP)
- 研究问题:一个由语言模型组成的评委小组等价于多少位人类标注者,而且这个「有效规模」是否随测量目标变化。
- 改动位置(维度):只改评测计量。把评委小组的有效人数按两种误差定义分别算,并与名义人数对照。
- 核心方法机制:以每个条目上人类标签的经验分布为靶,用参与率匹配算一种有效规模,用分布平方误差算另一种;再把总误差分解,并定义一个共识方向上的方差占比,用来描述评委小组在多大程度上只是共享同一个偏好方向。
- 关键定量结果(含比较对象与口径):同一组 32 个评委在 ChaosNLI 的三个任务上,按参与率算出的有效规模是 4.24、6.46、6.50,只有名义人数 32 的 13.3% 至 20.3%;按平方误差算出的是 2.30、3.75、3.44;共识方向方差占比 43.8%、33.7%、35.9%。实验底账是 32 个模型乘 1,000 题乘 3 个任务共 96,000 条基线判断,加 122,000 条呈现序,12 次模拟。
- 证据强弱与复现边界:三个数据集乘 32 个评委、跨 10 个厂商,记录量做得很足;模拟网格有限,没有把多种不确定性量化出来,有一个数据集的跨半可靠性偏弱。论文补充材料里的六个链接渲染成无法解析的主机名;仓库本体可达,实测已改名为 32judges-votes,代码部分为 MIT、数据为 CC BY,README 里还多出一批论文未报告的条目。
- 对目标研究线的连接点:直接命中评测方法学。它给所有用模型评委打分的长程评测一个具体警告:写「32 个评委」时,实际有效人数可能只有四到六个,而且这个数字随测量目标变化,不能跨任务引用。
- 结论与阅读建议:值得扫读,把有效规模当作方法学警示,别当成新的排行榜指标。
- 入口:栏目正文 · arXiv
6. From Task Success to Productive Success: Evaluating Human-AI Collaboration by Quality and Cost(arXiv:2609.21117,直接命中·其他/综合 NLP)
- 研究问题:人机协作的「生产率」该如何定义,主观评分能不能替代质量与成本这两个客观量。
- 改动位置(维度):只改评价量。把质量与交互成本标准化后相减得到一个生产率分,并检验主观感受与它的关系。
- 核心方法机制:成本按用户输入的 token 加上半个智能体 token 计;质量用模型判官与李克特量表两条通道对照,并对子样本做人工验证;对话层面还标注了接地行为与「正向摩擦」。
- 关键定量结果(含比较对象与口径):最高质量档的完成会话成本区间是 854 至 60,324 个 token,相差 70.6 倍;质量与成本的相关系数在四个任务上分别是 +0.55、+0.27、−0.13、−0.48;控制质量之后,主观信心与成本的相关是 +0.41(p<0.01)。用户修复行为在低质量会话里出现 0.83 次、高质量会话里 0.22 次,生产率较高的会话里确认行为约为三倍。
- 证据强弱与复现边界:质量走人类与模型双通道并做了子样本验证;但四个任务里有三个来自同一个协作环境,可视化子样本只有 42 条,多数结论是点估计且属观察性。论文脚注给出的代码与数据仓库可打开,但实测是空仓库:API 显示 0 字节、没有许可证、内容接口返回「仓库为空」。
- 对目标研究线的连接点:直接命中长程任务的评估,把成本算进成功是这批工作里少见的角度。
- 结论与阅读建议:值得扫读,借它的生产性成功与成本框架,数字不要跨任务搬。
- 入口:栏目正文 · arXiv
7. EnterpriseVal: Quantifying the Efficacy, Reliability and Value of Generative AI in the Enterprise(arXiv:2609.21841,邻近跟踪·智能体、规划与决策)
- 研究问题:企业里一个生成式 AI 用例到底有没有效、可不可靠、值不值得上线,怎么量化到能下判决。
- 改动位置(维度):只改评测流程。给出用例规范、指标目录、盲评与校准判官、双层阈值门与价值风险模型五件套。
- 核心方法机制:六类指标覆盖正确性、幻觉、一致性、可解释性与交互质量;判官先校准,再用预测驱动推断把人工标注与模型打分结合;双层阈值门既看单指标门槛,也看综合分;价值侧用等权与保真加权两种口径对照。
- 关键定量结果(含比较对象与口径):用例 B 中 Gemini 2.5 的引用精度 88.0%、幻觉率 1.6%、导向召回 80.0%(门槛为引用精度大于 65、幻觉率小于 10、导向召回大于 75);Llama 4 对应 76.0%、3.2%、95.0%。用例 C 里模型精修耗时 10.6 小时,对人工的 27.4 小时。
- 证据强弱与复现边界:单一银行三个工作流的试点,作者自己写明样本量、置信区间与评分者一致性都没有记录,阈值只是示例。这是本批证据最弱的一档,适合借结构不适合引数字。没有代码与数据,参考实现与合成任务集都还只是计划。
- 对目标研究线的连接点:邻近跟踪长程任务评估的企业侧延伸,可搬的是「指标目录加双层门控」的结构。
- 结论与阅读建议:邻近跟踪,按连接点取用设计原则,不必通读原文。
- 入口:栏目正文 · arXiv
8. Can Agents Design Better Chips with a Higher Level Abstraction?(arXiv:2609.21157,邻近跟踪·自然语言与多模态智能)
- 研究问题:让智能体在更高的寄存器传输级抽象之上设计再回写底层,与直接写底层相比,能不能得到更好的芯片。
- 改动位置(维度):只改设计流程的抽象层级与迭代轮数,比较四条流:直接写寄存器传输级、只在高层综合层迭代、高层综合后再回写、编译后再精修。
- 核心方法机制:智能体在每条流里按固定轮数与时限迭代,用隐藏测试台做端到端面积、功耗与性能的评测,评测对象是最终交付,中间产物不计分。
- 关键定量结果(含比较对象与口径):两种高层流组合相对直接写底层,几何平均加速 2.62 倍;只在高层综合层迭代是 2.31 倍。有效样本 n=13。较弱模型在直接写底层时只有较强模型的 0.40 倍,换到高层综合层后升到 0.95 倍。例如某个基准上高层方案用 127K 周期与 118K 查找表,直接写底层是 1.86M 周期与 5,454 查找表。
- 证据强弱与复现边界:11 个任务乘 2 个模型乘 4 条流,评测用的是端到端指标与隐藏测试台,但每配置基本只跑一次,没有种子与区间;有效样本 13 来自基线不齐;平台只有 FPGA,模型是两个闭源接口。仓库可达(MIT),含任务、测试台、结果与轨迹,复现需要厂商工具链与接口。
- 对目标研究线的连接点:邻近跟踪长程任务的训练与评估。可迁移的结论是抽象层级会改变能力上限:弱模型的成绩在直接写底层时只有强模型的 0.40 倍,换到高层抽象后升到 0.95 倍,两者从相差两倍多变为基本持平。
- 结论与阅读建议:值得扫读,主题在芯片设计,方法论适用于任何「工具链很长、评测在末端」的长程任务。
- 入口:栏目正文 · arXiv
自进化与测试时适应:改哪一层、谁来验收
这一批八篇继续沿「只改一层」的方向走,并且把验收环节本身当成要解决的问题:演化出来的东西由谁判、判不准怎么办、什么时候该停下来。
1. Designer-RSI: Evolving Procedural Memory from User Traffic for Agentic Graphic Design(arXiv:2609.22086,直接命中·智能体、规划与决策)
- 研究问题:图形设计的长程任务没有可靠判分器,如何在权重不动、不依赖人工标注的条件下,把真实用户流量里的经验固化成可复用的技能。
- 改动位置(维度):只改外部程序性记忆。四个角色组成离线演化环,权重全程冻结,唯一变化的是一份技能文件。
- 核心方法机制:提示词角色、求解角色、多模态评分角色与反思角色分工,反思角色把失败轨迹转成技能候选;技能库沿加宽与加深两个方向生长,候选必须通过配对盲评的复现门才能入库。冷启动的 76 条技能来自产品帮助文档整理的流水线。
- 关键定量结果(含比较对象与口径):五轮演化共 1,406 条真实需求与 1,869 条自动评分轨迹,技能库从 76 条长到 139 条,期间拒掉 231 次改写中的 100 次、136 次新增中的 67 次。Claude-Sonnet-4 上 GenEval2 成功率 72.7%→99.3%、质量 34.26→46.25;DPG-Bench 成功率 82.7%→100%、质量 68.28→83.79;四个基准平均质量 +7.70、成功率 +10.5;延迟只增加 3.4% 到 6.2%。
- 证据强弱与复现边界:三个骨干乘四个通用与四个设计基准,做了消融、显著性与效应量;运行种子与置信区间未报,内部留出集在正文写 200 条、附录写 193 条,两处不一致。作者在附录里明确不发布用户提示词、轨迹、内部评测集与技能库,全文没有代码链接,可复现性停在方法层。
- 对目标研究线的连接点:直接命中自进化这条线,是本期「改哪一层」的代表:把改进从权重搬到一份外部记忆文件上,并且给候选设了验收门。
- 结论与阅读建议:建议精读,搬机制不搬数字,先解决判官同族、同批次重放与保守阈值三件事。
- 入口:栏目正文 · arXiv
2. One Prompt Does Not Fit All: Self-Meta-Evolve for Personalized Information Extraction(arXiv:2609.21626,直接命中·自然语言与多模态智能)
- 研究问题:同一份文档对不同岗位的用户要重组出不同结构,如何为每个用户维护专属提示词并让它持续改进。
- 改动位置(维度):只改提示词的维护方式。内层为每个用户改提示词,外层反过来改进「怎么改」这件事。
- 核心方法机制:内层由扮演用户的模型给出结构化的修改与删除反馈,编辑智能体按元提示词输出点到点的补丁;损失下降的轨迹进成功缓冲,攒够 K 条后外层元优化器重写元提示词,把跨用户的编辑模式沉淀下来。
- 关键定量结果(含比较对象与口径):292 个用户画像、留出集 59 条上,结构化命中率 74.58%,比上一代提示优化方法 ProTeGi 高 13.56 个百分点,配对自助检验 p=0.0038;跨五个骨干的同一指标都有一致提升,例如 GPT-5.1 从 61.02 到 74.58。人工双盲 200 次里本方胜 71.0%、负 19.0%、平 10.0%(p<10⁻⁵)。去掉外层元优化,结构化命中从 74.6 掉到 57.6。全程 12.4K token 每轮、合计 0.372M。
- 证据强弱与复现边界:八个基线、五个骨干、跨领域与两项人工研究,表面看很全;但用户由模型扮演、训练数据由模型合成,人工研究只验证了相对静态提示词的优势,没有验证胜过 ProTeGi;多种子方差未报。论文声明接受后按 CC BY 4.0 发布画像池与脚本,当前摘要页与全文都没有链接。
- 对目标研究线的连接点:命中自进化里的经验复用,外层元优化是在优化「改进方法本身」,这一层设计可搬到任何按用户持续交互的智能体。
- 结论与阅读建议:建议精读双环结构;先确认真实用户反馈存在,不要用被评测的基线给自己定阈值。
- 入口:栏目正文 · arXiv
3. What Should We Ask Next? Retrieval-Aware Question Learning under Partial Evidence(arXiv:2609.21924,直接命中·智能体、规划与决策)
- 研究问题:在只掌握部分证据的交互式检索里,下一个该问什么,能不能用真实检索系统的反馈来训练提问策略。
- 改动位置(维度):只改提问器的训练信号,把离线问答顺序模仿换成用真实检索反馈做在线强化学习;检索器、回答器与视觉骨干全部冻结。
- 核心方法机制:先用小规模监督微调冷启动,再让提问器在能看到前四名候选的环境里用组相对策略优化继续训练,奖励是排名的倒数改进并额外强调进入第一名,另设有效性门控过滤无效提问。训练状态池按固定规模分层构造,便于比较冷启动与强化学习各自的贡献。
- 关键定量结果(含比较对象与口径):Interactive-PEDES 第 5 轮 R@1 为 73.73、R@5 90.53、R@10 94.98,比对照方法高 5.79 个百分点的 R@1;只做监督微调是 69.44,加在线强化学习到 73.73。状态池规模 0K/1K/3K/5K 对应 69.44/69.46/73.73/74.35。训练用 3,000 个状态、24,000 条 rollout、1,500 次更新,2 张 A800 上训练 26.5 GPU 小时、评测 16.6 GPU 小时。
- 证据强弱与复现边界:五轮多基线、状态池扫描,还做了离线标签弱预测的诊断(含 p 值)与人机一致性审计,算力披露清楚;但单数据集、单检索器、单提问器骨干,训练方差未报,无代码与数据。
- 对目标研究线的连接点:命中轨迹学习里「用真实多轮反馈替代离线模仿」这条线,也命长程评测里整条轨迹的预算指标。
- 结论与阅读建议:值得扫读,方法干净、算力清楚,是本期少见的可核算训练成本的一篇。
- 入口:栏目正文 · arXiv
4. Recursive Language Models Generalize Out of Domain(arXiv:2609.20831,邻近跟踪·其他/综合 NLP)
- 研究问题:限制语言模型能看到什么,在什么条件下反而让它学得更好;把整条扁平的思维链与递归模型的隔离子问题上下文相比,域内与域外的可学习性各是什么样。
- 改动位置(维度):只改模型能看到上下文的位置,用递归模型的隔离帧代替整条思维链,并逐项控制变量。
- 核心方法机制:作者先在域内用描述长度与有限类界证明思维链可以复现递归模型能表达的子序列,因此域内几乎没有统计优势;再到域外用最小描述长度与不变性论证思维链会利用邻近中间值、格式与答案位置这些捷径,而递归模型通过隔离上下文把捷径排掉。实验用带类型函数库的表达式生成器,长度与深度两个维度分别外推。
- 关键定量结果(含比较对象与口径):长度外推上,递归模型从域内 99.3 掉到域外 76.4,思维链从 79.0 掉到 9.7,最大差 89.4 个百分点;深度外推上递归模型 98.7、思维链 38.4,差 60.4 个百分点;六类捷径的域外准确率递归模型 87.3%–99.7%、思维链 0.3%–14.7%。每种设置用了 3,100 条表达式。
- 证据强弱与复现边界:三组受控实验共享架构与表达式池,另做了帧宽度的诊断;但模型只有 10.65M 参数、6 层、从零训练,任务族是合成表达式,同分布大样本只跑一个种子、没有统计检验,离真实语言模型的迁移还有距离。全文没有代码、数据与检查点,v1 的提交时间是 7 月 23 日,比本期批次早两个月。
- 对目标研究线的连接点:邻近跟踪长程任务评估与轨迹表示。它给出的是一条可以直接照做的评估纪律:构造同规则的域外对照,用不变性验收,域内分数据此只能作参照。
- 结论与阅读建议:值得扫读,读论证与实验设计,不必纠结那几个准确率数字。
- 入口:栏目正文 · arXiv
5. LogicTrack: Auditing Reasoning Trajectories of Large Language Models with Formal Logic Solvers(arXiv:2609.21492,邻近跟踪·自然语言与多模态智能)
- 研究问题:一条思维链的中间步骤是否逻辑有效,怎么验证,才能避免出现「链子是错的、答案是对的」这种情况。
- 改动位置(维度):只改生成过程中的验证与回溯。每一步被拆成上下文、解释与结论三段,自动形式化后交给求解器判定,不通过就在该位置回溯重生成。
- 核心方法机制:形式化后的前提保真度与求解器验证结果合成一个奖励,低于阈值即触发回溯;回溯过程中产生的轨迹再被收集起来做监督微调,约 6,000 条。
- 关键定量结果(含比较对象与口径):八个基准乘七个模型共 168 个比较中有 133 个优于基线。GPT-4o-mini 的 VU(全步骤都通过求解器验证的那部分样本上的答案准确率)从 21.51% 升到 46.61%,总体准确率从 70.68% 升到 78.49%;另一个模型在一个基准上把未验证步骤占比从 75.63% 降到 27.79%。
- 证据强弱与复现边界:覆盖面广,奖励成分与搜索策略都做了消融;但没有多种子、置信区间与显著性检验,自动形式化的失败率没有量化,求解器带来的额外延迟没有报告。全文唯一命中的模型仓库是基线方法的,本文产物没有发布地址。
- 对目标研究线的连接点:命中长程任务的训练与评估,过程级验证与「用回溯轨迹造监督数据」两端都能借。
- 结论与阅读建议:值得扫读;符号求解器路线离语音与生成式音频较远,价值在验证信号的设计。
- 入口:栏目正文 · arXiv
6. Implicit Rule Induction with Test-Time Task Embeddings in ARC-like Tasks(arXiv:2609.21181,邻近跟踪·其他/综合 AI)
- 研究问题:在抽象推理类基准上,模型的解题反映的是它归纳出了目标规则,还是走了捷径;如何把规则归纳与规则执行分开观测。
- 改动位置(维度):只改测试时适应的对象。先只微调任务嵌入,再冻结这个嵌入去微调骨干,与把两者一起微调形成对照。
- 核心方法机制:作者用无真值规则的检索、线性探针、回归探针、降维后的几何结构与受控组合任务五个角度诊断嵌入里到底装了什么;三步组合分别是全参数测试时训练、只训嵌入、先训嵌入再训骨干。
- 关键定量结果(含比较对象与口径):主基准的 pass@1 上,全参数测试时训练 48.8、只训嵌入 13.0、两步 49.5;嵌入的 top-5 检索命中率在全参数方案下只有 6.5%、只训嵌入下是 86.25%;组合任务里正确切换的命中率是 100% 对 13.3%。只训嵌入的可训练参数不到总参数的 0.01%,全参数方案约 1,800 万。
- 证据强弱与复现边界:三臂对照加五类探针,信号强;但只有单一骨干来源、单一数据集,没有多种子、区间与显著性,组合任务的一个子集上任务级与配对级差距很大,自建数据规模小。无代码与数据。
- 对目标研究线的连接点:这是本期测试时适应最直接的一篇,也是「规则归纳与规则执行要分开评」的样本。
- 结论与阅读建议:值得扫读,属于合成推理与测试时适应的机制研究,方法论可借。
- 入口:栏目正文 · arXiv
7. Rewarding Efficient Reasoning Improves Abstention on Underspecified Tasks in Reasoning Models(arXiv:2609.20846,直接命中·其他/综合 NLP)
- 研究问题:推理模型在信息不足、题目无解的情况下不会及时停下;如何让它在判定点之后就停止推理。
- 改动位置(维度):只改奖励。在组相对策略优化的奖励里惩罚越过「信息不足判定点」之后的冗余推理。
- 核心方法机制:先用人类对照确认一件事:人在不可回答的题目上花的推理努力,落在可回答题目给出的上界之内。据此设计的过程奖励把判定点之后的每个 token 计价,并与结果奖励组合;训练用 LoRA 微调约 4B 的推理模型。
- 关键定量结果(含比较对象与口径):多个 4B 模型上弃权表现平均提升 +12.8%(摘要口径),正文写弃权召回平均 +0.173;思维链平均缩短 44%,不可回答任务从 1,432 降到 662 个 token、可回答任务从 1,183 降到 766。三种奖励同条件对照里,只有本文的过程奖励保住了作答正确性(−0.012),朴素的长度惩罚把它拉低 0.136。人类对照一共 24 个条目、126 人、每人 6 个主试次。
- 证据强弱与复现边界:人类对照与三奖励同条件比较是亮点;但只训练一次,没有多种子与显著性检验,弃权的真值依靠模型判官,而且摘要与正文的口径不一致(+12.8% 对 +0.173),引用时必须写明用的是哪一处。论文脚注给出的代码仓库实测 404,作者的项目站点可达、人类实验页面可打开,训练数据与权重没有发布。
- 对目标研究线的连接点:直接命中长程任务的训练与评估。它把「算力该花在哪儿」变成奖励的一部分,这在长程任务里是常见痛点。
- 结论与阅读建议:值得扫读,重点看人类对照的设计与那个口径不一致带来的引用风险。
- 入口:栏目正文 · arXiv
8. Information-Gain Rewards over Diversity-Pruned Tests: GT-Anchored Verifier Co-Training for Reliable Code Generation(arXiv:2609.21208,邻近跟踪·其他/综合 AI)
- 研究问题:代码生成的自我博弈里,测试太宽松会崩、太集中会偏,如何同时治这两个毛病。
- 改动位置(维度):只改自我博弈的奖励。测试的奖励从通过率换成信息增益,并在固定预算下加三阶段多样性剪枝。
- 核心方法机制:单个策略同时扮演 coder 与 verifier,用自生成测试的通过失败向量与真值锚定的正确性信号之间的互信息给测试打分,并用协方差符号做门控;三阶段剪枝按无效性、输入字符串与执行剖面剔除冗余测试,让固定预算下的信息增益估计更有效。
- 关键定量结果(含比较对象与口径):五个基准一次性 pass@1 的宏平均,7B 35.94 对同规模基线的 30.18、14B 42.90 对 35.82;四个种子平均,独立重跑的差是 0.61 与 0.35 个百分点。奖励消融的三档分别是 33.91、34.75、33.51;不剪枝 34.27,剪枝后 35.94。训练 350 步,7B 用 72 GPU 小时、14B 用 96 GPU 小时(2 张 B200)。
- 证据强弱与复现边界:这是本期证据披露最规范的一篇:四个种子平均、独立重跑方差、逐基准差值、两组消融、跨族对照与量化算力都给了;模型规模只有 7B/14B 同族加一个跨族 8B,训练只用竞赛题数据,沙箱有限制。方法代码与数据没有发布,全文唯一命中的数据集是第三方竞赛数据。
- 对目标研究线的连接点:命中自进化里的「验证器与生成器协同训练」,奖励设计与方差控制的写法可直接借用。
- 结论与阅读建议:值得扫读,代码生成域与本频道主线不相交,但方差披露与奖励门控的做法值得抄。
- 入口:栏目正文 · arXiv
后训练与蒸馏:教师信号里哪些不该学
这两篇处理同一类风险:教师或参考模型给出的 token 级信号里混着它自己的偏好,学生照单全收就会学到任务无关的东西。
1. GVPO++: Group Variance Policy Optimization for LLM Post-Training and On-Policy Distillation(arXiv:2609.21432,邻近跟踪·自然语言与多模态智能)
- 研究问题:组相对策略优化依赖重要性采样,比值可能任意大、方差难控;能不能给出一个唯一最优、无需重要性采样、还能推广到同策略蒸馏的梯度加权方式。
- 改动位置(维度):只改训练目标。用组方差权重把监督微调、拒绝采样与组相对策略优化的梯度统一成一个带权形式。
- 核心方法机制:作者把三类梯度统一成加权对数似然之和,利用组内权重和为零把配分函数消掉;权重取隐式奖励中心距与真实奖励中心距之差,梯度等价于中心距的均方误差,正则项包含组相对优势、协方差与方差三部分。定理证明唯一最优是 KL 约束下的奖励最大化,并扩展到任意采样分布;同策略蒸馏在序列级分配权重,支持跨词表蒸馏。
- 关键定量结果(含比较对象与口径):Qwen2.5-Math-7B 在 k=5 下平均 52.02,对照 GRPO 46.69、Dr.GRPO 46.77、Remax 49.01、Reinforce++ 47.22。1.5B 上跑了 10 个随机种子,五个评测的平均分与标准差都给了。消融里单独去掉方差项或协方差项,五个评测指标全部掉到 0.00(训练不收敛、输出不连贯);两项同时去掉能短暂收敛,约 10% 的训练轮次后开始发散。跨词表蒸馏上 35.99 对策略梯度的 24.75、序列级蒸馏 19.06、监督微调 19.57。
- 证据强弱与复现边界:有 10 个随机种子的标准差、换骨干对照、跨域对照、正则消融与多组敏感性;但主结果单骨干单种子、没有 p 值,而 10 个种子用的是 1.5B,主实验用的是 7B。实现位置与论文表述有出入:论文说已并入官方仓库,实测主库里检索不到相关标识,代码在另一个配方子模块中,许可证为 Apache-2.0,基座与数据公开。
- 对目标研究线的连接点:与自进化、同策略自蒸馏的方法基础相关,且与下一篇构成一对可比方案:一个改梯度权重,一个改教师参考。
- 结论与阅读建议:邻近跟踪,按连接点取用;做训练算法的团队值得展开看定理与消融。
- 入口:栏目正文 · arXiv
2. Calibrating Teacher--Student Discrepancy for On-Policy Distillation(arXiv:2609.21619,邻近跟踪·其他/综合 AI)
- 研究问题:同策略蒸馏学的是 token 级的师生似然差,而这个差里混着教师自身的偏差;直接把特权信息交给教师会放大偏差,学生于是学到任务无关的噪声。
- 改动位置(维度):只改教师参考的构造。用特权干预估计教师自偏差的区间,只把落在区间外的学生残差当作校准信号。
- 核心方法机制:只对教师喂特权信息,用正向与负向干预探测教师似然的变化幅度,得到自偏差区间;把同策略蒸馏的优势分解成校准项与偏差项,学生似然落在区间内就置零,落在区间外则保留越界的残差。特权干预只用来校准教师参考,不直接蒸馏给学生。
- 关键定量结果(含比较对象与口径):六个基准的采样平均上,4B 教师到 1.7B 学生的配置里学生 49.2、教师 63.2、同策略蒸馏 50.8、本方法 53.1,12 个基准与配置的组合里有 7 个最优;30B 教师到 4B 学生时同策略蒸馏反而比学生低(65.9 对 66.6),本方法到 69.0。任务无关的指令变体让 20.2% 与 25.8% 的 token 出现显著偏差,并集 29.8%。训练约快 1.26 倍,最终回答长度 9.3K 对同策略蒸馏的 11.8K。
- 证据强弱与复现边界:两个规模配置、六个基准、五个基线、干预集与松弛因子消融、训练动力学与效率分析都有;但没有训练多种子与显著性检验,采样平均只反映单次训练的采样噪声,偏差区间只靠一对模型与两个探针估计,数学推理之外的外推有限。实现未发布,基座与部分训练数据是公开的,校准部分要自己实现。
- 对目标研究线的连接点:命中自蒸馏这条支线,也关系到语音生成模型的蒸馏训练:教师信号里哪些该学,这一篇给了可操作的判据。
- 结论与阅读建议:值得扫读;如果正在做蒸馏训练,升为精读。
- 入口:栏目正文 · arXiv
语音接口层与生成:全双工、何时开口、上传什么
这一批八篇都落在对话式语音的接口层与生成侧:两篇处理全双工系统怎么在对方还没说完时决定动作,一篇处理什么时候该主动出声,一篇给对话语音加听者面部条件,两篇处理长音频在进入模型之前该怎么切、怎么定位(强制对齐与主题定位),一篇处理多说话人对话的说话人归属,一篇用寄存器标记给音频推理加训练期约束。
1. NemotronLabs VoiceChat: An Open Full-duplex Speech-to-Speech Model with Tool Calling Capabilities(arXiv:2609.21967,直接命中·语音语言联合与音频文本)
- 研究问题:一套统一的流式架构能不能同时保住全双工实时交互行为与原生工具调用。
- 改动位置(维度):只改模型架构与通道划分。在流式语音到语音架构里加原生的工具调用通道,并单独做语音合成细化头。
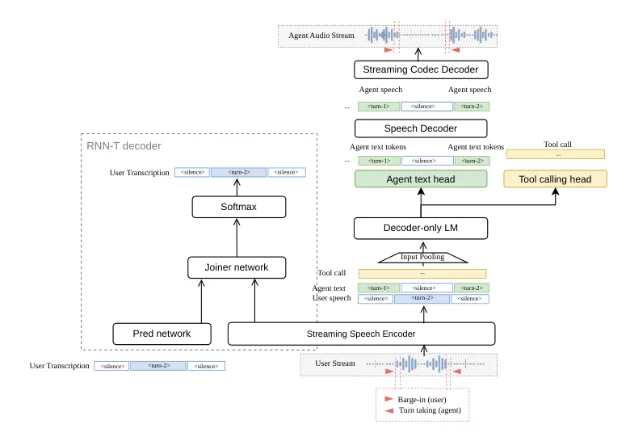
- 核心方法机制:骨干是一个 9B 级别的基座模型,加 600M 流式卷积编码器;同一份编码状态同时喂给语言模型与一个辅助识别分支。工具调用走独立的函数通道,训练时音频、文本与函数三类样本按 1 比 1 比 2 混合。语音合成侧用一个约 977M 的组合模型,用高斯混合头做 4 到 8 次细化替代 31 步自回归解码,音色由 3 秒参考音频条件化。
- 关键定量结果(含比较对象与口径):工具选择 F1 82.5%、参数准确率 42.2%、Pass@1 33.0%;在同台比较里,选工具一项胜过 Gemini Live 2.5 与 3.1,参数与执行两项落败。交互行为上,平滑轮换的轮次占有率 81.5%、0.448 s;用户打断场景轮次占有率 100%、自然度 4.33/5;暂停场景只有 15.3%。识别词错率从 9.02% 降到 8.28%。单张 H100、四并发、160 ms 音频块下的 p95 延迟 118 ms,处理速度约为实时的 1.36 倍。
- 证据强弱与复现边界:没有种子、区间与显著性检验;多个基线取自不同榜单,横向可比性有限;工具调用只测一个数据集;语音合成第 4 轮出现说话人身份漂移(等错误率代理指标从 2.00±0.10 到 2.20±0.20)。论文内部用代号指称同名系统,与标题不一致。模型权重确实发布在模型站上(非门控、openmdw-1.1 许可,含权重文件),训练代码、数据与评测脚本都没有发布。
- 对目标研究线的连接点:直接命中 TTS 生成与评估这条线:它是本期唯一一个权重可下载、能直接跑起来的开源全双工语音到语音基线,同时给工具调用型语音前端提供了统一通道的样本。
- 结论与阅读建议:建议精读,先跑通再评估;引用工具调用数字时注意基线来自不同榜单。
- 入口:栏目正文 · arXiv
2. Voice-Light: A Full-Duplex Cascaded Voice Agent with Causal Turn-Taking and Speculative Generation(arXiv:2609.20995,直接命中·语音识别与关键词检测)
- 研究问题:级联式语音代理(识别、语言模型、合成三段)如何在不打断每句应答、又不误判每次附和的前提下,判断轮次并提前准备回应。
- 改动位置(维度):只改控制器与历史提交规则。在冻结的流式识别模型上挂一个约 18.3 万参数的因果适配器,加可逆播放控制、投机生成与「只把真正播出的音频写进历史」的提交规则。
- 核心方法机制:适配器取编码器四层特征投影成 64 维,过因果卷积与门控循环单元,输出三个头:完成度与让出、交互事件、未来活动。控制器把基于能量的检测器当作最早的声学权威,轮次接管概率超过 0.82 才提交打断,非抢话反馈超过 0.82 则恢复同一代生成;回放可逆,暂停可恢复。浏览器确认播出的音频才进入对话历史,被取消的音频不进入。
- 关键定量结果(含比较对象与口径):锁定评测上的学习检查点假打断率 2.70%,但回合结束召回只有 12.53%,而基于能量的时序策略在同样的 2.70% 假打断率下召回 95.60%,延迟 656 ms;部署的控制器因此保留混合方案。另一个训练步数的版本把召回提到 65.04%,代价是假打断率 3.73% 与 p95 延迟 2.0 s。合成数据上的判别指标 0.9260,换到真人样本掉到 0.5646。工具决策从 80.0% 提到 95.2%,过渡语句从 7.6% 提到 94.3%。部署后三段真实会话 36 个响应轮次的中位延迟 758 ms,21 轮低于 800 ms。
- 证据强弱与复现边界:这一篇的价值一半在它报告的负结果:学习到的轮次判定没有打过简单的时序规则,作者因此保留混合控制器并把阈值冻结后评测,这种披露在同批里少见。边界也清楚:学习检查点只测了 11 段、37 个待定事件,一次错误就是 2.7 个百分点;部署的检查点没有在锁定集上评测;延迟统计来自单人三段会话,属于仪器化个案。代码仓库可打开、含完整运行时与文档但没有许可证文件,演示页可访问,合成数据与适配器权重可下载,人工采集的语料登记为受限未公开。
- 对目标研究线的连接点:直接命中语音生成这条线,同时给了长程任务一个具体标准:哪些音频才算「已经发生」,这决定了历史与记忆里该写什么。
- 结论与阅读建议:建议精读,把它当作混合控制器与证据边界的设计范本。
- 入口:栏目正文 · arXiv
3. Listen Before You Speak: Response Planning from Listener Facial Reactions for Conversational Speech Generation(arXiv:2609.21683,邻近跟踪·其他/综合 AI)
- 研究问题:开口之前一秒,听者的面部反应能不能给下一句的情绪与韵律规划提供文本之外的补充信息。
- 改动位置(维度):只改条件输入。在纯文本的语音合成管线里加一路听者面部动态分支、一个门控融合与一个响应风格适配器。
- 核心方法机制:三段式。第一段用文本编码器加图像主干与 Transformer,从听者面部输出情绪、效价唤醒度与韵律风格;第二段在对话数据集上训练合成器;第三段冻结第一段,训练响应风格适配器。融合按门控加权,并保留一条残差文本通路保底,保证面部信号缺失时退化回文本条件。
- 关键定量结果(含比较对象与口径):与纯文本条件相比,宏观 F1 提高 0.0093±0.0184,10 个种子中赢 7 次;自助法差值 +0.0094,95% 区间 [−0.0057, +0.0247],区间跨零;反事实对照里正确面部条件 0.2582、错配 0.2526。主观评测 20 人,76% 偏好加入面部条件的版本。
- 证据强弱与复现边界:种子数、自助区间、反事实与主观评测都做了,这在语音生成里不常见;但区间跨零,只能说方向为正;只有对话数据集 MELD 一个来源,两类情绪样本分别只有 7 与 8 条,主观评测没有检验,消融与主实验用的种子集不同因而不能直接比较。代码仓库可打开、含脚本与配置,但没有权重、音频与许可证文件,README 提到许可证文件而仓库里并不存在。
- 对目标研究线的连接点:命中 TTS 生成的条件侧建模与统计和主观评测设计;与长程任务、轨迹学习两条线没有直接关系。
- 结论与阅读建议:值得扫读,方法配方可借;结论只当弱正向线索引用。
- 入口:栏目正文 · arXiv
4. I'll Keep an Ear Out: Teaching AudioLLMs Proactive Audio Assistance(arXiv:2609.21183,邻近跟踪·语音翻译与语音语言模型)
- 研究问题:音频大模型能不能根据一句自然语言的留意意图,自己盯着音频流决定什么时候打断、什么时候保持安静。
- 改动位置(维度):只改解码状态。在音频大模型的词表里加两个特殊标记,把主动决策直接编码进生成过程。
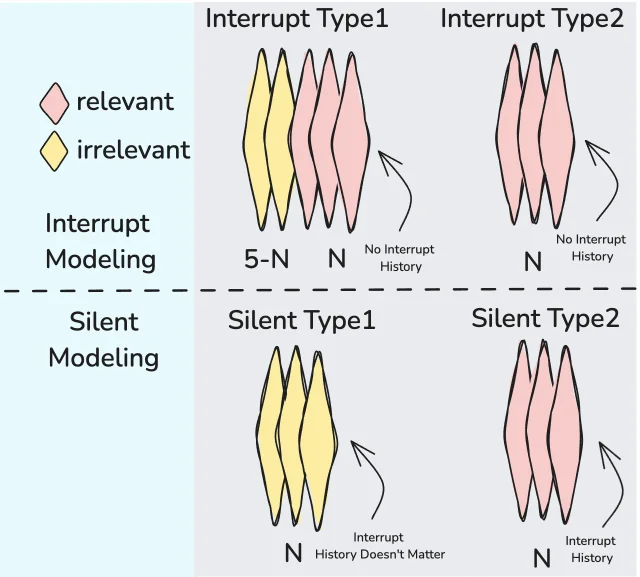
- 核心方法机制:作者把主动决策拆成两种打断与两种静默,区别在之前有没有打断历史、当前片段是相关还是无关(对应能力是声音起始的检测、持续相关的触发、无关的抑制与重复的去除);先在反应式声音分类上做监督微调,再构造四类主动场景的监督实例,目标序列是「打断标记加回复」或「静默标记」,静默样本被下采样到与打断样本等量,以免模型学会一味沉默。
- 关键定量结果(含比较对象与口径):环境声音数据集上打断 F1 99.6%、静默 99.7%,四种状态召回分别 99.8%、100%、99.4%、100%;零样本基线在抑制无关一项上只有 59.9%、去重一项 0.2%。换到嘈杂的厨房音频,打断 F1 最高 67.5%,但声音起始召回只有 10.1%。流式评测平均响应延迟 3.5 s。加入重复去除的训练让这一项召回提高约 10 个百分点。
- 证据强弱与复现边界:单一骨干模型,环境声音数据集做了五折但迁移集只有一次评测,没有种子方差、区间与显著性;唯一的消融只写了约 10 个百分点没有表格;没有与听障用户的真实研究。无代码、数据与模型发布,只有第三方数据集链接。
- 对目标研究线的连接点:命中生成式音频接口层里「该不该出声、什么时候出声」这个问题,属于可穿戴场景的早期范式验证。
- 结论与阅读建议:值得扫读;范式成立,离实用还有距离。
- 入口:栏目正文 · arXiv
5. Scaling Forced Alignment to End-User Devices(arXiv:2609.21145,邻近跟踪·其他/综合 NLP)
- 研究问题:强制对齐的显存占用随输入长度平方增长,怎么把它变成常数并提速,让终端设备也能处理几小时的长音频且结果不变。
- 改动位置(维度):只改算法实现。把分治递归引入维特比对齐,并用正态近似先验做长度缩放剪枝。
- 核心方法机制:在子问题缩到 1KB 时停止递归,实现原地常数内存的维特比。把语音与文本的对齐建模成受约束随机游走,用中心极限定理给单个字符对齐位置一个正态先验,搜索窗口宽度随长度平方根缩放,并用并集界校正置信度、把插入与删除分开估计。
- 关键定量结果(含比较对象与口径):3 小时输入的峰值内存从 140 至 144 GB 降到 5.2 MB,CPU 用时 271.3 s;对照的图形处理器实现用 220.4 s 但要 144 GB。加剪枝后 57.2 s,输入超过 20 分钟时再快约 2 倍,且 98% 以上用例保持对齐精度。未剪枝版本与各基线的完全一致率:本方法 100%/100%/100%,Kaldi 67.5%/93.8%/69.6%,另一个工具全部为 0%。支持最长 16 小时输入。
- 证据强弱与复现边界:十次重复与 p<0.05 的组间比较都给了,这在系统类工作里不算常见;但剪枝的准确率表没有报种子与方差,语料只有两个自建集加一个公开集,其中一个自建集属宗教口译域,外推有限;摘要写 140 GB、正文写 144 GB,口径不一致。代码仓库可打开、含源码与许可证,但没有发布到包索引上,只能源码安装;数据要自备。
- 对目标研究线的连接点:命中长程任务的数据与评测基础设施,长音频做时间戳切分时会直接受益。
- 结论与阅读建议:值得扫读,需要给长音频打时间戳的团队可以直接拿它替换现有实现。
- 入口:栏目正文 · arXiv
6. Enhancing Audio Reasoning via Semantic Summary Prediction(arXiv:2609.20849,邻近跟踪·语音语言联合与音频文本)
- 研究问题:能不能用训练期的正则把音频语言模型的潜在状态锚定到最终结论上,在推理期不增加任何成本地提升零样本音频推理。
- 改动位置(维度):只改训练目标与序列结构。在音频与提示之后、思维链之前插入一个寄存器标记,用结论句的嵌入做余弦对齐。
- 核心方法机制:训练序列是问题、音频、选项、寄存器标记、思维链、结论;把结论句过冻结的句子编码器得到目标向量,用余弦距离把寄存器标记的末层隐状态对齐过去,总损失是交叉熵加 λ 倍对齐损失。自定义因果掩码让后续 token 看不到该标记,推理时整段丢掉,因此不增加参数与延迟。
- 关键定量结果(含比较对象与口径):13B 模型零样本上,一个音频推理基准 58.03±1.50、另一个 40.32±0.57,对照监督微调是 54.65±0.34 与 38.15±0.37;监督微调加思维链的零样本只有 18.03±0.36 与 12.32±2.31。λ 取 1.0/2.0/3.0 对应 57.73/58.03/57.60。
- 证据强弱与复现边界:给了标准差但没说明种子数(注意力分析处写 6 个种子),正文用「显著」却没有任何显著性检验,这是本篇最该打折的地方;只测单一骨干与两个基准,λ 与插入位置都不稳定,也没有独立的局限性章节。仓库质量好(Apache-2.0,含训练与评测脚本),项目页可访问,未发布微调后的检查点。
- 对目标研究线的连接点:命中音频理解侧的训练方法,可迁移到语音生成的条件建模。
- 结论与阅读建议:值得扫读,方法简单、仓库可用,但把「显著」二字忽略掉再看结论。
- 入口:栏目正文 · arXiv
7. Reusing Latent Speech Representations for Query-Conditioned Topic Localization in Transcripts(arXiv:2609.21844,邻近跟踪·语音语言联合与音频文本)
- 研究问题:给定一段长语音的转写和一个主题标题,能不能复用识别编码器的内部状态来预测最贴合查询的句子跨度。
- 改动位置(维度):只改定位器的输入表示。把识别编码器的句级语音表征投影后与文本句向量融合,再交给既有的定位网络。
- 核心方法机制:离线按语音活动切块(不超过 30 秒)送识别,句子按对齐区间取编码器某一层的帧并池化,比较均值、均值加标准差、边界等多种池化;文本与语音投影到 128 维后用求和、拼接或门控融合,在线部分只训练投影、融合、编码与定位几层,识别与文本编码器全程冻结,融合后的在线参数量只有 37.2M。
- 关键定量结果(含比较对象与口径):长新闻语料上文本基线到加语音后,精确匹配从 45.26 升到 69.11、R@1@0.5 从 72.92 升到 79.66;另一个语料上精确匹配从 13.88 升到 20.56;换一种定位器从 35.34 升到 61.97。融合方案里均值加标准差配门控最好;把识别器换成 Canary,精确匹配的增益是 18.23(文本 46.50 升到 64.73),换成 Whisper 是 23.85;换用专用语音编码器的方案精确匹配 67.00,还要多跑一遍编码。
- 证据强弱与复现边界:两个训练集加两个跨域集、两种定位器、完整消融;没有种子、区间与显著性,增益属小到中等,跨域的一个语料上变弱且换定位器后 R@1 下降;声学线索那一节的结论来自单人听 20 段的主观打分。论文声明发布评测代码与检查点,实测仓库只有 3KB 的说明文件与许可证,README 写明「正在准备发布」,代码、检查点与数据抽取脚本都不存在。
- 对目标研究线的连接点:命中长程任务的按需定位与离线索引成本结构。与播客只有一处间接关系:所用语料的输入侧包含播客类音频,对象本身不是节目级。
- 结论与阅读建议:值得扫读,关心语音表征复用的可以看细节;关心可复现性的按邻近跟踪对待。
- 入口:栏目正文 · arXiv
8. Transsion's Speaker-Attributed Multilingual ASR System for the MLC-SLM 2026 Challenge(arXiv:2609.20833,邻近跟踪·语音语言联合与音频文本)
- 研究问题:在没有分段与说话人标注的多语言对话里,如何级联产出带说话人属性的转写并压低官方指标。
- 改动位置(维度):只改级联系统的组合方式,在日志、识别与时间戳三个模块之间加任务定制微调与融合策略。
- 核心方法机制:说话人日志用局部到全局的两段式:帧级活动检测加多类交叉熵处理重叠,再用聚类做全局归属。识别用 30B 级别多模态模型做两阶段低秩适配;另用一个 1.7B 识别模型加辅助时序头产出时间戳。融合按时间重叠把词分到日志段,0.3 秒内找最近段兜底,最后按时间序拼成带说话人的转写。
- 关键定量结果(含比较对象与口径):官方评测指标从 22.78% 逐步降到 16.40%、16.01%、15.72%、15.41%,端到端微调的参考方案是 16.27%。训练数据约 2,100 小时、14 种语言、21 个变体,每变体约 100 小时。
- 证据强弱与复现边界:只有官方单一评测集上的逐步消融,没有种子、区间与显著性;名次是自述;模块之间没有交叉消融,几个阈值没有敏感性分析;依赖 30B 大模型,成本高;时间戳用伪标签训练,错误会传播。
- 对目标研究线的连接点:命中长音频与长对话的数据处理管线,指标定义对多说话人转写任务有参考价值。
- 结论与阅读建议:邻近跟踪,按连接点取用;这是赛题系统报告,做长音频对齐时可以对照。
- 入口:栏目正文 · arXiv
音频评测、数据与复现
最后六篇分两类:一类在改音频与语音的评价指标,另一类在把数据与复现的账算清楚。
1. GenTraceBench: A Benchmark for Tracing Audio Deepfakes Across Pre- and Post-training Stages(arXiv:2609.21738,直接命中·安全、隐私与深度伪造音频)
- 研究问题:从基础语音合成生成器身上学到的取证指纹,在生成器经过监督微调或偏好优化之后是否还有效。
- 改动位置(维度):只改评测协议。固定提示集,把五个架构组合成 16 个预训练与后训练变体,在基础生成器上训练、在适配后代上测试。
- 核心方法机制:固定 3,108 条提示,跨 16 个变体合成 49,728 条语音,后训练包含直接偏好优化、监督微调、偏好优化再接组相对策略优化,以及分阶段数据混合;取证系统用同一骨干,另用两个模型复核;任务分二分类检测、闭集归属与开集验证三种。
- 关键定量结果(含比较对象与口径):检测的 pooled 准确率 99.5%、等错误率 1.0%。八个强化学习变体的归属平均只降 0.13±0.23 个百分点,而只换数据组合的某个变体掉了 10.15±0.97 个百分点;某架构的监督微调降 0.64±0.06。开集验证里,多镜头注册把监督微调条件下的等错误率从 44.4% 降到 11.0%,而只换数据组合的条件仍在 45% 以上。
- 证据强弱与复现边界:49,728 条合成语音与 1,556 条测试集是受控设计的底账,主骨干报告三个种子,另两个复核骨干只有单种子,配对自助区间对强化学习与监督微调条件都包含零;只测了一种监督微调配方,评测语料是干净的中英双语,某变体的漂移与音质损失混在一起无法分开。全文两处写「将会发布」,摘要页与全文都没有代码、数据与项目页链接,目前无法复现。
- 对目标研究线的连接点:直接命中 TTS 生成与评估。它把「后训练会不会毁掉指纹」变成可以逐变体核对的表,也顺带给出一个操作结论:注册环节多录几条,比换更强的检测器更划算。
- 结论与阅读建议:建议精读,核查受控结论的边界,同时记住入口缺失这一条。
- 入口:栏目正文 · arXiv
2. Rethinking Human-Aligned Evaluation: An Analysis of Semantic Metrics Beyond WER(arXiv:2609.21663,邻近跟踪·语音语言联合与音频文本)
- 研究问题:词错率是否真的跟踪人类对转写质量的判断,哪一类度量与人类偏好最一致。
- 改动位置(维度):只改评测协议。把成对偏好标注搬到英语朗读语料上,再用人类偏好给各指标排位。
- 核心方法机制:用四个识别系统对同一批语音产出假设,抽 1,000 组「参考加两个假设」的三元组,隐藏音频、随机顺序、强制二选一;119 名标注者分 50 批完成;随后用人类偏好排名比较词错率、字错率、语义相似度与学习型度量,并扫描语言模型、层与池化方式。
- 关键定量结果(含比较对象与口径):标注者间一致性 Fleiss κ=0.3061,完全一致率 48.10%(随机基线 25%)。共识过滤后,词错率与人类一致率 75.47%、字错率 86.28%(McNemar p=9.03×10⁻¹²);最佳语义度量优于词错率(p=5.87×10⁻¹⁵),对字错率不显著(p=0.243),对最佳学习型度量也不显著(p=0.136)。
- 证据强弱与复现边界:有人类一致性、McNemar 检验与多层消融,属于中上强度;但只有一个朗读数据集、四个识别系统,先按标注完全一致过滤,摘要提到词素音节文字而实验全是英语。数据可以下载(匿名仓库的评分表 256KB、1,000 行,音频要自备),指标代码、标注应用与配置脚本都没有发布,链接指向双盲匿名域名。
- 对目标研究线的连接点:命中 TTS 与播客评估里「该用什么指标」这个问题。可搬的结论有两条:字错率默认比词错率更贴人类判断;成对偏好加一致性过滤这套流程可以直接用于音频生成的评测。
- 结论与阅读建议:值得扫读;不要把它读成「语义度量显著优于字错率」,原文的实验不支持这个说法。
- 入口:栏目正文 · arXiv
3. Beyond WER: Entity and Disfluency Recall in Accented Conversational ASR(arXiv:2609.20828,邻近跟踪·语音语言联合与音频文本)
- 研究问题:以词错率为目标的识别系统会漏掉带口音对话英语里的命名实体与填充词,如何在不增加推理复杂度的前提下把两者都救回来。
- 改动位置(维度):只改训练数据与指标。用查询过滤提高训练集里的实体密度,并给模型加一路逐字稿输出,指标从词错率扩到实体与填充词召回。
- 核心方法机制:三阶段:先用启发式查询从生产日志里筛出实体密集的样本;再用模型生成参考转写、经人工核验得到金标;最后在 3B 级多模态模型上按区域做低秩适配,单次前向同时输出保留填充词的逐字稿与校正稿,并加一个可理解性布尔标志来抑制幻觉。
- 关键定量结果(含比较对象与口径):实体召回 79.5%–84.6%,对照基线 53.6%–55.2%;填充词召回 76.5%–87.9%,对照基线不足 5%;词错率 5.95%–10.00%。消融里两路输出的组合相对单路,在三个区域分别提高 4.19、2.84、2.76 个百分点,配对自助 10,000 次 p<0.0001,区间不含零。金标核验 750 条、识别测试约 6 千条,每区域一个适配器用单张 A100 训练约 6 小时。
- 证据强弱与复现边界:每区域 250 条人工核验、判官一致性 83.8%,是本期音频侧少见的核验强度;但每区域只有一个适配器、无种子,参考转写是模型银标;印度区域实体召回实际 79.52%,落在摘要宣称的 80%–85% 之外,同区域填充词的组合方式还低于单路。正文说训练代码将会公开,摘要页与全文都没有仓库或数据地址,生产日志、权重与金标都没有发布。
- 对目标研究线的连接点:命中的是「把指标从词错率扩到实体与填充词召回」,这一条可以直接平移到语音生成与播客场景要评的字段设计上。
- 结论与阅读建议:值得扫读,引用时注意银标参考与单适配器这两条限制。
- 入口:栏目正文 · arXiv
4. The Internet Archive Music Dataset(arXiv:2609.20870,邻近跟踪·数据集、基准与评测)
- 研究问题:缺少规模大、许可清楚、可公开下载的音乐文本对,音乐理解与生成模型因此难以做可复现的训练与对比。
- 改动位置(维度):只改数据来源与标注流水线。从公开档案里抓取声明为开放许可的音频,自动过滤与标注。
- 核心方法机制:抓取音频后先用语言模型给音乐相关性打分过滤,优先下载无损格式,剔除超过 10 分钟的文件,按文件名与时长去重,再用音乐数据库做模糊匹配;切成 30 秒片段,用音频语言模型生成基础描述,再用探针与档案元数据经语言模型聚合成最终描述。
- 关键定量结果(含比较对象与口径):4.1M 条描述、34.8k 小时、548k 个源文件;30 秒片段的自动描述质量分 55.61±0.77,对照另一数据集 52.29±0.66,但另一个评测基准上 65.43±1.77 低于对照的 69.80±1.44;10 秒片段上也低于对照数据集。主观方面:正确性 4.24±0.13、完整性 4.35±0.11(满分 5,100 条样本、20 人)。
- 证据强弱与复现边界:客观侧做了 1,500 条抽样与 95% 区间;主观侧只有 100 条、20 人、没有一致性检验与多种子;许可来自用户自报且多数为非商业,用之前要逐条核对;论文写 4.1M 与 548k,仓库与数据页显示 4.25M 与 93k 条目,口径不一致。配套网站仍是匿名占位页,四项统计都显示为空值,并写着「很快发布」;代码仓库与数据页实测都可访问(MIT 与开放许可,数据以拼花格式内嵌音频、可流式读取),主观评测页只返回一个输入姓名的界面外壳,分数无法复核。
- 对目标研究线的连接点:邻近跟踪音频数据与复现这条线。对播客方向来说它是一个反向信号:这条流水线按设计排除非音乐内容:播客、电台与电视被当作噪声滤掉,另有超过 10 分钟一律剔除的时长先验。
- 结论与阅读建议:建议精读做法与许可核对方式,规模数字以数据页为准。
- 入口:栏目正文 · arXiv
5. Investigating the Performance and Energy Costs of Replicating Band-Split RNN for Music Source Separation(arXiv:2609.21918,邻近跟踪·音乐信息检索与音乐生成)
- 研究问题:原论文没有发布完整代码,其它方案又依赖私有数据或超大算力;在可负担的算力下复现这条流水线要花多少代价,这些代价能不能折算成可比数字。
- 改动位置(维度):只改复现路径与记账方式。从零实现整条流水线,逐项消融设计选择,并用两种口径统计能耗。
- 核心方法机制:按原论文结构实现频带分割、双向长短期记忆残差块与子带掩码,训练损失是时域与频谱实虚部的组合;系统考察批大小与学习率、训练轮数与耐心值、数据生成方式与推理方式,用两种分离质量指标评测,用两种工具统计能耗。
- 关键定量结果(含比较对象与口径):原始论文在测试集上 8.24 dB,本次复现平均 7.42 dB,换用替代数据生成方式补回一半到 7.87 dB。加大模型规模(约 1.47 亿参数)能到 8.2 dB,能耗 230 至 321 kWh;把耐心值调到 30 能到 8.4 dB,能耗升到 354 至 495 kWh。整个项目总能耗 24.2 MWh(另一种口径更高),是最佳单模型的 53 倍、基础模型的 144 倍。
- 证据强弱与复现边界:数据集 150 首,三个种子,作者明确设定「平均差异小于 0.1 dB 视为不显著」,并给了十四行消融与两种能耗口径;主结果单次运行,只用了一个数据集,能耗里混着实现失误与额外实验,两种统计口径的结果差得不少。代码仓库(MIT、74 次提交)与权重存档(开放、含校验值、约 4.7GB)都可达,数据公开。
- 对目标研究线的连接点:邻近跟踪音频复现这条线。它的方法论价值在于把「有没有完整代码」折算成 MWh 和美元量级的账,这套记账方式可以搬到任何音频模型的复现评估上。
- 结论与阅读建议:建议精读,重点看复现差距的来源、能耗口径的差别,以及仓库与权重的可复现链路。
- 入口:栏目正文 · arXiv
6. Composer2Vec: A Continuous Embedding Space of Composer Style Learned from Symbolic Melody Generation(arXiv:2609.20893,邻近跟踪·音乐信息检索与音乐生成)
- 研究问题:作曲家条件生成模型学到的作曲家嵌入,除了当生成用的内部表示,是否本身构成一个可解释的风格连续空间。
- 改动位置(维度):只改分析对象。把训练好的嵌入矩阵拿出来做统计与几何分析,与通用音频文本嵌入对照。
- 核心方法机制:在符号旋律数据上清洗(二值钢琴卷、统一调性,用音节对齐率与音符时长种类数剔除自动转谱噪声),切成 8 小节片段得到 277,718 段;训练两层、128 维的因果自注意力模型,条件为作曲家独热嵌入逐帧相加;对 124×128 的嵌入矩阵做主成分分析、轮廓系数、降维可视化与向量算术,并与通用音频文本嵌入做同样的分析。
- 关键定量结果(含比较对象与口径):第一主成分解释 21.5% 的方差,与作曲家出生年相关 r=−0.884(p<0.001,n=123;嵌入矩阵含 124 位作曲家,该相关分析的样本是 123),优于通用音频文本嵌入的 +0.532 与 −0.679;风格时期的轮廓系数 0.0110,置换检验 2,000 次后 p<0.001,对照的通用嵌入不显著(p=0.548);向量算术的最近邻命中对,正文写余弦 0.787、表格写 0.865。
- 证据强弱与复现边界:样本量够大,置换检验也做了;但只有一个种子、没有重复训练与规模消融,清洗阈值靠目视拟合,轮廓系数本身极低,风格时期的标签彼此重叠,两处余弦值互相矛盾而论文没有解释。全文唯一的外部链接是数据来源站点,没有代码与数据发布。
- 对目标研究线的连接点:邻近 TTS 生成与评估。可迁移的是一套探针方法:把生成模型内部的说话人或风格嵌入拿出来,检验它能否被解释成连续的风格轴,这个方法本身在语音侧同样适用。
- 结论与阅读建议:值得扫读,注意单种子、清洗阈值未泛化与内部余弦值矛盾这三处限制。
- 入口:栏目正文 · arXiv
缺口与核验说明
播客生成与节目级评估,本期仍为零直接命中。 本期做了四层核实:① 对三个允许栏目的全部 123 篇正文做中英关键词扫描(播客、节目、双人对话、多人对话、多说话人、长音频、电台、有声书、podcast、episode、two-speaker、multi-speaker、long-form、dialogue 等),直接命中的对象为零;② 逐条清点语音与音频栏目 9 篇的六个分区,没有一篇以节目级音频为对象;③ 把该账号 9 月 19 日至 20 日发布的全部条目逐条枚举(该账号在周末发布了单篇论文导读与行业稿,属于非允许栏目),没有一条涉及播客;④ 顺带发现一条反向证据:本期收录的音乐数据集论文主动把播客、电台与电视内容当噪声滤掉,并用时长先验剔除超过 10 分钟的文件。候选池被频道配置限定在这三个栏目内,改用其他出版社或聚合器会越过白名单,因此这个问题出在来源侧的选题口径,本期不存在不越界的替代路线。
可迁移的仍是接口层三件,且都停在接口层,引用时不要写成节目级结论:多说话人长音频的切分与说话人归属(本期新增一篇赛题系统报告,指标是带说话人属性的字错率)、全双工语音前端的工具委派与低延迟回吐(本期一篇开源权重可下载,一篇是带负结果的混合控制器)、以及「何时该出声」的配对评测协议(本期一篇把打断与静默各拆成两类的范式工作)。
TTS 生成与评估本期有 3 篇直接命中。 一篇是全双工语音到语音模型的生成侧(权重可下载),一篇是级联语音代理的轮次控制(含负结果),一篇是后训练之后取证指纹是否存活的受控基准。生成侧的波形合成与声码器仍是零直接命中。
入口实测中,声明与实际对不上的地方。 以下状态由本期逐条打开确认。内容完整、与论文相符的:RecreationWorld 的代码仓库与数据页(MIT,含源码与 250 条测试)、GameASG-Bench 的仓库(Apache-2.0,含题面与检查)、全双工语音到语音模型的权重页(非门控,含权重文件)、级联语音代理的运行时仓库与合成数据(仓库里没有许可证文件,人工录音语料登记为受限未公开)、语音推理那篇的仓库与项目页(Apache-2.0)、终端强制对齐的源码仓库、片上设计的仓库(MIT,含任务、测试台与轨迹)、裁判小组那篇重定向后的仓库(代码 MIT、数据 CC BY)、音频分离复现的仓库与权重存档、音乐数据集那篇的仓库与数据页。声明了发布物但没有地址的:后训练指纹基准(两处写「将会发布」,摘要页与全文零链接)、弃权奖励那篇(脚注仓库实测 404)、自进化设计系统那篇(附录明确不发布任何资产)、个性化提示词那篇(声明接受后发布画像池与脚本,当前无链接)、记忆决策控制器那篇(称按 MIT 发布,无任何可定位地址)、长期记忆视图那篇(声明接受后发布)、轨迹蒸馏那篇(只有无法访问的匿名补充包)、验证器协同训练那篇(唯一可打开的数据集是第三方的竞赛题数据,方法代码未发布)。地址有效但内容为空或不是本文产物的:人机协作生产率那篇的仓库(0 字节、无文件)、联合信用传播那篇声明的仓库(可打开,但里面没有该方法的任何内容,README 全文一次也未提及)、语音主题定位那篇的仓库(只有说明文件,README 写着「正在准备发布」)。此外有两处内部数值口径不一致已在正文标注:一处是长上下文那篇的摘要与表格(+13.5% 对约 +10.9%),一处是弃权那篇的摘要与正文(+12.8% 对 +0.173)。
本期没有收录的 85 篇。 三个栏目 123 篇里,未进入本期的部分主要分布在知识图谱与临床文本处理、多语言与低资源方法、多模态理解的应用场景、机器学习与表示学习的基础工作、以及大量与四条目标线没有可迁移接口的应用类工作。逐条清点后按同一价值门槛排除,理由只有一个:它们回答的问题不在本频道盯的四条线上,与论文本身的好坏无关。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.