在 Blender 里搭 3D 场景有多难:BlenderWorld 223 道题,榜首 79.9 分,全部评分项通过的只有 42.2%
阿里 Qwen 团队发布三维创作基准 BlenderWorld:223 道题要求智能体在 Blender 里交出还能继续编辑的工程文件,13 个前沿智能体同题各跑一次,榜首 79.9 分,全部评分项通过的任务只有 42.2%,共同短板落在三维结构与接触约束上。

阿里 Token Hub 联合浙江大学、香港中文大学、复旦大学与南洋理工大学,在 10 月 16 日发布了一份三维创作基准:BlenderWorld。1
它考的事情很具体。智能体读一份自然语言需求,配上参考图片或视频,然后在 Blender 里把场景搭出来。1
交付物是一个还能继续编辑的工程文件,外加任务要求的渲染图和视频。1
13 个前沿智能体在同一批 223 道题上各跑一次。榜首 GPT-6-Astra 综合 79.9 分,第二名 Opus-5 是 73.0 分。1
另一组数字更能说明难度:把一道题的评分项全部拿到才算通过,这样的任务占比最高的也只有 42.2%。1
为什么把「还能继续改的工程文件」当成评分对象
已有的 Blender 基准大多把范围收得很窄。3DCodeBench 的 212 道题以单个物体建模为主,BlenderBench 只有 27 道相机与场景编辑任务。1
SceneActBench 做到了 520 道,评价目标仍是预设好的几何量。1
真实需求不长这样。一份装修提案、一张产品展示图、一段课堂演示动画,都不存在唯一的正确资产;同一份简报可以对应好几个都算合格的实现。1
这里留了一条捷径。只按渲染图打分的话,把参考照片里的东西抠出来贴在一张正对相机的平面上,画面看上去可以很像。1
BlenderWorld 把交付物本身变成评分对象:2,651 条评分项里有 1,544 条要打开提交的工程文件量内部结构,只有 1,107 条靠看渲染图判断。1
223 道题摊开是什么样
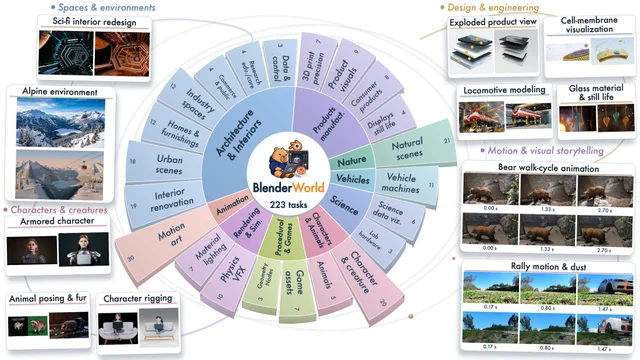
223 道题分在 9 个大类、22 个子类里,对应 16 个应用场景,涵盖分镜预演、产品发布、游戏资产、电商图、科学插图与课堂演示。1
输入分三种:78 道只有文字,130 道带参考图,15 道带参考视频,合计 145 道是多模态任务。1
另有 59 道题附了规格文件,28 份 Markdown、20 份 YAML、11 份 JSON,内容写着尺寸、材质清单或相机设置。需求正文会明确指向这些附件。1
评分项一共 2,651 条,每道题 6 到 22 条、平均 11.9 条。每条只有通过与不通过两种结果,权重按重要程度分 3、2、1 三档,其中 83.3% 的条目落在最高档。1
按关注点分布,Function(功能与可编辑性)660 条、Geometry(几何)446 条,两类合计占 41.7%。1
Physics(接触、支撑、碰撞与运动)124 条,数量明显少一截。1
分是怎么打出来的
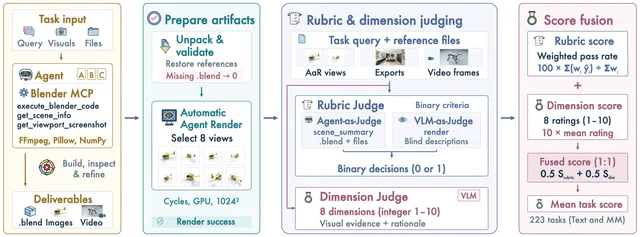
评分链路有四段。第一段是自动渲染:一个渲染智能体打开提交的工程,自己挑 8 个和题目相关的视角,用 Cycles 按 1024×1024、64 采样渲出来,每个视角最多重渲两次。1
它只能调相机取景和渲染设置,模型、材质、光照、动画都保持提交时的样子。1
第二段按证据类型把评分项分流。需要看外观、空间布局和运动的条目交给视觉语言模型当评委。1
需要查内部结构的条目交给智能体当评委,它直接打开工程文件量尺寸、数部件、验拓扑,也能回看画面。1
第三段是另一套打分:同样由视觉语言模型沿八个维度各给 1 到 10 分——场景还原度、物理合理性、风格与配色、真实感、空间布局、比例尺度、光照与材质、完整度。1
最后把两边各取一半相加:总分 = 0.5 × 加权通过率 + 0.5 × 维度均分 × 10。也就是说,79.9 分里有一半来自观感质量。1
渲染、评分项裁判、维度裁判这三个角色,全部由 gpt-5.6-terra 承担。1
13 个系统的成绩
| 系统 | 综合分 | 加权通过率 | 视觉维度分 | 全部通过的题目占比 |
|---|---|---|---|---|
| GPT-6-Astra | 79.9 | 87.3 | 72.6 | 42.2% 1 |
| Opus-5 | 73.0 | 80.9 | 65.1 | 25.6% 1 |
| GPT-5.6-Sol | 67.7 | 74.7 | 60.7 | 15.7% 1 |
| DeepSeek-V4.1-Flash | 65.7 | 72.0 | 59.4 | 11.7% 1 |
| Qwen3.8-Max | 60.6 | 65.9 | 55.3 | 10.3% 1 |
| GLM-5.3-Flash | 59.7 | 64.8 | 54.4 | 6.28% 1 |
| Grok-4.6 | 57.0 | 61.4 | 52.7 | 6.73% 1 |
| Opus-4.8 | 57.0 | 60.2 | 53.7 | 5.38% 1 |
| Seed2.1pro-0915 | 51.3 | 54.9 | 47.7 | 3.59% 1 |
| Qwen3.8-27B | 47.7 | 50.0 | 45.5 | 1.35% 1 |
| Kimi-K3 | 46.5 | 47.9 | 45.2 | 1.79% 1 |
| Gemini-3.8-Flash | 34.2 | 29.8 | 38.5 | 0.45% 1 |
| MiniMax-M3 | 31.8 | 28.9 | 34.7 | 0.45% 1 |
榜首领先第二名 6.9 分,差距在带图或带视频的任务上更大。1
多模态部分 GPT-6-Astra 是 80.7,Opus-5 是 72.1;纯文字的 78 道题上两者是 78.6 与 74.8。1
合规与观感两边不同向。GPT-6-Astra 的加权通过率 87.3、维度分 72.6,属于要求完成得比画面好。1
Gemini-3.8-Flash 反过来,通过率 29.8、维度分 38.5。1
论文拿 2,899 份产出算了这两个分数的相关性,Spearman ρ 只有 0.630,说明它们衡量的确实是两件事。1
换个口径量同一件事:加权通过率达到 90% 的任务数,GPT-6-Astra 有 143 道,全部通过的只剩 94 道;Opus-5 是 85 道对 57 道。1
融合权重也扫过一遍。把合规那一半的权重 λ 从 0 调到 1,13 个系统的排序基本不动,只有 Grok-4.6 与 Opus-4.8 的第 7 名互换。1
分类别的排名里有一处逆转:GPT-6-Astra 在 9 个类别里领先 8 个,唯独 Rendering & Simulation 输给 Opus-5,71.1 对 74.5。1
失败长什么样
论文把几种失效追到了具体的工具调用记录。1
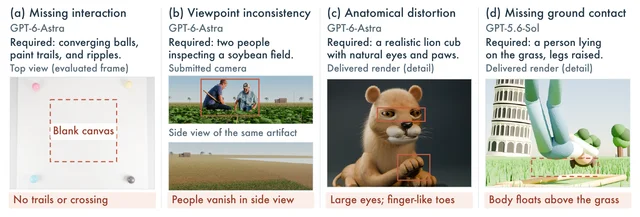
第一类是动态交互缺失。有一道题要求球体相撞,留下颜料轨迹和涟漪,GPT-6-Astra 把球和画布摆好了,轨迹和交叉点一个都没有。1
第二类是视角不一致,也是最能说明问题的一格。另一道题要求画两名正在查看豆田的人,GPT-6-Astra 把参考图里的人抠出来,各自贴到一张朝向相机的平面上。1
提交机位下两个人看着正常。换成侧视图,人整个消失。1
第三类是细部几何失真。一只狮崽的爪子被做成了手指的形状,眼睛也明显偏大。1
第四类是接触约束被违反。有一道题要求一个人躺在草地上、鞋尖在画面里与远处的塔对齐。1
GPT-5.6-Sol 用代码标出对齐基准,把投影误差压到 1.19 × 10⁻⁷,还加了「误差不得超过 10⁻⁶」的守卫。它没检查人是否踩在草地上,交付画面里人悬在草坪上方。1
还有一种是自查量错了目标。需求写的是 150 毫米实木腿加黄铜脚轮,Opus-5 把「150 毫米」当成含脚轮的总高,建了 102 毫米木料加 48 毫米脚轮。1
Opus-5 拿自己的脚本量「地面到框架」的高度,报 150.0 毫米通过。冻结的场景检查单独量了木料,102 毫米,比要求短 32%。1
四类失效落在同一个位置:三维结构、物理接触、跨视角的一致性。它们在单张渲染图上不容易当场看出来。1
每任务看多少次图,与它拿多少分
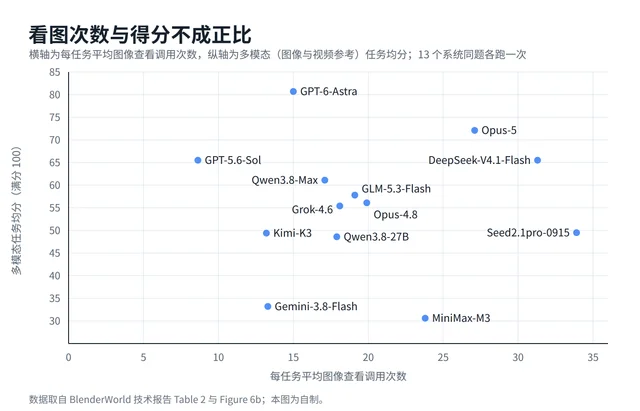
一个自然的猜想是:多看几次渲染结果、多改几轮,分数应该更高。把 13 个系统的两个数放进同一张图,看不出对应关系。1
Seed2.1pro-0915 平均每道题看 33.9 次图,DeepSeek-V4.1-Flash 31.3 次,排在 13 个系统的前两位,多模态分是 49.5 与 65.5。1
GPT-6-Astra 只看了 15.0 次,多模态分 80.7。1
交互风格本身分成两路。Opus-5 每道题平均跑 45.5 次 Blender 执行、158 个回合,输出 24.1 万 token。1
GPT-6-Astra 是 23.3 次、45.6 个回合、8.45 万 token,分数反而更高。1
论文自己给这条划了边界:这是聚合统计,只说明有多少次看到反馈的机会,推不出每个系统用视觉反馈的效率。1
这份榜单的边界
评委本身是模型,而且只有一个。这份榜单全部由 gpt-5.6-terra 产生,没有第二套评委的对照。1
官方为这个选择做了一次人工校准。150 对同输入产物,每对由三位评审打分,去掉三人各投一票的 3 对,剩 147 对可用。1
GPT-5.6-terra 的总分与多数人偏好一致率 82.99%,Gemini-3.8-Flash 77.55%,DeepSeek-V4.1-Flash 76.87%。1
把两份产物平均分差小于 10 分的 70 对单独拿出来,三个评委的一致率掉到 68.57%、58.57%、55.71%。1
分数挨得越近,评委与人的判断越对不上。1
三个评委之间只比了与人的一致率,没有各自把这 223 道题重跑一遍,所以榜上没有换评委后的读数。1
每个系统每道题只跑一次,没有重复运行,也就没有方差估计,相邻两名的差距要看这个前提。1
这份榜单评的是完整智能体。GPT-6-Astra 与 GPT-5.6-Sol 跑在 Codex 上,另外 11 个跑在 Claude Code 上。1
工具集、运行环境和推理档位都算进成绩。1
报告给了每任务的回合数、输出 token 与工具调用次数,没有对应的金额。1
缺的是什么
成本一行空缺。回合数、token 数、工具调用都在表里,折成钱需要一个价格基准,报告没有给。1
重复运行与第三方复现都还没有。发布方自己把重复运行列进了扩展计划。1
几何真值的缺位是设计前提。需求是开放式的,同一份简报允许多解,判分只能靠写出来的评分项。1
论文把体素交并比这类几何指标列进了下一步。1
下一个能核的节点
命令行从 bw download、bw verify、bw prepare、bw pack-submission 到 bw evaluate 一条链走完。5
门槛写得明确:生成要用 Blender 4.2.10;评测要 Node.js 22.17.0、ffmpeg,加上一个支持视觉的模型端点与对应的 API key。5
评测会真的调用模型服务,费用由使用者承担。5
模型侧的下一个读数写在扩展计划里:给智能体评委加上直接操作工程的工具,去测绑定、动画和仿真能不能按预期工作。1
任务侧要补上局部编辑、网格修复、拓扑优化、重拓扑这类更接近生产流程的题目。1
平台侧则要扩到 Maya、3ds Max 与其他操作系统,并让模型用图形界面操作 Blender。1
国内网络下取数据集更方便的入口是 ModelScope 镜像。6
References
- 1
- 2BlenderWorld 项目页
blenderworld.github.io
- 3QwenLM/BlenderWorld
github.com
- 4Qwen/BlenderWorld 数据集
huggingface.co
- 5BlenderWorld 评测指南
github.com
- 6ModelScope 上的 BlenderWorld
modelscope.cn
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.