Gemini 4 Argon 全面开放:19 项里输 5 项,两道安全门槛写着「无法排除」
解读 Google DeepMind 2026 年 10 月 13 日把 Gemini 4 Argon 向所有人开放:拆开首份模型卡里 19 项基准的胜负与两道「无法排除」的安全门槛,并逐项标出官方那批工程与科学结果里哪些能在公开仓库里核到。

2026 年 10 月 13 日,Google DeepMind 把 Gemini 4 Argon 向开发者、企业、科研人员和消费者开放了。1
上一次它露面是 9 月 30 日,当时只经 Fairwind 计划发给可信的网络防御者。Gemini API 里查不到这个模型,官方的模型卡索引里也没有它。这两处今天都补上了。1
Google 同一天还发了一份 14 页模型卡、两条配套博客和一份长解码文档。模型卡是 Argon 的第一份,19 项基准的胜负也在里面。2
今天起,几个入口都能拿到它
开发者走 Gemini API 的付费档,在 AI Studio 与 Android Studio 里调用;企业侧走 Gemini for business 和 Google Antigravity。1 普通用户要有 Google AI Ultra 或 Pro 订阅,才能在 Gemini app 和搜索的 AI Mode 里用它。1
科研人员另有一条通道。Google 拿出 Antigravity 的最高用量档,免费给 10,000 名科学家用 6 个月,滚动开通,需要申请。1
价格写得很明确:引导期每百万输入 token 2 美元、输出 10 美元,缓存输入再减 95%。引导期在 2026 年 11 月 30 日结束,之后回到每百万输入 4 美元、输出 20 美元。1 脚注还限定了一句:这只适用于面向公众开放的 Argon。1
网络防御者仍然走分开的一条路。Fairwind 计划本身已经有 650 多个伙伴,这次是「开始向另外数百个伙伴扩展」。3 这条通道在 API 里对应另一个模型 ID:
gemini-4-argon-cyber-permissive,用在经 Fairwind 批准的网络安全负载上。41M 是输入、思考、输出共用的一个池子
官方对这一代的说法是「业界领先的 100 万 token 统一输入输出上限」。模型卡写得更细:1,048,576 个 token,由输入、思考与输出共同使用。2 输入占得越多,留给输出的就越少。
默认设置下的输出上限要低得多。单次请求的输出是 65,536 token,非流式的直连 HTTP 请求更低,32,768。45 在流式或非流式调用里把上限设到 65,536 以上,会直接返回 400 错误。5
要超过这个数得走另一条路,官方叫长解码。打开后台执行之后,服务端以 64K 为一跳,接着上一跳停下的地方继续生成,直到模型写完或用完设的上限。5 这条路单次交互最长可以跑 24 小时,代价是必须打开
store: true,交互会留在服务端。5还有一条客户端路径:由你的代码一跳一跳地发起续写,用服务端返回的
continuation_token 接着写。走这条路,交互不留在服务端;代价是每次只能续 64K(流式)或 32K(非流式),整段限时 20 分钟。5 官方 SDK 默认帮你处理这个 token,可以用 automatic_continuation=False 关掉。4官方示例里设的
max_output_tokens 是 262,144,而 1,048,576 是整个共享池的天花板。两个数字都对,指的是不同位置:都要先开后台执行才够得着。5模型卡第一次给出对照列
这是 Argon 的第一份模型卡,14 页,标注为 Published October 2026。2 里面那张评测表有 19 行,时点是 2026 年 10 月,列了四组读数:Argon,加上 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5 三个对照。2
19 行里,Argon 领先 13 行,落后 5 行,1 行并列。2
落后的五行里,两项是编码基准:FrontierSWE v2 拿 55.0%,Astra 65.5%;Terminal-bench 4.0 拿 57.4%,Opus 5.5 66.4%。2
另两项在训练与科学侧:PostTrainBench 45.3%,Opus 5.5 49.3%;Terminal-Bench Science 0.1 拿 57.6%,Astra 68.1%。2
赢下来的那些里,Vals Index 那一项能在公开榜上核到。榜单今天有 47 条模型记录,Argon 以 68.90% 排第一,第二是 Claude Sonnet 5.5 的 67.04%,第三是 Opus 5.5 的 66.97%。6 同一页给出每次测试成本 15.68 美元,按 4 美元输入、20 美元输出折算,也就是引导期结束之后的价。6
有一行到今天仍然对不上。模型卡里 DeepSWE v1.1 给 Argon 的是 77.9%,同一行里 Astra 74.1%、Opus 5.5 74.2%、Fable 5.1 67.4%。2 而 DeepSWE 的公开榜仍停在 2026 年 9 月 22 日那一版,榜首是三个并列的 74%,列表里没有 Argon。7
安全段:两道「无法排除」,一道 14/15
模型卡按《前沿安全框架》(2026 年 4 月版)逐域给出判定。2
生物这一类,官方写的是「无法排除 Gemini 4 Argon 已达生物关键能力等级」。同一段的说明是:专家红队在其中两个场景里看到了相对网页基线的可测提升,模型给出的信息完整、准确、可用。2 因此他们为这项能力做了安全论证,并评估把残余风险压到该等级以下。2
失控这一类,判定是「无法排除已达隐匿与情境感知威胁等级」。支撑数字是模型通过了 15 项挑战里的 14 项。2
剩下四项写着没有达到:化学、放射与核的威胁等级被「以合理的置信度排除」,有害操纵的关键能力等级没有达到,机器学习研发的加速与自动化两项关键能力等级都没有达到。2
博客里另给了一组数字。外部生物红队只解锁了官方所测生物子任务的不到 1%;在一组对抗集上,违规回答减少了近一半。1 另外两个数字在编码与提示注入上:模型想抄近路的比例降到 2%;15 次自适应尝试下,间接提示注入的攻击成功率是 0.7%。1
工程四项,三项能在公开仓库里核到
博客用一批工程与科学结果说明 Argon 已经在干活。1 逐项看下去,它们留下的公开产物差别很大。
Chrome 那一项的读数是:Argon 帮团队把约 600 万行的浏览器功能目录从 Chromium 的四千万行代码里拆出来,跨数百个文件完成一次架构重构,把原本数月的工作压缩到数周。1 在 Antigravity 里,智能体提交的代码增加了 35% 以上,回滚减少近三分之一。1 这两组数字只出现在官方文字里,附的是一条 Chromium 问题单编号。1
ADK 那一项三样都能核。改动落在 google/adk-python 的一次提交里(
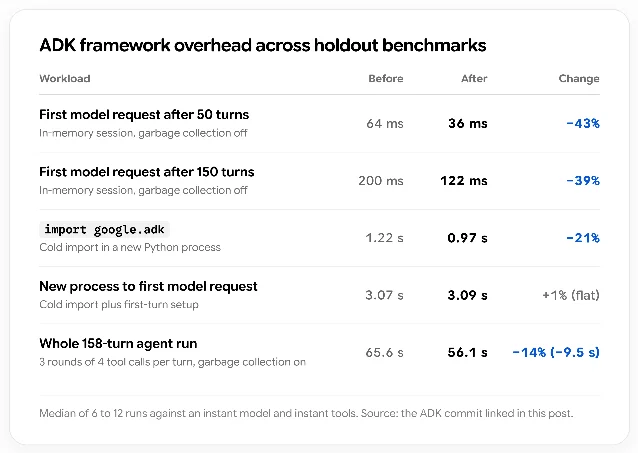
1754b3e,2026 年 10 月 7 日),22 个文件、新增 956 行、删除 101 行。8 提交说明的末尾写着「Argon generated these changes」。8读数和提交说明里的一致:50 轮之后首个模型请求从 64 毫秒降到 36 毫秒,150 轮之后从 200 毫秒降到 122 毫秒。8 冷启动导入从 1.22 秒降到 0.97 秒,新进程到首个请求则持平。8
整段过程是 11 小时无人值守。Argon 提了 6 项优化,维护者砍掉 4 项,最后只留会话复制与懒加载两项,一起进了那 22 个文件的改动。9
xTB 那一项的读数是结构预测快 2.3 倍、构象搜索快 1.8 倍。1 提交确实在公开仓库里:用博客给的筛选条件能找到三个 PR(1464、1465、1466),都在 2026 年 10 月 9 日开启,到今天仍是未合并状态。10 2.3 与 1.8 这两个倍数只写在官方博客里,PR 页面上没有。
Gemma 4 E2B 那一项说,几天之内把 vLLM 在 A100 上的端到端推理提到 2.85 倍,吞吐从约 37,900 token/秒 升到 108,000 以上。1 官方同时说明 token 完全一致、质量没有下降。1 对应的 PR 也在公开仓库:同一位贡献者从 10 月 5 日起开了 10 个,到今天 8 个还开着,2 个已合并——合并的那两个是 EmbeddingGemma 2 的配置整理,与提速无关。11
还有一项是三维可视化:官方说 Argon 在 Antigravity 里用多智能体循环做出了宝塔和赛车游戏的模型,这一项没有给数字。1
科学四项:一项有论文,三项只有官方自述
量子那一项给了两个数。把内部的 AlphaQubit 解码器改写成单一硬件内核之后,推理吞吐接近翻倍。1 另一个数是一个 arcsin 子程序:它用 Lean 形式验证过,相对已发表的量子 CORDIC 基线,时空开销降了 100 倍以上。1 两项都只有官方文字。
核聚变那一项能核到。博客说 Google 的团队与马里兰大学的 Matt Landreman 一起,给 Grad 猜想找到了更广的一类反例。1 对应的论文在 2026 年 10 月 5 日提交到 arXiv,编号 2610.07304,作者是 Opal Issan、Jonathan Citrin、Matt Landreman 与 Brendan Tracey。12 论文做的是给 Landreman 此前发现的两族解各加一个破坏对称性的参数,得到新的非轴对称解,参数取零时退回原来的解。12
罕见病那一项来自 Gamow Labs。在一组由真实临床与实验室数据派生的评测上,Argon 在 RareBench 的协助罕见病诊断上拿到 57%,在 LabBench 的湿实验推理上拿到 52.2%。1 两个榜的公开页面会随脚本加载结果,我访问时停在加载状态,只读到题量——RareBench 122 例、LabBench 20 项任务。13
机器人:87% 来自自家基准
机器人那一项给出了这批材料里唯一一个跨模型的新基准读数:ERQA 上 Argon 拿 87%,纯推理、关闭工具、400 例。14 同一张图上,Claude Opus 5.5 是 82.3%、GPT-6 Astra 是 81.0%、Claude Fable 5.1 是 74.0%。14
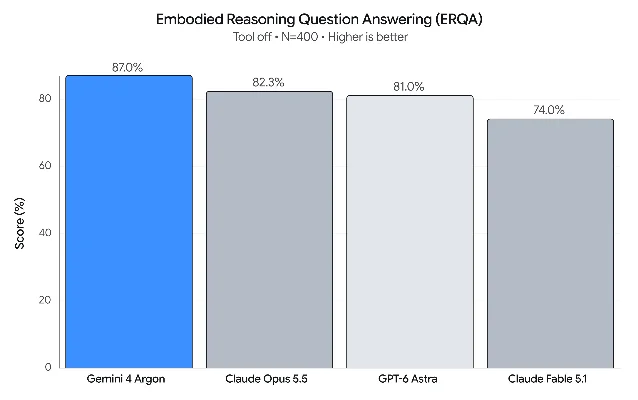
这个基准是 Google DeepMind 自己的。ERQA 随 Gemini Robotics 一起开源,400 道多模态选择题,考的是空间推理与物理世界知识;仓库里的评测脚本支持 Gemini 与 OpenAI 两组接口。15 四个读数可以跨模型比较,跑这段评测的仍然是官方自己。
配套演示里最能说明问题的是一条内部测试。Argon 看一段人玩沙包投掷的原始视频,自己解出空间坐标与全身关节动作,再把仿真代码搭起来;接到 Apptronik 的 Apollo 人形机器人上之后,连中七次。1 同一条流水线在另一处给出的读数是:从一张桌面照片出发,Argon 自己搭仿真、定义任务、采出 4,500 局以上的域随机化数据,真机成功率从 56% 提到 75%,完成时间从 35 秒降到 24 秒。14
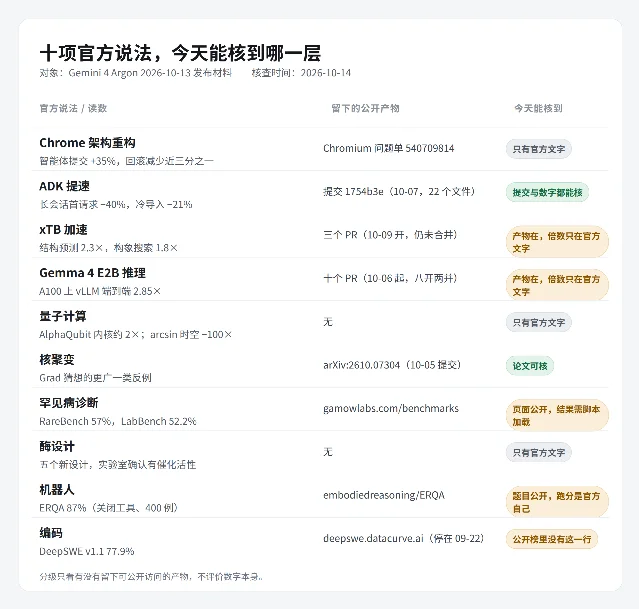
把前面十项官方说法按「有没有留下可公开访问的产物」排开;这张图由本地渲染自制,分级依据是 2026 年 10 月 14 日当天对各仓库、论文页与公开榜单的访问结果。
这份材料没说清的
配套的评测方法页还是 9 月 30 日那一份,我核过,仍是 5 页、标题未变。16 模型卡里那张 19 行的对照表,因此没有随之公布的方法说明。
引导期在 11 月 30 日结束,之后每百万输入与输出的单价都翻一倍。长期跑的负载如果按今天的价格估算成本,11 月 30 日之后的实际支出会翻倍。1
要往下追
三个可以直接观察的信号。
第二,DeepSWE 的公开榜会不会出现 Argon 这一行。榜单现在停在 9 月 22 日,而模型卡里的 77.9% 已经放了三周。7
第三,有没有第三方用同一批题复现任何一个数字。今天能自核的那一项(ADK),恰好也是唯一一个提交里直接写着「Argon generated these changes」的。8
References
- 1Gemini 4 Argon: Built to solve your hardest problems
deepmind.google
- 2Gemini 4 Argon Model Card
storage.googleapis.com
- 3Fairwind Program
deepmind.google
- 4Developer's guide to Gemini 4 Argon
docs.cloud.google.com
- 5Long decode
ai.google.dev
- 6Vals Index leaderboard
vals.ai
- 7DeepSWE leaderboard
deepswe.datacurve.ai
- 8
- 9Optimizing a 200,000-line Python codebase overnight with Gemini 4 Argon
developers.googleblog.com
- 10xTB pull requests
github.com
- 11vLLM pull requests
github.com
- 12
- 13Benchmarks | Gamow Labs
gamowlabs.com
- 14Gemini 4 Argon for Robotics
developers.googleblog.com
- 15
- 16Gemini 4 Argon Model evaluation
deepmind.google
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.