8月11日 AI 早报:5000亿美元算力融资,前沿模型进入受控防御
五条按行业影响力排序的全球 AI 进展:NVIDIA 计划为算力融资平台动员超过 5000 亿美元,OpenAI 扩大受控网络防御模型访问,纽约州公共科研超算上线,USC 测试音频模型的语气理解,以及企业开始重做 agent 的工作边界。
覆盖时间:2026 年 8 月 10 日 00:00 至 8 月 11 日 07:45(上海时间)。以下按行业影响力排序;公司目标、政府项目和研究团队自报结果,均与已落地的事实分开。
| 排名 | 发生了什么 | 为什么重要 |
|---|---|---|
| 1 | NVIDIA 与 Apollo、BlackRock、Blackstone、Brookfield、Goldman Sachs、KKR 签署谅解备忘录,计划通过独立融资平台动员超过 5000 亿美元第三方资本,支持 AI 基础设施。1 | 算力建设开始被包装成可融资、可投资的基础设施资产;但这笔钱还不是已到位的投资。 |
| 2 | OpenAI 扩大 Daybreak,把 GPT‑5.6 Sol 和专门的 GPT‑5.6‑Cyber 交给获批的网络防御者,分为更广泛的 Blue 和受更严格治理的 Red 两条访问路径。23 | 「模型发布」与「公开可用」被明确拆开:访问权留在获批合作伙伴手中,客户不能直接拿到底层模型。 |
| 3 | 纽约州 Empire AI Beta 正式上线。这台由 NVIDIA 提供算力、造价 4000 万美元的学术超算,相比 2024 年的 Alpha,AI 训练能力提高 11 倍、推理能力提高 40 倍、存储扩大 8 倍;已有 300 多个研究项目排队。4 | 公共研究机构正在用集中式算力补上实验室与前沿模型之间的资源差距;目前能确认的是容量,不是这些项目已经产生了什么科研成果。 |
| 4 | USC 团队发布 VoxParadox 基准,测试音频大语言模型识别年龄、人数、情绪、语调、音高和音量等 10 类副语言线索;NVIDIA Audio Flamingo 3 和阿里 Qwen2‑Audio 在故意制造「文字与语气冲突」的样本上接受评估。加入多层音频特征选择与偏好优化后,研究组报告准确率从 17% 升至 65%。5 | 多模态模型的短板不只在「听不见」,也在于它会把文字当成更可靠的捷径;65% 是该研究的报告结果,尚不是跨团队复现后的行业指标。 |
| 5 | The Conference Board 发布 agentic AI 与工作重设计框架。报告汇总 2026 年 2 月至 7 月的 16 场研究活动,涉及 75 位以上 HR、人才和 AI 负责人,并提出先定业务结果,再决定哪些任务交给 AI、人机协作或保留给人。6 | 企业落地的瓶颈被重新指向工作拆解、质量检查和收益分配;这是一份访谈、焦点小组和工作坊形成的执行摘要,不是大规模随机调查。 |
1. NVIDIA 要为 AI 工厂寻找 5000 亿美元的资金入口
8 月 10 日,NVIDIA 宣布与六家大型金融机构签署谅解备忘录,目标是建立独立的算力融资平台,形成大规模专用资本池,服务对象包括前沿 AI 实验室、企业和 AI 云。NVIDIA 把这类由计算硬件、软件和数据中心组成的设施称为「AI factories」,并希望把算力变成一种可投资资产。1
数字很大,但要先读清楚它的性质:公告说的是「动员超过 5000 亿美元第三方资本」的目标,合作仍以最终协议签署为前提。它不是 NVIDIA 已经筹到的资金,也不是已经开工的数据中心总额。
为什么排第一: 过去 AI 基础设施的讨论主要围绕芯片供货和云厂商资本开支。这次加入 Apollo、BlackRock、KKR 等金融机构后,算力项目多了一条金融化路径。接下来要看的不是口号,而是最终协议、资金真正投向哪些项目,以及项目能否获得稳定的电力、芯片和客户收入。
2. OpenAI 把前沿网络模型放进「受控防御」通道
OpenAI 8 月 10 日宣布扩展 Daybreak 项目,向获批的个人和组织提供两种访问路径。Daybreak Blue 面向漏洞发现、安全代码审查、恶意软件分析、事件响应和补丁验证;Daybreak Red 则用于更高风险的授权漏洞研究、红队演练和渗透测试。Red 通道包含专门训练的 GPT‑5.6‑Cyber,Blue 通道提供 GPT‑5.6 Sol 等前沿通用模型。2
另一篇同日公告显示,Accenture、IBM、Palo Alto Networks、CrowdStrike、Cisco、Cloudflare 等服务与技术伙伴可以在安全产品、托管服务和客户项目中使用这些模型,但模型访问权仍保留在获批伙伴手里,不会直接转交给客户。OpenAI 列出的控制包括身份验证、限定测试范围、日志、监控和人工监督。3
为什么重要: 这次变化不是「又一个模型上线」那么简单。它把能力交付、使用授权和责任边界绑在一起:模型能力可以进入真实防御流程,但接触模型的人、测试环境和可执行范围都要先被限定。OpenAI 的公告描述了访问计划,尚未提供足以证明防御效果的独立评估数据。
3. Empire AI Beta 上线,公共科研算力扩容
Empire AI 是纽约州的研究计算联盟。设在纽约州立大学布法罗分校的 Beta 系统由 NVIDIA 提供算力,造价 4000 万美元,属于纽约州 5 亿美元联盟建设的第二阶段。校方 8 月 10 日称,Beta 相比 2024 年上线的 Alpha,训练能力提高 11 倍、推理能力提高 40 倍、数据存储扩大 8 倍。4
已有 300 多个研究项目排队,方向包括医疗、气候、先进制造、教育、网络安全和公共安全。网页还称它是美国最强的学术研究计算机,但这是州政府和校方的表述,页面没有附上独立的横向基准或已完成项目的研究结果。
为什么重要: 前沿 AI 的门槛不只是模型代码,也包括谁能获得足够的训练和推理资源。Empire AI Beta 让「公共科研算力」从政策目标变成一台已经上线的机器;它能否改变研究产出,要等排队项目公布可复核结果。
4. 音频模型会读文字,不一定会听语气
USC 团队提出 VoxParadox,专门测试音频大语言模型是否能使用说话人的年龄、人数、情绪、语调、音高和音量等线索。实验把文字内容与说话方式故意做成冲突,例如让语气传达的意思与字面句子不一致,再要求模型判断陈述是否为真。研究对象包括 NVIDIA Audio Flamingo 3 和阿里 Qwen2‑Audio。5
研究组把问题拆成两部分:音频信息在模型后层逐渐退化,以及语言偏置让模型即使保留了声学信息也不去使用。团队用 Prompt-Conditioned Layer Mixer 从多个层提取音频特征,再用 Direct Preference Optimization 让模型偏向更符合声音证据的答案;新闻稿报告准确率由 17% 提升到 65%。5
为什么重要: 语音助手、客服和会议 agent 如果只听懂词,不听懂语气,就会在反讽、犹豫和情绪变化上误判。这个结果值得关注,但目前来源是学校对研究的介绍;65% 的提升还需要论文细节和其他团队复现来确定适用范围。
5. Agent 落地的难题,可能先是工作设计
The Conference Board 的执行摘要把 agentic AI 和技能导向型工作放在同一个问题里讨论。它汇总了 2026 年 2 月至 7 月的 16 场研究活动,包括 12 次高管访谈、4 场焦点小组、专家小组和一场会员工作坊,参与者超过 75 位,主要来自 HR、人才和 AI 管理岗位。6
报告给出的顺序很实际:先写清楚业务要达到什么结果,再把工作拆成 AI 独立完成、人机协作和人独立完成三类;随后补上数据、治理、质量检查,并事先决定生产率收益流向投资者、客户还是员工。它还提醒企业把 agent 的持续定价、监控、编排和更新成本算进去。6
为什么重要: 这份材料不是大样本调查,结论也不能代表所有企业。但它抓住了一个常被跳过的判断点:如果一项试点没有先定义任务边界、验收方式和收益分配,模型能力再强,也很难说明它到底替代了什么、增加了什么。
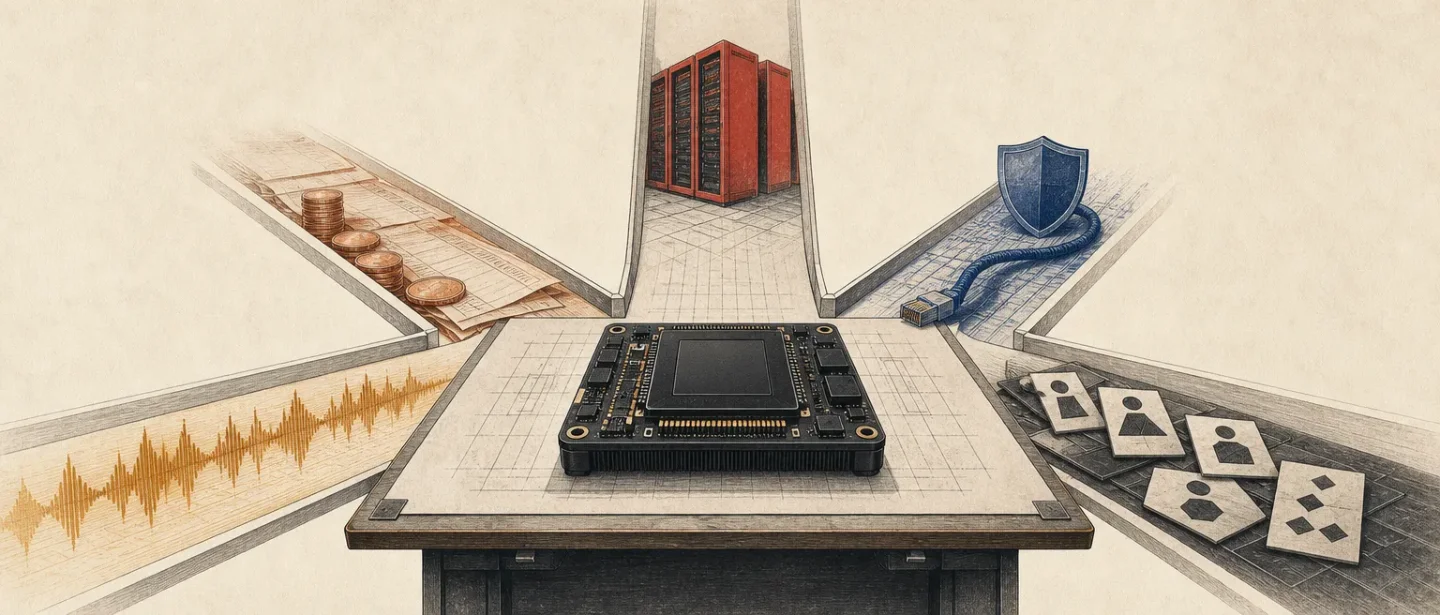
今天这五条消息放在一起,读者看到的是一条从资金到使用的完整链条:NVIDIA 在找钱建算力,纽约州把公共算力开出来,OpenAI 把高风险模型放进受控渠道,研究者在测模型是否真的理解声音,企业顾问则开始处理 agent 进入组织后的任务分工。每一层都还带着未解决的验证问题,不能把融资目标、项目上线、研究组结果和企业框架统称为「AI 已经解决了」。
References
- 1NVIDIA Newsroom
nvidianews.nvidia.com
- 2
- 3
- 4
- 5Can AI read the room? USC study finds AI is better at reading than listening
viterbischool.usc.edu
- 6A Framework for Agentic AI and Work Redesign
conference-board.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.