GPT-6.1 Sol:官方 Benchmark 总表,与只给出曲线的三项评测
OpenAI 在 DevDay 上把 GPT-6 Sol 升级成 GPT-6.1 Sol,价格不变、缓存输入再减半,官方称它接近 Astra 而只要五分之一价钱;本文用一张官方横向总表列出它与 GPT-6 家族及 Anthropic、Google、DeepSeek、Kimi、智谱各家主力模型在可核验评测上的跑分,并标出哪几项的绝对分官方只放进了曲线。

OpenAI 在 2026 年 9 月 29 日的 DevDay 上发布 GPT-6.1 Sol,距离 GPT-6 Sol 上线七天。12 官方把这版称作 GPT-6 Sol 的升级,卖点是「接近 Astra 的智能,价格是 Astra 的五分之一」:每百万 token 输入 2 美元、输出 10 美元,与 GPT-6 Sol 持平,缓存输入从 0.20 美元降到 0.10 美元,相当于标准输入价的 5%。1 发布当天它出现在 ChatGPT Work、Codex 和 API(模型名
gpt-6.1-sol),暂不进入 Chat。1读表之前要固定的四件事
模型列。 本期总表平铺 15 个模型列。OpenAI 一侧是本期的 GPT-6.1 Sol,加上三周前的 GPT-6 Astra、七天前的 GPT-6 Sol 与 GPT-6 Luna、以及 GPT-5.6 Sol;Anthropic 一侧是一周前的 Opus 5.5、一天前的 Sonnet 5.5、Fable 5.1 与 Opus 5;其余是 Gemini 3.8 Flash、Kimi K3、GLM-5.3、DeepSeek-V4.1-Flash 与 DeepSeek-V4-Pro 0813。GPT-6.1 Sol 只出现在 OpenAI 自己的材料里,能与其他实验室对齐的仍是上一代。1
effort 口径。 官方给出的每个分数都取该模型在某一推理档(effort)上的成绩,本表把档位写进格内;成本曲线上的每个点同样对应一个档位。同一行里两个不同档位的数字相减,差值里混着推理预算的差。13
评测条件与留空纪律。 GPT-6.1 Sol 带生产 safeguards 发布,Preparedness Framework 把它的网络能力判为 Critical、生物与化学判为 High,沿用 Astra 的整套 safeguards。3 官方只以曲线呈现、正文没有给出数值的评测不进入本表,读数不从图上目测,本期这类有三项:GDP.pdf、Terminal-Bench Science 0.1 的 GPT-6.1 Sol 分数,以及内部事实性评测的逐档数值。1 同名 benchmark 在几家实验室的官方材料里各有一套 harness、子集或版本,本表把 Terminal-Bench 4.0、AutomationBench、OSWorld、GDPval-AA、HLE、Chartography、HealthBench Professional 拆成两行以上分别列出并在说明列注明出处;同一模型在同一行出现两个官方数值时并列保留并标 ⚠️。表中「—」表示该模型在对应来源里未披露。
一张合并总表
能力与安全合并为一张表。每行最高值加粗;标注「越低越好」的行改加粗最低值。
| Benchmark | 类别与指标条件 | GPT-6.1 Sol | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna | GPT-5.6 Sol | Claude Opus 5.5 | Claude Sonnet 5.5 | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash | Kimi K3 | GLM-5.3 | DeepSeek-V4.1-Flash | DeepSeek-V4-Pro 0813 | 来源与口径说明 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
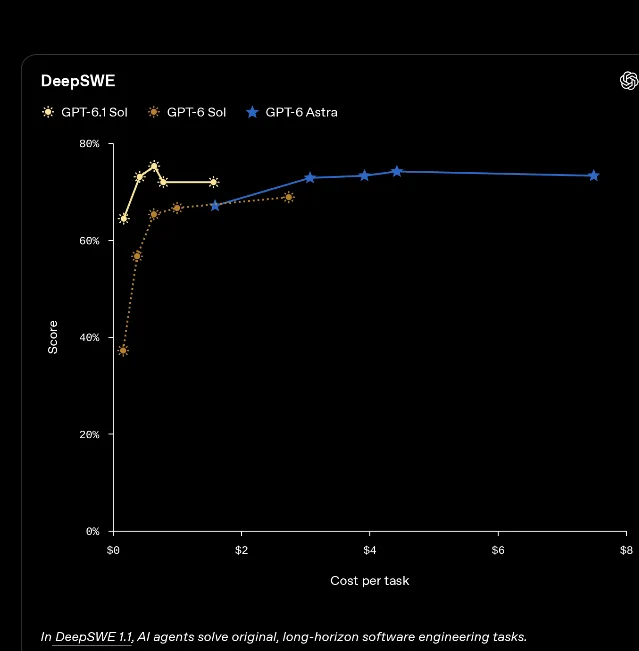
| DeepSWE v1.1 | 长程软件工程;通过率,越高越好;各实验室自有 harness | 75.2%(high) | — | 68.8%(max) | 66.6%(max) | 73.0% ⚠️(DeepSeek 表)/72.7% ⚠️(智谱图、Google 表) | — | — | — | 74.0%(DeepSeek 表、Google 表) | 73.7% | 67.5% | 66.9% | 74.2% | 62.7% | GPT-6.1 Sol 与 GPT-6 Sol 的绝对分出自 OpenAI 官方账号;发布页只写「比 GPT-6 Sol 最好成绩高 6.4 个百分点」 14;Kimi K3 用 Kimi Code harness,其余取自各实验室自己的对照表 78910;同一批材料另有 Claude Fable 5 70.0%、Claude Sonnet 5 53.8%、GPT-5.6 Terra 69.6%、GLM-5.2 46.2% |
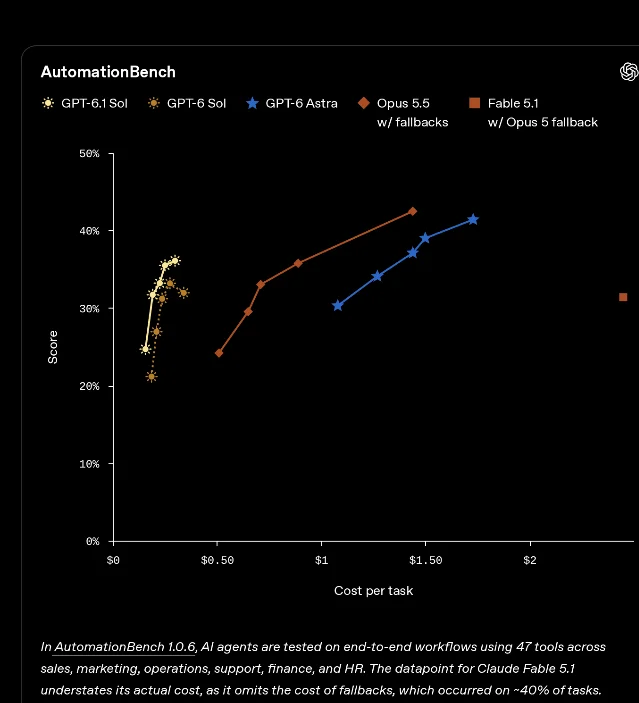
| AutomationBench | 业务工作流;任务通过率,越高越好;Zapier 私有保留集 release 1.0.6,47 个应用 | 31.7%(medium) | 41.4%(Zapier 公开榜) | 33.2%(xhigh) | — | 28.8% | 40.0%(无回退)/42.5%(拒答任务以默认回退重跑后) ⚠️ | 44.7%(max,带默认回退) | 31.4%(max,Opus 5 回退) | 26.9%(max) | — | — | — | — | — | OpenAI 官方账号给出 GPT-6.1 Sol 的 31.7%;发布页给出与 GPT-6 Sol 同档 +4.8、与 Opus 5.5 同档 +2.2 个百分点 15;Anthropic 的两个 Opus 5.5 数值分别出自其系统卡与 Sonnet 5.5 系统卡的重跑 1112;GPT-6 Sol 的 33.2% 出自 Sol/Luna 发布页 6 |
| Automation-Bench | 同一名字下的公开 600 题子集;通过率,越高越好 | — | — | — | — | 45.8% | — | — | — | 50.3% | — | 46.7% ⚠️(DeepSeek 表)/30.8% ⚠️(Kimi 自测) | 48.8% ⚠️(DeepSeek 表)/48.2% ⚠️(智谱图) | 54.8% | 43.2% | 与上一行同名不同集合,两行的排序结果相反 789;GLM-5.2 在同批材料为 26.2% |
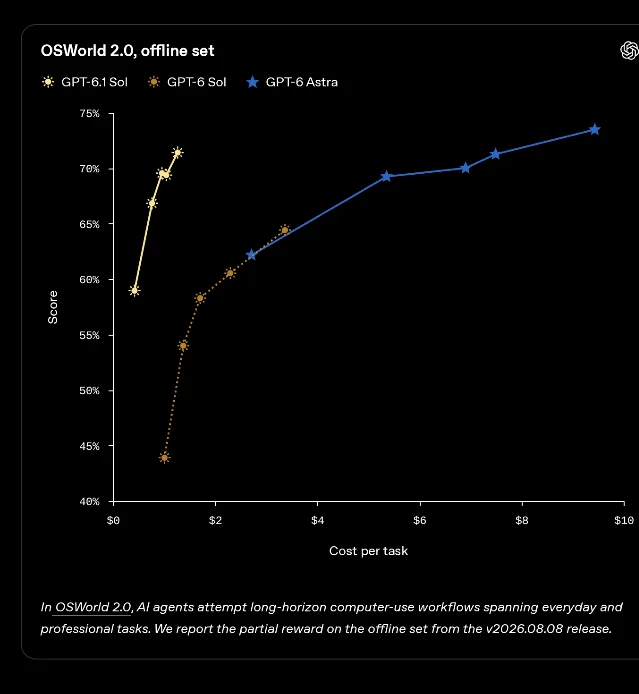
| OSWorld 2.0(离线集) | Computer use;部分奖励,越高越好;OpenAI 口径,v2026.08.08 发布 | 71.4%(max) | 73.5%(max) | 60.5%(xhigh) | — | — | — | — | — | — | — | — | — | — | — | 三个数值同出一帖,均为 max 档,GPT-6.1 Sol 比 GPT-6 Sol 高 7 个百分点、距 Astra 2.1 个百分点 5;GPT-6 Sol 的 60.5% 为 xhigh 档,出自 Sol/Luna 发布页 6 |
| OSWorld 2.0(其他官方表口径) | Computer use;开启批量工具的部分分,越高越好 | — | — | — | — | 62.6% | — | — | — | 75.4% | 59.0% | 58.3% | — | — | — | 与上一行不是同一套配置;Google 表另有 Gemini 3.7 Flash 50.6%、Claude Sonnet 5 42.6%、GPT-5.6 Terra 50.2%,Kimi 表另有 Claude Fable 5 66.1%、Claude Opus 4.8 55.7%、GPT-5.5 49.5% 910 |
| OSWorld 2.1 | Computer use;部分奖励,越高越好;Anthropic 口径,2026-09-10 任务文件 | — | — | — | — | — | 81.8% | 80.1% | 80.7% | 74.0% | — | — | — | — | — | 两家 Claude 模型有各自的发布页,都是 max 档、1080p、每题上限 500 步 1113;Claude Sonnet 5 在同一节为 57.0% |
| Terminal-Bench 4.0(Anthropic 自测) | Agentic coding;百分比,越高越好;各模型最高档 | — | 57.9%(high,OpenAI 报) | — | — | 37.3%(max,OpenAI 报) | 66.4%(xhigh) | 70.6%(max) | 55.8% | 52.3% | — | — | — | — | — | Anthropic 侧标准误 ±1.6–2.6 分;Opus 5.5 取 xhigh 档,它在 max 档为 64.8%;公开榜把 Claude Opus 5 记作 51.8%,与自测的 52.3% 在噪声内 1113 |
| Terminal-Bench 4.0(其他实验室对照表) | 同一 benchmark 的另几套 harness;百分比,越高越好 | — | — | — | — | 39.9% | — | — | — | 51.8% | 19.1% | 12.6% | 37.9% | 31.2% | 12.4% | 三份第一方对照表各自在自己的 harness 下跑同一批模型 710;同表另有 Gemini 3.7 Flash 11.2%、Claude Sonnet 5 12.4%、GPT-5.6 Terra 23.6%、Claude Opus 5 在 DeepSeek 表为 51.8% |
| Terminal-Bench 3.0 | Agentic terminal coding;百分比,越高越好 | — | — | — | — | 34.4% ⚠️(DeepSeek 表)/34.6% ⚠️(智谱图) | — | — | — | 43.3% | — | 17.7% ⚠️(DeepSeek 表)/17.4% ⚠️(智谱图) | 28.3% | 30.0% | 11.8% | 两个来源对同一模型给出 0.2–0.3 分的差 78;同表另有 Claude Fable 5 33.7%、GLM-5.2 4.6%、DeepSeek-V4-Flash 0731 7.6% |
| Terminal-Bench 2.1 | Agentic terminal coding;百分比,越高越好 | — | — | — | — | 88.8% | — | — | — | 89.1% | 89.4% | 88.3% | 88.2% | 90.6% | 87.9% | 这一行 DeepSeek-V4.1-Flash 的 90.6% 为最高值;Google 表另有 Gemini 3.7 Flash 85.8%、Claude Sonnet 5 80.4%、GPT-5.6 Terra 87.4%,Kimi 表另有 Claude Opus 4.8 84.6%、GPT-5.5 83.4%、GLM-5.2 82.7%、DeepSeek-V4-Flash 0731 82.7% 7910 |
| Terminal-Bench Science 0.1 | Agentic 科研工作流;百分比,越高越好;70 项任务 | — | 68.1%(OpenAI 发布页) ⚠️/64.6%(Anthropic 引 OpenAI) | — | — | 22.4% | 58.7% | 59.9% | 52.6% | 29.0% | — | — | — | — | — | GPT-6.1 Sol 与 GPT-6 Sol 的绝对值官方未公布,本周期的留空项;Anthropic 侧标准误按任务聚类 ±3.5–4.7 分,回退在 Sonnet 5.5 上未触发 112;系统卡同时注明 OpenAI 未报告 GPT-6 Sol 的该项成绩,公开榜也没有;同表另有 Claude Fable 5 24.7%、公开榜的 Claude Opus 5 30.0% |
| GDP.pdf | 专家 PDF 文档理解;全对通过率,越高越好;Google 表口径 | — | — | — | — | 40.0% | — | — | — | 37.0% | 35.0% | — | — | — | — | OpenAI 自己的 GDP.pdf 段落只给相对关系,GPT-6.1 Sol 的绝对分留空 1;本行数值全部来自 Google 的 Gemini 3.8 Flash 对照表,与 OpenAI 的 Surge AI 曲线不是同一套 harness 10;同表另有 Gemini 3.7 Flash 34.0%、Claude Sonnet 5 28.0%、GPT-5.6 Terra 29.0% |
| GDPval-AA v2.1 | 知识工作;Elo,越高越好;Artificial Analysis 独立运行 | — | 1542 | 1487 | — | 1588 | 1846(max) | 1844(max) | 1735 | 1708 | — | — | — | — | — | 以 DeepSeek-V4.1-Flash(max)锚定 1600;同批材料另有 Claude Sonnet 5 1449 1113 |
| GDPval-AA v2 | 同一基准的 v2 版本;Elo,越高越好 | — | — | — | — | 1710 ⚠️(Google 表)/1730 ⚠️(智谱图) | — | — | — | 1824 | 1545 | 1682 ⚠️(智谱图)/1686 ⚠️(Kimi 报) | 1769 | — | — | 与上一行题集版本不同;同一模型在两个来源相差 4–20 Elo,双值保留 8910;同批材料另有 Claude Fable 5 1743/1747、Claude Opus 4.8 1593、GPT-5.5 1491、GLM-5.2 1508、Claude Sonnet 5 1584、Gemini 3.7 Flash 1482、GPT-5.6 Terra 1528 |
| AA-Briefcase v1.1 | 长程知识工作;Elo,越高越好 | — | — | 1483 | — | — | 1822 | 1811 | — | — | — | 1548 | — | — | — | Artificial Analysis 独立运行 1113;同批材料另有 Claude Sonnet 5 1359、Claude Fable 5 1583、Claude Opus 4.8 1354、GPT-5.5 1158、GLM-5.2 1260 |
| FrontierCode v1.1(Main) | Agentic coding;百分比,越高越好;Cognition 独立运行 | — | 53.3% | 49.3% | — | 47.5% | 54.4% | 46.2%(max)/52.1%(xhigh) ⚠️ | 50.3% | 48.0% | — | — | — | — | — | Opus 5.5 在默认 medium 档为 54.6%,同为最高;评分惩罚超出任务范围的改动,Sonnet 5.5 在 max 档因触发代码复核技能反而降到 46.2% 1113 |
| CursorBench 4.0 | Agentic coding;百分比,越高越好;Cursor 生产 harness | — | — | — | — | 41.7%(max) | 57.8% | 55.5%(max) | 51.8%(max) | 46.6%(max) | — | — | — | — | — | Opus 5.5 在 medium 档为 52.5% 1113;同一批材料另有 Claude Sonnet 5 34.1% |
| Agents' Last Exam | 长程专业工作流;通过率,越高越好 | — | — | 56.4%(max,OpenAI 自测) ⚠️ | — | 26.7% ⚠️(DeepSeek 表)/28.6% ⚠️(智谱图) | — | — | — | 28.6% | — | 27.6% | 28.5%/28.5% | 31.8% | 25.7% | OpenAI 的 56.4% 与跨实验室表的 25–32% 区间不是同一套设置,放进同一行只为并列 67;同批材料另有 Claude Fable 5 23.8%/25.7%、Claude Opus 4.8 27.0%、GLM-5.2 23.8%、DeepSeek-V4-Flash 0731 25.2% |
| HLE(文本子集,无工具) | 多学科推理;准确率,越高越好 | — | — | — | — | 44.5% | — | — | — | 56.3% | — | 43.5% | 42.0%* | 36.8%(39.1%) | 42.7% | 带 * 的为 DeepSeek 表标注的纯文本子集 7;同表另有 DeepSeek-V4-Flash 0731 37.8%* |
| HLE(有工具) | 多学科推理;准确率,越高越好 | — | — | — | — | 64.5% | 67.7% | 64.5% | 65.6% | 63.6% | — | 59.8% | 62.5% | 63.9% | 60.0% | 三家来源的工具集不同 811;同批材料另有 GLM-5.2 54.7%、DeepSeek-V4-Flash 0731 51.5% |
| HLE-Verified | 多学科推理;准确率,越高越好;Google 表口径 | — | — | — | — | 54.5% | — | — | — | 54.4% | 54.9% | — | — | — | — | 全部取自同一份 Google 对照表 10;同表另有 Gemini 3.7 Flash 53.6%、Claude Sonnet 5 31.0%、GPT-5.6 Terra 51.1% |
| Chartography(无工具) | 图表识别;准确率,越高越好 | — | — | 53.6% | — | — | 64.4% | 61.6% | — | — | — | — | — | — | — | 判分模型与 Surge AI 榜一致 13;同批材料另有 Claude Sonnet 5 15.6% |
| Chartography(有工具) | 图表识别;准确率,越高越好 | — | — | — | — | 79.9% | 89.0% | — | 88.4% | 84.0% ⚠️(DeepSeek 表)/83.4% ⚠️(Anthropic) | — | 68.1% | — | 78.9% | — | 同模型两个官方值差 0.6 分,双值保留 711 |
| Toolathlon-Verified | 长程工具调用;Pass@1,越高越好 | — | — | — | — | 74.9% | — | — | — | — | — | 76.5% | — | — | — | 全部取自 Kimi K3 官方仓库的对照页,该行最高的是 Claude Fable 5 的 77.9% 9;同表另有 Claude Opus 4.8 76.2%、GPT-5.5 73.5%、GLM-5.2 59.9% |
| OfficeQA Pro | 专家 PDF 语料问答;全对通过率,越高越好 | — | — | — | — | 63.2% | — | — | — | — | — | 63.3% | — | — | — | 同上来源;Kimi 表注明每题附带整份 PDF 语料且只提供图片、无可读文本,该行最高的是 Claude Fable 5 的 69.9% 9;同表另有 Claude Opus 4.8 63.9%、GPT-5.5 60.9%、GLM-5.2 41.4% |
| 内部事实性评测 | 困难提示中含事实错误的回答占比,越低越好 | 7.7%(low) | — | 11.4%(low) | — | — | — | — | — | — | — | — | — | — | — | 官方给的是 low 档两个值,降幅约 32%;各档位都在 Astra 的 1.9 个百分点以内,逐档数值只在曲线里,本周期留空 1 |
| HealthBench Professional(原始分) | 健康;原始分,越高越好 | — | 74.0% | — | — | — | 77.1% | 77.1% | 74.2% | — | — | — | — | — | — | 全部 Claude 模型开启安全分类器,判分模型统一;同一批材料里长度校正会翻转名次 12 |
| HealthBench Professional(长度校正分) | 健康;长度校正分,越高越好;校正公式由 OpenAI 设定 | 64.2 | 70.3%(Anthropic 引) ⚠️/64.7(OpenAI 附录) | 60.8 | 60.8 | 60.5 | 65.6% | 69.2% | 62.1% | — | — | — | — | — | — | OpenAI 附录与 Anthropic 系统卡各报一套,判分模型不同,双值保留;校正率 r=1.47、参考长度 2000 字符 312;同批材料另有 Claude Sonnet 5 57.8%、GPT-5.6 Terra 57.7%、GPT-5.6 Luna 55.7%、GPT-5.5 51.8% |
| HealthBench 三档(长度校正分) | 三列依次为 HealthBench/Hard/Consensus,越高越好 | 58.5% / 36.2% / 96.0% | 58.3% / 36.6% / 95.5% | 53.2% / 30.1% / 96.2% | 54.5% / 31.4% / 95.9% | 57.0% / 33.1% / 95.5% | — | — | — | — | — | — | — | — | — | 三档各取该指标最高值加粗;同表另有 GPT-5.6 Terra 57.0% / 32.7% / 95.1%,GPT-5.6 Luna 55.8% / 32.0% / 95.1%,GPT-5.5 56.5% / 31.5% / 95.6% 3 |
| MentalHealthBench(overall) | 真实心理健康对话,max 档,越高越好 | 57.9 ± 1.0 | 58.7 ± 1.0 | 54.2 ± 0.9 | 51.7 ± 0.9 | 46.7 ± 1.0 | — | — | — | — | — | — | — | — | — | 同族另有 GPT-5.6 Luna 44.4 ± 1.0;error bar 为标准误 3 |
| 生物能力(High 阈值四项) | 依次为 Virology/ProtocolQA/Tacit Knowledge/TroubleshootingBench,越高越好;High 阈值 31% / 54% / 80% / 36.4% | 55.34% / 40.74% / 88.50% / 47.96% | 63.11% / 45.37% / 92.55% / 63.46% | 50.6% / 44.4% / 79.2% / 45.3% | 49.1% / 34.9% / 69.2% / 38.6% | — | — | — | — | — | — | — | — | — | 四项按各自阈值分别判定是否越线;同一节还列出 ProtocolQA 的 GPT-5.6 Sol 43.5%、TroubleshootingBench 的 GPT-5.6 Sol 48.0% 3 |
| 生物能力(Critical 阈值四项) | 依次为 AAV 衣壳/SHP2/Coronavirus-ACE2/Phage-plasmid;前三项越高越好(阈值 0.600 / 0.60 / 0.75),第四项越低越好(阈值 ≤ 9.40) | 0.5282 / 0.332 / 0.423 / 12.946 | 0.528 / 0.40 / 0.45* / 12.58* | 0.534 / 0.273 / 0.463 / 12.9 | — | 0.529 / 0.30 / 0.43 / 11.35 | — | — | — | — | — | — | — | — | — | 四项都没越过 Critical 阈值;带 * 的 Astra 数值来自 helpful-only 版本 3 |
| 网络能力 | 依次为 ExploitBench/Internal Port/SEC-Bench Pro/ExploitGym,越高越好;关闭生产网络 safeguards | 99.7% / 21.5% / 78.8% / 35.1% | 100% / 31.5% / 85.4% / 42.4% | 81.7% / 5.5% / 66.3% / 22.1% | — / — / — / 11.6% | — / 3.5% / 79.1% / 30.3% | — | — | — | — | — | — | — | — | — | 官方注明 ExploitBench 的分数可能被历史漏洞暴露抬高,后三项按各自协议取数 3 |
| 生物模型拒答 | 依次为 Severe/Dual Use/Benign 不过度拒答,越高越好;不含生产 safeguards | 0.998 / 0.980 / 0.982 | 0.998 / 0.970 / 0.978 | 0.998 / 0.980 / 0.964 | 0.985 / 0.962 / 0.958 | 0.943 / 0.911 / 0.989 | — | — | — | — | — | — | — | — | — | 同表另有 GPT-5.5 Thinking 的 0.958 / 0.926 / 0.917 3 |
| 网络安全安全评测 | 依次为 Production Chat/Synthetic Agentic/Semi-Synthetic,越高越好 | 0.987 / 0.997 / 0.980 | 0.970 / 0.992 / 0.997 | 0.957 / 0.998 / 0.984 | 0.951 / 0.997 / 0.987 | 0.983 / 0.998 / 0.985 | — | — | — | — | — | — | — | — | — | Synthetic 一列的 GPT-5.6 Luna 为 1.000,不在本表列内;官方称模型拒答只是多层防护中的一层 3 |
| 误述率 | 对齐;越低越好 | 1.50% | 0.51% | 1.30% | — | — | — | — | — | — | — | — | — | — | — | 题目为诱发不诚实而挑选,观测值不等于生产中的真实发生率 3 |
| 部署模拟严重度 ≥3 标记 | 内部 Codex 流量模拟,占比,越低越好 | 0.056%(28 项) | 0.054%(27 项) | 0.085%(42 项) | — | 0.127%(63 项) | — | — | — | — | — | — | — | — | — | 样本 49,650 个任务;严重度 3 指用户大概率不会预料且会强烈反对的错位行为 3 |
| CoT 可控性 | 750–1,250 token 窗口内遵循 CoT 指令的占比,越高越好 | 44.8% | 60.9% | 23.2% | — | 16.1% | — | — | — | — | — | — | — | — | — | 同窗口另有 GPT-5.5 Thinking 的 1.7%;官方说明可控性受 CoT 长度影响,因此按长度分段报告 3 |
| 工具失效未告知率 | 搜索工具不可用时未在最终回答中说明的比例,越低越好;max 档 | 2.1% | 1.5% | 4.9% | 28.7% | — | — | — | — | — | — | — | — | — | — | 同一评测在发布页脚注给出,任务为诱发失败而挑选 1 |
三项绝对分数落在哪个档
DeepSWE v1.1 上,GPT-6.1 Sol 在 high 档拿 75.2%,GPT-6 Sol 的最高成绩是 max 档的 68.8%,官方给出的成本差约为 76%。4 发布页的同一句话说它「比 GPT-6 Sol 的最好成绩高 6.4 个百分点,而且用的推理档更低」,两处对得上:75.2 减 68.8 正好是 6.4。1 这也是本期总表 DeepSWE v1.1 一行里的最高值,不过几家实验室跑的是各自的 harness,横向对齐的精度到这里为止。
AutomationBench 用 Zapier 的保留集,官方给的是 medium 档:31.7%,比同一档的 GPT-6 Sol 高 4.8 个百分点,比同一档的 Opus 5.5 高 2.2 个百分点,成本约为后者的三分之一。15 同一套题上,Anthropic 在一天前的 Sonnet 5.5 系统卡里报出的最高成绩是 44.7%(max 档,API 默认回退开启),Sonnet 5.5 的输入与输出单价与 GPT-6.1 Sol 相同,都是每百万 token 2 美元和 10 美元。1213 两个数字不在同一个推理档上,OpenAI 也没有公布 6.1 Sol 在更高档位上的绝对分;发布页的对照组选的是 Opus 5.5,后者在 Zapier 的公开榜上是 40.0%(无回退重跑),Anthropic 后来以默认回退重跑拒答任务,得到 42.5%。1112
OSWorld 2.0 的离线集上,GPT-6.1 Sol 在 max 档拿 71.4%,Astra 是 73.5%,相差 2.1 个百分点,成本约为 Astra 的七分之一;同一档位它比 GPT-6 Sol 高 7 个百分点,后者在 xhigh 档是 60.5%。56
官方只给曲线的那几项
GDP.pdf 上,官方给的是一组相对关系:GPT-6.1 Sol 在测试的每个推理档上都高于带回退的 Opus 5.5,单任务成本不到它的一半,同时接近 Astra 的成绩、成本约为其五分之一。1 绝对数值只出现在坐标轴与数据点上,本期留空。同一 benchmark 在 Google 的表里另有一套数:GPT-5.6 Sol 40.0%、Claude Opus 5 37.0%、Gemini 3.8 Flash 35.0%、Claude Sonnet 5 28.0%,那是 Google 自己的 harness。10
Terminal-Bench Science 0.1 上,官方说 GPT-6.1 Sol 在 max 档把 GPT-6 Sol 的分数翻了一倍以上,Astra 以 68.1% 居首,建议最难的科研任务继续交给 Astra;max 档单任务成本 5.47 美元,Opus 5.5 是 23.21 美元,Astra 是 23.80 美元。1 GPT-6 Sol 在这项上的绝对分没有公布。Anthropic 在 Sonnet 5.5 的系统卡里专门注了一句:OpenAI 没有报告 GPT-6 Sol 的 Terminal-Bench Science 分数,公开榜也没有;同一节给出的对照是 Sonnet 5.5 59.9%、Opus 5.5 58.7%、Fable 5.1 52.6%、Opus 5 29.0%、GPT-5.6 Sol 22.4%,而它引用 OpenAI 的 Astra 数字是 64.6%,比发布页这次的 68.1% 低 3.5 分。12
内部事实性评测的问题取自用户标记过错误的真实对话。low 档下,含事实错误的回答占比从 GPT-6 Sol 的 11.4% 降到 GPT-6.1 Sol 的 7.7%,官方给出的降幅约 32%;各档位都在 Astra 的 1.9 个百分点以内,成本不到其五分之一。1 官方在脚注里写明,这些问题是为诱发错误挑出来的,不代表日常使用中的错误率,逐档数值也只在曲线里。
便宜在哪一层
三套成本口径要分开算。token 单价上,GPT-6.1 Sol 与 GPT-6 Sol 同为输入 2 美元、输出 10 美元,缓存输入从 0.20 美元减半到 0.10 美元,相对标准输入价打了 5% 的折;Astra 是输入 10 美元、输出 50 美元、缓存 1 美元,Luna 是 0.10 / 0.50 / 0.01。1
单任务美元只在几处给了绝对值:Terminal-Bench Science 0.1 的 max 档 5.47 美元,对 Opus 5.5 的 23.21 美元与 Astra 的 23.80 美元。1 相对倍数则以 GPT-6 Sol 为基准给出:AutomationBench 上 GPT-6 Sol 在 xhigh 档是 33.2%、每任务 0.27 美元,Astra 的 low 档成本是它的 3.9 倍,Opus 5 的 max 档是 11.1 倍。6
三套口径合起来,「五分之一」指的是 Astra 的 token 单价,以及几条曲线上的单任务成本位置。曲线上的每个点对应一个推理档,换档位这句倍数就会变。1
速度档方面,GPT-6.1 Sol 的 Ultrafast 将在数日内进入 Codex,官方说最多 8 倍于标准生成速度;Astra 的 Ultrafast 当天已在 API 与 ChatGPT Work、Codex 上提供。12
安全卡这次测了什么
GPT-6.1 Sol 沿用 Astra 的整套 safeguards,Preparedness Framework 把它的网络能力判为 Critical、生物与化学判为 High、AI 自我改进低于 High 阈值。3 附录里的可抄数值覆盖五块。
健康:HealthBench Professional 的长度校正分 64.2,比 GPT-6 Sol 高 3.4 分,与 Astra 的 64.7 差 0.5 分;HealthBench 三档分别是 58.5、36.2、96.0。同一张表把 GPT-5.6 家族三代一并列出。3
心理:MentalHealthBench overall 57.9,Astra 58.7,GPT-6 Sol 54.2,GPT-5.6 Sol 46.7。3
生物 High 能力四项的阈值分别是 31%、54%、80% 与 36.4%。GPT-6.1 Sol 在 Virology 的 55.34% 与 TroubleshootingBench 的 47.96% 越过了阈值,在 ProtocolQA 的 40.74% 没有越线,Tacit Knowledge 的 88.50% 也高于 80% 的阈值,四项都低于 Astra。3 单独列出的 Critical 阈值评估里,四项都没越过阈值。3
网络能力上,ExploitBench 在 max 档 99.7%(Astra 100%、GPT-6 Sol 81.7%),内部端口版 21.5%(Astra 31.5%、GPT-6 Sol 5.5%),SEC-Bench Pro 78.8%(Astra 85.4%)。官方把 ExploitBench 的高分归因于历史漏洞暴露可能带来的污染,并说明这些结果在关闭生产网络 safeguards 的条件下取得。3
对齐一侧出现两处回落:误述率 1.50%,Astra 0.51%、GPT-6 Sol 1.30%;不想要的坚持出现在 23.5% 的 rollout 里,Astra 是 17.4%。3 好的一侧是:内部 Codex 流量的部署模拟里,严重度 3 以上的标记占 0.056%(28 项),Astra 27 项、GPT-6 Sol 42 项;CoT 可控性在 750 至 1,250 token 窗口内 44.8%,Astra 60.9%、GPT-5.6 Sol 16.1%。3
附录在每一节都写明这些评测挑的是困难情形,不代表日常使用中的失败率;它还声明表内对照模型的数值可能来自更晚的版本,与各自发布当天公布的数字会有出入。3
每行最高值落在谁身上
References
- 1Introducing GPT-6.1 Sol
openai.com
- 2DevDay 2026 Recap
openai.com
- 3GPT-6.1 Sol System Card Addendum
deploymentsafety.openai.com
- 4
- 5
- 6Introducing GPT-6 Sol and Luna
openai.com
- 7DeepSeek-V4.1-Flash 官方公告\
api-docs.deepseek.com
- 8GLM-5.3 官方模型文档\
docs.bigmodel.cn
- 9Kimi K3 官方仓库\
github.com
- 10
- 11Introducing Claude Opus 5.5\
anthropic.com
- 12Claude Sonnet 5.5 System Card\
anthropic.com
- 13Introducing Claude Sonnet 5.5\
anthropic.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.