EmbeddingGemma 2 发布:740M 开源多模态嵌入,代码检索涨 9.9 分、端侧文本版 191MB
Google DeepMind 发布 EmbeddingGemma 2:740M 参数、Apache 2.0 的开源嵌入模型,把文本、代码、图像、视频与音频映射进同一个 768 维空间;代码检索比一代高 9.92 分,多语种文本持平,端侧文本版权重约占 191MB 内存。

Google DeepMind 在 2026 年 10 月 6 日发布 EmbeddingGemma 2,权重与模型卡同日公开。12 这是一个 740M 参数的嵌入模型,把文本、代码、图像、视频和音频映射进同一个 768 维向量空间,权重按 Apache 2.0 许可发布,可以直接下载到手机或笔记本上离线运行。13
上一代 EmbeddingGemma 发布于 2025 年,官方说它累计被下载超过 2,000 万次。1 二代换了 Gemma 4 的架构,纯文本部分从一代的 308M 缩到 270M,上下文从 2K 扩到 8K,图像、视频和音频三种输入是这一代新加进来的。23
先说结论
- 家族位置:EmbeddingGemma 2 是 EmbeddingGemma 的下一代,基于 Gemma 4 解码器架构,官方说它与 Gemini 的嵌入模型同源。13
- 参数规模:总计 740M,其中文本主干 270M(130M transformer 加 140M 嵌入层)、视觉编码器 170M、音频编码器 300M,两个模态编码器可以单独不加载。2
- 许可:Apache 2.0,允许微调与商用;官方同时要求部署遵守 Gemma 禁用用途政策。34
- 上下文:8,192 tokens,四种模态共用同一个窗口,比一代的 2K 大四倍。2
- 官方自测:代码检索一项从 68.76 升到 78.68,多语种文本与一代持平,图像、视频、音频的分数是这一代新出现的。2
- 独立评测:本轮没有查到任何第三方复跑结果,官方三张图上的对照数字全部出自 Google 自己的评测。56
- 价格与获取:开放权重没有按 token 计费;权重在 Hugging Face 与 Kaggle,Ollama、llama.cpp、vLLM、SGLang、LM Studio 等推理栈当天跟上。17
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与状态 | EmbeddingGemma 2,模型仓库 google/embeddinggemma-2,已公开发布 | Hugging Face |
| 发布方与时间 | Google DeepMind,2026 年 10 月 6 日 | 发布博客、模型卡 |
| 家族位置 | EmbeddingGemma 的下一代,基于 Gemma 4 解码器架构 | Gemma 文档 |
| 参数规模 | 740M 总量;文本主干 270M、视觉 170M、音频 300M | 模型卡 |
| 架构要点 | 24 层、模型维度 512、隐层 2048、滑窗 1024 tokens、词表 262,144、GQA/MQA、5:1 局部与全局注意力、均值池化、512→768 投影 | 模型卡 |
| 模态与输出 | 输入文本、代码、图像、视频、音频及其交错组合;输出 768 维向量,可截断到 512 / 256 / 128 维 | 模型卡 |
| 上下文 | 8,192 tokens,四模态共用 | 模型卡 |
| 许可 | Apache 2.0;部署须遵守 Gemma 禁用用途政策 | Gemma 文档、模型卡 |
| 评测口径 | 全精度权重、768 维;MTEB / MIEB / MMEB v2 / MSEB / MAEB 各项 | 模型卡 |
| 获取方式 | Hugging Face、Kaggle、LiteRT 量化包;ML Kit 与 Gemini Enterprise Agent Platform Model Garden 标为「即将」 | 发布博客、端侧博客 |
它把五种模态放进了一个空间
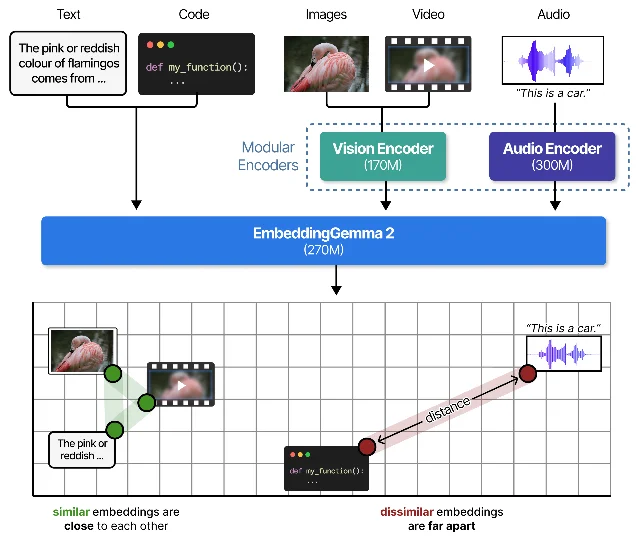
这件事对开发者的意义是省掉中间环节。过去要在本地同时搜图和搜文,得先把图片生成文字描述、把语音转写成文本,再接一个文本嵌入模型;EmbeddingGemma 2 让这三种输入各自过自己的编码器,输出直接落在同一套坐标里,可以用一段文字去查一张图或一段录音。89
8,192 tokens 的窗口由所有模态共用,各类内容按固定费率占用:文本一个子词算一个 token,一张图默认 280 tokens(单独放图约 29 张),视频每帧 140 tokens(约 58 帧,默认每秒抽 1 帧),音频每秒 25 tokens(约 327 秒)。2 混着放就把预算摊薄。文本和媒体交错时用占位符标位置:
<|image|>、<|video|>、<|audio|>,每个占位符按顺序取对应的输入,整段只输出一个向量。2 图像的视觉 token 预算可以在 70 到 1120 之间调,调高换质量、换来更高的延迟。2官方自测:代码领先,多语种文本让位给更大的模型
Google 在模型页上放了一张六列对照表,把自己和一代、Jina v5 Omni-Nano(986M)、Qwen3-Embedding-0.6B、SigLIP-SO400M(878M)、larger-clap-general(194M)并列。5
| 评测项 | EmbeddingGemma 2(740M) | EmbeddingGemma(308M) | Jina v5 Omni-Nano(986M) | Qwen3-Embedding-0.6B | SigLIP-SO400M(878M) | larger-clap-general(194M) |
|---|---|---|---|---|---|---|
| MTEB 多语种文本 v2 | 61.4 | 61.2 | 65.5 | 64.3 | * | * |
| MTEB 英文文本 v2 | 68.5 | 69.7 | 71.1 | 70.7 | * | * |
| MTEB 代码 v1 | 78.7 | 68.8 | — | 75.4 | * | * |
| MIEB(lite) | 64.6 | * | 49.4 | * | 53.5 | * |
| MMEB v2 图像 | 57.3 | * | 31.6** | * | — | * |
| MMEB v2 视觉文档 | 67.8 | * | 71.4** | * | — | * |
| MMEB v2 视频 | 50.7 | * | 31.2** | * | — | * |
| MSEB 检索 | 69.5 | * | — | * | * | — |
| MAEB | 49.4 | * | 50.1 | * | * | 35 |
表下官方图例:— 表示暂无数据,* 表示该模型不支持这一模态,** 表示该数字并非该模型方自报。上表数字出自 Google DeepMind 模型页,一代与二代两列在 模型卡 里还有两位小数的版本(多语种 61.36 对 61.15、代码 78.68 对 68.76)。
这张表的读法是分模态的。代码检索一项 EmbeddingGemma 2 拿到 78.7,比 Qwen3-Embedding-0.6B 的 75.4 高 3.3 分,Jina v5 Omni-Nano 那一格是「暂无数据」;图像检索它比 Jina 高 25.7 分,视频检索高 19.5 分;到了多语种与英文文本两项,两个更大的文本嵌入模型都排在它前面,英文一项它比自家一代低 1.2 分。视觉文档与音频检索两项,Jina v5 Omni-Nano 略高(67.8 对 71.4、49.4 对 50.1)。5
官方另有一句口径值得记下:这代在代码上的提升是相对一代的 14%,多语种文本则是「保持一代的水准」。9
向量可以裁到六分之一
EmbeddingGemma 2 用 Matryoshka 表示学习(MRL,把向量按嵌套顺序训练,允许只保留前若干维)训练,768 维的向量可以截断到 512、256、128 维再重新归一化。2 官方给出的四档分数如下。
| 输出维度 | 压缩比 | MTEB 多语种 | MTEB 英文 | MTEB 代码 | MIEB | MMEB v2 总体 | MSEB | MAEB |
|---|---|---|---|---|---|---|---|---|
| 768 维(完整) | 1:1 | 61.36 | 68.46 | 78.68 | 64.64 | 59.01 | 69.54 | 49.39 |
| 512 维 | 1:1.5 | 61.17 | 68.41 | 77.24 | 64.32 | 58.38 | 69.18 | 49.21 |
| 256 维 | 1:3 | 60.41 | 67.78 | 76.18 | 63.13 | 56.24 | 66.76 | 48.91 |
| 128 维 | 1:6 | 57.89 | 65.68 | 71.41 | 59.06 | 45.65 | 56.71 | 46.92 |
数据出自 模型卡。官方给的适用面是:256 维保留大部分文本与代码质量、图像视频语音检索约为完整版质量的 95%,适合存储吃紧的索引;128 维的文本与代码约保留九成,图像、视频、语音检索掉到七成五左右,官方建议只在纯文本索引或召回初筛里用,多模态场景要拿自己的数据先验一遍。9
落到体积上:bfloat16 精度下,100 万条 768 维向量约 1.5 GB,截到 128 维约 250 MB。9 两处官方材料对压缩倍数的写法不一致——发布博客与模型卡写「最多 6 倍」,端侧博客写「最多 8 倍」,768 除以 128 是 6 倍。18
另外两个容易踩的点:截断后必须重新做 L2 归一化,否则相似度排序会静默变差;查询与文档必须用同一个维度。2
端侧能跑到什么程度
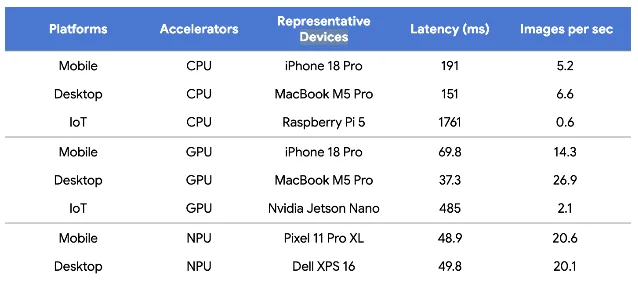
内存这一侧,官方在 Pixel 11 Pro 上给出量化后的数字:只加载文本权重时活动内存约 191MB,全模态约 567MB。1 官方为此做了 INT4 与 INT8 的量化感知训练。8 这组数字解释了一个取舍:文本、文本加图像、文本加音频、全模态四种加载方式的参数量分别是 270M、440M、570M、740M,它们共享同一个检查点,先建了纯文本索引,之后再加装图像或音频编码器,已经算好的向量不用重算。9
有一个运行时约束官方写得很直白:用 bfloat16 或 float32 推理,不要用 float16——这一版的激活范围超出 float16 的动态范围,在 float16 下模型会返回 NaN 或静默劣化的向量,而不是报错。2
第三方独立评测:这一轮没有
MTEB、MIEB、MMEB v2、MSEB、MAEB 都是公开的社区基准,分数由提交方用基准方的流程跑出来,Google 这次给的就是自己的提交结果,模型卡里也逐项标注了度量口径。2 本轮核验没有查到任何机构独立复跑这套结果:收录模型元数据的第三方站点 BenchLM 已经把 EmbeddingGemma 2 建档,同时注明它「还是一条可展示的基准记录都没有」;以对话与生成模型为主的独立评测站(Artificial Analysis、OpenRouter 一类)本轮也查不到这个模型的条目。6
能查到的第三方内容都是发布当天的介绍与转述,没有独立测试结果。10 换句话说,上面所有分数都该按「Google 自己跑的」来读。
拿到它,以及价格
权重在 Hugging Face 与 Kaggle 上都能下载,许可为 Apache 2.0,没有按 token 计费这一层。111 服务端与本地推理栈已经跟上:transformers、sentence-transformers、vLLM、SGLang、llama.cpp、Ollama、LM Studio、MLX 都能加载,官方仓库页还挂了 Unsloth 的微调指南 与 Qdrant 的向量库接入示例。1
端侧这条线还多两样东西:Hugging Face 上有量化好的 LiteRT 版 与 GGUF 版,MediaPipe 的通用嵌入任务与语义检索任务也把这一版收了进去,可以直接拿到归一化后的 768 维或截断维度向量。121314 Android 侧的 ML Kit 与 Gemini Enterprise Agent Platform 的 Model Garden 都标为「即将」提供。18
该不该试
- 你现在用 EmbeddingGemma 一代。 换过去要把整个语料库重新嵌入一遍,索引也得重建;能换回来的是代码检索(78.68 对 68.76)和图像、视频、音频三种新模态,多语种文本基本原地不动,英文文本反而低一点。2
- 你现在把图像描述、语音转写、文本嵌入串成一条链。 这一版把三步并成一次调用,端侧可跑、没有按次费用,官方举的例子是用一段录音里的声音去找视频里的那一段。8
- 你只做多语种或纯英文文本检索。 Jina v5 Omni-Nano 与 Qwen3-Embedding-0.6B 在那两项上都更高,先拿自己的语料对齐一次再决定要不要换。5
- 你的瓶颈是向量存储。 256 维那一档保留大部分文本与代码质量,体积降到三分之一,是性价比最高的一档;128 维留给纯文本。9
- 你要在手机、离线或涉密环境里做检索。 这是目前少见的把五种模态装进 740M 的开源选择,量化后文本版权重约 191MB 活动内存,官方在 Pixel 11 Pro XL 的 NPU 上给出 48.9 毫秒、每秒 20.6 张图的视觉编码速度。18
还没有的数字
References
- 1
- 2EmbeddingGemma 2 model card
ai.google.dev
- 3EmbeddingGemma
ai.google.dev
- 4Gemma Prohibited Use Policy
ai.google.dev
- 5EmbeddingGemma
deepmind.google
- 6
- 7google/embeddinggemma-2
huggingface.co
- 8Bring multimodal semantic search to the edge with EmbeddingGemma 2
developers.googleblog.com
- 9EmbeddingGemma 2: The Developer Guide
developers.googleblog.com
- 10
- 11EmbeddingGemma 2
kaggle.com
- 12embeddinggemma-2-740m-litert-lm
huggingface.co
- 13embeddinggemma-2-GGUF
huggingface.co
- 14MediaPipe Universal Embedder Task
developers.google.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.