Gemini 3.8 Flash TTS:音色变成可生成的对象,每分钟 1.35 美分的价只写到 2026 年底
解读 Google 2026 年 9 月 23 日发布的 Gemini 3.8 Flash TTS 与 Flash-Lite TTS:音色可以按提示词生成、用 10–30 秒样音复刻,本文拆开官方两张评测表里它赢在哪一行、没赢在哪一行,并算清每分钟 1.35 美分的限时价在 2027 年翻倍之后还剩多少优势。

2026 年 9 月 23 日,Google 发布两款语音合成模型 Gemini 3.8 Flash TTS 与 Gemini 3.8 Flash-Lite TTS,官方称这是他们「最有表现力的音频生成模型」,同一天在 Gemini API、Google AI Studio 上线,并进入 Gemini Notebook 与 Google Vids1。
这次发布值得单独拿出来读的地方有两处。一是音色本身变成了可以生成、可以复刻、可以当作 ID 管理的东西,工作流从「从菜单里挑一个」变成「先造一个再带着走」;二是官方自己贴出的评测表里,有两行它不是第一,而那两行恰好是「像不像人」最直接的读数。
音色从 30 个预设变成两种创建方式
Gemini 3.8 TTS 的语音来源现在是四种:30 个预置录音棚音色、Extended Voice Library、声音设计(Voice design)与声音复刻(Voice replication)2。后两种是这一代新开的——被它替代的
gemini-3.1-flash-tts-preview 在这两项上都标着不支持3。两条创建路径的接口分别是
POST /v1beta/voices 的 type="prompted" 与 type="replicated",都能返回一个持久的 voice_... ID,可以直接当成 speech_config 里的 voice 传下去2。声音复刻的门槛写在文档里:需要同一位成年说话人的两段真人录音,一段 10–30 秒的参考音频,加一段按指定句式念出的同意声明(30 个语种各有指定句子,英文那句是 "I am the owner of this voice and I consent to Google using this voice to create a synthetic voice model.")4。官方博客说的「30 秒样本」是这段参考音频的上界。真正改变工程习惯的是这两类音色有额度和有效期:
| 存储方式 | ID 形态 | 项目额度 | 保留期 |
|---|---|---|---|
store=True(设计或复刻,默认) | voice_... | 每项目 200 个,两类共享 | 1 年 |
store=False(仅复刻,客户端自管) | voicekey_... | 由调用方保管 | 7 天 |
音色因此是项目里带生命周期、可以用
voices.list()、voices.get()、voices.delete() 管理的资源,不是一次性参数4。周更或年番这类要跨月复用同一把嗓子的项目,得自己管住续期和替换。配套的提示词习惯也换了。官方文档把「Audio Profile」「Director's Notes」这类多段人设描写列为声音漂移的最常见来源,建议的做法是在声音设计里把角色一次做出来,之后每轮只带
voice_... ID 加一个很短的 style,多数请求甚至不需要 style2。还有一条硬约束值得先知道:单次请求里的双说话人对白只支持预置音色;要用自己设计或复刻的音色做多角色对话,得按轮分别合成,再把 24 kHz 的 PCM 帧拼起来2。官方把「原生双说话人场景编排」写进了发布页,但自定义音色那条路要自己搭。
音色的总数,两份官方材料给的量级不一样:博客写「2,000+ 生产可用音色」1,接口文档写的是 30 个预置音色,加上 Extended Voice Library 再提供「数百个」2。哪个口径对,
GET /v1beta/voices 一次就能问清楚。官方表里它赢在哪一行,没赢在哪一行
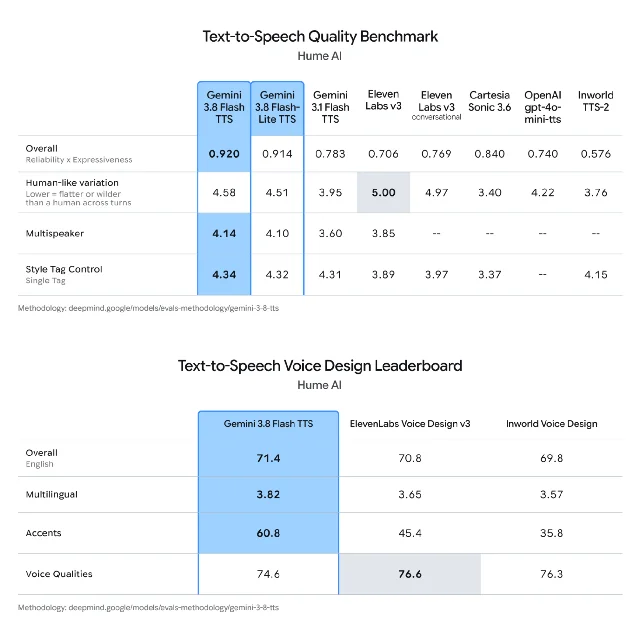
| 指标 | 3.8 Flash TTS | 3.8 Flash-Lite TTS | 3.1 Flash TTS | ElevenLabs v3 | ElevenLabs v3 对话版 | Cartesia Sonic 3.6 | OpenAI gpt-4o-mini-tts | Inworld TTS-2 |
|---|---|---|---|---|---|---|---|---|
| 综合(可靠性 × 表现力) | 0.920 | 0.914 | 0.783 | 0.706 | 0.769 | 0.840 | 0.740 | 0.576 |
| 类人变化度 | 4.58 | 4.51 | 3.95 | 5.00 | 4.97 | 3.40 | 4.22 | 3.76 |
| 多说话人 | 4.14 | 4.10 | 3.60 | 3.85 | — | — | — | — |
| 风格标签控制(单标签) | 4.34 | 4.32 | 4.31 | 3.89 | 3.97 | 3.37 | — | 4.15 |
数值取自官方评测方法页5。加粗为行内最高。
「类人变化度」这一行官方给了方向说明:数值越低,表示比真人更呆板或更夸张;5.00 是这八个系统里的最高分。
于是「最有表现力」这句话落到坐标里是这样的:综合分(可靠性 × 表现力)0.920 第一,多说话人 4.14 第一,风格标签控制 4.34 第一;但同一张表里最接近真人变化的那一行,最高分归 ElevenLabs v3 的 5.00,Gemini 的 4.58 排在它和自家对话版(4.97)之后。
第二张表把同一件事摊得更开。声音设计的综合分(英语)71.4 排在 ElevenLabs Voice Design v3 的 70.8 与 Inworld 的 69.8 之前,口音这一行 60.8 对 45.4 和 35.8 是整张表里差距最大的一处;但「声音质量」这一行 74.6 落在 ElevenLabs 的 76.6 与 Inworld 的 76.3 之后5。
这两张表的评测口径也写在方法页上:用生产检查点、默认采样参数、单次生成(pass@1),在受控听音小组与盲比竞技场里做5。分数由 Hume AI 这套基准产出,Hume AI 本身是一家做语音 AI 的公司,其基准公开在 arXiv:2607.14846(2026 年 7 月)6。这是第三方在跑,不是自评;但发布页只放了自家领先或追平的行与语种,不是全量榜。
第三方榜上排第一,前五名统计上打平
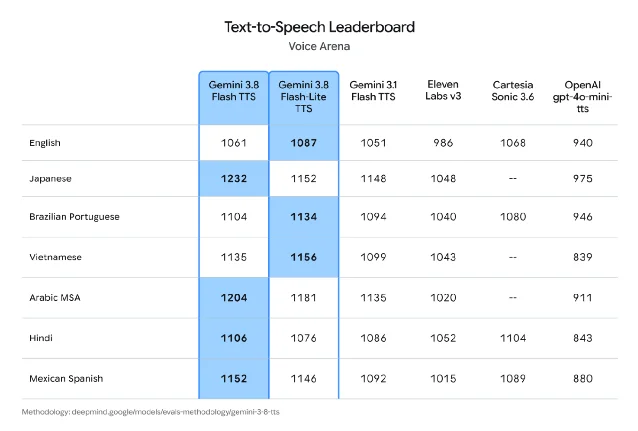
把它放进榜单里读得更准:Voice Arena 的美式英语榜现在的前五名里,这两款占了两个位置。
| 名次 | 模型 | Elo(95% 区间) | 名次区间 | 票数 | 入榜 |
|---|---|---|---|---|---|
| 1 | Gemini 3.8 Flash-Lite TTS | 1087 ±15 | 1–4 | 636 | 2026-09 |
| 2 | Cartesia Sonic-3.6 | 1068 ±13 | 1–5 | 1004 | 2026-08 |
| 3 | Gemini 3.8 Flash TTS | 1061 ±12 | 1–5 | 1161 | 2026-09 |
| 4 | Inworld Realtime TTS 2(研究预览) | 1058 ±15 | 1–6 | 849 | 2026-09 |
| 5 | Gemini 3.1 Flash TTS | 1057 ±6 | 2–5 | 6123 | 2026-04 |
数值与区间取自 Voice Arena 美式英语榜当前快照7。
三处读法比名次本身有用。
第一,前五名的名次区间(1–4、1–5、1–5、1–6、2–5)全部互相重叠。按榜单自己的规则,名次区间重叠就是统计打平8。能说的是它在前五里占了两席,不能说它拉开了差距。
第二,便宜的那一档排在贵的那一档前面。Flash-Lite 1087、Flash 1061,两者的区间是 1072–1102 对 1049–1073,几乎相接。这不是孤例:官方那张七语种表里,Lite 在英语、巴西葡语、越南语上领先,Flash 在日语、阿拉伯语 MSA、印地语、墨西哥西语上领先5。文档给的差别是定位而非能力:两款在单说话人、双说话人、声音设计、声音复刻四项上都打勾,Flash 走录音棚级创意与方言,Lite 走高吞吐、低延迟与复刻2。
第三,这张榜测的不是这次的新能力。方法页写明它只评各家官方目录里的音色、不评声音克隆;还明确列了不测的东西:延迟、实时率、每字或每分钟成本、复刻相似度、语音识别的准确率、语音智能体端到端表现8。所以「声音设计」与「声音复刻」好不好用,这张榜给不出答案;它榜上 Gemini 两条的延迟列也是空的7。
还有一处口径差值得顺手记住:官方表里 Gemini 3.1 Flash TTS 的英语是 1051,榜上实时是 1057,OpenAI 那款从 940 变成 92957。榜单在持续累积投票,官方那张表是发布当时的一次快照,票数少的模型区间也更宽。
每分钟音频多少钱,以及一条 25 token/秒的脚注
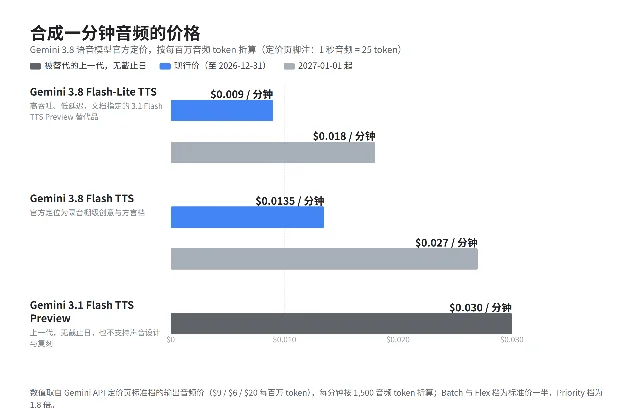
定价页是按 token 报的,好在 TTS 两节下面都写同一条脚注:1 秒音频对应 25 token9。一分钟就是 1,500 token,把每百万 token 的价乘 1,500,每分钟的钱就出来了。
| 模型 | 输入文本(每百万 token) | 输出音频(每百万 token) | 折算每分钟音频 | 2027-01-01 起每分钟 |
|---|---|---|---|---|
gemini-3.8-flash-tts | $0.50 | $9.00 | $0.0135 | $0.027 |
gemini-3.8-flash-lite-tts | $0.50 | $6.00 | $0.0090 | $0.018 |
gemini-3.1-flash-tts-preview | $1.00 | $20.00 | $0.0300 | 无截止日 |
数值取自官方定价页标准档9。每分钟一列为本文按 25 token/秒折算,官方未直接给出。
账单几乎全在输出音频上。输入文本按 $0.50 每百万 token 算,一万英文词约 1.3 万 token,成本约 $0.0065;同一万词合成成一小时音频,按 Flash TTS 现价是 $0.81。
真正需要留意的是这一代两档挂的都是限时价。定价页写明 $9.00 与 $6.00 的有效期到 2026 年 12 月 31 日,2027 年 1 月 1 日起变成 $18.00 与 $12.009。把它和被替代的
gemini-3.1-flash-tts-preview(输出 $20.00,页面上没有截止日)放在一起:- 限时价期内,Flash TTS 每分钟 $0.0135,比上一代便宜 55%;Flash-Lite 每分钟 $0.0090,便宜 70%。
- 2027 年 1 月 1 日起,Flash TTS 每分钟 $0.027,只便宜 10%;Flash-Lite $0.018,便宜 40%。
两款模型各另有三档调用方式:Batch 与 Flex 是标准价的一半,Priority 是 1.8 倍9。博客把大批量配音列为用途1,那种场景走 Batch 才是实际单价——Flash-Lite 的 Batch 档折算下来是每分钟 $0.0045。
接进去之前会先撞到的五条边界
单次生成的输出上限,两份官方页写得不一样。 模型卡写的是这两款模型「音频,输出 64K token」10,模型页给的是输出 token 上限 16,384、输入 8,1923。按 25 token/秒折算,16,384 约合 10.9 分钟,65,536 约合 43.7 分钟——官方没有直接给时长上限,这个换算是本文做的。它决定一章有声书要切成几段:博客把「数小时连续音频、说话人不漂移」写进卖点,而在任一条上限下,数小时都必须靠多次请求续接,续接的具体做法官方文档没有写。
声音复刻有地区限制。 博客的脚注写明,通过 AI Studio 做声音复刻在美国 Illinois 与 Texas,以及 EEA、英国、瑞士、印度不提供1。
输出格式换了默认值,升级会碰到。 3.8 的 TTS 在非流式请求下默认返回带 RIFF 头的 WAV,而 3.1 及更早的 TTS 默认返回无头的裸 PCM;如果你的代码里自己包过 WAV 头,升级时要把它去掉,需要裸 PCM 就显式指定
audio/l163。另外两款模型都有真正的流式返回(默认是无头 16 位 PCM 分块),实时级联场景用得上2。它们只能文本进、音频出。 模型页把函数调用、搜索接地、URL 上下文、Live API 全部标为不支持3。做实时语音智能体要自己把识别、对话、合成拼成级联;发布页列的 Agora、LiveKit、Pipecat、Vercel 就是这类拼装层1。
语种数也有两处口径。 博客写「超过 100 种语言和方言」1,模型页给的是 Flash TTS 130 种、Flash-Lite TTS 101 种311——如果目标语种只落在 Lite 的名单里,这一条是选型依据。
安全口径可以一并收在这里:每段生成的音频都织入 SynthID 不可感知水印,复刻产物带 C2PA 凭证,创建复刻音色前必须过同意验证112。模型卡写明 Gemini 3.8 Audio 基于 Gemini 3 Pro,这一次的前沿安全评估沿用 Gemini 3.7 Flash 的结论——未触及受追踪或临界能力等级,依据是 3.8 Audio 相对 3.7 Flash 没有实质新能力或显著性能提升;已知限制列出幻觉、仍在改进的越狱抵抗、偶发的变慢或超时,知识截止为 2025 年 1 月10。
三件可以带走的事,四项还要等
带走的:音色变成了带额度和有效期的项目资源,设计靠提示词、复刻靠 10–30 秒样音加同意声明,每项目 200 个、保留 1 年,接之前先想清楚谁来管它的生命周期。官方表里它赢的是综合分与口音,类人变化度与声音质量两行的最高分仍归 ElevenLabs;第三方榜上它在前五占了两个位置,但前五名统计上打平,而且那张榜不覆盖这次的两个新能力。每分钟 0.9 到 1.35 美分是限时价,2027 年 1 月 1 日翻倍,届时相对它要替代的那一代只剩 10%(Flash)与 40%(Flash-Lite)的优势。
References
- 1Gemini 3.8 text-to-speech says hello
deepmind.google
- 2Text-to-speech generation (TTS)
ai.google.dev
- 3Gemini 3.8 Flash TTS
ai.google.dev
- 4Voice replication
ai.google.dev
- 5
- 6
- 7Voice Arena TTS US English leaderboard
voicearena.com
- 8Voice Arena methodology
voicearena.com
- 9Gemini Developer API pricing
ai.google.dev
- 10Gemini 3.8 Audio model card
deepmind.google
- 11Gemini 3.8 Flash-Lite TTS
ai.google.dev
- 12SynthID
deepmind.google
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.