AGI新战场谷歌亚马逊巨头激战,杀出个中国LimiX-2赢了又赢
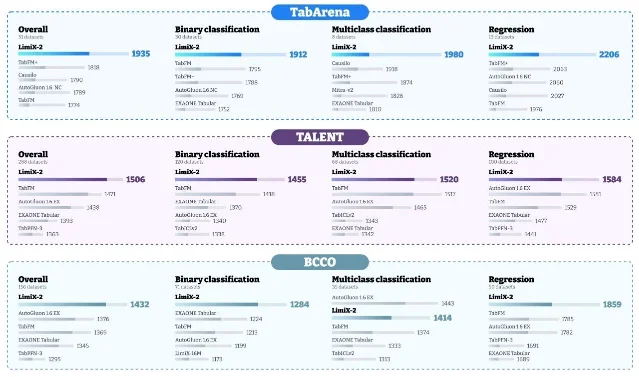
量子位报道稳准智能与清华团队发布 400M 参数的结构化数据基础模型 LimiX-2:把学习目标从预测 Y 改为建模变量之间的关系,在 TabArena、TALENT、BCCO 三个基准的二分类、多分类与回归任务上位列第一。

转载说明:本文转载自微信公众号「量子位」官方账号(biz_id:MzIzNjc1NzUzMw),原文发表于 2026 年 9 月 18 日 20:17,作者署名「梦瑶 发自 凹非寺量子位 | 公众号 QbitAI」。原文链接:[量子位微信公众号原文](http://mp.weixin.qq.com/s?__biz=MzIzNjc1NzUzMw&mid=2247924531&idx=1&sn=b1e06939c8ac4efbe2213e834677002d),同题文章另见量子位官网 qbitai.com。
9 月 15 日,德国软件巨头 SAP 先发布了 TabPFN-3.5。按原文的记述,几小时后(9 月 16 日),一支由清华博士组成的团队发布了 400M 参数的结构化数据基础模型 LimiX-2 1。
原文给出的成绩是:LimiX-2 在 TabArena、TALENT、BCCO 三个国际主流基准的二分类、多分类和回归任务上均排名第一,超过 Google TabFM、TabPFN、TabICL、Mitra 等模型 1。发布方是稳准智能,首席科学家为清华大学计算机系教授崔鹏,也是 LDM 理念的提出者之一。
稳准智能不是第一次在这个方向上上榜。去年他们发布的 LimiX 是国内首个结构化数据基础模型,霸榜了很长一段时间。原文转述这支团队的说法:
「真正重要的,从来不是拿下一次第一,而是每到关键节点,都有能力重新回到第一。」
语言模型之外,另一条处理表格数据的路线
LDM 指 Large Data Model,即结构化数据基础模型,目标是让基础模型直接学习不同结构化数据里的变量关系、条件关系和生成机制 1。
原文解释的差别落在信息空间上。LLM 处理的是已经完成语义化的现实:文本、代码、论文、数学公式,以及经过标注和描述的图像与视频。这些知识都经过人类一次理解、筛选和抽象,再被编码成 Token。
产业系统里的另一类数据落在这一层之外。以制造业为例,温度、压力、转速、原料配比、设备状态、能耗等几十、几百甚至上千个变量同时变化,构成一个持续演化的高维空间,其中大量规律没有被写成规则、公式或文本 1。
产业关心的也不只是单个变量的取值。原文列举的是另外几件事:变量之间存在什么稳定关系,哪些关系能跨环境成立,以及一个变量变化之后,系统整体会如何响应。
如果先把这类数据转写成文本再交给 LLM,中间会经历一次信息压缩。在生产系统里,被压缩掉的细粒度差异可能直接决定预测精度、良率和风险判断。
巨头入场的方式各不相同。Google 今年发布 TabFM,把表格数据基础模型纳入自己的基础模型版图;Amazon 推出 Mitra,探索一个预训练模型如何在不同的表格和任务之间直接迁移。
SAP 的动作更大:先做 SAP-RPT-1,今年收购 TabPFN 背后的 Prior Labs,投入超过 10 亿欧元扩建结构化数据 AI 研究团队。几天前,TabPFN-3.5 Plus 进入 SAP AI Core,开始处理现金流预测、付款延迟、供应商风险、客户流失这些企业决策任务 1。
换掉学习目标:从预测 Y 到学变量之间的关系
TabPFN 代表的 PFN 路线目标很直接:给定上下文和目标,让模型快速适应一张新表,把 Y 预测准。这条路线在分类、回归上适配很快,推动了表格基础模型的发展 1。
原文在这里提出的疑问是:「如果我们想知道的,已经不止是『Y 等于多少』呢?」
LimiX-2 改的是模型「学什么」。团队提出上下文机制网络 Contextual Mechanism Networks(CMNs),把结构化数据建模从以目标变量为中心的预测问题,推进为面向全变量联合依赖和数据生成机制的关系建模问题。
技术报告把两个学习目标写成了两个式子。PFN 类模型围绕 p(y | x, D_context) 组织网络,CMNs 则围绕 p(x, y | D_context),学习与上下文相关的数据生成联合结构 2。原文把这套范式切换类比成大语言模型从 BERT 走向 GPT。
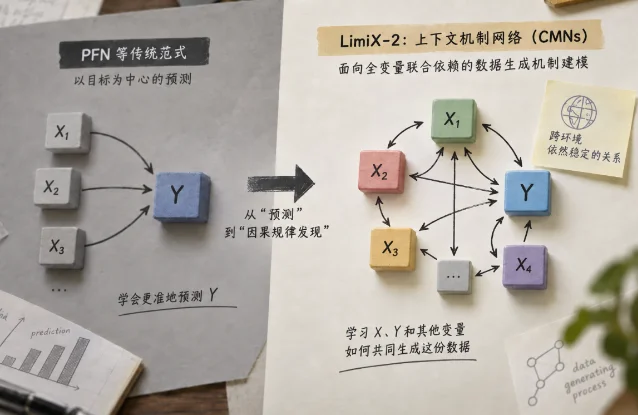
新目标需要新的训练方式。团队提出上下文条件掩码建模(CCMM):不断遮住、预测不同的变量,逼着模型从预测单一目标转向学习变量之间的条件依赖与联合结构,等于不停给它换题 1。
底层表示也跟着往下沉到 Cell-Level:以单元格作为基础表示单元,保留列身份、具体取值和缺失状态,支持跨变量、跨样本的信息交互。这样一来,分类、回归、缺失值填补都可以统一成对同一个数据模型的不同查询。
权重页面上对应的说法是:一个预训练模型在一次前向传播里完成分类、回归和缺失值填补,不需要按任务更新参数 3。
三个基准上,分类和回归都排在第一
分类任务回答的是「它属于哪一种状态」:设备会不会故障、客户会不会流失、一笔交易是否存在风险。这类任务要求模型从大量变量里找出真正影响结果的信号 1。
原文在 TabArena 上按 Elo 排名给出的结果是:LimiX-2 四项指标均居第一,Elo 达到 1917,领先 TabFM+ 143 分 1。
回归任务考的是另一件事:模型要理解连续变量之间的依赖关系,再把这种关系压到一个足够准确的数值预测上。在 TabArena 的回归任务里,LimiX-2 四项指标同样第一,Elo 达到 2206 1。
训练数据一侧也做了升级。CMNs 把学习目标扩展到变量关系建模,对数据多样性的要求随之提高,LimiX-2 因此升级了大规模自动化合成数据引擎,覆盖更多分布、交互关系和噪声类型 1。技术报告里的对应做法,是用结构因果模型(SCM)生成的合成数据集做预训练,覆盖不同的图结构、函数机制和观测过程 2。
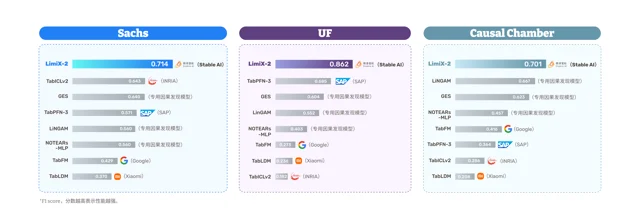
除了分类和回归,LimiX-2 也把能力推向因果发现。在 Sachs、UF、Causal Chamber 等公开数据集上,原文称 LimiX-2 领先多种传统因果发现方法 1。
原文留下的判断
原文把 LDM 的能力路径写成一条链:从 Prediction 走向 Relationship、Causality、Intervention、Decision,让 AI 进一步理解真实世界里的变量关系、生成机制和变化规律 1。
收束处回到 2020 年 GPT-3 问世那一刻。原文的判断是,LDM 这块竞争场域指向的,可能是决定下一阶段 AI 能力上限的「GPT-3 时刻」:
「让大模型从理解人类已经表达出来的知识,进一步走向理解世界运行本身。」
想自己核对的,技术报告是《LimiX-2: A Contextual Mechanism Network Towards General Structured-Data Intelligence》,2026 年 9 月 15 日提交到 arXiv;权重与推理代码发布在 Hugging Face、ModelScope 与 GitHub,仓库目前有 4.2k star(截至 2026 年 9 月 19 日)4。权重按非商用许可(StableAI LimiX Non-Commercial License)发布,使用范围以该许可为准 3。
References
- 1AGI新战场谷歌亚马逊巨头激战,杀出个中国LimiX-2赢了又赢
mp.weixin.qq.com
- 2
- 3stable-ai/LimiX-2
huggingface.co
- 4limix-ldm-ai/LimiX
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.