Claude 形状的科学:三个月 36 篇手稿,判据是笔记本上能算到任意精度
解读 Anthropic 2026 年 10 月 1 日刊出的客座稿《Claude-shaped science》:理论物理学家 Matthew Schwartz 换了做法,不再让 Claude 假装是科学家,而是专门去找「Claude 形状」的题,为此建了 BootLoops 工具包;本文拆开它的验收标准、铺开的读数,以及哪些数字目前还只有作者一方的账。

10 月 1 日,Anthropic 的 Science 栏目刊出一篇客座稿《Claude-shaped science》,作者是高能理论物理学家 Matthew Schwartz,页面标注的发布时刻是北京时间当天 22 点 02 分1。这是他第二次在这里写同一件事:去年 12 月的《Vibe physics》里,他拿 Claude Opus 4.5 当研究助理,结论是它像一位很强的研究生、速度是他的 20 倍,代价是他要一句句改,还要不断把模型从岔路上拉回来2。
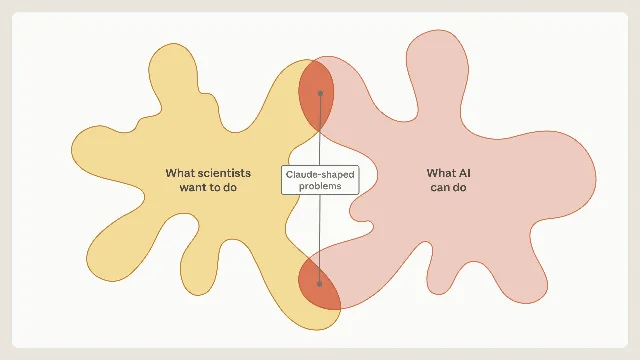
这一篇讲他换了做法之后发生的事。他不再把 Claude 当成他希望的那种合作者,而是当成它实际是的那种合作者,然后专门去找「Claude 形状」的题,也就是最适合当前这代模型能力的那一类。为此他建了一套叫 BootLoops 的工具包,三个月里牵出 36 篇手稿、18 个领域、19 位合作者,候选题目约 400 个1。
「阻抗失配」:把问题倒过来问
他的诊断是,模型很强,但「像人类科学家一样工作」这件事当前的大模型做不好。他借来物理学的说法叫阻抗失配(impedance mismatch):两个各自正常的系统匹配得不好,输入端的大部分东西到不了另一头1。他列出模型真正强的四件事:跨所有领域的知识面、编码能力、数学与统计的前沿知识,以及以机器速度读论文和数据。
他找的第一类「AI 形状」的题,是高能物理里的半数值自举(semi-numerical bootstrap)。散射振幅是大型强子对撞机数据与理论之间的那座桥。传统自举靠物理约束把可能性一路砍到只剩一个答案,可是越接近真实世界,约束越容易在走到终点前用光;半数值自举的补法是,再在少数几个点上把振幅算到极端精度,有时要到 1000 位,用这些数把剩下的系数钉死1。这套方法的论文是 arXiv:2507.17815,2025 年 7 月 23 日提交,作者是 Oscar Barrera、Aurélien Dersy、Rabia Husain、Matthew D. Schwartz 和 Xiaoyuan Zhang。摘要写的方法是,用高精度数值采样加上对函数空间的先验知识,配格基约化反推出精确解析式,定位是补上自上而下的 Landau 自举4。
这类题落在「Claude 形状」里,有三个理由。它横跨数学、物理和计算机,没有一个人全都掌握;它需要大量编码和算法开发;它可核验,同一套数值让任何人写两个脚本,就能把答案对着积分验到任意位数1。作者还补了一句现场情况:这个共同体的专长分布得很散,好点子分别在 Wolfram 语言、C++、Python、Julia 里,更多埋在根本没有代码的论文里。
结果分两层。他先把这批东西整体移植到一个共同框架,Claude 用约 20 分钟复现了他当年花几周写出来的结果;再往下,30 个积分端到端跑通,其中 15 个是用这套新方法复现已知结果,15 个此前从未被算出来1。
起作用的是那套验收标准
BootLoops 属于 harness 这一层,也就是套在模型外面、让模型能把活干完的外壳与协议。它和 Claude Code、Claude Science 是同一层东西,区别在于它不绑定模型。项目站把它描述成一堆从数学、物理、计算机科学移植或新写的工具,供模型调用,外加一批协议——测试、验收门、标准,规定什么工具什么时候用、输出意味着什么、答案要过什么测试才算数35。Claude、Gemini、ChatGPT 都能驱动它;代码开源在公开仓库,MIT 许可,文档 CC BY 4.06。驱动 BootLoops 1.0 的是 Claude,振幅那一段用的是 Fable 513。
整套东西的准入判据叫 BootLoops 标准:一个图算不算被解决,看两件事,完整的函数形式是已知的,并且一个 Python 脚本能在笔记本上把它算到任意精度3。任意精度这个要求是冲着作弊去的,它逼着代码不能藏着有限精度的网格或者预先算好的边界常数。振幅那边惯常的做法是两条路线对算:一边用移植进来的 AMFlow 高精度算原积分,一边用解析式算到同样的精度,对上 30 位算过,常常会跑到 100 位。作者的原话是,有了 30 位,它没法作弊5。预测还会先用 SHA 指纹封存,事后才能证明没有被改过、没有去迎合测试,项目站把这个动作明确写成防 reward hacking3。
有一段演示解释了「多算几位」和「知道自己算对了」的区别。项目站拿 Muller 递推举例:x₁₀₀ 的真值是一个 79 位与 78 位整数之比的精确分数,等于 6.000000016099565。用定长浮点,精度低于 119 位时结果会跑到 100 附近,而且没有任何提示;到 300 位,结果是对的,同样没有任何提示说它是对的。换成带证书半径的球算术,每一步都带着一个被证明的误差范围走,一旦某个除数球包含 0,半径就变成无穷大,球仍然包含真值,但什么也没证明,中心值退回成那个没有证书的定长数,于是它给不出一个自信的错答案3。这套算术还有一条不对称:球能证明两个数不同,因为半径永远到不了零,球证明不了它们相等。相等要靠精确那一侧,把量算成精确分数,或者先用 PSLQ 从数字里猜出恒等式,再用符号方法证明3。
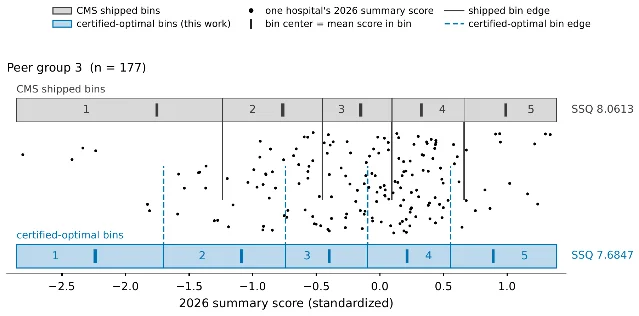
精度这条标准在别处也值钱。项目站举的例子是美国的 Medicare 星级评定:规则手册写着一个切分点的最优性判据,实际用的是启发式。BootLoops 把那个判据精确解出来,项目站说这个问题的最优解从 1958 年起就可算,再拿它去量生产输出,结论是公布的阈值在 123 次近期计算里有 104 次不符合自己声明的判据;换用认证最优的分箱,2025 到 2027 三个支付年度里大约 9 亿到 14 亿美元的奖金会重新分配7。这个例子出自项目站,不在那篇客座稿里。
同一批积分,落在生态、遗传、语言和经济学里
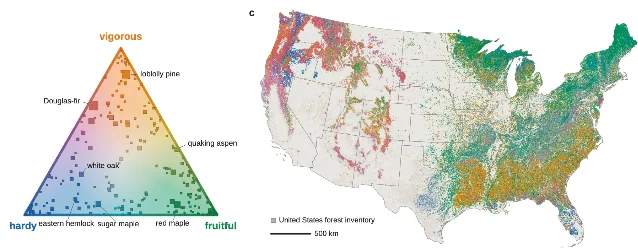
生态学那一条最完整。中性理论想问的是,一个生态系统里物种的兴衰有多少只是随机。2005 年 Rampal Etienne 给 Hubbell 的这套想法配上一个方程,让它原则上可以被精确检验8;此后二十年,没人能在规模上把它解出来。Claude 认出 Etienne 的方程是 BootLoops 形状的,把它解了,再套到数据上:在巴拿马运河的 Barro Colorado 岛上,也就是地球上研究得最多的那片森林,树种构成的变化速度是中性理论允许的 4.5 倍1。
这个数字没能说服生态学家。作者把结果拿给植物学教授 James O'Dwyer 看,对方佩服技术,但说它「会被很多生态学家耸耸肩」带过,因为这些人早就更定性地知道中性理论跟不上真实森林。O'Dwyer 给了另一条路:把中性预测减掉,去看剩下的那部分,那才是自然选择、竞争和物种差异的痕迹。最后做出来的模型在项目站上有底细:50 公顷样地、1982 年以来八次普查、每次约 2.1 万棵树、230 多个物种;两个最常见的树种,Faramea occidentalis 从 1,227 棵涨到 2,082 棵,Trichilia tuberculata 从 2,021 棵掉到 1,180 棵,两条曲线都远远跑出「只靠随机漂变」能解释的范围9。
群体遗传那一条是同一套积分换了个对象。Claude 用从数学物理借来的方法,解出一个描述「自然选择如何塑造稀有突变」的积分表达式;客座稿写它 30 年没被解出,项目站写那条公式已经 60 年110。它被用到 gnomAD 上,那是目前最大的公开人类遗传变异目录11。作者自己对结果将信将疑,写信问了三位生物学家才约到同事 Michael Desai 做验证。对方的反应和生态学那次接近:技术漂亮,科学上不算要紧,但指出了一条更值钱的路——去看同一条染色体上成对突变之间的相关性。这条路让工具包长出了新工具,比如数学里做计算机辅助证明用的不等式证书;最后分析了 1000 基因组计划里 57 亿对邻近突变,找到基因转换(gene conversion)的证据112。项目站另有一组读数:用 gnomAD 约 73 万份人类外显子、146 万份基因组拷贝做拟合,大多数导致基因失活的突变落在数据能分辨的最强选择区间;标准软件在它们被设计来处理的样本规模上大多可靠,项目站还给出一张「从哪个规模开始失准」的地图10。
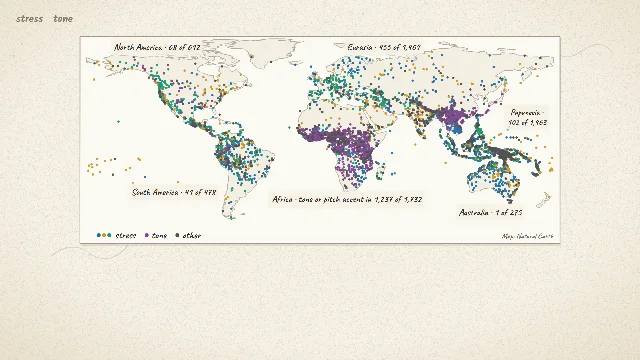
语言学那一条的产物完全公开。AccStack 收录 6,072 种语言的词重音与声调,每一条都引用它依据的原文段落;另有 160,654 篇文献、覆盖 8,600 种语言的目录,以及一个能精确列举重音类型的计算器13。站点自己标着 beta,一切都在复核中,配套论文标注为 preliminary13。
经济学那一条是四条里唯一走到正式工作论文序列的。NBER 工作论文 35782《An LLM Workflow That Reproduces, Improves, and Extends Published Economics Research》,作者 Matthew Schwartz、Isaiah Andrews、Jesse M. Shapiro,2026 年 9 月14。摘要给了客座稿没写的三个数:跨五个经济学刊物的 4,452 份复现包,工作流在 3,460 篇论文或附录里标出与已发表结果对不上的地方;在 496 篇里把某一步计算的时间降到原来的十分之一以下而精度不降;在 923 篇里给出原文没有、但与原文目标和假设一致的扩展。论文自己写明,这篇文章的分析和写作都用了大模型,Schwartz 在这个项目里的身份是 Anthropic 的合同工,结果和观点不获 Anthropic 背书14。
剩下的一批成果,客座稿用一段话列出来,每条都注明是与领域专家合作、且仍在进一步探索和验证:系统发育(把进化树的贝叶斯证据做成可精确核验的,发现单基因经常让两棵树之间的差距小于标准采样程序的误差)、地球科学(把大气科学、地球化学和气候模型的方程与数据拼成大氧化事件的定量模型)、基因组(单细胞 RNA 计数的统计,看它离教科书里的基因表达模型有多远)、太阳黑子(用人口统计的方法推断生命周期,再扩到 509 颗恒星上的星斑)、数学物理(Watson 从 1939 年开始算的格点积分,客座稿写「解出了」,项目站写「证明了 1939 年以来被寻找的那个闭形式从来不存在」)、宇宙学(两圈功率谱与一圈三谱)、统计(混合模型的贝叶斯证据近似)13。
作者自己记下的失败模式
这一段是全篇最可复用的部分,因为它记的是操作经验。他列出的几条:
- 爱宣布胜利。「带一个星号的完成」往往等于「根本没完成」,「基本就是这样,只有一点小修」通常等于「不」。有个项目它很得意地交出一个证明,只剩「一个未证明的引理」,而那个引理就是整个证明。
- 每一张图自己看。 即使架了监控,自动检查也不可信;提防「吻合得很好」这类定性说法。
- 追着问结论。 它擅长算,结论却可能是错的;让它一直解释到你信为止。
- 品味由人供给。 Claude 能找到 Claude 形状的问题,但这样的问题有成千上万。它偏爱老的、被高引但被遗忘的争论;让它盯住「新出现的可能」比让它追求更快或更多位数有用,但什么算有趣,仍然不能交给它判断。
- 追问下一步。 拿到一个好结果后再要一个更大的,它总能给出来,偶尔确实漂亮。
- 提防磨洋工。 他从来没让模型把时间估计对过,估得要么太长要么太短;后来靠自己对「这类事该花多久」的手感来判断进展。它倾向于硬啃一个要跑好几天的计算,而不是先造一个把同一件事压到几分钟的工具,作者反复要说的那句是「聪明点,别更用力」。
工程侧他也写了。所有 Claude Code 会话跑在 Google Cloud 虚拟机上的终端里,按项目分会话,另有一个总管会话负责调度算力、校验结果;每个会话里的子智能体会在后台跑计算,把中间结果写成 markdown。子智能体有个实际好处:撞上 Fable 5 的分类器时,封掉的只是一个 agent,整个会话还在。他还有单独会话负责写结果、建仓库和手册、写并校验工具代码,以及当「对抗性审稿人」反复复核。上下文压缩会丢东西,所以他让模型周期性地整理文件。最后一句是,这些项目吃算力和 token1。
哪些能查,哪些还只是一方的账
材料的性质先摆清楚:这是一篇客座稿,是作者对自己项目的叙述,没有走同行评议;文中明说这些项目仍在进一步探索和验证1。36 篇手稿、18 个领域、19 位合作者、约 400 个候选题目,这几个数字出自这篇客座稿本身;项目站另写「应用横跨二十二个领域」,两个口径不一样13。
能自己动手查的有四处。NBER 工作论文,前面写过的三个数,连同它自己的披露14;AccStack,公开可浏览,每条都带引文,站点自称 beta、论文标注 preliminary13;BootLoops 仓库,MIT 许可、文档 CC BY 4.0,2026 年 10 月 1 日 15 点 29 分(UTC)创建,也就是客座稿发布大约一个半小时之后,到现在还是 0 关注、0 分支6;以及这套方法的学术来源 arXiv:2507.178154。
项目站自己标出了两处问题。大氧化模型里,按模型算出的第三次冰期结束时间,比已定年的火山灰层允许的晚约 2000 万年15;生态那个模型,项目站写普查数据所要求的比模型成分所能允许的简单得多,换个森林还成不成立是开放的9。
同一批 Anthropic Science 材料里还有一份值得并读的对照。9 月 23 日那篇自主发现新酶系统的预印本,记录了一次明确的复现失败:同一套 campaign 重跑 10 次,那个重复阵列一次都没再被发现16。那是一次开放式搜索,本来就没有能把答案判死的判据;BootLoops 这条线恰恰相反,它只做答案能被判真伪的题。两件事放在一起,这份手记的边界就出来了:它证明的是「答案可验算时,AI 能承担的工作量可以很大」,再往外那一层,材料没有给出证据。
现在能下的判断
这份手记给出的最有用的东西是一条可操作的判据:把「AI 做科学」的可行域收缩到答案能被独立判真伪的问题上,再把这条判据工程化成一个不绑定模型的工具包。判据越硬,能在笔记本上算到任意精度、能对着积分验到 30 位,能交出去的工作就越多;判据越软,什么算有趣、值不值得挖,人就越是不可省。作者列出的失败模式,全部落在软的那一侧。
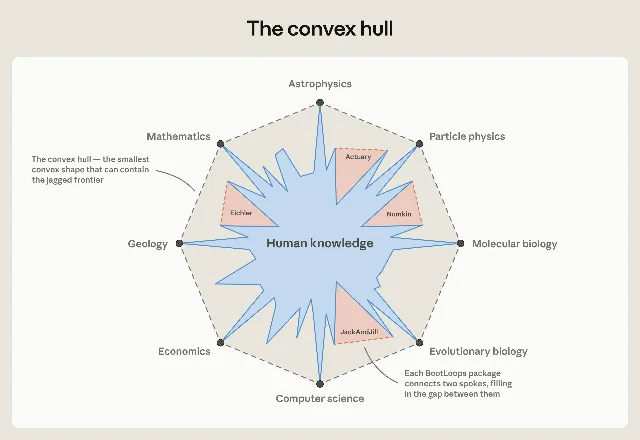
对做产品与工程的人,真正可搬的是那层「验收门」:工具、约定,以及答案要过什么测试才算数。它和「等一个更强的模型」是两条不同的路。按作者的说法,harness 可以由人和模型一起改进,不必等前沿实验室的超级计算机3。
还有两件事现在没有答案。那 36 篇手稿里有多少能走到同行评议,要等;把这套「任意精度可复算」的标准搬到判据本身就有争议的领域会剩下什么,作者给的答案是,需要领域专家来供给「什么才算有意思」,而这一步他承认自己也是摸索着做的1。
References
- 1Claude-shaped science
anthropic.com
- 2Vibe physics: The AI grad student
anthropic.com
- 3BootLoops
bootloops.ai
- 4
- 5The BootLoops harness
bootloops.ai
- 6BootLoops-ai/bootloops
github.com
- 7Medicare stars
bootloops.ai
- 8
- 9A forest deciphered
bootloops.ai
- 10The strength of natural selection
bootloops.ai
- 11gnomAD
gnomad.broadinstitute.org
- 121000 Genomes Project
internationalgenome.org
- 13ACCSTACK
accstack.org
- 14NBER Working Paper 35782
nber.org
- 15How Earth's air got its oxygen
bootloops.ai
- 16
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.