奇绩信号Alpha Sight 2026年9月25日【文字版】
从 2026 年 9 月 23 日 arXiv 最新批次精选十五篇论文:AI 家教与人类家教在 GRE 学习增益上等价的对照实验、高维潜空间扩散难训的成因与一行级解法、验证器与教师信号的两级信用分配、把长程想象与实时执行拆成两台时钟的灵巧操作架构,以及把「能力上限」还原为答案约定偏差的评测研究。

本期从 2026 年 9 月 23 日提交、9 月 24 日在 arXiv 公开可见的最新批次中精选十五篇前沿 AI 论文。
AI 科技评论注意到,这批论文在做同一件事:把平时留在系统内部、没人去量的那些东西——记忆、深度、信用、代价、状态、读出方式——做成可以计量、可以调度、可以被别人复算的接口。
一份综述把视频生成的「记忆」拆成载体、功能、生命周期、学习与评测五个可讨论的维度;一篇论文发现视觉语言模型的「能力上限」其实来自答案的约定方式;一篇论文把长程机器人的想象与实时反应拆成两套异步时钟;还有一篇把短视 feed 的观看时长从一个数改成一条分布。
我们按头条、认知模型、多模态、具身智能、AI4Science、Infra、Agent、应用体系、Benchmark 九个板块呈现本期内容。
头条
1. AI 家教和人类家教在 GRE 上打平了——StudentBench 用二千三百八十三名学生把「会不会教」拆成五张榜单原文
信号源:Handshake AI(原论文 arXiv 版本未展开作者单位署名,论文在伦理声明中披露该研究由 Handshake AI 资助、在其平台完成)
🎓
认知提取
教人一直是少数没法被标准分数测量的能力。这篇论文把它放进测量范围:让十三位大模型家教和真人家教上同一套 GRE 课,只比较一件事——学生前后测的分数涨了多少。
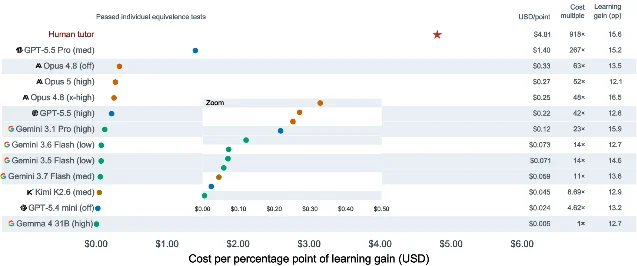
结论是等价:AI 家教与真人专家家教的平均学习增益在统计上不可区分。更值得记住的是成本那一栏:在通过单模型等价性检验的家教里,最便宜的模型把每一分学习增益的成本压到人类参照的九百一十八分之一。
它还顺手拆掉了一个常见幻觉:家长和学校想要的「教得好」,其实是五件可以分开排名的能力,而同一家的模型会挤成一团。
论文摘要
• 论文把问题放在「递归的人类自我改进」这个框架里:教学技术要提高人的能力,才有资格谈下一轮。原文引言
• 研究通过 Handshake 平台邀请约七万名随机抽取的学生,最终纳入二千三百八十三名学生、二千四百六十九场有效会话,覆盖 GRE 的 Quant 与 Verbal 两科,累计留下十七万五千条以上学生与 AI 的对话消息。原文实验设计
• 每场会话的结构固定:二十七题前测(Quant 四十七分钟、Verbal 四十一分钟,长度与时限对齐真实 GRE),五分钟复盘错题,进入三种条件之一学习一小时,再做同长度后测。原文实验设计
• 判定用的是等价性检验而不是「谁更高」:在正负零点二五个标准差与正负零点二〇个标准差两个更严的边界下,合并 AI 与人类家教的整体差异都落在预先声明的等价区间内。原文主要结果
• 论文同时披露:这一批 AI 家教包含非前沿与开放权重模型;学习增益只测了即时后测,长期保持没有测。原文局限
核心方法
• 研究不是训练新模型,而是搭一套可复用的评测装置:十三位 LLM 家教分别负责备课(生成教案与练习题)与实时对话辅导,接入统一的学生界面。原文研究设计
• 学生被随机分配到 AI 家教、真专家家教或空白对照;空白对照不做真题练习,因此论文明确说明它无法分离「AI 家教」与「单纯刷题」的差别。原文局限
• 教学质量的评价交给真专家:二千零二十八组两两比较的评分,拆成教案设计(九千五百七十七条评分、三百八十一份前测)与练习题设计(五千二百六十五条、三百八十份)两张榜单,用 Bradley–Terry 模型拟合偏好。原文教学质量评价
• 教学行为不靠专家主观印象,而是六条固定的对话规则(例如要求学生先解释、针对具体错误给帮助、留出尝试空间),对一千九百七十一段 AI 对话与一百三十五段真人对话逐条打分;真人组是语音辅导、AI 组是打字对话,论文提示两者只能在同一面板内比较。原文对话教学
• 成本用可复算的口径:按会话内实际记录或重建的推理花费统计(覆盖百分之九十七的 API 调用),真人参照取市场价每小时七十五美元。原文成本口径
实验成果
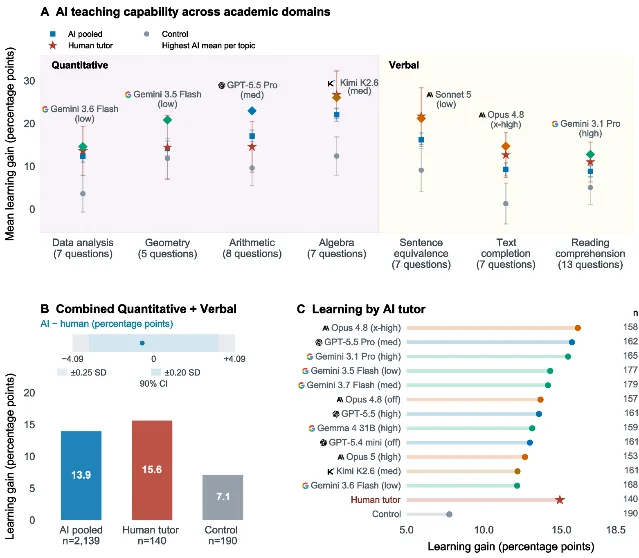
• 等价性的主结论:合并 AI 与人类家教的差距为负零点五八个百分点,百分之九十区间从负二点一八到正一点零三;在正负零点二五个标准差的边界下 p 等于零点零一五,收紧到正负零点二〇个标准差后 p 等于零点零二三。原文主要结果
• 相对空白对照的增益更直观:Quant 科目高出六点八六个百分点(百分之九十五区间四点零二到九点六九),Verbal 高出五点四七(二点四六到八点四七),合并高出六点一五(四点零八到八点二一),折合约二十七题里多答对一点五到两题。原文主要结果
• 分域看,最强的 AI 家教在七个子域中的五个超过真人平均,而且不同子域由不同模型领先;Verbal 三个子域上真人平均仍高于 AI 合并平均。原文分域结果
• 成本端的核心数字:一个家教的单点学习增益成本为零点零零五二美元,真人参照为四点八一美元,相差九百一十八倍;Gemini 3.5 Flash 达到与 GPT-5.5 Pro 相近的学习增益,成本只有其约二十分之一。原文明细
• 排行榜确实能分开模型:教案与练习两张榜单上多数模型对之间的区间不重叠;Anthropic 系模型在这两项和对话指标上都靠前。学生标记「我不同意这个答案」的比例也有记录,最高的一个家教被质疑的比例约为 Quant 练习题的百分之十一,论文强调这是学生的主观异议、不是被验证的错误。原文教学质量评价
• 对话特征按模型家族成簇,不同家族之间没有重叠,论文据此提出:教学风格可能来自厂商层面的训练取向,而不是单个模型的偶然。原文对话教学
总结与反思
• 结果总结: 这项研究真正的贡献是把「AI 会不会教」变成了可复核的对照实验:在同一个前测—干预—后测结构下,合并 AI 家教与真人专家家教的增益等价,而价格差了两个数量级。
• 局限性: 论文自己列得相当完整:只测即时增益、不测数月后的保持;参与者全是能用英文读写的成年人,通过一个付费招募平台进入,跨语言、跨设备、跨教育场景都没测;没有「独自刷题」这一对照,因此无法分离家教与练习本身的贡献;两张教学质量榜单衡量的是专家偏好与对话行为,不是学习增益。
• 前沿见解: 如果教学质量的瓶颈真的是「家教数量」而不是「家教智商」,那么这条路线带来的不是替代教师,而是把一对一辅导的边际成本压到接近零——真正需要重新设计的,是学校用什么信号来判断一个学生需要哪种辅导。
2. 高维潜空间的扩散模型难训,原因不在容量——把预测目标从速度换成干净数据,GenEval 从三十点九六回到三十九点四八原文
信号源:康奈尔大学、Adobe、弗吉尼亚理工、华盛顿大学、马里兰大学
🧭
认知提取
生成模型现在喜欢把图像压进预训练视觉编码器的特征空间里再扩散,因为语义特征比像素更好用。可为了让重建更清晰而微调编码器之后,一个反直觉的副作用出现了:表征的有效维度大幅塌缩,标准的「速度预测」目标反而变得难训。
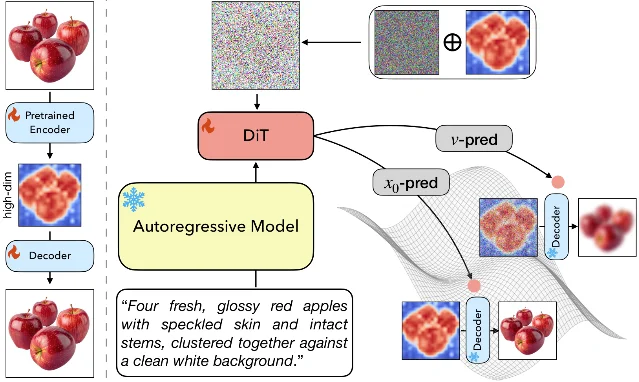
论文把原因算清楚了——在高维空间里,噪声方向的分量占比过大,模型被迫花容量去拟合与信号无关的方向。
补救办法简单到近乎朴素:让模型直接预测干净数据的表征。在两个强重建编码器上,这个换法都稳定提高了文生图质量。
论文摘要
• 问题起点是一个已经存在的取舍:表示自编码器(RAE)在预训练视觉编码器的特征空间里做扩散,但现成编码器为了语义而丢掉了细节,重建保真度不够。原文引言
• 论文指出,为重建微调编码器能把细节找回来,却让表征的有效维度显著下降,而这种几何变化会反过来影响生成的可训练性。原文引言
• 分析落在一个可量化的机制上:标准流匹配用速度作为目标,速度里垂直于信号流形的分量在高维情形下会主导目标能量,模型因此把容量花在了无信息的方向上。原文方法
• 由此给出的建议是改用干净数据预测(x₀ 预测),把学习集中到信号流形上;论文在两个强重建编码器上验证了这一改动,并给出了放大数据集后的结果。原文实验
• 实现细节按可复现口径给出:冻结的 Qwen3-VL-2B-Instruct 做文本编码,一 B 参数的 DiT 做主干,六十四枚 query token,全局批一千零二十四,训练九万步,用六十四张 A100 或三十二张 H200。原文实现细节
核心方法
• 目标层面的改动只有一句话:把训练目标从速度 v 换成干净表征 x₀,所有其他设置(时间调度、采样器、条件方式)保持不变,使对比只反映目标函数。原文方法
• 编码器侧使用两条路线验证普适性:一条把 DINOv2-L 在重建目标上解冻微调,并额外加一项语义保持损失防止塌陷;另一条沿用 MAE 预训练加 ViT-XL 解码器的现成组合。原文强重建自编码器
• 论文用归一化奇异值衰减与累计解释方差刻画「有效维度」,把「塌缩」从直觉变成可测的曲线,并额外在 ImageNet-21k、BLIP3o、CC12M 三个数据集上重复该分析以确认结论不是单一数据集的产物。原文有效维度分析
• 生成侧用一 B 参数的扩散 Transformer 与一百步 Euler 采样器评测,评价指标取 COCO-30k 的 FID、GenEval 与 DPG-Bench。原文评测设置
实验成果
• 塌缩是可量化的:全维仍是一千零二十四,但微调后 R90 由六百七十二降到一百二十九、R95 由八百一十一降到三百零二、R99 由九百六十五降到七百二十六,而重建 PSNR 从十七点三四升到二十九点一二。原文有效维度与重建
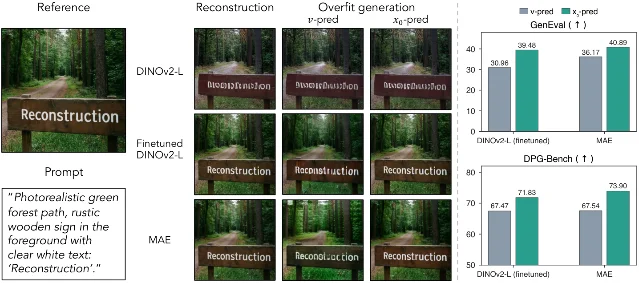
• 换目标后的生成质量同步改善:同一微调编码器上,GenEval 从三十点九六升到三十九点四八,DPG-Bench 从六十七点四七升到七十一点八三,FID 从二十九点九七降到十六点八〇。原文文生图对比
• 结论在第二个编码器上复现:MAE-RAE 上 GenEval 从三十六点一七升到四十点八九,DPG-Bench 从六十七点五四升到七十三点九〇,FID 从二十二点二〇降到十七点二四。原文消融
• 放大到九千万张图的数据集后,一 B 参数 DiT 在监督微调前 GenEval 为四十三点八四、DPG-Bench 为七十六点一五;加入六万步微调后分别升到七十八点六二与八十点一三,分辨率提到五百一十二后为七十九点六九与八十一点一五,论文同时给出一个二点四 B 参数基线作为参照(七十七点四三与七十八点四七)。原文规模实验
• 编码器侧也有一条耐人寻味的对照:把同一个微调编码器压到三十二维再用速度预测,GenEval 反而有四十点九九——低维空间里速度预测没那么难,这从反面支持了论文对高维正交分量的解释。原文消融
总结与反思
• 结果总结: 这篇论文的价值在于把「高维潜空间难训」从经验抱怨变成了一个可推导、可测量、并有一行级解法的工程问题:换目标函数,不换架构。
• 局限性: 实验分辨率主要停在二百五十六,只在放大实验里触及五百一十二;结论建立在两个编码器与图像生成任务上,视频、三维等其他高维表征没有验证;论文的机制解释基于子空间模型,属于分析性论证而非穷尽的实证图谱。
• 前沿见解: 当生成模型越来越多地搬进别人的特征空间,表征的几何就不再只是编码器的事,而成了生成系统的设计约束;谁能先给出「可扩散性」的度量,谁就能在选编码器这件事上少走一轮试错。
3. 学生答错的题,老师的偏爱也说不准——UECR-GRPO 把「什么时候信老师」拆成路径与词元两级原文
信号源:上海交通大学、浙江大学
⚖️
认知提取
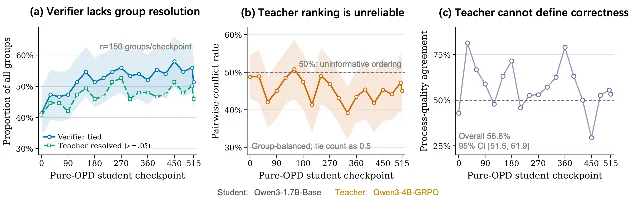
用可验证奖励做强化学习有一个老毛病:答案对错只给整段回复一个分数,于是关键的代数步骤、无关的语气词、以及第一个算错的地方,拿到的是同一个优势值。
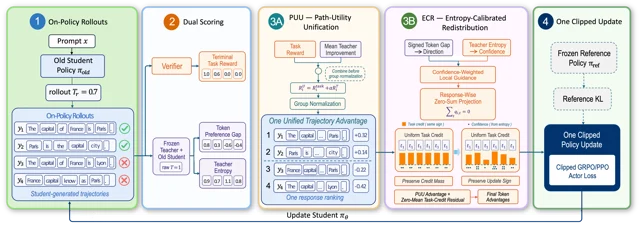
蒸馏能补上细粒度反馈,但老师的偏好并不等于正确性。这篇论文的做法是把两种信号放到同一层去合成:先让老师的分差和验证器分数一起决定整段回复的排名,再按老师的熵给词元级信用做一次零和分配。
两级分开之后,论文能分别回答两个问题:合并在归一化之前是否有用,以及词元级的局部分配是否还有额外收益。
论文摘要
• 论文指出的第一个漏洞在序列级:GRPO 的优势值只由最终答案对错决定,同一组回复如果奖励全相同,组内信号就整体消失。原文预置知识
• 第二个漏洞在合成方式:已有混合方法把教师信号接在验证器归一化之后,而词元重加权并不保证每段回复分到的任务信用总量不变,等于悄悄改了总预算。原文引言
• 论文先在十九个纯蒸馏检查点上做了信号诊断:在每组八条回复中,验证器无法区分对错的比例不低,而其中一部分组的教师分差足够大;教师偏好与盲评之间也存在冲突。原文信号互补性
• 方法因此设计成有序两层:路径效用统一(PUU)在组归一化之前合并验证器奖励与教师相对锚点的路径对数比;熵标定再分配(ECR)只重排验证器派生那部分信用。原文方法
• 评测沿用固定十二次采样的 Avg@12,覆盖 AIME 2024、AIME 2025、AMC 2023 与 2025 年二月、十一月的 HMMT,五项等权平均。原文实验设置
核心方法
• PUU 把验证器奖励与教师到锚点的路径对数比放进同一个 KL 正则目标里,且合并发生在组归一化和 PPO 裁剪之前,因此教师证据可以影响整段回复的排序,而不只是事后微调。原文路径效用统一
• ECR 用教师与旧策略的词元分差作为方向,用全词表教师熵作为不确定性权重:熵高的位置信号被压低,熵低的位置被放大。原文熵标定再分配
• 关键约束是一个按回复的零和投影:把教师派生的调整投影成均值为一,从而保持每段回复的任务信用总量与词元级符号都不变,再交给裁剪。原文熵标定再分配
• 训练设置给得很细:一点七 B 学生配四 B-GRPO 教师,在 DeepMath-103K 的难度五到七问题上训练五百一十五步;四 B 学生配八 B-Math-GRPO 教师,在难度六到八子集上训练一百六十步;两者都是每组八条回复,全局提示批一百二十六。原文实验设置
• 基线覆盖 Vanilla GRPO、Vanilla PG-OPD、直接相加、Distilled RL 与 ATOD 的单回复适配版本,同一规模内所有教师辅助方法共用同一个冻结打分器。原文基线
实验成果
• 一点七 B 学生上五项平均为十七点二一,超过最强的对齐版 ATOD 零点八九个百分点,并在 AIME24、AIME25、AMC23、HMMT25-Feb 四项上领先(分别高出零点五二、零点二八、一点八三、零点二八个百分点)。原文主要结果
• 四 B 学生上五项平均为六十五点零九,超过 Distilled RL 零点五六个百分点,但只在 AIME24 与 HMMT25-Feb 领先(零点二八与零点一八),在其余三项分别落后零点五六、零点一四与零点五六个百分点。原文主要结果
• 论文自己点出了这个不对称:平均分领先并不等于全面领先,四 B 规模上单项的第一名并不在同一套方法里。原文主要结果
• 离线诊断支持两层设计的意图:在一次词元信用诊断里,正负信用确实落在熵的不同十分位;ECR 的零和投影把每段回复的平均词元权重固定为一,使分配不影响总量。原文诊断
• 论文披露了教师偏好与验证器的一致性问题:在正确的与错误的回复配对上存在组平衡冲突,教师偏好并非正确性的代理。原文信号互补性
总结与反思
• 结果总结: 论文把「验证器只能判对错、老师只能给偏好」这对互补但不对齐的信号,整理成一个两级、可与 GRPO 兼容、且不改变任务信用总量的训练目标,两个规模上都拿到了平均分优势。
• 局限性: 增益幅度很小,四 B 规模的整体领先只有零点五六个百分点且单项有输有赢;实验集中在数学推理与 Qwen3 系列,未验证其他模型家族或非数学任务;教师信号的有效性依赖冻结教师本身的质量。
• 前沿见解: 当可验证奖励的颗粒度成为瓶颈,下一步的争点会从「换更好的奖励模型」转向「把不同来源的信号放进同一层归一化,并保证预算不被悄悄改写」——这一步决定了蒸馏到底是在传知识,还是在传偏见。
4. 慢系统负责想、快系统负责动——LiMA 把长程想象和实时灵巧操作拆成两台时钟原文
信号源:北京大学、北京人工智能研究院、多媒体信息处理国家重点实验室
链接:LiMA: Bridging Long-term Imagination to Real-time Dexterous Manipulation via Asynchronous Diffusion
🦾
认知提取
灵巧操作同时要两种能力:对几步之后局面的想象,以及对接触瞬间的反应。前者要慢、要长程,后者要快、要密。
现有做法要么让视觉语言动作模型硬扛物理直觉,要么让世界动作模型反复迭代生成,代价是每次动作都要等一长串去噪。
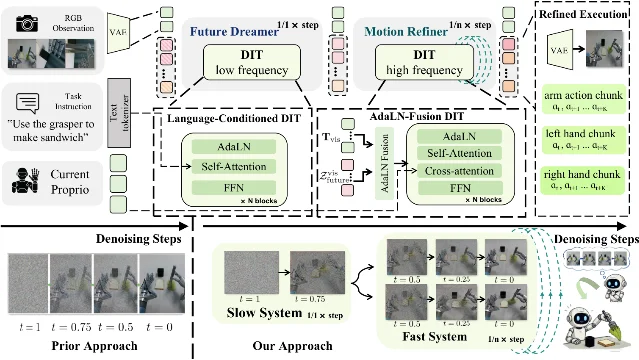
LiMA 把这两件事分给两个系统:慢的一侧稀疏地生成未来的时空意图,快的一侧高频细化动作;两者之间用一条隐空间上的薛定谔桥耦合,保证粗意图和细执行说的是同一件物理事实。
论文摘要
• 论文把问题定位为时间错配:视觉语言动作模型长于高层推理、弱于物理动力学与空间感知;世界动作模型则因为迭代生成承担了高推理延迟,导致模型意图跟不上接触状态的快速变化。原文引言
• 方法组织成一个多尺度层级:慢系统做稀疏的长程时空意图生成,快系统做稠密的高频动作细化。原文摘要
• 对齐两个系统的关键是隐空间薛定谔桥耦合:把细化过程写成熵正则化的概率输运问题,让稀疏意图作为边界条件参与细化。原文方法
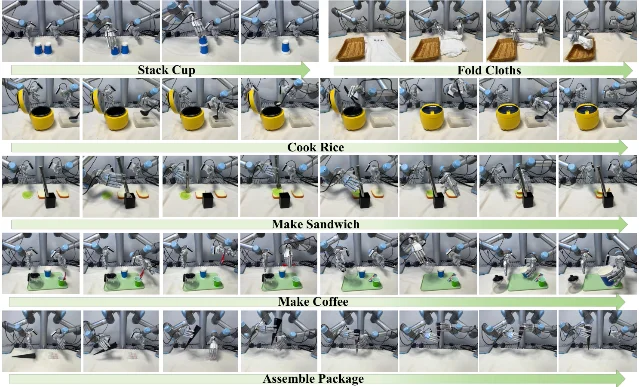
• 评测在真机上完成:六项双臂灵巧任务,每项二十次试验,对照四个最先进的基线(两个视觉语言动作模型、两个世界动作模型)。原文实验设置
• 平台细节完整披露:两台六自由度 UR5 机械臂配两副二十二自由度 SharpaWave 五指灵巧手,三路 RealSense D435 相机(头部一路、双腕各一路),每项任务采集一百条专家遥操作示范。原文实验设置
核心方法
• 异步调度的具体比例被明确写死:慢系统每四次快系统更新刷新一次(ΔT 等于四),论文按摊薄延迟计算平均推理时间,而不是取单次生成的峰值延迟。原文结果分析
• 耦合方式做了三种受控对照:去掉未来视觉意图、把细化器从高斯噪声初始化并只用交叉注意力注入意图、以及在同一架构下把薛定谔桥换成流匹配。原文消融
• 消融还覆盖去噪步数与快慢比例:步数从五到二十、慢快比从一比九到四比六逐一比较成功率与延迟。原文消融
• 速度比较在统一条件下进行:所有方法同一张 H100、同批大小与数值精度,不做算子融合、编译、量化或端侧优化,论文明确这是为了公平而不是为了刷榜。原文结果分析
实验成果
• 真机成功率:叠杯九十、卷 T 恤七十五、煮饭八十、做三明治七十、冲咖啡六十、装包裹五十(百分比);六项任务整体成功率七十点八,平均子任务成功率七十八点九。原文主表
• 延迟收益是这篇论文最硬的一栏:平均生成一段三十二步动作块需要三百二十五毫秒,而 Cosmos-Policy 为六百毫秒,降幅百分之四十五点八。原文结果分析
• 逐阶段成功率给出了失败位置的分布:在叠杯任务上两阶段为一百与九十;在做三明治这类四阶段任务上,成功率的衰减主要发生在后半程(九十、八十五、七十五、七十),说明长程任务失败更多来自中途状态衔接,而不是第一步抓取。原文逐阶段结果
• 桥设计消融说明耦合不是装饰:在煮饭任务上,完整 LiMA 为七十八点三(正负二点九),换成流匹配为七十三点三(正负二点九),去掉未来视觉意图降到六十一点七(正负七点六)。原文桥设计消融
• 快慢比例存在明显拐点:比例为一比九时成功率五十、二比八为六十五、三比七为八十、四比六回落到七十,延迟从零点二八秒升到零点三四秒;去噪步数以十步为佳(八十),五步只有六十五。原文消融
总结与反思
• 结果总结: 论文用真机实验给出一个清晰的架构判断:把「想」与「动」分成两台时钟,并用隐空间输运保持两者的语义一致,可以在不牺牲成功率的前提下把推理延迟砍掉近一半。
• 局限性: 论文自己承认在严重遮挡与视觉变化不足的场景下性能下降,因为规划本身依赖视觉;评测规模是六项任务、每项二十次试验,属于样机级证据;异步比例与去噪步数都需要按任务调参。
• 前沿见解: 当机器人开始做多阶段长程任务,评估的重心会从「单步成功率」转向「哪一段开始掉」;谁能把任务拆成可计分的阶段并把每阶段的延迟摊开写明,谁的系统就更容易被复现和迭代。
认知模型
5. 八千亿参数只激活一千三百亿——混元 A13B 把推理深度做成一个任务级开关原文
信号源:腾讯混元团队
🔀
认知提取
这份技术报告给出的核心取舍不在参数规模,而在算力花在哪一步:八十 B 总参数、十三 B 激活,把训练成本压在可部署区间,同时靠数据配比把数学与 STEM 拉上来。
更值得关注的是双模式思维链:同一个模型按任务复杂度选择「快想」还是「慢想」,把推理深度变成一次可以显式指定的开关,而不是隐含在提示词里。
对一个需要控制推理成本的产品来说,这比多爬几个榜单更有用。
论文摘要
• 模型是开源 MoE 架构,八十 B 总参数、推理时激活十三 B,上下文长度二百五十六 K,预训练语料为严格过滤后的二十 T token,并对 STEM 数据做了加强。原文摘要
• 结构细节:三十二层、三十二个注意力头、八个键值头、一个共享专家加六十四个专用专家(每次激活八个)、词表十二万八千、隐层四零九六。原文超参
• 后训练按四个步骤组织:面向推理的 SFT、面向推理的 RL、全场景 SFT、全场景 RL。原文后训练
• 双模式思维链是这一节的重点:快想服务于常规查询,慢想服务于多步复杂问题,模型按任务复杂度选择推理深度。原文双模式思维链
• 论文把评测分成预训练模型与后训练模型两套,并单独报告长上下文与推理效率。原文评测

核心方法
• 预训练强调数据而非规模:论文称语料经过严格过滤,并在 STEM 数据上加强,这两项与架构改动一起被列为相对前代的提升来源。原文预训练
• 后训练把「推理」与「通用」拆成两段 SFT 加两段 RL,避免一次混合训练里两类目标互相牵制。原文后训练
• 评测维度覆盖通用、代码、数学与多语言四类,预训练侧用 MMLU、MMLU-Pro、BBH、SuperGPQA、EvalPlus、MultiPL-E、MATH、GSM8K、GPQA 等;后训练侧补充 AIME、OlympiadBench、LiveCodeBench、ZebraLogic、DROP 与若干智能体工具调用基准。原文评测
• 效率单独作为一节报告:给出不同批大小与输入输出长度下的吞吐量,用于支撑「适合延迟敏感场景」的定位。原文推理效率
实验成果
• 预训练对比给出的结论是参数效率:相对上一代混元 Large,只有四分之一激活参数与约五分之一总参数时,在十四个评测中的十二个上更好;与总参数接近的 Qwen2.5-72B 相比几乎全部项目更高;与总参数约三倍、激活约两倍的 Qwen3-A22B 相比,十二项里有七项更高。原文预训练评测
• 推理模式的核心数字:AIME 2024 为八十七点三、AIME 2025 为七十六点八、MATH 为九十四点三、GPQA-Diamond 为七十一点二、BBH 为八十九点一、ZebraLogic 为八十四点七。原文慢想模式
• 智能体工具调用是这份报告里最亮的一栏:BFCL v3 为七十八点三、ComplexFuncBench 为六十一点二、C3-Bench 为六十三点五、τ-Bench 为五十四点七,其中 ComplexFuncBench 与 C3-Bench 明显高于同级对照。原文慢想模式
• 快想模式给出的取舍很清楚:延迟更低,但 AIME 2024 只有三十点六、AIME 2025 只有十九点二,LiveCodeBench 为二十七点四——同一模型两种模式的差距,说明「深度」确实是一个需要按任务显式选择的资源。原文快想模式
• 长上下文上,RULER 平均为七十六点七(对照 Gemini 2.5 Pro 八十一点七、DeepSeek R1 七十二点零、Qwen3-A22B 七十三点零),并在六十四 K 到一百二十八 K 这段以七十三点九领先三个对照;LongBench-v2 为五十五点零;PenguinScrolls 为八十七点七。原文长上下文评测
• 吞吐量按批大小给出:批一为每秒一百九十点八四 token,批十六为一千二百四十六点五四,批三十二为一千九百八十一点九九;批三十二、输出加长到二万二千五百二十八时为一千七百二十五点九五。原文推理效率
总结与反思
• 结果总结: 这份报告的主要信息不是某个榜单的第一名,而是把「十三 B 激活能到什么水平、以及推理深度可以按任务开关」两件事同时放到了可核对的表格里。
• 局限性: 作为技术报告,它没有给出与规模无关的消融来解释每项提升来自数据、架构还是后训练;对比表引用的对照模型版本与解码设置未逐一展开;双模式思维链的路由机制在报告中描述得比较概括。
• 前沿见解: 当开源模型的能力差距收窄到个位数百分点,竞争点会从「谁更强」转到「谁更可控」——把推理深度、上下文长度与吞吐量一起摆到台面上,本身就是一种产品化的信号。
6. 每个前缀都能算,只是代价从平方变成线性——对数深度循环语言模型把序列编码的扫描搬到了自回归预测原文
信号源:帝国理工学院计算系
🌀
认知提取
Transformer 的深度是固定的,代价随 token 数平方增长;循环模型开销线性,却没法并行。
这篇论文把序列编码里的平衡树递归算子搬到自回归预测上:先做一趟上扫建立层级表示,再做一趟下扫得到所有前缀表示,于是全部前缀都能在对数深度、线性开销下算完。
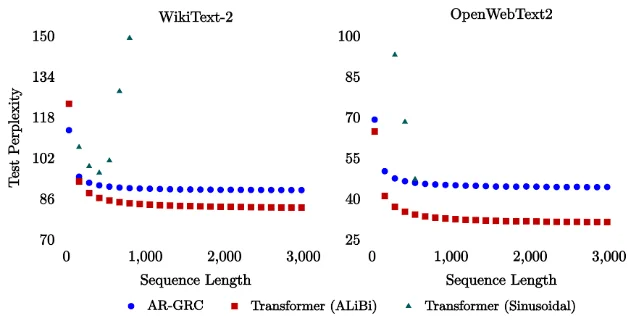
它没有宣称打败 Transformer,而是给出这类模型的第一份刻画——包括一个很实用的性质:训练只见过五百一十二个 token,测试到二千九百七十六个 token 时困惑度不崩。
论文摘要
• 论文的出发点是两类模型的互补缺陷:Transformer 深度固定、随输入长度平方增长;循环模型深度线性但无法并行计算。原文引言
• 做法是把序列编码中的平衡树递归算子扩展到自回归预测,使所有前缀表示都能以对数深度、线性运行时间获得。原文摘要
• 论文对自己的定位是审慎的:它提供的是这类模型的「初步刻画」,展示长度外推的稳健性与接近 ALiBi Transformer 的表现,而不是宣称替代。原文摘要
• 实验覆盖三个规模递增的语料:Penn Treebank、WikiText-2 与 OpenWebText2,参数规模分别约三百五十万、二千万与一亿,最大上下文一律五百一十二。原文实验
• 对照是有意挑选的:正弦位置编码与 ALiBi 位置编码的 Transformer,因为这两者直接检验「自回归预测能否在长度外推下保持」。原文实验
• 论文明确说明只做单种子(除 OpenWebText2 用三次随机种子),这是它结论强度的边界。原文实验
核心方法
• 核心是两趟扫描:上扫用平衡树建立层级表示,下扫复用这些表示产出所有独占前缀表示,从而在不重算前缀的前提下完成自回归预测。原文方法
• 模型名为 AR-GRC,论文还提供 AR-MLP-LDRU 作为算子替换的对照,用来判断结论是否依赖具体二元算子。原文方法
• 分词使用 SentencePiece 的 BPE,WikiText-2 词表八千、OpenWebText2 词表五万;模型参数量与 Transformer 基线对齐,这是可比的必要条件。原文实验
• 外推实验的设计是把测试序列从三十二个 token 逐步加到二千九百七十六个,步长一百二十八,远超训练时的五百一十二上限,用困惑度曲线看退化位置。原文实验
实验成果
• 短序列上基本打平:Penn Treebank 上 AR-GRC 困惑度为十四点三四,正弦编码 Transformer 为十二点六八、ALiBi 为十三点三四,论文给出的区间是高百分之七点五到十三点一。原文主表
• WikiText-2 上呈现交叉:AR-GRC 为九十点七四,比 ALiBi 的八十五点四九高百分之六点一,但比正弦编码的九十四点三零低百分之三点八。原文主表
• 更大的 OpenWebText2 上代价更明显:AR-GRC 为四十六点零八(正负零点零六),ALiBi 为三十四点四三(正负零点零三),差距在百分之二十三点五到三十三点八之间。原文主表
• 外推是这篇论文最有说服力的一栏:测试长度扩到二千九百七十六(约为训练长度的六倍)时,AR-GRC 与 ALiBi 都保持稳定,而正弦编码 Transformer 的困惑度在超过五百一十二后急剧上升。原文外推实验
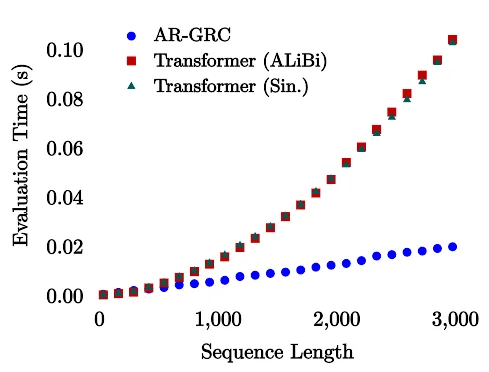
• 训练与推理开销随长度线性增长:论文报告每批评估时间随序列长度的变化,并给出线性运行时间的实测曲线。原文时间开销
总结与反思
• 结果总结: 论文把一个理论上有吸引力的性质做成了可测的模型:对数深度、线性开销、可并行,全部前缀都能算,并在长度外推上表现出与 ALiBi 同级的稳健性。
• 局限性: 语言建模质量整体落后于 Transformer,规模最大的一档差距最明显;除 OpenWebText2 外基本是单种子结果;模型规模停在约一亿参数,没有与更大模型的对照,因此结论应被读作「这条路可行」,而不是「这条路更好」。
• 前沿见解: 长上下文竞争的下半场可能不止有一种解法:如果线性开销与长度外推可以被一个对数深度的树状架构同时拿到,那么上下文窗口的成本结构就值得重新算一遍——这篇论文提供的正是那把尺子。
多模态
7. 视频生成的记忆问题,被拆成五个可以分开讨论的维度原文
信号源:香港科技大学、香港城市大学、复旦大学、卡内基梅隆大学、纽约大学、香港科技大学(广州)、新加坡国立大学、佐治亚理工学院、北京大学、穆罕默德·本·扎耶德人工智能大学、英伟达、中佛罗里达大学、特伦托大学、南洋理工大学、加州大学默塞德分校等
🎞️
认知提取
自回归视频生成有一个绕不过去的物理事实:上下文窗口、显存与算力都是有限的,而一段长视频里真正重要的信息——人物身份、空间布局、动态状态、某个动作引起的因果变化——往往在它还重要之前就被挤出了活跃上下文。
这篇综述的价值在于把「记忆」定义成一个可操作的动词:跨越自回归步被保留下来、并在原始证据已经不可见之后仍能影响生成的历史信息。
在这个定义下,整片文献被组织成五个可以分别讨论的问题:记忆用什么承载、要保住什么、生命周期怎么走、怎么学、怎么评。
论文摘要
• 论文先给出一个统一框架:把记忆定义为跨外层自回归步持续存在、且在原始证据不再局部可见后仍能影响后续生成的历史信息。原文摘要
• 记忆的必要性来自三重约束的同时收紧:上下文窗口有界、存储有界、计算有界。原文背景
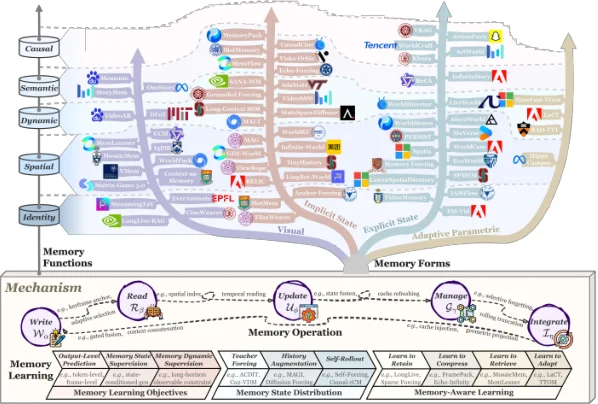
• 综述用五个互补视角组织文献:形式(历史由什么承载)、功能(哪些语义与物理信息需要被保住)、操作(写入、读取、更新、管理、整合的生命周期)、学习(闭环 rollout 下记忆行为的优化)、评测(如何诊断记忆能力)。原文摘要
• 论文把「无记忆 rollout 的失效模式」单列一节,说明这不是综述的修辞结构,而是一类可以被观察和分类的现象。原文背景
• 结语部分集中列出开放问题:可组合且资源感知的记忆架构、可信的状态更新、自 rollout 学习,以及标准化评测。原文摘要
核心方法
• 综述把自回归视频生成拆成两种内层生成方式(离散 token 自回归与连续帧/块的逐步生成),指出两种方式共享同一个外层因果 rollout 结构,因此记忆问题在它们之间是同一类问题。原文背景
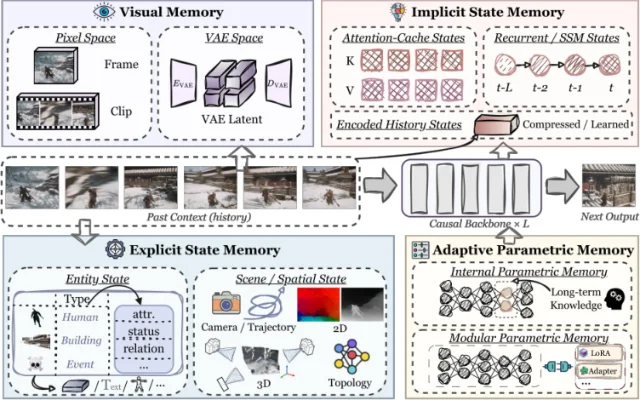
• 承载形式被分成四类:视觉记忆、隐式状态记忆、显式状态记忆与自适应参数记忆;论文强调它们可以组合,共同为因果主干提供条件。原文记忆载体
• 论文给出以载体为中心的分类表,逐项标注每个方法的驻留存储随 rollout 增长的方式(固定、有界、线性或随场景扩大)、单元结构(条目化、分布式、结构化、实体或混合)以及读取所用的索引信号,使方法之间可以逐字段比较。原文分类表
• 生命周期被拆成写入、读取、更新、管理与整合五个操作分别讨论,论文据此指出一个常见盲点:更新策略很少被单独评估,但它直接决定记忆是否会在长程 rollout 中积累错误。原文操作
• 评测一节区分了「看起来记住了」与「确实依赖记忆」两类证据,论文主张用诊断式评测来分清二者。原文评测
实验成果
• 这是一篇综述,没有新训练的实验结果;它交付的是结构化的文献地图与开放问题清单,因此本节按论文实际给出的信息呈现,不替换为其他论文的数字。
• 论文的「结果」体现为可比较的分类字段:每一条被收录的方法都被标注驻留存储的增长方式、单元结构与读取索引,读者可以据此判断某个方法是否适合自己场景的资源约束。原文分类表
• 论文明确列出四类开放问题作为后续工作的判断标准:可组合且资源感知的记忆架构、可信的状态更新、自 rollout 学习与标准化评测。原文摘要
• 未收录范围说明:本期未收录该综述的分类表全表(原文以长表格形式给出,含数十条方法的逐字段标注),也未收录其参考文献列表;正文的两张图取自原文。
总结与反思
• 结果总结: 它把视频生成里含糊的「记忆」拆成五个可以分别提问、分别评测的维度,并给出可逐字段比较的方法分类,这点对正在做长视频生成的团队最有直接价值。
• 局限性: 综述本身不提供新实验,其框架的覆盖完整性取决于文献选取;论文也承认领域演进很快并欢迎补充,因此分类表的边界会随时间移动。
• 前沿见解: 当生成模型的时间尺度被拉长,评测的焦点会从「画面像不像」转向「它记得住什么、什么时候忘、忘了之后错在哪」——评测范式的更新,会比多接一块记忆模块更能决定这条路的走向。
8. 它看起来不会数坐标,其实是答案的写法不给它机会——同一批照片换个选项约定,准确率相差四十八点五个百分点原文
信号源:哥伦比亚大学
📐
认知提取
基准给视觉语言模型的选项总有一种写法:字母、颜色名、像素坐标。这种写法一直被视为中性,论文证明它不是。
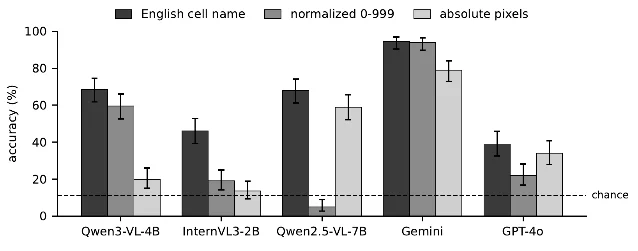
在同一批二百张 COCO 照片、同一组九个候选位置、同样的输出格式下,把选项从英文方位名换回像素坐标,某模型定位准确率从六十八点五掉到二十点〇,而随机基线是十一点一。
更关键的是这种差异会决定谁排第一:两个在英文方位下打平的模型,换到坐标约定后一个领先三十九个百分点,换到归一化约定后反过来差五十四点五个百分点。
论文摘要
• 论文的问题设定很窄:只改动六个候选选项的表述方式,刺激图、候选集合、候选顺序与输出格式全部固定。原文实验设计
• 主实验在 COCO val2017 的二百张照片上做定位任务:给出一个物体名字,从九个位置里选一个(随机基线百分之十一点一)。原文空间任务
• 还做了反向任务:给出位置、问那里是什么物体(六个选项,随机基线百分之十六点七),用来分离「读不到」与「说不出来」。原文空间任务
• 颜色任务用于验证这一现象不是空间坐标独有:六个颜色选项分别写成颜色词、整数标签、附带文字的色相角、只讲一次图例的色相角、以及单独的色相角。原文颜色任务
• 论文用一个「读谁」的实验区分「会用」与「不会用」某种约定:把错误的名字贴到每个坐标上,记录模型跟随坐标还是跟随名字。原文读谁
• 论文最后把自己也审了一遍:研究过程中有五次把「有能力的模型」误判成「没能力」,原因是打分脚本与模型对「什么算一个答案」理解不一致。原文自查
核心方法
• 唯一变量是选项的表述约定,因此结论不受题目难度变化的影响;论文还做了三乘三与四乘四两种网格,以及可见与缓存两种呈现条件。原文方法
• 统计上使用配对检验(同一照片内的精确 McNemar),并给出跨照片的自助区间,避免把不同题目混成一个大平均。原文统计
• 为了排除「模型根本读不懂坐标」,论文设计了错配名字实验:给每个坐标贴一个错误的名字,看模型跟随哪个线索,从而把一个约定的可读性从准确率里分离出来。原文读谁
• 论文还校准了颜色词表:把色轮上被模型一致命名的角度作为锚点,先确认模型自己的颜色词汇,再比较不同写法的差异;五个模型对同一色轮的命名方式各不相同。原文颜色校准
• 稳健性检查覆盖量化精度(四比特与八比特)、物体大小三分位、目标离格子边界的距离,以及类别切片。原文稳健性
实验成果
• 主结论的量级:定位任务上英文方位名为六十八点五、归一化零到九九九为五十九点五、绝对像素为二十点〇;后两者相对英文方位的配对差分别为负九点〇与负四十八点五(后者 p 小于十的负二十一次方量级)。原文空间结果
• 这个落差不是「读不懂坐标」:反向任务(给位置问物体)上英文方位名九十六点〇、绝对像素九十二点五,只差三点五且不显著;把坐标写进问题里也只损失三点五个百分点。原文空间结果
• 跨模型一致性与例外并存:同一落差在 InternVL3-2B 上为负三十二点五(区间负四十点五到负二十四点五)、Qwen2.5-VL-7B 为负九点〇、Gemini 在可解析答案上为负十五点五(p 约十的负四次方),而 GPT-4o 为负五点〇且区间跨零。原文跨模型
• 它会改变排名:一组模型在英文方位名下差负零点五(p 等于一点〇,等于打平),在像素约定下差正三十九点〇(p 约十的负十四次方),在归一化约定下差负五十四点五——同一对模型,三种约定,三个方向。原文排名反转
• 颜色任务上落差同样明显:写成颜色词为八十四点四,写成单独的色相角只有二十一点八,而「附带文字的色相角」为七十七点五、「只讲一次图例的色相角」为五十三点八——差别不在信息量,而在约定是否被模型使用。原文颜色结果
• 「读谁」实验给出了一个可用的判别标准:色相角约定被跟随的程度低于随机,归一化像素约定被跟随的程度达到随机的四倍;这能区分「模型会用」与「模型不会用」两种约定。原文读谁
总结与反思
• 结果总结: 论文用一个干净的单变量实验证明:基准报出的「能力上限」有时属于读出方式,而不是模型;同一批题换一种答案写法,分数要么崩掉四十八点五个百分点,要么直接翻转两个模型的排名。
• 局限性: 真实图像部分只用了 COCO 一个数据集、且类别偏向「人」;网格是较粗的三乘三与四乘四;主模型运行在四比特精度(八比特下差距更大,但全精度没跑);跨家族复现只是部分复现。
• 前沿见解: 对做评测的人,这篇论文给出了一条可以直接写进规范的规则——报分时必须同时报答案约定,否则不同论文之间的定位分数不可比;这条规则的代价很低,收益是避免把读出问题记成能力问题。
具身智能
9. 机器人要加入一群人,得先判断「这群人是谁」——语言引导的群体定位与入群位姿预测原文
信号源:新加坡国立大学计算学院、智能系统研究所
🚶
认知提取
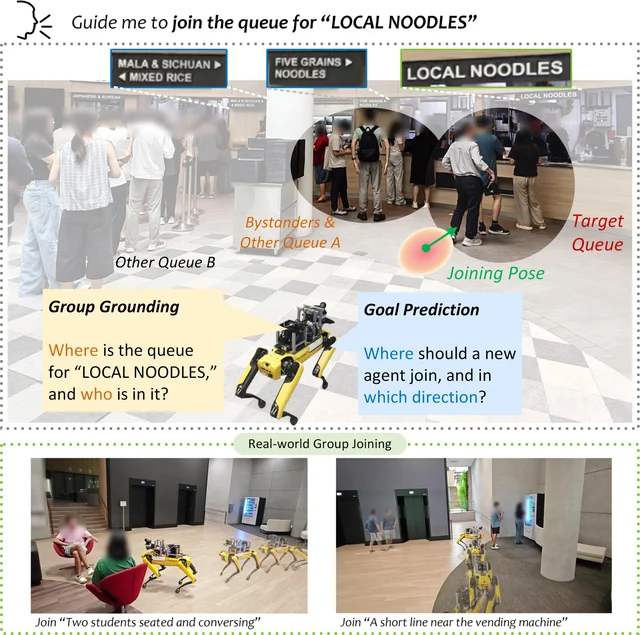
社交导航通常假设目标已经给定,剩下的只是绕着人走。但入群是完全不同的问题:机器人要自己判断哪几个人算「一群人」,还要决定站在哪里才不算插队。
论文把它写成一个语言条件任务:给一句自然语言描述目标群体,机器人要完成群体定位与入群位姿预测两件事。
它给出的答案很工程化——用递归谱划分生成候选子集、用语言条件模型排序、再用人类群体构型先验生成能量与朝向地图;结果是亚秒级推理加接近九成的位姿有效率。
论文摘要
• 任务被定义为语言条件下的机器人入群:给定一次观测和一段对目标群体的自然语言描述,机器人要识别相关成员并预测符合社交规范的入群位姿。原文任务定义
• 这类能力对应的真实应用被明确写出:机器人导盲犬与自主移动代步工具。原文引言
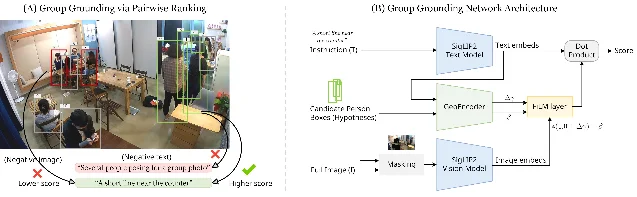
• 群体定位分两步:用递归谱划分生成结构化的候选子集,再用语言条件的图像—几何模型对候选排序。原文群体定位
• 位姿预测在定位结果之上工作:借助人类构型先验,输出一张覆盖可行位姿的多峰能量与朝向地图。原文位姿预测
• 评测覆盖对话、排队与观众三类场景,并改变群体规模、人群密度与视觉歧义程度;真机实验同时验证静态与动态变化的交互。原文摘要
核心方法
• 候选生成不靠阈值聚类,而是用递归谱划分把场景里的人切成结构化子集,从而把「哪几个人是一组」变成一个可枚举、可排序的假设集合。原文假设生成
• 排序器是语言条件的图像—几何模型,用成对排序的方式训练,输入是候选边界框与人际几何关系,输出是该子集与描述匹配的分数。原文假设排序
• 位姿预测网络以俯视表征为输入,联合输出三通道地图:位置能量、朝向的正弦与余弦,避免角度回归的周期性断裂。原文位姿预测
• 有效性判据是显式的几何约束:与相关成员保持零点五到一点二米距离(排队取队尾、对话取群体质心附近、观众取第一排之后且不遮挡他人),朝向需落在目标方向正负三十度内。原文评价指标
• 基线覆盖多模态大模型(含思维链与非思维链模式)与两种导航方法,真机部分还要对照一个用同一俯视表征采样候选、再让大模型选择的采样—选择基线。原文实验设置
实验成果
• 群体定位:在包含四到二十人以上的场景上平均取得一致度加权的 F1 为零点八一二五,推理耗时零点九三六秒;论文指出更强的少样本大模型虽然略高,但推理时间显著更长。原文结果
• 位姿预测:位姿有效率八十九点七六,平均每次查询约一点一秒。原文结果
• 基准构成:四十二个场景(十五个对话、十五个排队、十二个观众),其中十一个观众场景是手工采集的,因为这类交互在现有数据集里代表性不足;源数据来自 JRDB 与 SCAND 以及手持相机素材。原文实验设置
• 定位评价引入了人工标注研究:二十七名参与者从带索引标注的场景中指出目标成员,用标注者一致度给精确率、召回率与 F1 加权。原文实验设置
• 失败案例被如实列出:论文分析了位姿有效率为零或极低的五个场景,归因于两类原因——定位出错(正确群体压根不在候选子集里,例如有人站得比排队间距远一倍),以及入群距离过于保守。原文结论与局限
• 真机指标是多维的:任务成功率、碰撞率、导航时间与个人空间侵入时长(在以人为中心零点二五米内停留的时间),并分别在五个场景、每场景五次试验中评估。原文实验设置
总结与反思
• 结果总结: 论文把「去哪加入」这个在社交导航里常被跳过的问题补全成可评测的任务,并给出一个亚秒级、可复现的工程方案,同时用人工标注研究给定位指标提供了可信度参照。
• 局限性: 自己的失败分析指出两类系统性错误——候选子集可能不含正确群体,以及入群距离偏保守;评测场景规模为四十二个,且观众类场景有一半以上是手工采集;真机试验规模较小,动态变化场景的覆盖有限。
• 前沿见解: 当机器人从「绕过人」走向「参与人群」,社交规范就不再是软约束,而是一组可以写成几何判据的硬条件;把这些判据写清楚,比提升检测精度更能决定系统能不能真的上线。
10. 一套点集世界模型,管住刚体、布、绳和柜门——PointCast 用一千九百八十万参数覆盖四种物理形态原文
信号源:明尼苏达大学
🧊
认知提取
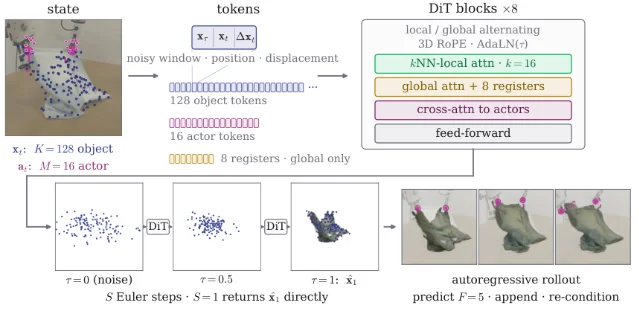
操作类世界模型长期各管一段:刚体一套、布一套、绳一套,铰接物体再一套。PointCast 的做法是只换状态表示:把物体和机械末端都写成一堆三维点,每个点保留自己的身份并被单独监督轨迹。
这样一来,模型学的是「每个点去哪」,而不是「点连成的形状长什么样」,网格与拓扑都不再是前提。
一个一千九百八十万参数的扩散 Transformer 加同一套训练配方,套上四个各自训练的检查点,就在四种物理形态上拿到三胜一负。
论文摘要
• 世界模型对操作的价值在于执行前先预测动作如何改变物体状态,而现有方法通常按物体类型分家。原文引言
• 状态定义是无网格、无拓扑假设的点集:物体点与末端执行器点共同构成状态,每个点保留身份并按自身轨迹被监督。原文问题设定
• 主干是扩散 Transformer,对一小段未来点位置做去噪,条件是该点的近期历史与指令化的末端运动。原文架构
• 注意力交替使用 k 近邻局部注意力与全局注意力,并通过交叉注意力读取末端执行器 token 来承载接触耦合。原文架构
• 评测分两处:随机化仿真数据与真实机器人遥操作数据集(PGND 基准),并在采样式模型预测控制里冻结使用。原文实验设置
核心方法
• 训练配方统一:每类形态各自训练一个检查点,同样的余弦衰减调度、两百个 epoch、每 epoch 八百步、批大小六十四,在单张 A100 或 H100 上约七小时。原文实验设置
• 训练数据规模被明确披露:刚体十一万二千条、布一万零二百条、绳一万零二百条、柜体五千条交互,其中百分之十五留作验证。原文实验设置
• 真实数据侧使用 PGND 基准的六类多视角 RGB-D 遥操作记录,物体点来自基准发布的 CoTracker3 轨迹,执行器点是同一套夹爪指模板,双手采集时十六个点分给两个夹爪。原文实验设置
• 基线处理方式透明:AdaptiGraph 与 PGND 保持作者原始配方与框架,PGND 直接跑官方检查点;ParticleFormer 未开源代码与超参,论文按原论文自行复现并公开完整规格。原文实验设置
• 控制闭环的用法是冻结模型后接采样式模型预测控制,每个窗口只做一次网络前向,用来测「预测误差是否足以支撑规划」。原文规划实验
实验成果
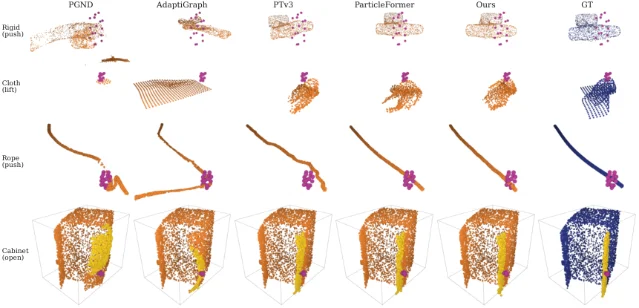
• 仿真平均回放误差(毫米):布为三十一点九〇(对照 ParticleFormer 三十八点二六)、绳为十四点六七(对照二十一点七八)、柜体活动关节为六点八四(对照 PTv3 的十点三四),刚体为二十四点四〇,落后 ParticleFormer 的二十点八八。原文仿真基准
• 相对最强基线的幅度:布上领先百分之十六点六,绳上领先百分之三十二点六;刚体是唯一一处输掉的项目。原文仿真结果
• 同预算同容量对照把增益归到架构:与 PTv3(一千九百五十万参数,PointCast 为一千九百八十万)在相同训练预算下比较,PTv3 在每一个形态上都更差。原文仿真结果
• 真实数据上六类中四类取得最低平均位移误差,另两类第二,并且六类全部优于该数据集自带的模型;零样本迁移时(用仿真检查点直接跑真机数据)四类中有两类最好。原文真实数据
• 消融定位了关键设计:把逐点损失换成集合级损失,柜体误差上升百分之七十九点三;用逐帧 token 的块因果注意力,布、绳、柜体误差分别上升百分之一百二十四、百分之二百四十八与百分之一百四十七;采样步数从一到二十五在绳与柜体上变差。原文消融
• 规划实验给出闭环证据:冻结在采样式模型预测控制里、每个窗口只做一次网络评估,在四个仿真任务、共六十四回合上与所有基线相比持平或更好。原文规划
总结与反思
• 结果总结: 论文证明「点集加逐点身份监督」可以成为跨物理形态的统一状态表示:一套架构、一套配方、四个检查点,就在刚体、布、绳、柜体上接近或超过专用方法。
• 局限性: 每个形态仍需各自训练一个检查点,并非真正单一模型;刚体上落后专用基线;真实数据评测依赖第三方基准的点轨迹,误差里混入了跟踪质量;规划实验只在仿真中做,四个任务、六十四回合属于初步规模。
• 前沿见解: 机器人的世界模型正在从「按物体类型写不同的物理假设」转向「选一个足够通用的状态载体,让数据自己决定动力学」;一旦状态表示统一,不同形态之间的知识迁移就从可选变成了自然下一步。
AI4Science
11. 一千五百三十七万八千九百二十三条固液界面结构——SoLiD26 把电解液、催化剂与腐蚀的界面补成可训练的数据集原文
信号源:丹麦技术大学能源转换与存储系
🔬
认知提取
机器学习原子间势在固液界面处最难:训练数据必须同时覆盖液体环境、固体本身和界面,而这三者的 DFT 计算都贵。
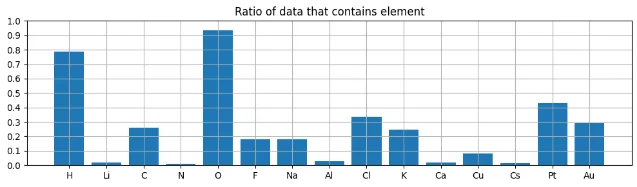
SoLiD26 的价值在于把散落在多个研究项目里的第一性原理计算整理成一份统一的数据集:一千五百三十七万八千九百二十三条结构,最多五百七十六个原子,覆盖十五种元素。
验证也做得很干脆:拿同一套 MACE 框架在同一份数据上训练与微调,力的平均绝对误差降到基线的大约三分之一,说明这份数据里确实有原始基础模型没见过的信息。
论文摘要
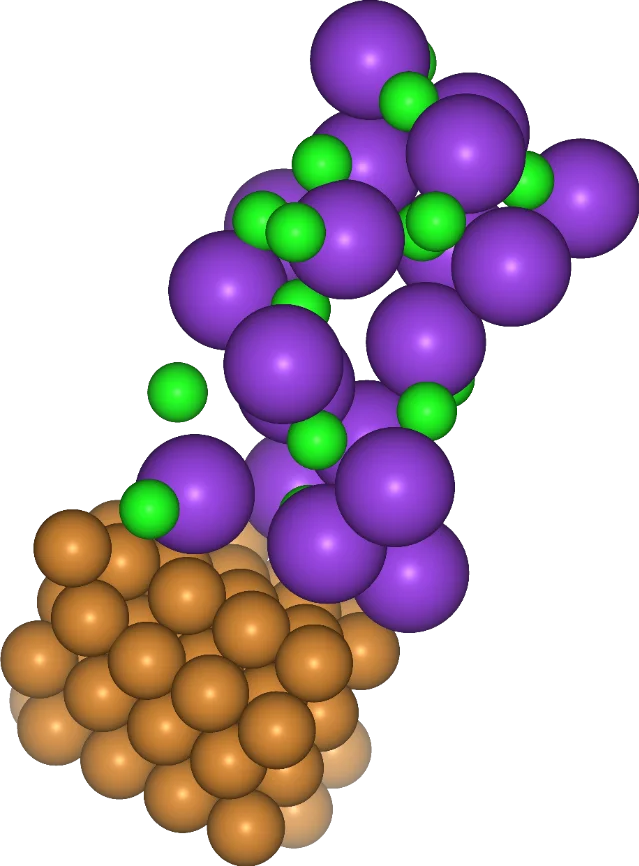
• 数据集的定位是给固液界面场景的机器学习原子间势提供训练与评测数据,应用方向写明为电化学、催化与腐蚀。原文摘要
• 数据来自固液界面研究中的密度泛函理论计算,多数构型源自从头算分子动力学模拟。原文摘要
• 每条记录包含原子种类、位置、模拟盒子、周期性边界条件、势能与原子受力。原文摘要
• 覆盖范围包括水相贵金属界面、电极—电解液体系以及若干体相参照结构,计算使用 VASP 与 PBE 泛函加 D3 色散校正。原文摘要
• 论文给出了数据摄取与准备流程,并用一套 MACE 模型在简单的训练、验证、测试切分上演示训练与评测。原文摘要
核心方法
• 切分方式透明且可复现:测试集取全部原子数超过二百的结构(二十七万二千八百八十九条),剩余数据中随机取十万条作验证,其余一千五百万零六千九百三十四条作为训练集。原文技术验证
• 模型侧用三种 MACE 配置做对照:预训练的 MACE-MATPES-PBE-0 加 D3 修正作为基线、在该数据集上朴素微调的版本、以及从头训练的版本,后者与前者使用相近超参。原文技术验证
• 训练分两阶段进行:先用能量权重一、力权重十训练,再用力权重一、能量权重十继续训练以压低最终能量误差。原文技术验证
• 数据集以自然科研数据集的格式组织,配套提供代码与数据可用性说明;论文同时披露了作者贡献与利益冲突声明。原文数据可用性
实验成果
• 数据规模与覆盖:一千五百三十七万九千八百二十三条结构、最多五百七十六个原子、十五种元素;测试集二十七万二千八百八十九条、验证集十万条、训练集一千五百万零六千九百三十四条。原文技术验证
• 力的误差改善最明显:预训练基线在力的 MAE 为零点零五〇一(RMSE 零点零六九六),微调版本为零点零一一八(零点零二四三),从头训练版本为零点零一一九(零点零二二九),均约为基线三分之一。原文验证表
• 能量项同步改善:单原子能量 MAE 从零点零零四六降到零点零零二七(微调)与零点零零二六(从头训练);总能 MAE 从一点三三四一降到零点八六三八与零点八九五三。原文验证表
• 论文据此给出核心判断:力误差降到约三分之一,说明该数据集包含预训练基础模型未见过的信息,而不只是同一分布上的重复采样。原文技术验证
• 计算成本说明:全部训练与评测在 NVIDIA H100 与 H200 上完成,论文未报告总机时,因此本节不给出该项数字。原文技术验证
总结与反思
• 结果总结: 这份数据集把「固液界面」从一个各自为战的建模难题,变成一个有一千五百万级训练结构、明确切分与公开验证流程的公共资源。
• 局限性: 计算层级统一在 PBE 加 D3,方法误差未被系统评估;体系的化学与结构覆盖由来源项目决定,某些元素与界面的样本会明显稀疏;验证只用了 MACE 一个模型家族,尚未证明对其他势函数同样有效。
• 前沿见解: 当数据规模跨过千万级,原子间势的竞争会分岔成两条:一条继续堆模型容量,另一条去补那些「基础模型见过但没见过这一界面」的数据缺口——SoLiD26 属于后者,而后者的门槛是整理能力,不是算力。
Infra
12. 层间共享 KV 省了显存,也压平了表征——局部历史该保留什么,被一次八种子的对照实验问清楚原文
信号源:原论文 arXiv 版本未展开机构署名
🗄️
认知提取
自回归生成要把历史算过的键值缓存下来复用,而层间共享缓存能省一大块显存,代价是深度方向上的表征被压平。
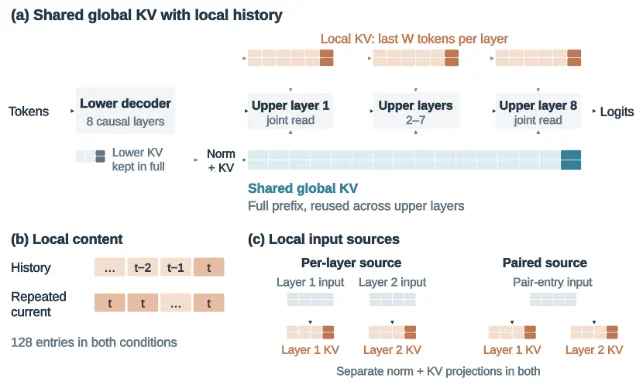
这篇论文把问题拆得很干净:把「保留什么内容」与「这些内容由哪一层提供」当成两个独立设计选择,分别做对照。
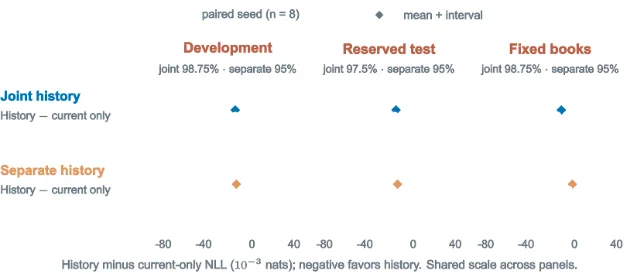
结论是局部历史确实带来约百分之一点四的留出困惑度下降,而且这一点在相邻层共享输入来源时仍然成立;代价也写得很直白——缓存更大,长请求延迟更高。
论文摘要
• 问题设定是最小可判断的规模:一亿二千六百万参数、二千 K 上下文,用八个配对种子做留出测试困惑度对照。原文摘要
• 主结果:用局部历史比用「当前 token 的局部分支」低约百分之一点四的留出困惑度,容量、条目数与训练算力的控制实验支持这来自历史内容本身。原文摘要
• 第二个结论关于来源:在双种子对照中,当相邻层共享局部输入时这一收益仍然存在,同时来源共享还缩短了精确缓存构建的依赖链。原文摘要
• 与 GQA 和相邻层 KV 共享的对比给出的是取舍而非压倒性胜利:同源似然更好,但代价是更大的缓存与更高的长请求延迟。原文摘要
• 论文如实标注了不确定项:八种子的外部书籍历史效应仍不确定,下游任务表现因任务而异;8K 适配后排序保持但短上下文有代价。原文摘要
• 论文还给出一个可用于工程化的结论:存在一种充分后缀调度,在精确算术下减少上层构建工作量,同时保持完整缓存。原文摘要
核心方法
• 研究设计的关键是把「内容」与「来源」解耦:部分实验固定来源只换内容(历史 vs 重复当前),部分实验固定内容只换来源(逐层独立 vs 相邻共享)。原文方法
• 对照设置尽量对齐:容量、条目数、训练算力都做了控制,避免把「多给了显存」误读成「历史更有用」。原文实验
• 与标准方案的比较采用有界学习率搜索加新种子确认,并把质量与请求成本放在同一张图里比较,而不是只报困惑度。原文实验
• 8K 适配实验用四个检查点在约一亿三千四百万 token 上适配,评分目标固定为最后一千零二十四个 token、局部窗口一百二十八,使长上下文比较公平。原文 8K 适配
• 成本侧的推导给出充分后缀调度,说明有界历史为什么允许精确的后缀执行,并把预填充与暂停状态保留一并验证。原文缓存构建与推理成本
实验成果
• 主效应:八配对种子、一亿二千六百万参数、二千 K 上下文下,局部历史相对对照低约百分之一点四的留出测试困惑度,配对种子区间与零分离。原文局部历史效应
• 来源共享不改变结论:双种子对照中相邻层共享局部输入时,历史仍然优于重复当前,同时精确缓存构建的依赖链被缩短。原文来源结果
• 长上下文上的排序保持:在 8K 适配后与 GQA4–CLA2 比较,同源似然仍更好,且在固定书籍文本上优势扩大,但短上下文上要付出代价。原文 8K 结果
• 成本是明确的:完整预填充后缓存(含文档标识)更大,长请求延迟更高;请求成本取决于负载形状,论文按三类负载分别给出比值而不是给一个综合分。原文质量与成本
• 不确定项被具体标注:八种子实验中外部书籍的历史效应仍不明确,若干下游任务的表现因任务而异,论文没有把它们合并成一个「更好」的结论。原文摘要
总结与反思
• 结果总结: 论文把一个常被含糊处理的工程取舍拆成了两个可独立验证的设计问题,并给出量化答案:局部历史值约百分之一点四的困惑度,但要用更大的缓存与更高的长请求延迟来换。
• 局限性: 主实验规模是一亿二千六百万参数与二千 K 上下文,结论能否外推到更大模型未验证;部分对照只有两个种子;外部书籍效应仍不确定;下游任务结果因任务而异。
• 前沿见解: 推理系统的下一轮优化不再是「省显存」或「保质量」的二选一,而是把质量、缓存与延迟画成一张可比较的图,让每个部署场景自己选点——这篇论文提供的是那张图的做法。
Agent
13. 智能体的状态会被自己的错误推理污染——AEWM 不预测工具返回,而是去编辑推理与动作原文
信号源:中国人民大学高瓴人工智能学院
🛠️
认知提取
语言世界模型通常模仿环境返回什么,但工具返回本来就是执行相关的、熵很高的东西,在真实反馈随时可得的情况下,把容量花在模仿它收益有限。
真正的问题在别处:智能体的历史里会积累没有依据的假设与过期的计划,论文把它命名为任务状态污染,并指出它才是长程任务里持续失分的来源。
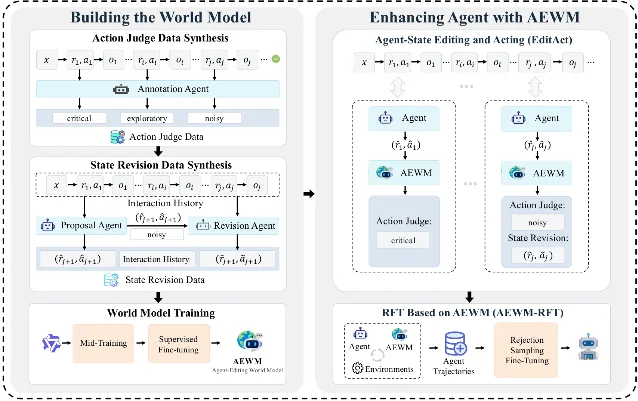
AEWM 的转向很清晰——不预测工具返回,而是判断哪些推理与动作是关键的、探索性的还是噪声,并直接在状态层面改写噪声那部分。
论文摘要
• 论文指出既有语言世界模型的错位:重建高熵、依赖具体执行的工具返回,在真实反馈可用时价值有限。原文摘要
• 同时指出任务状态污染现象:没有依据的假设与过期计划留在历史里,扭曲后续决策。原文摘要
• 方法由两块组成:动作裁判(Action Judge)把决策分成关键、探索性、噪声三类;状态修订(State Revision)基于同一段观测历史改写噪声的推理—动作续写。原文摘要
• 落地形式是 EditAct:它与真实执行结合,直接改变后续决策所依赖的状态,而不只是给出评语。原文摘要
• 训练跨搜索、终端与软件工程三个领域进行,采用中训练加监督微调两阶段。原文摘要
• 还做了拒绝采样微调(AEWM-RFT):用被验证过的编辑轨迹继续训练,使能力在不再接入在线引导时仍然保留。原文摘要
核心方法
• 训练数据按角色分工合成:动作裁判数据由两个大模型生成轨迹,状态修订数据由提案与修订两个智能体协作产出,再由另一个大模型按质量量表过滤。原文实验设置
• 标注质量有硬门槛:每个量表维度按零到四打分,必须每个维度都不低于三,且满足若干硬条件才被接受。原文数据合成
• 评测覆盖三个域六项基准:搜索域用 BrowseComp 与 DeepSearchQA,终端域用 Terminal-Bench 2.0,软件工程域用 SWE-Bench Pro、Doc2Repo 与 NL2Repo。原文实验设置
• 对照设计有三条基线:ReAct、步级 Best@3 与轨迹级 Best@3,后两者都用同一个大模型做验证器选择,从而把「会判断」与「多采样」区分开。原文实验设置
• 论文还单独统计了动作类型分布,用来说明编辑行为在标注语料与在线引导中分别落在哪些类别上。原文动作类型分布
实验成果
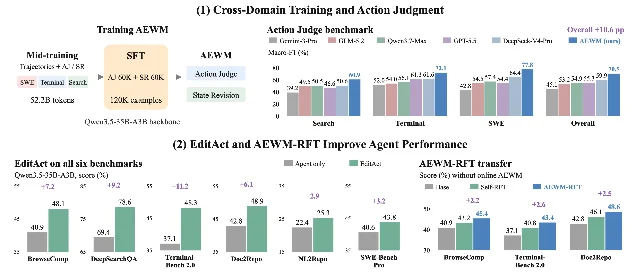
• 动作裁判本身是一个可评测能力:在自建基准上宏观 F1 为七十点五,超过最强前沿基线十点六个点。原文摘要
• 带编辑的推理带来跨基准收益:在六项基准与三种智能体主干上,EditAct 相对最强基线的平均分提升三点二到六点七分。原文主要结果
• 能力可以被内化:用被验证的编辑轨迹做拒绝采样微调后,三个域上相对自我拒绝采样微调提升二点二到二点六分,且推理时不再需要在线 AEWM 引导。原文 AEWM-RFT 结果
• 论文给出了行为层面的证据:在搜索任务上,编辑改变了最长纯搜索序列与请求不同网页的数量,说明增益来自行为分布的改变而非单纯重排答案。原文搜索行为
总结与反思
• 结果总结: 论文把「世界模型该预测什么」这个设定问题换成了「世界模型该编辑什么」,并在搜索、终端、软件工程三个域上给出了可复现的增益与一条把能力内化的路径。
• 局限性: 训练数据依赖其他大模型生成与过滤,存在继承其偏置的风险;动作三分类的边界由标注量表定义,换域后是否需要重新定义未验证;评测以任务成功率为核心,编辑带来的额外推理开销未被单独核算。
• 前沿见解: 随着智能体任务变长,「记住什么」与「忘掉什么」会成为同一枚硬币的两面;能把状态修订做成一个独立可训练、可内化的能力,比让模型自己小心一点更接近工程现实。
应用体系
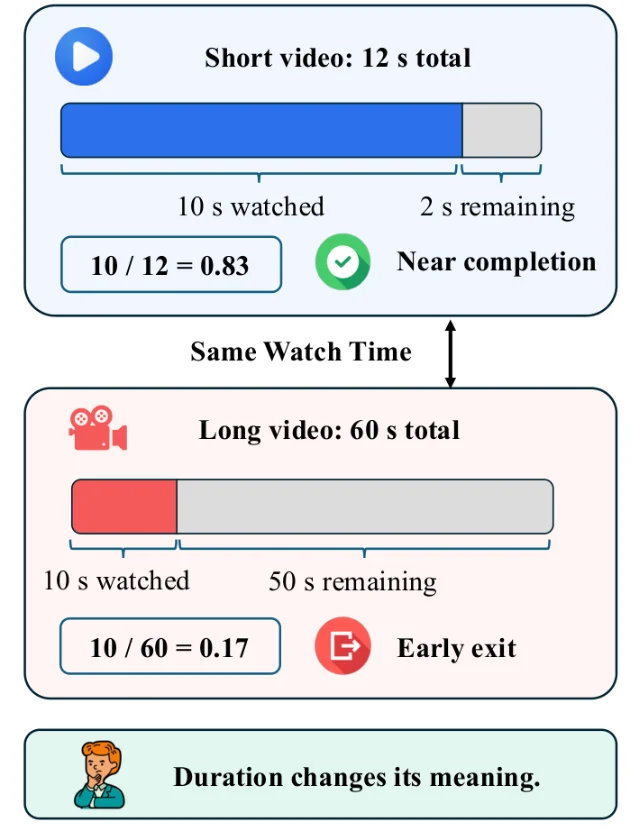
14. 观看时长不该只给一个数——DSI 把服务接口换成四个状态与它们的时间分布原文
信号源:上海交通大学、莱斯大学
📺
论文摘要
• 问题在于接口而不是模型:现有方法在服务时只暴露一个期望观看时长(或去偏后的单值),下游拿不到「看完」「多播」等区域的概率。原文引言
• 提出分布服务接口(DSI),由三部分组成:分布提供者、低维紧凑摘要、以及面向各任务的轻量读出头。原文摘要
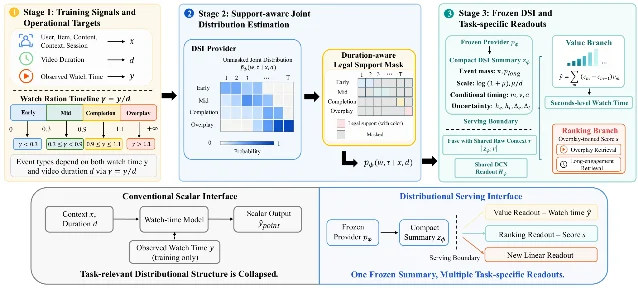
• 提供者学习的不是单值,而是观看比例派生出的四种观看状态与它们的事件时间的联合分布。原文方法
• 训练时用基于视频时长的规则剔除不相容组合,并用一个还原损失保证「秒」这一量纲上的准确度。原文方法
• 摘要把分布压成一组事件概率、相对时长的时间尺度与不确定性统计;提供者训练完成后冻结参数,再训练价值与排序两类读出头。原文方法
• 评测使用三个公开短视频数据集:KuaiRec、KuaiRand-1K 与 WeChat21。原文实验设置
认知提取
短视频排序里,观看时长是最主要的参与信号,可服务接口只给出一个数。这一次的改动很小,位置很关键:把一个数换成一条低维分布摘要。
提供者学的是四种观看状态与它们发生时间的联合分布,摘要再把它压成事件概率、相对时长尺度与不确定性统计,下游任务各自训练轻量读出头。
结果是三个公开数据集上 MAE 都最低,而且摘要里多出的信息,用同样的读出结构就能转移到新的预测目标上。
核心方法
• 训练与评测协议固定:按曝光级随机八比一比一切分,三颗种子(二〇二七到二〇二九)用于初始化与采样,切分在种子间保持一致。原文实验设置
• 评价指标是多轴的:MAE 以秒计,XAUC 度量预测与观测的成对一致性,另加两个按视频时长做归一化的检索指标(Long-N@5 与 OP-N@5)。原文实验设置
• 对照九个基线,覆盖点回归、按观看时长加权的逻辑目标、两类去偏方法、序数分解、自适应分箱等不同路线,全部在同一套处理过的切分与评测代码下运行。原文基线
• 关键对照是「同一个冻结提供者换接口」:在固定提供者的条件下比较不同接口的信息量,把「模型更强」与「接口更有信息」两件事分开。原文接口对比
• 为了验证接口可复用,论文冻结提供者后只用同一套轻量线性头去预测两个新的观看时长目标与一个单独记录的参与目标。原文接口可复用性
实验成果
• 完整系统的 MAE 在三个数据集上均最低:KuaiRec 为三点五零五九(最强基线 EGMN 三点八三二七)、KuaiRand-1K 为十二点三二四四(D2Q 十二点五六六八)、WeChat21 为十二点九二七八(D2Q 十三点二九六四)。原文主表
• 论文给出的相对幅度是:优于九个基线中的最好结果百分之一点九到八点五;同时在三个数据集中的两个上取得最佳 XAUC(KuaiRec 零点六八二七、KuaiRand-1K 零点七三六七,WeChat21 零点七〇二〇略低于零点七〇五四)。原文主表
• 时长相关的检索指标提升幅度最大:KuaiRand-1K 上 Long-N@5 为零点七一八五(对照最强基线零点五三八七),OP-N@5 为零点七四二六(对照零点四三一一);WeChat21 上分别为零点八一八一与零点八〇五六。原文主表
• 接口本身的信息量可以被单独测出:在冻结提供者、匹配读出结构的条件下,摘要保留的信息超过「预测均值加视频时长」这一组合,且随机初始化的提供者无法复现该增益。原文接口对比
• 可复用性得到验证:同一套轻量线性头在两个新的观看时长目标上表现最好,并改善了一个单独记录的参与目标。原文接口可复用性
• 机制消融给出了各部件的作用分工:类型化摘要承担了融合读出中的大部分信号,排序分支提供 OP-AUC 而几乎不改变 MAE,观看时长还原损失改善 MAE 而对 OP-AUC 影响很小。原文机制消融
总结与反思
• 结果总结: 这篇论文的主张很小也很实:把服务接口从单值换成分布摘要,下游多个任务能在同一份冻结表征上各取所需,而排序与时长两个方向同时受益。
• 局限性: 评测走的是公开数据集的离线切分,属于热启动场景,没有报告在线 A/B;四个观看状态的类型划分依赖观看比例,事件边界需要按数据集调;排序指标只在与时长相关的两类目标上报告。
• 前沿见解: 推荐系统的下一步改进未必来自更大的模型,而可能来自接口信息量的重新分配——当一个中间表征能被多个下游任务复用,模型迭代的成本结构就会跟着改变。
Benchmark
15. 十一万八千条原始视频里找一条线索——MultiVENT-Raw 把「没有字幕、没有元数据的现场视频」做成检索与报告生成考题原文
信号源:约翰斯·霍普金斯大学语言与语音技术卓越中心、乔治城大学
🔍
认知提取
网络上越来越多的信息以视频形式出现,而其中一大类是原始视频:手机随手拍、手持跟拍、监控画面,剪都没剪就上传了。
这类素材没有脚本化的解说、没有标题条、没有图形、没有元数据,恰恰因此对检索与机器理解更难。
MultiVENT-Raw 收集了近十二万条这样的视频、五千多个小时,配上事件、查询、人工相关性判断与人工抽取的关键事实,并同时定义了检索与报告生成两个任务。
论文摘要
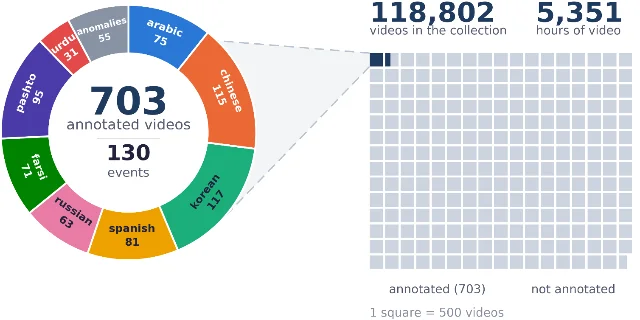
• 数据规模:近十二万条以原始视频为主的视频、总时长超过五千三百小时,覆盖多语言。原文摘要
• 标注资产包括一百三十个事件、二百二十二条以事件为中心的查询、人工标注的视频相关性判断,以及为相关视频抽取的关键事实。原文摘要
• 两个任务被明确分开:检索任务是从集合里找出与查询事件相关的视频;生成任务是针对目标用户把事件相关视频汇总成连贯报告。原文任务
• 论文同时释放一个开发集 MicroVENT,便于在完整集合上快速迭代。原文摘要
• 基线结果显示两个任务对当前多模态模型都不轻松。原文摘要
核心方法
• 数据构建按主题与视频策展、查询与人物画像设计、断言标注、质量控制与后处理四步走,力求覆盖不同语言与来源。原文数据收集
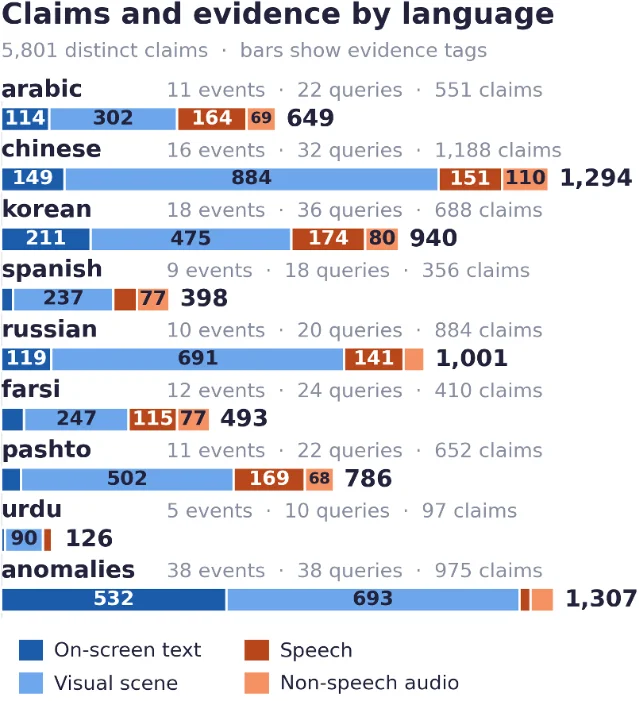
• 断言标注区分证据支持的类型,论文还发布了原始视频分类器的集成结果,用于界定语料中「原始视频」的比例口径。原文断言标注
• 检索评测把视频切成不超过五分钟的段落,完整集合得到十四万三千二百八十八段,开发集七万五千一百四十七段。原文实验
• 第一阶段检索基线覆盖多种稠密检索路线(含多向量与单向量、多模态与图文混合嵌入),第二阶段再加入视频原生重排序模型与大模型重排序。原文检索基线
• 报告生成用 MiRAGE 指标(信息覆盖与引用两个维度,以另一个大模型作为评判),并区分不同检索器提供的候选视频与 oracle 视频两种条件。原文报告生成
实验成果
• 语料与标注规模:完整集合为十一万八千八百零二条视频、五千三百五十一小时,配套一百三十个事件与二百二十二条查询;开发集 MicroVENT 为九百三十三条视频、三十四小时、二十三个事件。原文汇总统计
• 检索的第一阶段最好结果是 OmniEmbed-mv 的零点四七二 nDCG@10(完整集合),其余三条第一阶段基线分别为零点二六七(Qwen3-VL)、零点二三三(ColQwen Omni)与零点一八〇(OmniEmbed);加入重排序后推到零点五一五(RankVideo 为零点四八五)。原文检索结果
• 报告生成同样吃力:在较好的检索器提供前十段视频的条件下,信息维度的最好 F1 为二十六点二,引用维度的最好 F1 只有六点九;换成 oracle 视频后指标上升,但仍远未饱和。原文报告生成结果
• 语料侧还有一个副产品:为界定原始视频,论文训练了一个集成分类器,准确率为九十五点一、宏观 F1 为九十一点四,作为该基准的口径依据。原文原始视频分类
总结与反思
• 结果总结: 这个基准把「原始视频」从一种被顺手忽略的素材变成有规模、有标注、有明确任务的考题;检索与生成两条线的基线分数都说明这是当前多模态系统的一个真实短板。
• 局限性: 事件与查询由人工策展,规模有限且不可避免地带有主题偏好;检索评测以五分段为单位,细粒度定位未被单独考核;报告生成的评判依赖另一个大模型,论文采用参考变体来降低这一依赖但仍非人工评判。
• 前沿见解: 当真实世界的视频越来越多是没有脚本的现场记录,评测的重心会从「理解一段剪辑好的视频」转向「在一堆没有被组织过的素材里找到并在语言上重建一件事」——后者更接近情报与新闻工作的真实形态。
本期观察
AI 科技评论注意到,把本期十五篇论文放在一起看,它们指向的是同一件事:
系统能力的新增量,越来越来自把内部的量暴露出来,而不是把端到端做得更强。
StudentBench 把「会不会教」拆成五张可以分别排名的榜单,于是成本那一栏第一次能被算出来;高维潜空间那篇干脆指出,训练难的根因是一个可以被推导和替换的目标函数;UECR-GRPO 把「信老师」拆成路径级排序与词元级定位两级,并给分配加了一条总量守恒的约束;LiMA 则把「想」和「动」拆成两台时钟,用延迟而不是分数证明这种拆分值得。
多模态一侧的两篇形成了一组对照:一篇把视频生成的记忆整理成载体、功能、生命周期、学习与评测五个可讨论的维度;另一篇用单变量实验证明,同一个模型在不同答案约定下能差出四十八点五个百分点——评测报出的能力,有时属于读出方式。
工程与应用的收束同样清晰:PointCast 用点集作为跨物理形态的统一状态;SoLiD26 用一千五百万级结构补上固液界面的数据缺口;共享 KV 那篇把质量、缓存与延迟画进同一张取舍图;AEWM 把「忘掉错误推理」做成一个可训练、可内化的动作;DSI 把服务接口从一个数换成一条分布摘要;MultiVENT-Raw 则在最难的素材上承认基线还很差。
对读者而言,这一期给出的可操作信号很简单:评估一个系统时,先看它把哪些内部量暴露了出来。能被计量、能被调度、能被别人复算的那部分,才是这一轮真正在进步的地方。
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.