美团自研搜推推理引擎:0.5B 小模型 20ms 约束下有效 MFU 67%,10 倍对照只有 SGLang 一家
美团把搜推场景的 0.5B 小模型推理从 SGLang 换成自研静态 DAG 引擎,把平均端到端时延压到 20 ms 以下、有效 MFU 做到 67%;这篇拆开五类优化的机制与各自读数,也把那个 10 倍对照的缺口写清。

搜索和推荐里越来越多环节用上了 0.5B 到 1B 的小模型。这些模型不写作文,只做一件事:给一批候选打分,或从里面挑出几条。
美团为这类在线服务单独造了一套推理引擎,替掉了原来「Triton Inference Server + SGLang」的组合,并在 10 月 15 日公开了工程复盘。1
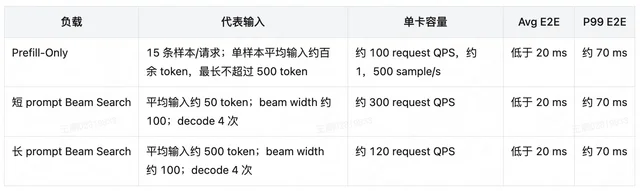
主干读数是:三类负载的平均端到端时延都低于 20 ms,P99 约 70 ms;Prefill-Only 负载的混合精度有效 MFU 约 67%。1
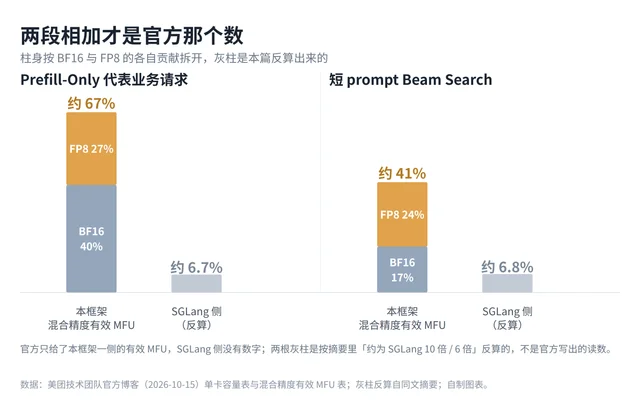
摘要把 67% 写成「约为 SGLang 10 倍」。这个对照只有一侧,SGLang 的版本与配置全文没有公布。
有界生成负载:这次要服务的是哪一类请求
原文先给这类负载起了一个统称:有界生成负载。指的是控制流结构、状态容量和执行资源都能在部署前界定,输出 decode 的次数有固定上界。1
这不是业界通用术语,是本文自己的用法。原文也写明,同一个语言模型拿去做开放式文本生成,就可能不满足这个条件。1
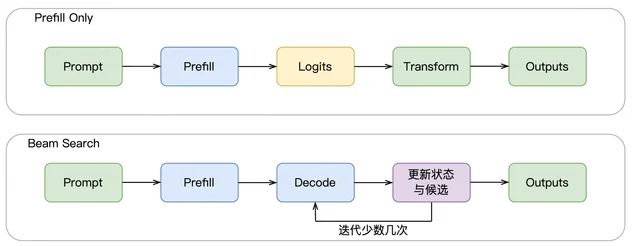
两类在线执行形式对应两张执行图。Prefill-Only 只跑一次 prefill,取每条序列最后一个有效 token 位置的 logits,直接得到类别或分值;也可以把 prefill 产出的 embedding 接一个 MLP 做分类。1
Prefill-Only 被算作 decode 次数为 0 的特例。Beam Search 才继续往里走:一次 prefill 之后固定执行若干次 decode,每步在各 beam 的局部候选里挑,与历史累计分数合并,保留固定数量的候选序列。1
有界具体发生在哪几处,原文列得很细。覆盖范围里请求平均输入都在 500 token 以内;beam 宽度与最大生成步数由部署配置固定,本文覆盖的配置不超过 400 beam 和 5 个生成 token。1
实际输入长度、batch 大小和候选内容仍随请求变化,但都落在预先配置的容量范围内。原文把这条概括得很直白:执行结构固定、动态 shape 可控。1
SGLang 与 vLLM 的优化为什么在这里是负向的
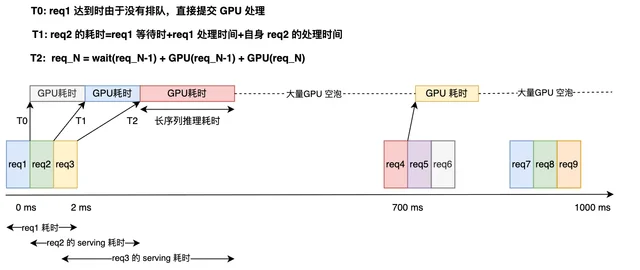
原文给这套设计的理由是排队论。GPU 推理本质上是 Cuda Stream 上的串行计算,服务耗时可以抽象成 G/G/1 模型。1
衡量窗口取 1000 ms,因为 QPS 是每秒完成的请求数。Kingman 近似把平均排队等待写成三项相乘:GPU 拥挤度、到达与服务时间的两个变异系数、以及单次前向的平均耗时。1
搜推场景把这三项里的两项推到了极端。序列分批让请求到达间隔严重偏离泊松分布,请求在窗口内聚集;服务时间却因为序列长度与 batch size 基本固定而很稳定。1
单次推理的平均耗时在 20 ms 以下,所以瓶颈不在算得多快,而在 GPU 入口的等待:排队久了会超过上游超时,请求被丢弃,GPU 在窗口里的实际计算时间反而不够。1
原文把这种组合描述成利用率很低、耗时却很高。通用引擎不是为这个前提设计的,它为 prefill 长度任意变化、decode 次数无上界而准备的那套优化,在搜推的 SLM 场景里是负向的。1
需要说明的是,这段推演出自设计方,文中没有给出线上的到达间隔分布或排队统计实测数据。
把控制流搬进编译产物
系统换掉的第一件事是「一个请求」的定义。原来的做法把批量输入拆成多条独立生成请求,各自做文本处理、创建状态、走通用生成 Runtime,返回后再恢复顺序和业务结构。1
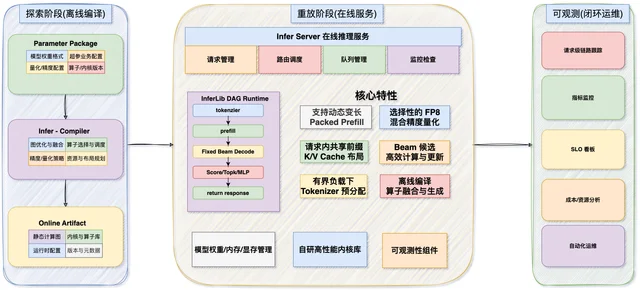
现在完整业务请求就是 DAG 调度、端到端测量和容量规划的共同边界。原文的执行抽象是一张静态有向无环图:请求是图的执行单位,节点是模型编译边界。1
离线一侧用 Python 表达模型语义、选算子实现,经
torch.export 与 AOTInductor 生成可直接加载的 AOTI 节点产物。在线一侧用 C++ 做协议处理、DAG 调度、资源管理和数据转换,不解释也不即时编译模型计算。1「静态」固定的不是 tensor 的形状,而是节点拓扑与依赖、跨节点 tensor 接口、最大物理容量、最大迭代结构、执行设备与同步边界。1
请求阶段仍动态确定实际 batch 大小、每条文本的有效 token 数、本次的逻辑 shape,以及由模型输出决定的 Beam 状态内容。1
这套分工最具体的一个落点是固定 Beam Search。搜索深度既然固定,逐 step 的状态转移就能写成结构确定的张量程序,与 Transformer 一起导出、一起编译。1
于是整个搜索收进一个生成节点,DAG Runtime 只调度它一次,既不知道里面跑了多少次 decode,也不理解候选选择与状态更新的语义。固定的是控制流,不是模型输出:parent index 仍动态决定 suffix K/V 与分数的重排。1
在线并发分成三层,原文强调它们不能合并成一个统一的 concurrency 配置:AOTI 执行实例数、DAG 请求上下文数、服务入口的在途请求上限。1
容量配置按完整链路逐层扫描,最后才设入口上限;入口负责过载保护,超过业务允许等待时间的请求不再进入后端计算。1
部署形态是单个请求不跨卡、每张 GPU 一份完整模型副本,不涉及张量并行与流水并行。不同卡型的 kernel、精度配置与执行并发各自选择,DAG 与节点接口保持不变。1
五类优化,各自换掉多少时间
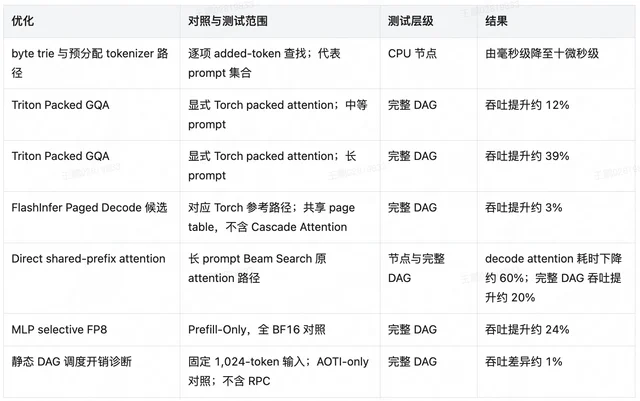
执行边界改完,吞吐就取决于模型节点与相邻 CPU 节点的处理能力。原文列出五类主要开销,逐条给了对照与测试层级。1
第一类是变长样本的 padding 计算。Prefill-Only 一个请求里有多条长度不同的样本,统一 padding 会让短序列按最长序列算完线性层、MLP 和 attention。1
系统的做法从 tokenizer 起就保留序列边界,把有效 token 连续写入 packed buffer,在一个模型节点里完成整个请求的 prefill;sequence boundary 隐式定义 block-diagonal 的 causal mask,序列之间不产生 attention 连接。1
FlashAttention-2 本就有变长实现,但它的变长接口无法同时满足 AOTI 集成与目标 GPU 兼容要求,系统因此自写了 Triton Packed GQA。相对显式 Torch packed attention,中等 prompt 负载的完整 DAG 吞吐提升约 12%,长 prompt 约 39%。1
第二类是 Beam 之间重复的 prompt K/V。所有 beam 共享同一个 prompt,只有 suffix 随搜索路径变化;每条 beam 各存完整 K/V 时状态规模与
W(L_p + L_s) 成正比,改成一份公共 prefix 加逐 beam suffix 后降到 L_p + W·L_s。1执行时不生成拼接 Tensor,Triton kernel 直接读两段 K/V,在同一组 online softmax 状态里合并;parent index 更新时只重排较短的 suffix。这条优化让 decode attention 耗时下降约 60%,长 prompt Beam Search 完整 DAG 吞吐提升约 20%。1
同一节里还有一个被放弃的候选:FlashInfer 的共享 page table Paged Decode 路径提升约 3%,但它与 FlashAttention 一样,接入 AOTI 编译流程后存在稳定性问题,没有被采用。1
第三类是 Beam 候选与状态更新自己。词表大小远大于 beam 宽度时,把
W × V 个分数全部合并是浪费;系统先在每条 beam 内选 2W 个局部候选,展平后从 W × 2W 个扩展里选出全局候选。1候选 ID 与候选分数走两条路径。log-softmax 对同一行保持严格单调,所以 token ID 可以直接在 BF16 logits 上做 Top-K;候选分数由完整词表的 FP32 log-softmax 算好再按 ID 读取,精度和多扫一份词表两件事都避开了。1
专用 GPU Top-K 也评估过,完整 DAG 上没有稳定额外收益,最后保留 Torch Top-K。1
第四类是密集矩阵计算。代表模型的 FLOPs 集中在 MLP、其他线性层与 LM head,这些路径转成 FP8;softmax、候选排序、累计分数与最终业务分值保留 FP32。1
量化细节是 activation 用 per-token 动态 scale,权重离线转 E4M3 并保存 per-output-channel 的 FP32 scale;节点之间仍传 BF16 Tensor,低精度只局限在已经通过验证的矩阵路径里。1
收益并不平均。MLP selective FP8 让 Prefill-Only 的完整 DAG 吞吐提升约 24%,而较小或计算占比低的 linear 拿不到稳定收益——动态量化与格式转换本身也要占时间。1
第五类在小模型上格外要紧:tokenizer、字符串处理和结果编码难以被 GPU 计算摊薄,优化前已经是完整请求时延里不可忽略的一块。1
业务 tokenizer 在基础词表外有一批需要优先识别的 added token,原来逐项做字符串查找,现在按公共字节前缀建 byte trie,一次扫描完成匹配。输入侧先把多条字符串转成连续 UTF-8 字节加长度,规范化与 tokenizer 直接写进预分配的 token buffer。1
输出侧一次解码同一请求里的全部 Beam 候选,把 token、score 和 length 直接写进预分配的 UTF-8 JSON buffer。代表 prompt 集合上的文本处理因此由毫秒级降到十微秒级。1
五条里没有一条是通用优化,每条都依赖「请求内有确定结构」这个前提。被放弃的三个候选也说明了代价:AOTI 这条编译路线把 FlashAttention-2 与 FlashInfer 都挡在门外,变长 attention 与共享前缀因此成了要自己维护的 kernel。1
67% 与 41% 是怎么算出来的
先看容量口径。性能评估在业务常用的相近算力档位单卡上完成,混合精度 MFU 按部署 GPU 的 dense 理论峰值计算,BF16 与 FP8 分别取约 150 与 300 TFLOPS。1
容量测试是固定请求数的 closed-loop 方式:一个请求完成后立即发下一个,中间不加客户端等待。单卡容量取同时满足平均端到端时延低于 20 ms、P99 低于 80 ms 的最高完成 QPS。1
三类代表负载的读数分别是:Prefill-Only 每个请求 15 条样本,单样本平均输入约百余 token,约 100 request QPS,合每秒约 1,500 条样本;短 prompt Beam Search 约 300 request QPS;长 prompt Beam Search 约 120 request QPS。1
后两者的 beam 宽度都约 100、decode 4 次,平均输入分别约 50 与 500 token。三类负载的平均端到端时延都低于 20 ms,P99 约 70 ms。1
有一个细节值得单独拎出来:无约束的峰值吞吐不等于可用的容量。以短 prompt Beam Search 为例,过了选定的容量点再往上加执行并发,QPS 只多几个百分点,平均端到端时延却上涨 30% 以上并越过 20 ms 目标。1
再看有效 MFU。它是本文自定义的指标:把每个请求里 BF16 与 FP8 的逻辑矩阵 FLOPs 分别除以对应的 dense 理论峰值,再乘同一请求口径下的完成 QPS。1
分子只统计 linear、LM head 与 attention 的逻辑矩阵 FLOPs,排除的东西是一长串:物理 shape 对齐或分块的冗余计算、动态量化与 scale、逐元素与非线性、softmax 与 log-softmax、Top-K 与 Beam 状态更新、tokenizer 与结果编码与 DAG 调度、数据传输与同步。1
排除掉这么多,这个数一定高于通用的 MFU 口径,跟别家公布的数字不能直接横比。
两行的拆分也值得抄下来:Prefill-Only 约 67%,其中 BF16 部分约 0.6 TFLOPs/请求、贡献 40%,FP8 部分约 0.8、贡献 27%;短 prompt Beam Search 约 41%,BF16 约 0.08 贡献 17%,FP8 约 0.23 贡献 24%。1
摘要把这两个数写成「约为 SGLang 10 倍」与「约为 SGLang 6 倍」。SGLang 侧没有给出数字,按倍数反算约为 6.7% 与 6.8%——这是本篇的算术,不是官方读数。
这套结论的边界
原文自己划了不适用的清单:开放式长文本生成、decode 长度高度动态、sequence 持续进出、强依赖 continuous batching、跨请求公共前缀长且命中率高、KV 状态规模大需要动态分页与淘汰。这些场景它认为 vLLM、SGLang 更匹配。1
跨请求 prefix cache 是被主动放弃的,理由写得比结论更值得看。模板较早进入业务 Query 与候选文本这类请求特有内容,不同请求间可复用的公共前缀很短,命中率也很低。1
加上平均输入不足 500 token,缓存管理能摊薄的计算有限,于是系统只保留同一 Beam Search 请求内部的 prompt K/V 共享。1
这一条同时也是结论的软肋:整套收益依赖这个模板结构。换到公共前缀长、命中率高的负载上,同一套系统要重新测一遍。
没有公布的东西同样重要。全文没有写单卡型号,只给「业务常用的相近算力档位单卡」与 150 / 300 TFLOPS 两档峰值;SGLang 的版本、配置与部署形态没有写,也没有 vLLM 对照。1
业务侧的收益只有定性表述:在搜索意图分流、搜索相关性判断、生成式召回等场景取得实验显著性,能支撑全量推送。没有 AUC 或 CTR 之类的提升数字,也没有成本节省金额。1
全文没有出现开源、仓库或代码链接,也没有配套论文与权重。所以现在能复用的是判断,不是实现。
下一个能核的节点
判断它能不能搬到自己手上,第一步不在 kernel,而在自己的负载:请求是否因为分批而聚集,单次前向耗时是否稳定在低位毫秒数,decode 次数是否有确定上界。三个都成立,本文的机制才有可搬的部分。
可搬的有三条。把完整请求当作执行与测量单位,而不是拆成逐条生成任务;把固定结构——Beam 的搜索深度就是典型——前移到编译期;在小模型上把 tokenizer 与结果编码算进端到端时延预算。
不可搬的是倍数。要在自己的机器上验证 10 倍这个量级,需要一个公布型号与配置的 SGLang 对照,或者一份第三方复现,这两样目前都没有。
在那之前可以确认的是位置:这套系统已经跑在三条搜推业务上,而它的 10 倍只对着一个未公布配置的 SGLang 量过。
References
- 1SLM 生成式高并发推理引擎:延迟约束下的有效吞吐优化
tech.meituan.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.