R4T:把强化学习编译成监督,Google 用 5390 万参数扩散检索器一次生成整组搜索结果
Google Research 把强化学习当成一次性的目标换能器:先用集合级奖励训练一个查询展开模型,再把它的行为蒸进 5390 万参数的扩散检索器,让「一次返回一整套结果」的检索在查询期只跑一次前向。

输入"露营装备",用户想要的是一整套互相配合的东西:帐篷、睡袋、便携炉、头灯。十个四人帐篷的轻微变体满足不了这个需求。Google Research 把这类任务称为集合式检索(set-valued retrieval),系统要返回的是一组结果1。
常见的应对方式叫 fan-out:让大模型把一条宽泛的查询拆成多条子查询,再分别去库里检索1。这个做法在实测里会露出两处破绽。零样本模型生成的子查询经常同义复读,"波西米亚节日风格"和"波西米亚节日时装"捞回来的内容高度重叠;延迟同样棘手,模型要先写出几百个思维链 token 才能规划出这组子查询,批大小 1024 时整个展开过程的墙钟时间接近 50 秒,而搜索栏能接受的量级是亚秒级12。
Google Research 在 2026 年 9 月 15 日发布了这篇博客,介绍的是论文《Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion》1。论文在 2026 年 3 月 6 日提交到 arXiv,ICML 2026 把它的海报场次排在 7 月 7 日34。方法叫 R4T(Retrieve-for-Train),它把强化学习从查询路径上撤了下来:RL 只跑一次,用来把"什么样的一组结果算好"翻译成训练数据,最后上线的是 5390 万参数的扩散模型1。
集合级的目标无法分解,监督也就采集不到
论文把困难放在目标的形状上。多样性、覆盖度、互补性这类性质无法在单独一条结果上度量,一条内容谈不上"多样",它们只在整组结果上才有定义,论文称之为不可分解(non-decomposable)2。同一层性质还允许多个正确答案并存:同一条"波西米亚节日风格",可以有一百种都成立的搭配组合。现有的监督数据是(查询,内容)配对,只优化单条结果的相关性,编码不了这一层2。
标注这条路因此堵死。要拿到性质对齐的配对,标注者得为一组结果的多样性、覆盖度和互补性整体背书;论文说这类数据采集成本高、主观性强,在垂直领域常常不可行2。
绕开标注的两条路线各拿到了问题的一半。一派把强化学习直接部署到查询期,论文举的例子是 DeepRetrieval 与 s3:奖励能把检索策略塑造成点向相关性以外的样子,代价是每次查询都要跑一遍策略,推理开销高2。另一派把检索搬进嵌入空间,用扩散模型一次采样出整组结果,论文举的例子是 Diff4Steer 与 GDRetriever:采样效率高,但依赖大量性质对齐的训练目标,而这批目标正是集合式检索里最缺的东西2。R4T 与后一派的关系比引用关系更近:被引作扩散检索代表的 Diff4Steer,作者里有 Judith Yue Li、Kun Su、Zhong Yi Wan 与 Dima Kuzmin,四人都在 R4T 的作者名单里2。
把这两条路线摆在同一个维度上看,它们争的是把算力放在哪一端:一端把探索留在查询期,另一端把生成搬进嵌入空间,却缺一批能学的目标。缺口落在监督上,多样性、覆盖度这类性质没有现成标量可用,也就没有现成的训练数据。
离线跑一次 RL,把奖励翻译成监督
R4T 分三步1。第一步用强化学习训练一个查询展开语言模型(fan-out LM,论文缩写 FOLM),让它在给定宽泛查询时生成一组性质对齐的子查询;第二步让训练好的 FOLM 离线合成(查询,目标集合)配对,这一步不需要人工标注;第三步用一个轻量的扩散检索器拟合这个条件分布,在查询期一次性输出整组检索方向12。
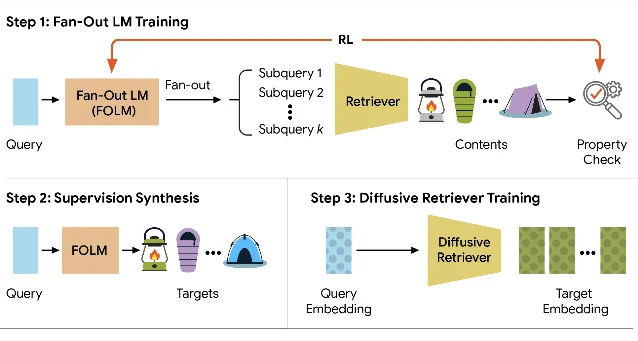
第一步的成败全在奖励怎么定义。论文把"好"写成一个复合奖励,由三项加权组成:groundedness 惩罚子查询嵌入到库内最近邻的距离,逼每条子查询落在数据库所在的流形上;diversity 用 Vendi Score 在每条子查询的代表检索结果上计算,衡量整组的语义跨度;alignment 取子查询与原始查询嵌入的余弦相似度,防止语义漂移。默认权重是 groundedness 0.6,diversity 与 alignment 各 0.22。
三项要同时在场,这一点有消融实验支撑。只优化 groundedness,策略会收敛到 "line ending line ending" 这样的退化字符串:它没有语义,却恰好贴近库里某个坐标,靠距离换到了分数;在 groundedness 之上再加 alignment,崩溃来得更快,因为把原查询复读几遍就能同时拿满两项。Vendi Score 补进来之后,这些捷径被堵住,策略想拿高分,只能去找既落在库内、又彼此不同、还不偏离原意的子查询2。论文还试了三组权重(6:2:2、4:3:3、2:4:4):groundedness 压倒时多样性上升、对齐下降,对齐与多样性加重时探索范围又会被压住2。
训练的规模不大。FOLM 用 Soft-GRPO,也就是在 GRPO 上加前向与反向 KL 惩罚(系数各 0.05),组大小 8,学习率 1×10⁻⁷,全局批 512,跑在一台 TPUv6e-16 上;基座选的是 Gemma3-4B 与 Qwen3-4B 两个 4B 开源模型2。合成监督只用了 4 颗加速核心,为每条查询采 128 个样本、温度 0.9,开放式抽象检索(OAR)任务一共造出 43,874 条宽查询2。
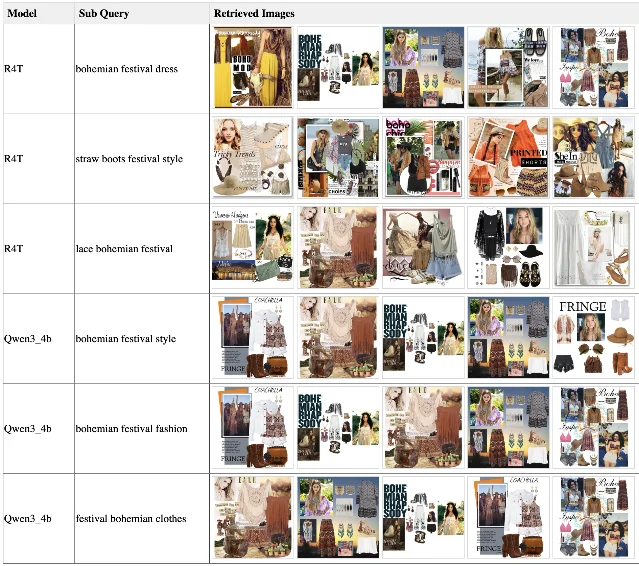
训出来的行为长什么样,论文给了一条具体查询的对照:给定"波西米亚节日风格",R4T 拆出的三条子查询分别落在连衣裙、草编靴和蕾丝三个方向,捞回的搭配风格各异;Qwen3-4B 拆出的三条("波西米亚节日风格""波西米亚节日时装""节日波西米亚服装")几乎同义,捞回的结果也彼此重叠2。
到这一步,R4T 拿到了一个质量不错的展开策略,但它仍然是语言模型,查询期还要自回归地写出十条子查询,那笔接近 50 秒的开销照旧1。
上线的是一个 5390 万参数的扩散检索器
蒸馏的关键在监督长什么样。论文把一组展开结果写成一个目标张量 Z(L×d),每一行代表 FOLM 发现的一个检索方向,训练时随机打乱行序,让模型不依赖方向之间的顺序2。行的内容随任务改变:开放式抽象检索(OAR)取被检索内容的嵌入,弱监督组合式检索(WSCR)取子查询文本的嵌入,前者蒸的是"最终该捞出什么",后者蒸的是"这条查询该怎么拆"2。
扩散器本身很小:VE 扩散配 EDM 框架,Transformer 主干 6 层、隐层 1024、16 个注意力头,序列长度 12、嵌入维度 128,合计 53.9M 参数;查询嵌入经交叉注意力注入,训练时以 0.1 的概率随机丢弃(classifier-free guidance),推理时解概率流随机微分方程 256 步,一次得到 L 个嵌入,再靠最近邻映射回库里的内容12。
论文因此有两个上线变体:R4T-FOLM 把 RL 训好的语言模型直接放在查询期,代表质量上限;R4T-Diffusion 用扩散模型的一次前向替代它,代表能部署的那一版2。
换上扩散模型要付一笔测量上的代价。扩散模型直接从查询嵌入生成内容嵌入,不产生中间子查询,表 1 里 R4T-Diffusion 的 groundedness 一栏因此空着,论文标注为不适用2。权重最高的那一项奖励(0.6)在真正上线的模型上少了一个读数。
质量与延迟各拿到了多少
评测覆盖两个任务。开放式抽象检索(OAR)没有唯一真值,用 LLM 评委在多样性、对齐、贴库三个维度上打分;弱监督组合式检索(WSCR)用 Recall@5K、Hit@5K 与 Vendi Score,候选池由 10 条子查询各取 500 条构成,也就是每次推理 5,000 条2。
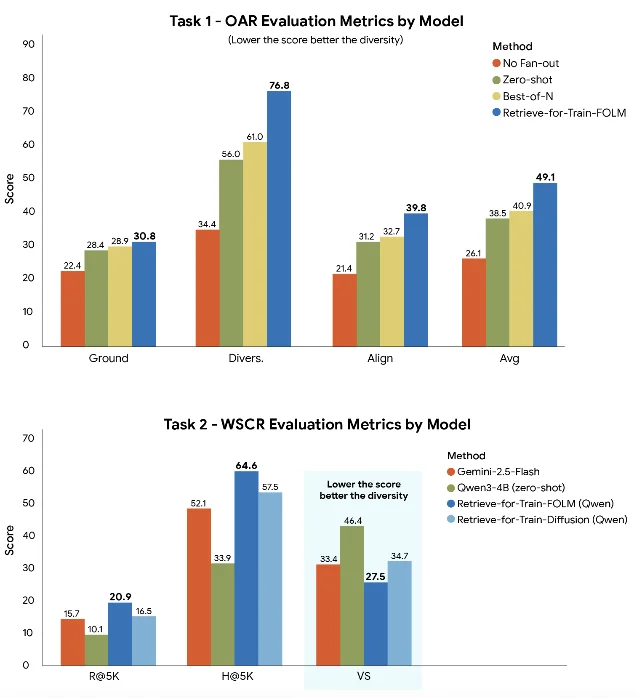
Polyvore 的 OAR 任务上,Gemma3-4B 家族里 R4T-FOLM 三项分别是贴库 30.8、多样性 76.8、对齐 39.8,平均 49.1;同家族的 Best-of-N 是 28.9、61.0、32.7,平均 40.92。Best-of-N 用同一个奖励函数采样五次再择优,论文把它当作最强基线,它比零样本好很多,代价是每条查询要跑五次展开2。WSCR 上,R4T-Diffusion(Qwen)的 Recall@5K 与 Hit@5K 是 16.5 与 57.5,高于 Gemini-2.5-Flash 的 15.7 与 52.12。
延迟的数字更干净。同一个 k=10 的展开任务,自回归模型在批大小 8 时要 1.46 秒,扩散模型要 0.07 秒;批大小 1024 时分别是接近 50 秒与 4.21 秒2。论文给出的区间是 12 倍到 20 倍,与这两个端点相除得到的约 21 倍与约 12 倍吻合2。
有几处单元格支撑不了更宽的说法,它们决定了这套东西能用在哪。音乐数据集上,不拆查询直接检索的 groundedness 是 48.8,零样本的 Gemini-2.5-Flash 与 Qwen3-4B 只有 45.8 和 42.0,拆查询在音乐这个模态上先损失了一部分贴库能力,尽管平均分仍然从 36.9 升到 45.1 与 40.72。WSCR 表里,R4T-Diffusion(Gemma)的 Recall@5K 是 15.0,低于 Gemini-2.5-Flash 的 15.7;同一张表里没有 Best-of-N 一行,"在两个任务上都超过 Best-of-N"这句话只在 OAR 上有数据2。蒸馏也不是无损的:Polyvore 上扩散版的多样性与对齐是 74.3 与 37.6,低于 FOLM 的 76.8 与 39.82。
换基座还会改变三个维度之间的平衡。同一套 R4T 放到 Qwen3-4B 上,Polyvore 的贴库分从 30.8 升到 37.0,多样性却从 76.8 落到 62.8,对齐从 39.8 落到 28.02。
多样性这一项还带出一层反直觉。WSCR 的 Vendi Score 衡量的是同一条查询多次推理之间的语义方差,R4T-FOLM(Qwen)只有 27.5,低于零样本 Qwen3-4B 的 46.4;论文把这归因于强化奖励会降低输出熵、促成模式塌缩,并引用了相关研究2。扩散版把一部分方差找了回来(34.7),论文据此认为把奖励对齐的行为蒸进扩散先验,能让覆盖率与语义丰富度同时改善2。
评测口径还有一处要留神:表 1 的 OAR 分数全部来自 LLM 评委,正文与官方博客都写评委是 Gemini-2.5-Pro,附录 B.1 写的却是 Gemini-2.5-Flash,两处对不上12。
什么条件下这套做法会反过来亏
论文在附录 A 里列了四条限制,第一条关于成本:RL 阶段要反复与冻结的检索器交互并计算显式奖励,这笔开销在部署时被摊给所有查询,论文说当数据库极大或者频繁变更时,前期成本可能相当可观2。摊销的分界线因此落在库的稳定性上:库越稳定,这笔前期成本越摊得开。
另外三条偏向方法论。第二条,R4T 假定想要的检索性质能写成显式奖励函数,创造力、新颖度、文化敏感性这类偏好很难塞进一个标量,论文建议下一步从用户反馈里学奖励2。第三条,评测部分依赖 LLM 评委,会继承评委模型的偏差,人工评测或混合评测协议是它留下的空白2。第四条,结论依赖具体实例化,基座语言模型、嵌入空间、扩散结构换了,结果可能跟着变,论文只试了 4B 基座与对应的嵌入空间2。
结果也全部来自离线数据集:公开的 Polyvore 时尚搭配集,以及一份不公开的工业音乐歌单数据集(候选池 8,522 条歌单嵌入)2。要跟进实现,先确认三件事:自己的库多久变一次,决定前期 RL 成本摊不摊得开;想要的性质能不能写成标量奖励;部署变体上 groundedness 这类性质该用什么替代指标来测。
R4T 提出的判断是:当目标不可分解、标注又不存在时,把强化学习从推理引擎改造成一次性的目标换能器,用一次离线探索换查询期的一次前向。证据支持那条更窄的结论,两个变体在可测维度上都高过同基座的 Best-of-N,扩散版把查询期延迟压到 1/12 到 1/20;同时它留下两处空白,上线变体测不了 groundedness,音乐这类模态上拆查询还会先损失一部分贴库能力。这套做法值不值得跟,取决于自己库里那笔前期成本摊不摊得开,以及想要的性质写不写得成一个标量。
References
- 1
- 2
- 3
- 4
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.