AI工具创业速报:路由、推理配置与零信任执行,AI工具开始接管生产约束
本周从 Ramp Router、SageMaker 推理推荐、Google ADK、Lambda MicroVMs、定制芯片合作与 Codex 迁移案例,看 AI 工具如何把成本、安全、运行和交付约束做成可验证的产品能力。

先看结论
AI 工具这周出现了一个更具体的变化:模型调用之后的成本、延迟、权限、代码执行和部署配置,开始由独立工具直接管理。
Ramp 把模型路由做成一个统一入口,AWS 把推理配置比较做进 SageMaker AI Studio,Google 用签名、沙盒和确定性网关约束 Agent,AWS Lambda MicroVMs 则把隔离运行环境扩展到更多区域。Marvell 与 Google 的定制芯片合作,以及 Asana 用 Codex 完成长期迁移的案例,又把推理供给和 Agent 价值拉到了采购与工程预算里。
对创业团队来说,本周最值得验证的变量是:一次成功任务要花多少钱、要等多久、能拿到哪些权限,以及结果怎样被审计。 这些变量开始比单个模型的演示效果更直接地影响毛利、上线风险和迁移成本。
本期覆盖窗口为 2026 年 8 月 14 日 17:15 至 2026 年 8 月 21 日 17:15(UTC+08:00)。表格中的数字保留原始披露口径;厂商自报的节省、性能和客户案例,会单独标明披露主体。
快速总览
| 事件 | 已确认变化 | 可用范围与限制 | 创业者先做什么 |
|---|---|---|---|
| Ramp Router | Ramp 于 8 月 19 日发布 Router.com,用一个 API 连接多家模型,并按质量门槛把请求路由到成本最低的模型;产品还提供故障自动回退和 100 多项优化。1 | 路由服务到 2026 年底免费,新用户获 26 美元额度;模型 token 按提供商目录价收费。Ramp 称客户平均推理成本下降 40%,这属于公司披露。1 | 用真实请求比较路由前后的质量、延迟、失败率和总成本。 |
| SageMaker AI Studio 推理推荐 | AWS 于 8 月 20 日把 Generative AI Inference Recommendations 从 API 扩展到低代码/无代码界面,自动基准测试多种 GPU 配置并返回排序后的建议。2 | 可按延迟、吞吐或成本优化,比较 TTFT、token 间延迟、吞吐和成本;当前覆盖美国、欧洲和亚太 7 个区域。推荐本身不额外收费,基准任务和端点使用标准计算费用。2 | 给目标模型准备一组真实负载,先测配置差异,再决定是否迁移实例或优化策略。 |
| Google ADK 零信任 Agent | Google 发布基于 Agent Development Kit 的示例架构,把生产状态保护拆成签名写入、gVisor 代码沙盒和确定性输入输出网关。3 | 示例面向客服与退款 Agent;代码沙盒无网络出口并设资源限制,数据库写入需由具体 Agent 签名,网关负责检查提示、工具调用和输出。3 | 先画出 Agent 的写入、执行和外部通信权限,再为每条路径增加可验证的硬门槛。 |
| AWS Lambda MicroVMs | AWS 于 8 月 19 日宣布 Lambda MicroVMs 新增孟买、新加坡、悉尼、法兰克福和斯德哥尔摩 5 个区域,总数达到 10 个区域。4 | 该运行原语提供 VM 级隔离、近即时启动与恢复、状态保留,可为每个用户或任务执行 AI 生成代码;支持 HTTP/2、gRPC 和 WebSockets,具体价格需查看官方定价页。4 | 对需要执行用户代码的产品,测试区域延迟、数据驻留、超时清理和每次任务成本。 |
| Marvell—Google 定制芯片合作 | Reuters 报道,Marvell 将帮助 Google 开发定制芯片;Google 获得最多 5897 万股、行权价每股 206.58 美元的认股权证,全部行权约值 121.8 亿美元。5 | 合作涉及运行 AI 模型、管理存储和传输数据的多类芯片;Reuters 提到的约 1200 亿美元是到 2033 财年的潜在收入规模,取决于 Google 是否达到认股权证绑定的目标。5 | 采购模型服务时,把区域容量、芯片依赖、替代供应商和退出路径一起列入成本表。 |
| Asana 使用 Codex 做长期迁移 | OpenAI 8 月 18 日披露,Asana 用 Codex 在两周内移除已停止维护的 Enzyme 测试系统;模型与基础设施成本约 1.2 万美元。6 | Asana 估算原人工方案约需 5 年、600 万美元;最多 4 个 Agent 并行,工程师每天检查两次进展并审阅每个变更。这是 OpenAI 发布的客户案例和 Asana 的估算。6 | 选择一个可验收的长期迁移任务,用工程周、人工复核时间和回归风险测量真实收益。 |
成本和性能开始由路由层决定
Ramp Router:一个入口,替每个请求选模型
Ramp 于 8 月 19 日发布 Router.com。开发者通过一个 API 连接多个模型,Router 按开发者设定的质量要求,把请求送到成本最低的模型。请求失败时,系统可以自动回退到其他提供商。1
首批接入的模型来自 OpenAI、Anthropic 和 SpaceXAI,Gemini 后续接入;开放模型包括 Nvidia、Kimi、DeepSeek、GLM 和 Qwen。Ramp 还把缓存、压缩、时间安排和请求处理等 100 多项优化放在路由层里。1
Router 的一个关键设计,是用真实工程任务测试模型。Ramp 称,Router 会用由生产任务组成的 Ramp SWE-Bench 比较模型的性能和成本,并把通过测试的模型和路由策略加入默认配置。团队也可以自己配置路由策略。1
商业条款相对清楚:路由服务到 2026 年底免费,新用户有 26 美元额度,用户仍按实际消耗的模型 token 目录价付费。Ramp 称,已经使用 Router 的客户平均降低了 40% 的推理成本;Ramp 自己则称,在保持相同输出的情况下,内部推理成本下降约 30%,生产流量可靠性超过 99.9%。这些数字都来自 Ramp 的发布材料。1
创业判断:模型路由产品真正替团队省下的,可能是持续维护模型目录、失败回退和成本归因的工程时间。采购前要自己验证一个问题:路由器的默认选择能否在你的真实任务上维持质量,而不是只在供应商自己的基准上省钱。
SageMaker AI Studio:把部署配置比较做成可视化工作流
AWS 于 8 月 20 日宣布,SageMaker AI Studio 已提供 Generative AI Inference Recommendations。这个能力此前已经有 API 版本,现在增加了低代码和无代码界面,让团队描述工作负载与优化目标后,直接比较多种推理配置。2
团队可以选择交互、生成、摘要或自定义场景,再选择降低延迟、提高吞吐或降低成本。系统会在真实 GPU 上用 NVIDIA AIPerf 做基准测试,尝试推测解码、内核调优等策略,并按首 token 延迟(TTFT)、token 间延迟、吞吐和成本排序。2
模型可以来自 JumpStart、S3、Model Registry 或现有 SageMaker 模型。团队可以在 Studio 里比较建议,再直接部署到 SageMaker 实时端点。详情页列出的可用区域包括美国东部(弗吉尼亚北部)、美国西部(俄勒冈)、美国东部(俄亥俄)、欧洲(爱尔兰)、欧洲(法兰克福)、亚太地区(新加坡)和亚太地区(东京)。推荐本身不额外收费,但基准优化任务和端点会产生标准计算费用。2
创业判断:部署配置正在从平台工程师的经验,变成产品团队也能参与的比较问题。团队可以用 20 个真实请求跑一次基线,记录 TTFT、完整响应时长、吞吐、实例费用和失败重试,再决定是否接受平台建议。
Agent 执行开始拆成权限、隔离和门禁
Google ADK:系统提示词之外,再加三道硬边界
Google 8 月 17 日发布了一篇基于 Agent Development Kit(ADK)的零信任 Agent 实践。文章把客服与退款 Agent 作为例子:Agent 会读取用户请求、生成 Python 脚本计算退款、写入数据库账本,再返回确认结果。只要 Agent 能够改变生产状态,提示词里的规则就不足以单独承担安全责任。3
Google 给出的架构分成三层:
- 签名写入。 每个 Agent 使用自己的密钥为数据库状态变更签名,数据库在提交交易前验证签名。Google 的生产示例建议把私钥放在 Cloud KMS 和 HSM 中;开源演示则用 HMAC 让开发者可以在本地运行。
- 代码沙盒。 动态生成的代码放进 gVisor 用户态内核环境,关闭网络出口、删除额外能力,并设置内存、CPU 和执行时间限制。
- 输入输出网关。 模型请求、工具调用和结果返回都经过确定性规则检查,网关可以拦截个人信息、密钥外传、越权退款和提示注入信号。3
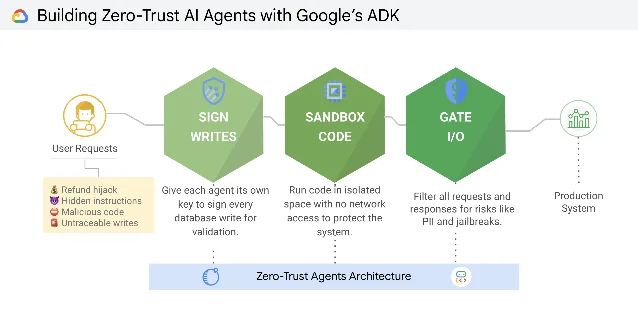
这套架构给创业团队的启发很具体:数据库写入、代码执行和外部通信不应共享一份宽权限。每种动作都要有自己的授权主体、资源范围和失败后的审计记录。
AWS Lambda MicroVMs:把隔离的代码执行放到更靠近用户的区域
AWS 于 8 月 19 日宣布,Lambda MicroVMs 新增孟买、新加坡、悉尼、法兰克福和斯德哥尔摩 5 个区域,总数达到 10 个区域。Lambda MicroVMs 是一种无服务器计算原语,为用户代码或 AI 生成代码提供 VM 级隔离、近即时启动与恢复速度,以及状态保留。4
开发者可以从 Dockerfile 创建 MicroVM 镜像,再为每个用户或任务启动独立环境。每个 MicroVM 都可以有自己的 HTTPS 地址,并支持 HTTP/2、gRPC 和 WebSockets。AWS 还提供了 Agent Toolkit for AWS 的专用技能,方便 Agent 开发工具调用这类运行环境。4
创业判断:这项更新降低了「每个用户或任务都要有隔离执行环境」的部署门槛,但它没有替团队解决成本和权限设计。产品上线前仍要测四件事:区域往返延迟、数据驻留要求、超时后的环境清理,以及一个任务的完整计算费用。AWS 详情页把价格指向官方定价页,当前发布信息没有给出具体单价。4
基础设施合作把推理供给写进采购约束
Marvell—Google:定制芯片合作也开始绑定股权安排
Reuters 8 月 19 日报道,Marvell Technology 将帮助 Google 开发定制芯片。交易中,Google 获得最多 5897 万股 Marvell 股票的认股权证,行权价为每股 206.58 美元;如果全部行权,认股权证价值约 121.8 亿美元,Google 将成为 Marvell 的第五大投资者。5
合作范围覆盖与 Google TPU 相关的多类芯片,包括运行 AI 模型的处理器、管理存储的芯片和负责网络数据传输的芯片。Reuters 提到,如果 Google 达到认股权证绑定的目标,这项合作到 2033 财年可能带来约 1200 亿美元收入;这个数字是潜在规模,不是已经确认的订单金额。5
Reuters 同时把这笔交易放进更大的供应链背景:云厂商正在增加定制芯片,以寻找比通用 GPU 更适合推理的成本结构。这个背景说明,创业团队采购模型 API 时,供应商的芯片、区域和容量安排最终都会影响延迟与价格;它并不意味着定制芯片一定会替代通用 GPU。5
创业判断:早期产品就应该把模型提供商、推理区域和运行时接口分开。这样做的目的不是预测哪家芯片公司会赢,而是避免供应商的容量、区域或商业合作变化时,团队只能整体重写产品。
企业案例把 Agent 价值单位改成迁移项目
Asana:两周完成预计五年的测试系统迁移
OpenAI 于 8 月 18 日披露,Asana 使用 Codex 移除了已经停止维护的 Enzyme 测试系统。Asana 原本预计这项工作需要 5 年,旧方案的人力成本估算约为 600 万美元;Codex 完成这次迁移用了两个日历周,模型与基础设施成本约为 1.2 万美元。6
Asana 从一个五句提示开始,最多让 4 个编码 Agent 并行工作,每个 Agent 使用代码库的独立副本。工程师每天检查两次进展,并审阅每一项拟提交的变更。OpenAI 的案例还写到,简单指令比更复杂的设置更有效。6
这组数字适合用来设计测试方法;普遍 ROI 仍要由其他团队的真实样本测量。案例的披露主体是 OpenAI,5 年和 600 万美元是 Asana 对原方案的估算;其他团队的代码库规模、测试覆盖率、人工复核速度和回归风险都可能不同。6
创业判断:编码 Agent 的价值单位可以从「生成了多少行代码」改成「完成了多少个可验收的长期迁移」。团队应选择一个预计周期超过 4 周的真实项目,记录 Agent 节省的工程周、人工复核时间、回归测试结果和重新打开的缺陷数量。
把六条消息放在一起
这六条消息共享一个具体约束:AI 进入生产后,团队必须把模型输出接到一套可以测量和限制的执行系统里。
- 成本与延迟需要被测量。 Ramp Router 通过路由、回退和模型测试管理请求成本,SageMaker AI Studio 通过真实 GPU 基准比较实例和优化策略。12
- 权限与执行需要被拆开。 Google 把数据库写入、动态代码和 I/O 分到三道边界,Lambda MicroVMs 则为每个用户或任务提供独立运行环境。34
- 基础设施和交付结果需要进入预算。 Marvell—Google 的交易把推理芯片供给和长期商业目标绑定,Asana 的案例则把 Agent 的产出落到一个有测试、有审阅的迁移项目。56
因此,创业团队接下来比较工具时,应该把默认模型、单次调用价和演示速度放进更大的账本:一条任务链需要多少输入和重试,谁能写入生产状态,生成代码在哪里执行,失败之后怎样回退,最后又怎样证明结果可用。
给创业团队的本周动作
- 做一次成功任务成本审计。 选 20 个真实请求,记录输入和输出 token、缓存、工具调用、重试、人工审批、实例费用与完成时间。先找出最贵的三类成功任务,再决定是否接入模型路由。
- 画一张 Agent 权限矩阵。 把数据库写入、代码执行、网络访问和文件读取分开授权。每一项状态变更都记录具体 Agent、用户、资源和结果。
- 跑一轮推理配置基准。 用同一组真实负载比较两个实例类型或两种优化策略,至少记录 TTFT、完整响应时长、吞吐、成本和失败率。平台推荐可以作为候选,不能替代自己的业务样本。
- 给生成代码设隔离测试。 在非核心环境验证无网络、CPU 与内存上限、超时和临时文件清理。测试要包含恶意输入和异常退出,而不只运行正常样例。
- 用长期迁移项目测 Agent。 选一个预计周期超过 4 周的真实工程任务,把 Agent 的并行数、人工复核时间、回归测试结果和返工缺陷写进同一张表。这样得到的 ROI,才接近采购决策需要的数字。
这周值得验证的不是哪个模型又进入默认列表,而是你的产品能否在模型切换、区域变化、权限收紧和执行失败之后,仍然交付同一个可验收的结果。
References
- 1
- 2
- 3Build zero-trust AI agents with Google’s Agent Development Kit
developers.googleblog.com
- 4
- 5
- 6

This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.