补丁全过测试却在真实服务里跑不起来、Jev+Mercury 换接口从 25/49 到 49/49、134.7 米开完花 7.74 美元
过去二十四小时里八组材料的结论都跟着同一处走:同一批补丁通过了全部测试,端到端服务测试却否掉约三分之一;同一套 Jev+Mercury 走 DOM 是 25/49、挂上工具接口是 49/49;134.7 米的路第二次才开完,账单 7.74 美元。

过去二十四小时里,八组材料的结论都跟着同一处走:这个东西是拿什么条件算它过关的。
同一批补丁,通过了隐藏功能测试、回归测试和对抗性审查,装进真实的推理服务里却跑不起来——在一个新基准里,这样的补丁占了约三分之一。同一套 Jev+Mercury 2.5,走原始网页 DOM 时 49 道题只解出 25 道,挂上工具接口之后 49 道全部解出。同一辆丰田卡罗拉,让前沿模型自己开完 134.7 米的锥桶路线,第二次尝试才成功,这一趟的推理账单是 7.74 美元。
这一期把八组材料的任务设定、运行条件、具体数字、分歧环节和作者自己承认的限制放在一起,供正在选模型、自己部署和报账的读者核对。覆盖 2026 年 9 月 23 日至 9 月 24 日,来源为 X、Reddit、小红书与公众号,另含论文、官方评测榜与独立评测页。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 改一个真实的推理服务 | SWE-Serve:53 个取自 SGLang 已合并改动的任务,11 个模型 31 档配置各跑 3 次 12 | 19 个带服务端检查的任务上,全量验证器 45.9%、去掉端到端测试 69.4%;跨运行时域的任务 47.7% 对单一域 69.0% | 单次上限 210 分钟 / 350 步;环境只有 CPU 与单卡 H100 |
| 让模型开真车 | DrivingBench:一句一条命令,同一对话内最多三次尝试,车是装了 comma 4 的卡罗拉 34 | 只有 GPT-6 Astra 跑完,第二次 100%、5 分 22 秒;另三个模型最好一次只走到 45% | 车速上限 0.94 mph,全程有人随时刹车 |
| 同一个浏览器 agent | WindTunnel:49 道题、8 个真实站点、21 种配置,共 2,793 次尝试 56 | Jev+Mercury 2.5 配工具接口 96.5 分、49/49;同一配置走 DOM 67.3 分、25/49 | 榜单由工具方自己维护;每题限 600 秒 |
| 一台新机器的本地能力 | M6 Mac mini 16GB 基础款,LM Studio 与 Draw Things 78 | 9B 与 16B 可用、70B 装不下;生图 1 分 40 秒;agent 任务半小时未完成 | 单机评测;官方的 4.8 倍出自特定测法 |
| 175 个讲题样本 | Braintrust MathTutorBench:7 类任务、175 个样本 910 | Opus 5.5 正确率 80.1%、表达 84.4%,领先未达统计显著 | 样本量小;同一轮里篇幅约束那一项差距很大 |
| 同样 16GB 显存 | 4080 加 64GB 内存跑 Qwen3.8 Flash Next 130k 上下文;另一台 16GB 显存跑 Qwen3.8-27B 1112 | 前者 16.5 tok/s 生成、350 tok/s 预填;后者 13.3GB、18 TPS | 两边都要先改分支或换量化;评论区有人报出不同的数 |
| 300 美元的矿卡 | 两块 BC-250、合计约 27GB 显存、1GbE 互联,跑 Qwen3.6-35B-A3B Q4_K_M 13 | 60 tok/s、64k 上下文 | 评论区先问满上下文还是短提示,作者没答 |
| 一张厂商对比表 | 厂商宣传表 + 两个第三方仓库 + 开源模型卡 1415 | 微调后 0.766、开箱 0.362、多数类基线 0.461 | 各数来自不同口径,需要逐项核对 |
补丁全过测试,装进真实服务里跑不起来
SWE-Serve 是 9 月 22 日挂上 arXiv 的一个新基准,任务全部取自 SGLang 已合并的生产改动 1。它筛任务的过程写得很细:先看 786 个候选源,做成 156 个可执行候选,最后留下 53 个,覆盖投机与高级解码 14 个、模型与后端启用 12 个、内核量化与性能 8 个、服务 API 与运行时正确性 8 个、缓存与运行时状态 7 个、分布式执行与调度 4 个。参考解法的中位改动是 553 行、7 个文件;典型验证器带 7 个新行为测试和 10 个回归测试;19 个任务会真的把服务启动起来,其中 3 个在 H100 上设了性能门槛 2。
它要量的是「本地做完」和「生产正确」之间的距离。在最能说明问题的 19 个任务上,同一批补丁交给完整验证器,通过率 45.9%;把 276 个端到端服务测试从计分里拿掉、其他测试一个不动,通过率升到 69.4%。627 个补丁里有 147 个是这么翻过来的 2。单个任务上的例子更具体:Gemma 4 MoE 那道题,33 个补丁里有 16 个通过了其他所有检查,却至少在一个端到端服务测试上失败。
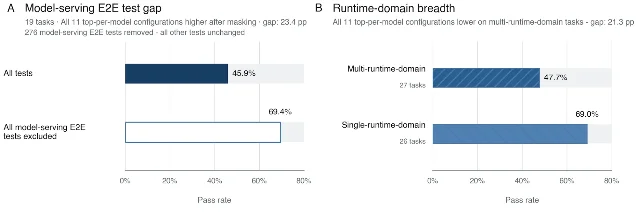
第二组数字说的是任务的跨度。只涉及单一运行时域的 26 个任务,通过率 69.0%;跨多个运行时域的 27 个任务,47.7%,差 21.3 个百分点,而且这个方向在被测的每个模型上都成立 2。
模型的排名与账单也一并公开了。评测用一个只带 Bash 的最小 agent、闭卷跑(封掉公网与上游仓库,只允许从 Hugging Face 取权重),单次上限 210 分钟或 350 步,11 个模型 31 档配置各跑完整 53 题三次,各模型最好配置的 pass@1 落在 34.6% 到 75.5% 之间。榜首两档是 Claude Opus 5(max)的 75%±3%、每个任务 17.40 美元、平均 57.5 分钟,和 GPT-5.6 Sol(max)的 75%±6%、12.26 美元、29.5 分钟。同样拿到 64% 的有四个:Sonnet 5(xhigh)6.61 美元、Kimi K3(max)7.24 美元且要用 99.9 分钟、GPT-5.6 Terra 5.06 美元、GPT-5.6 Luna(max)0.95 美元 2。测评方自己的读法是成本与成绩不成正比,也没有哪个模型在六个工程族里全都领先。
还有一处反直觉的结果值得单独记下:把模型放回自家 harness,成绩反而更低。GPT-5.6 Sol 在 Codex 里是 73.6%,Claude Opus 5 在 Claude Code 里是 69.8%,都低于它们用这个通用最小 agent 拿到的 75%。评测另审计了 1,749 次试验,拦下 196 次试图联网检索的行为,没有一次成功 2。
134.7 米开完:第二次才成功,账单 7.74 美元
DrivingBench 把前沿语言模型放进一辆真车里:一句一条命令,通过 comma 4 设备与 openpilot 控制一辆丰田卡罗拉,车上有人随时准备刹车,同一个对话里最多尝试三次 3。
成绩是这样分布的。GPT-6 Astra 在 Codex 的 medium 档下,第一次只走到路线的 49%(67.3 米)、没有完成、这一次花掉 2.01 美元;第二次走完 100%、134.7 米、用时 5 分 22 秒、花费 7.74 美元。另外三个都没跑完:Claude Fable 5.1 三次分别走到 9%、10%、45%;Grok 4.6 是 8%、11%、10%;GPT-5.6 Sol 三次都是 6% 3。榜单对「进度」的定义写得很清楚——沿路线中心线、且始终保持在中心线 4 米以内的最远位置,撞车就停在撞车前的进度。
Loading content card…
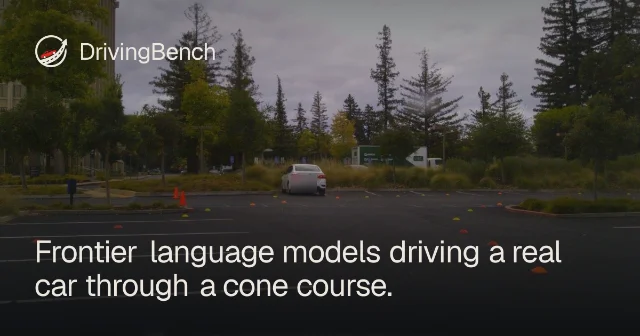
把这一趟换算成钱,读法就变了。当天的报道记下了几个条件:车速上限 0.94 mph;设备是一台 999 美元的 comma 4、一台接车机 CAN 总线的笔记本,以及一部连到模型服务器的手机;Astra 这一趟用了 660 万 token,研究者按列表价付了 7.74 美元,折下来大约每英里 92.47 美元 16。同一篇报道算了一笔对照账:一辆每加仑跑 25 英里、油价 4.60 美元的车,每英里油费约 18 美分,推理账单大约是油费的 500 倍,这还没算硬件、保险和全程监看的人。
榜单页与报道在 token 数上并不一致:榜单该行写的是 2.466 亿,报道写的是 660 万,费用两处都是 7.74 美元。这个差留给读者自己点开核。
失败的地方也不在「会不会开」。报道说,模型识不出第一道斜排锥桶的哪一侧才是车道;有模型以安全为由拒绝控制车辆,研究者把控制服务器改名成「DrivingBench Sandbox」之后拒答变少,但仍有模型认出这是真实摄像头画面而停止配合。延迟是另一道坎:Astra 每五到六秒调用一次摄像头观察工具,其余时间都在处理下一步;Claude 在一次 190 秒的尝试里只行驶了 31 秒,剩下的时间车是停着的 16。研究者自己的结论是,短期内自动驾驶仍应交给专用模型,通用模型眼下更适合把感知、规划和控制的经验蒸馏进一个能塞进车里的小模型。
同一套 Jev+Mercury:走 DOM 是 25/49,挂上工具是 49/49
WindTunnel 是一个开源的浏览器 agent 基准,49 道题、8 个真实网站、21 种配置,每道题每种配置尝试三次,共 2,793 次尝试,单次尝试给 agent 600 秒;最终分由尝试成功率 60%、每任务成本 20%、每任务耗时 20% 合成,成本和耗时做对数归一 5。
9 月 18 日的 v1.2 加进了同一套模型在两种接口下的对照,结果差得很远。Jev 负责挑工具、Mercury 2.5 负责写参数,挂上工具接口时最终分 96.5、49 道全部解出、147 次尝试里成功 141 次、每任务成本中位数 0.0011 美元、中位耗时 3.2 秒,排在榜首;换成同样的两个模型走原始 DOM,最终分 67.3、只解出 25 道、成功 76/147、每任务 0.0008 美元、中位 5.4 秒,掉到第 12 名 5。同一份榜单上,GPT-5.6 Luna 91.5、Gemini 3.6 Flash 88.2、Sonnet 5 86.0、GPT-6 Astra 84.0、GPT-5.6 SOL 与 Claude Opus 5 都是 82.0,全部是配了工具接口的配置;前九名清一色如此,不带接口的最好成绩是第 10 名的 71.3。
Loading content card…
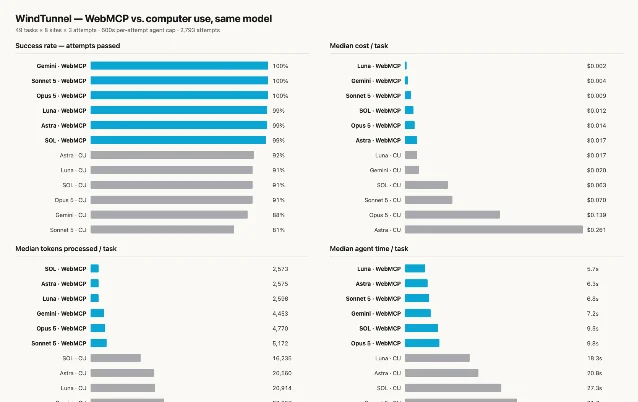
X 上 9 月 24 日转述这组数字的帖子写的是「模型成本比 GPT-6 Astra 低约 112 倍」,这跟榜单页给的每任务成本中位数是两个口径:前者说的是模型推理成本,后者把耗时也折进了总分,读数时别把两个数混在一起 6。
反过来的例子同一天也有。一位开发者在自己的真实对话记录上测了 Jev 替大模型挑 connector、挑 skill 和挑第一个工具的能力:40 次里挑对 connector 18 次、挑对 skill 21 次;而「沿用上一轮用过的 connector」这个不用任何模型的策略,31 次里对了 21 次 17。他自己给这条测试的说明是「第一次做,目标定高了」。
M6 Mac mini:4.8 倍落在提示词处理那一栏
M6 是苹果第一款 2nm 的 Apple Silicon,460 亿晶体管,密度提升约 35%,也是 Mac mini 第一次把 Neural Accelerator 放进每个 GPU 核心——苹果跳过了 M5 这一代;它带两个神经引擎,苹果称峰值算力翻倍 7。
WIRED 测的是 16GB 的基础款,给出的是一份很克制的账。在 LM Studio 里,90 亿参数的 Qwen3.5 和 160 亿的 Llama 3.2 都跑得起来,交互接近正常聊天速度,但离云端前沿模型还远;700 亿参数的 Llama 2 装不进去,提示至少需要 32GB 内存,硬加载会让系统立刻冻结 7。
图像这一栏的数字更具体:在 Draw Things 里跑约 90 亿参数的 FLUX.2、20 步、完全本地,这台 16GB 的机器平均 1 分 40 秒出一张图,比测试者手边那台 48GB 的 16 英寸 M4 Pro MacBook Pro 慢 20 秒。真正卡住的是 agent:让 90 亿参数的 Qwen3.5 读 15 个本地文本文件、整理成一份详细报告,那台 M4 Pro 用了 9 分 43 秒,16GB 的 M6 Mac mini 跑了半个多小时还没完成 7。评测者把 16GB 上的 agentic AI 直接列进了缺点,建议想跑家庭 AI 工作流的人从 32GB 版(1,299 美元)起步,要 48GB 或 64GB 就得换 M5 Pro 的 Mac mini。
苹果那个「4.8 倍」的落点需要说清:原话是 LM Studio 里的提示词处理速度最高到 M4 的 4.8 倍,另一句「部分 AI 性能最高 4 倍」也是对着特定测法说的 7。中文转述那篇补了一组生成速度:9B 约 28.4 tok/s、16B 约 12.1 tok/s、70B 约 3.6 tok/s,并给出带宽对照——M6 约 170GB/s,M5 Pro 是 307GB/s 8。这组生成速度是该篇自己标的口径,评测原文没有给到同一组数字。
175 个样本上领先 2.1 点,报告自己说没到显著
Braintrust 把 Opus 5.5 和两款新的 GPT-6 放进 MathTutorBench:7 类任务、175 个样本,既看解不算得对,也看讲不讲得清 9。
结果是 Opus 5.5 正确率 80.1%、表达质量 84.4%,GPT-6 Luna 78.0% 与 83.8%,GPT-6 Sol 76.8% 与 84.1%。测评方自己的结论写得很直白:在这个小规模测试里 Opus 5.5 的观测结果最强,但领先幅度没有达到统计显著,更像一个方向而不是定论 9。
同一轮还查了另外几件事,其中一项把画风拉了回来:Opus 5.5 只有 72% 的回答守住了篇幅预算,GPT 系列(包括 GPT-5.6 Sol)是 95% 到 99%;速度上 GPT-6 Sol 平均每例 2.2 秒、Luna 2.8 秒。得分、简洁和快,在这份报告里是三个不同的指标 9。中文那篇转述把这一组的读法落在「别只看谁赢榜单」上 10。
同样 16GB 显存,两边的答案不一样
两条实测,约束是同一个:16GB 显存。r/LocalLLaMA 上一条帖子把 Qwen3.8 Flash Next 压进 4080 的 16GB 显存加 64GB 内存,跑 130k 上下文、q8 KV 缓存,给出 15 到 20 tok/s;作者自己把经验总结成一句话——需要四样东西:对的量化、对的模型、对的分支、对的缓存标志 11。
四样东西分别是什么,帖子里写得清楚:量化用 AtomicChat 的 AD-4.27bpw Q4_K_M;模型要配一个共享的 Unsloth MTP 头;分支得自己从作者的 pr-mtp-fix 构建,主干还加载不了这个 MTP 头(需要 PR #28243 加一个修复提交);缓存标志是最关键的一条
--spec-draft-cpu-moe,让草稿专家住在内存里,把 GPU 留给目标模型的热专家 18。在 131k 上下文下,换到 IQ4_XS 是 16.5 tok/s 生成、350 tok/s 预填,而这个量化原本大约只有 10 tok/s。评论区把这条帖子的边界补上了。一位同样用 4080 加 64GB DDR5 的用户说,同一个 gguf、不挂 MTP,他能拿到 22 tok/s 生成和 450 tok/s 预填,并反问作者用了什么参数;另一位 4060 Ti 16GB 的用户照这套配置跑到 200 到 230 tok/s 预填、22 到 28 tok/s 生成,代价是从原来 IQ3_XXS 的 400 tok/s 预填换过来,他换到的是 q8 KV、更长的上下文和一个更聪明的模型;还有一位用 24GB 显存加载 Unsloth 的 Q3,报 50 到 60 tok/s 与 600 tok/s 预填,但自己注明那是一个非常改造过的 llama.cpp 11。
小红书那一边是同一道题的另一份答案。一位作者在 16GB 显存上跑 Qwen3.8-27B 的 UD-IQ4-XS 量化(13.3GB),报 18 TPS,认为属于个人能用的水平,并说回答的幻觉少了很多;他本想打开 MTP 提速,查下来是那个 llama.cpp 构建的源码里没有这个功能 12。
评论区比正文长。作者后来补了一句:打开 MTP 后大约 25 TPS。他也在评论区声明了自己的限制——显卡是 A 卡、价格不到 1000 元,请不要拿大几千上万的卡来比生成速度。下面还有人建议换 GSQ 版量化、把上下文做到 200k 以上、换 Vulkan 能再快约 10%;作者的回复分别是「已经是混合量化了」「装不下了」「开源驱动比原生更快不是没可能,但是不想折腾了」。另有一位自称 196k 全显存 50 tok/s 的,被问到是什么显卡时没有回答 12。
300 美元的矿卡跑 35B:60 tok/s,但评论区先问上下文
r/LocalLLaMA 上 9 月 24 日的一条帖子是另一种思路:两块从矿机上下来的 BC-250 板子,每块 115 美元,用 llama.cpp 的 Vulkan 后端加 RPC 跑在 Bazzite 上,两块合计约 27GB 显存,靠 1GbE 以太网互连,含电源约 300 美元;上面跑 Qwen3.6-35B-A3B 的 Q4_K_M,60 tok/s、64k 上下文。作者说他还想看看六块板子跑 Qwen3.8 Flash 会是什么样 13。
Loading content card…
评论区第一个实质问题正好落在这个数上:这 60 tok/s 是在 64k 上下文填满的情况下拿到的,还是短提示词?1GbE 上的 RPC 通常先体现在预填上。作者回答了散热胶带、板子要装回机箱、下一步做六板这些事,没有回答这一问;另一个问同一台机器换 Qwen3.8-27B 会怎样的,也没有下文 13。
那张「快 7.8 倍、便宜 3 倍」的表,被逐格核了一遍
小红书上有位作者做了一次逐格核对。起因是网上流传的一张对比表:开源的 Laya 比 Jev 快 7.8 倍、便宜 3 倍、成本 0 美元 14。
开源模型卡本身就把几个数字的来源写清楚了。同一个 typed-decisions 基准上,微调过的 laya-typed-decisions 准确率是 0.766,而开箱的 base checkpoint 只有 0.362;随机基线 0.318,永远猜最多那一类的基线是 0.461——开箱状态连多数类基线都没打过。Jev 1.13.0 公开的数字是 0.727 15。
校准误差也是同一个故事,而且方向在拟合前后会反过来。拟合之后,Laya 的 routed ECE 是 0.081,Jev 在同一口径下是 0.246;拟合之前则相反:base checkpoint 的 raw ECE 是 0.213,Jev 是 0.144。那张表里被引用的 0.081 是拟合后的数,跟它并排比的那个 Jev 数字却不是同一口径 15。模型卡自己写了建议:要信它的概率,请先在自己的数据上做温度校准。
Jev 那一侧也有反例。核对那篇提到,厂商说快 40 到 200 倍,第三方实测的 p50 是 264 到 276 毫秒,一份报告直接以「最快实测」为标题;在一个情绪基准上有 16% 的样本给正确答案打了 0 概率——打算按置信度转人工的人要当心;候选选项的上限是 255,到 256 就报错 14。
Laya 的边界写在它自己的模型卡里,比宣传表坦白:候选一多就垮,选项数超过 20 之后开始明显下降,77 个选项的银行意图分类只有 0.425,同一项 Jev 是 0.870;英文版在非拉丁文字上会失手,高棉语准确率 0.000,而它给出的置信度是 95.2%;上下文也短,英文版 512、多语言版默认 1,024 15。中文那篇还补了两个部署读数:Mac 上 MLX 单题 13.42 毫秒、Core ML 4.98 毫秒,而打到 Core ML 上上下文只剩 96 个 token 14。
核对者最后的落点不是谁赢。他把问题收成两句:这个数是在哪儿测的,边界在哪里——本地还是跨境、微调后还是开箱、拟合后还是出厂,同一个模型换三种测法能差一个量级。
看一个数字之前,先问它是拿什么算的
今天这八组材料给不出一个统一的名次,能带走的是一套看数字的动作。三句话够用。
第一句,先问这一栏是谁在跑、及格线画在哪。SWE-Serve 里同一批补丁,全量验证器 45.9%,去掉端到端服务测试 69.4%;DrivingBench 里 Astra 第一次只走到 49%,第二次 100%。两处的差别都不在模型,而在算它过关时用了哪些测试。
第二句,再问这里面什么东西被换掉了。同一个 Jev+Mercury 2.5,走 DOM 是 25/49,挂上工具接口 49/49;同样是 16GB 显存,一边要换量化、改分支、加缓存标志才到 16.5 tok/s,另一边换个量化到 18 TPS,而 MTP 那个开关在那个构建里根本打不开。
第三句,最后问这个数是在什么状态下量的。Laya 的 0.766 是微调后的,开箱是 0.362,比「永远猜最多那一类」的 0.461 还低;被引用的 0.081 校准误差是温度拟合之后的,拟合前是 0.213。M6 Mac mini 那个 4.8 倍说的是 LM Studio 里的提示词处理,而 16GB 那台机器上,半个小时的 agent 任务都没跑完。
最后留一个能自己动手的核对项:挑一件你每周都要做的活,在同一台机器上只换一处条件跑两次——把量化档从 IQ4_XS 换到 Q4_K_M,或者把浏览器 agent 从截屏点击换成工具接口,或者只把评测档位从 medium 挪到 xhigh——把预填速度、生成速度、完成质量和这一次的账单一起记下来。今天这几组里,同一件事在 25/49 与 49/49 之间、在 0.362 与 0.766 之间、在 6% 与 100% 之间,隔的就是这一处。
References
- 1
- 2How SWE-Serve Exposes the Gap Between Local Tests and Live Serving\
developer.nvidia.com
- 3DrivingBench\
drivingbench.com
- 4X:134.7 米实车测试\
x.com
- 5WindTunnel — the WebMCP Benchmark\
webmcp.com
- 6
- 7
- 8公众号 旭森智体视野:M6 Mac mini 开卖第三天\
mp.weixin.qq.com
- 9Opus 5.5 vs new GPT-6 models for writing quality\
braintrust.dev
- 10公众号 Ai学习的小健:别只看谁赢榜单\
mp.weixin.qq.com
- 11
- 12小红书 笨钟电子电路:本地16G显存部署 qwen3.8-27B\
xiaohongshu.com
- 13r/LocalLLaMA:Two BC-250 ex mining APUs\
reddit.com
- 14小红书 混沌生序:Jev 对 Laya:AI 比快也比水分\
xiaohongshu.com
- 15convaiinnovations/laya 模型卡\
huggingface.co
- 16
- 17
- 18GitHub:qwen38-flash-next-mtp-16gb
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.