E256|Agent、机器人与制药,谁先被 GPT-6 Astra 改写:完整逐字稿和精华摘要
基于《硅谷101》E256 的完整音频,整理泓君与许华哲、朱哲清、王晟的三段对谈:Astra 在机器人上是飞跃但在制药上只完成三成实验设计,个人 Agent 卡在浏览器与身份验证,附按说话人分段的完整逐字稿。

《硅谷 101》第 256 期在 2026 年 10 月 20 日上线,主播是泓君,嘉宾是破壳机器人创始人、清华大学交叉信息研究院助理教授许华哲,Pokee.ai 创始人兼 CEO 朱哲清,和华盛顿大学计算机学院助理教授王晟。1
完整音频长 1 小时 19 分 40 秒,入口是官方 RSS,视频版发布在硅谷 101 播客的 YouTube 频道。节目录制于 2026 年 9 月 29 日。
本期没有商业赞助。开头 00:00:05 到 00:00:46 是主播给团队新节目《消费 101》做的口播,正片从 00:00:49 开始。
三个人被问到同一个问题:这一代模型在你的领域里算不算大的节点。
做机器人的许华哲说它带来了定性变化,做模型的朱哲清说它只是长程任务上的稳定提升,做生物医学的王晟说它的实验设计完成度只有 30%。
9 月的五条线索
Astra 是 OpenAI 9 月发布的旗舰模型。官方把计算机使用、浏览、软件工程和科学列为主要能力:FrontierMath 第四档 98%,ARC-AGI-3 99.9%。2
计算机使用这一项,官方给出的对比是 OSWorld 2.0 上的 72.6%、每题约 40 分钟,上一代 GPT-5.6 Sol 是 65.7%、每题约 75 分钟。2
消费端的变化来得更快。Astra 发布 5 天后,Meta 上线个人 Agent「Muse」,给每个用户配一台云端电脑,两周冲到美国 App Store 榜首。3 它的对手 Instinct 在一个月里把估值从 25 亿美元做到了 100 亿美元。4
企业端,xAI 的 Grok Bot 给出另一种形态:每个 Bot 跑在一台持久的云电脑上,有浏览器、文件系统和终端。xAI 官方文档:Grok Bot
模型层冒出来的是 Jev。它不写文字、不写代码,只从给定的选项里返回概率,母公司 TypeSafe 把它叫作「系统 1 模型」。5
生物医学这边有两件事。9 月 23 日,Anthropic 公布 Claude 用约 21 小时找到一个类 CRISPR 的新酶系统,命名 ART。6 10 月初,扎克伯格夫妇的 Biohub 把虚拟细胞计划的盘子扩到 18 亿美元。7
这五件事构成了这一期的三张考卷:Agent 能不能替人把事情办完,机器人能不能接住一个通用模型,制药的瓶颈到底在哪。
Agent:活能干,卡在「你是谁」
朱哲清是 Pokee.ai 创始人兼 CEO,此前负责 Meta AI 的应用强化学习团队,斯坦福强化学习博士。
在他看来,这一次在编程上的变化没有那么大。Opus 4.5 到 4.6 那一步才是范式转变:工具调用几乎不再出错,长程任务可以自己跑完(约 00:08:35—00:09:00)。
Astra 相对上一代,他的体感是「更长、幻觉更低、审美更好」,但没有解决以前完全解决不了的问题(约 00:09:11)。
他自己测下来,Astra 在长程任务和迭代上确实有稳定提升,对上下文和已完成的步骤更清楚,幻觉更少(约 00:07:31—00:07:50)。
短板有两处。速度更慢;让它连跑 24 小时,幻觉仍然会出现(约 00:07:50—00:08:02)。
Computer Use 为什么又火了
按他的说法,行业原本的判断是工具都会开 API,应用会做 Agent Native 的接入(约 00:13:29)。
但现实里很多第三方应用不愿开放接口。购物、旅行这类场景,模型绕不开浏览器,只能像人一样点页面(约 00:13:47)。
Instinct 和 Muse 背后都在解浏览器。「我觉得这又回到了当年 Manus 的情况」(约 00:13:57)。
Manus 一开始也走浏览器,后来发现效率不够,集体退回写代码和调 API。绕了一圈,浏览器又成了绕不开的东西,所以最后会是一种混合状态(约 00:14:12)。
这里有个新的麻烦:远程的浏览器操作跑在云端的商用机器上,只能靠 Bright Data 这类代理遮住商用 IP,假扮成普通消费者(约 00:14:54)。
商家已经开始封这类流量。奢侈品网站更早,几乎所有都被屏蔽。朱哲清说,如果用的是用户自家网络的 IP,就不会被拦(约 00:15:23—00:15:29)。
他更看好的方向是本地:现在放出来的模型大多在 30B 左右,可以跑在一台 AI box 或个人电脑上。浏览器操作发生在本机,云端的瓶颈就不存在了(约 00:14:19—00:14:47)。
这条路一旦走通,会逼着应用厂商改浏览器机制,把沙箱放到本地(约 00:15:35)。
Muse 像 Manus,结局可能也像
Meta Muse 的虚拟机设置跟当年的 Manus 很像,主打浏览器的场景集中在旅行、购物和客服,这些任务没法靠 API 完成(约 00:16:34—00:16:46)。
他提醒了一件事:Manus 当年走过一模一样的路,也一模一样的被全部封掉(约 00:16:53)。
后来 Manus、Genspark 都往白领工作上偏。Claude Code、Claude Cowork、ChatGPT Work 最后都往这个方向靠,原因是很多事一开始能做,很快就被巨头封了(约 00:16:57—00:17:15)。
亚马逊确实动手了。9 月 20 日前后,它把 Muse 从站内屏蔽,理由是这个 Agent 不表明自己是谁,还像是一直攥着用户的登录凭证。8
第二天,Shopify 把 Muse 接进了所有店铺。同一件事上,两家公司的判断完全相反。8
朱哲清的解释是身份。云端虚拟机证明不了「这个 Agent 代表这个人」,商家会觉得自己的流量入口被拿走了(约 00:20:05—00:20:26)。
他算了一笔账:一个用户换成 20 个 Agent 来比价、刷流量,消费能力没变,商家得不偿失(约 00:20:38—00:20:53)。
所以他认为这波消费级 Agent 最后会落到软硬件结合。硬件属于用户,就能确认 Agent 是这个人派来的,商家才愿意开权限(约 00:20:58—00:21:00)。
一百美元能买多少 token
Muse 给每个用户的免费额度是 1 亿 token。朱哲清按输入成本估算,大约 100 美元(约 00:17:57—00:18:21)。
云端虚拟机的开销同样在账上。内存和 CPU 都不便宜,他们自己做强化学习时发现,租虚拟机跑沙箱太贵,最后自己租大 CPU 机器搭沙箱,因为「CPU 的价格跟 GPU 的价格一样了」(约 00:18:44—00:19:11)。
Astra 是这套账里最贵的一项。按节目里的说法,它每百万 token 输入 10 美元、输出 50 美元,是 GPT-6 Sol 的四到五倍(约 00:23:06—00:23:18)。
他举了自己的经历:20 倍的订阅套餐用完,花 100 美元买额度,两三次 Agent 流程就没了(约 00:23:28—00:23:41)。
所以他认为,把一成流量路由到 Astra,对免费产品就是灾难。「Meta 可能财大气粗没关系」,但 Instinct 这类公司要用至少 Sol 级别的模型,获客成本会非常可观(约 00:23:48—00:24:16)。
他给自家产品定的目标是反向的:至少 60% 到 70% 的 token 在本地产出,而不是全部路由到前沿模型(约 00:24:27—00:24:33)。
企业市场正在分叉
Grok Bot 在他身边更多是尝鲜。它更主动一些,但写代码的活 Codex 和 Claude Code 都能干,真正接进工作流的人还少(约 00:25:02—00:25:07)。
更真实的画面在传统企业里:法律、医疗的从业者还在琢磨怎么脱离 Microsoft Copilot,连 Codex 和 Claude Cowork 都不能随便用(约 00:25:17)。
「整个行业现在分叉非常大,走在前面的人什么都可以随便用,走在后面的人现在还在泥潭里挣扎。」(约 00:25:36)
机器人:先别急着说 GPT 时刻
许华哲是破壳机器人创始人,同时在清华大学交叉信息研究院任教。
他给 Astra 的评价是飞跃式的。过去几代升级在机器人测试上几乎没有表现,原来做不了的还是做不了,这次是定性上的变化(约 00:30:33—00:30:47)。
最直接的证据是适应能力。给它一个陌生的机器人本体,它很快摸清运动速度和空间;撞到桌子,它会判断桌子高,把手抬得更高(约 00:04:38—00:04:58)。
第二件是自我迭代。网上有人让它操作机械臂画金门大桥,第一遍画得差,它会复盘怎么画得更好,几轮之后画得相当像(约 00:05:21—00:05:25)。
第三件是 Real-to-Sim。给它几张图片,它很快能把实验室或办公室变成仿真环境。过去这件事要拍大量视频、手工标定(约 00:06:45—00:07:09)。
许华哲自己复现的是插花:花茎下端劈开、有点分叉,塞不进瓶子,它会先把分叉捏窄再往里塞(约 00:05:47—00:06:16)。
分层的那一刀,被往下压了
机器人行业一直认同分层:上层做规划,下层做控制,争论的是线切在哪(约 00:32:13)。
过去普遍认为视觉语言动作模型负责规划层,比如接到「做西红柿炒蛋」,它拆成开冰箱、拿西红柿、拿鸡蛋,具体怎么开、怎么打,交给下面更小的模型(约 00:32:13—00:32:17)。
Astra 的变化是它能做低层的动作控制,指令可以细到「把手往右伸两厘米」「放在门把手上,没抓住就再往前靠」(约 00:32:30—00:32:34)。
它把这条线往下压,底下的模型变得更像反射,听懂往左往右就行,像提线木偶(约 00:32:38—00:32:50)。
有人由此推断,上层模型会一路往下压,最后变成完全端到端的模型。许华哲不同意:速度是硬约束,网上那些演示要 16 倍或 24 倍速才能看(约 00:33:09—00:33:13)。
另一半原因是物理直觉。人随手一碰,知道杯里有水会洒、玻璃会碎;Astra 靠语言推理能想到,但要在一个动作里立刻反应过来,还不够好(约 00:33:22—00:33:37)。
它慢的机制也说明了这件事:模型大是一部分,内部思维链很长是另一部分。简单任务和复杂任务的思考时长差不多,于是复杂任务上显得聪明,简单任务上就成了额外开销(约 00:33:54—00:34:17)。
本地 10B,云端 200 毫秒
他给的尺寸是:装在机器人本地,10B 左右比较舒服;十几 B 到几十 B 也能做,硬件成本要上去(约 00:34:46—00:34:54)。
放到云端,模型大小几乎没有限制,受限的是网络延迟和显卡代次。准静态任务,200 毫秒甚至几百毫秒都能接受;高动态任务只能放本地,倒水时卡一下,水就洒出来了(约 00:35:13—00:35:40)。
自家的筷子夹小球和 Astra 的差别很典型。自研模型快得多,抓取是连续试错,失败了换个角度再来,中间没有太多逻辑推理(约 00:36:02—00:36:16)。
Astra 每做一步都要分析原因,再给自己下指令调整,过程更像人,代价是慢,而且一旦分析错了就推不下去(约 00:36:22—00:36:40)。
抓取后的旋转它偏弱,要把东西塞进墙上的小孔,得反复试(约 00:36:44—00:37:01)。
利好本体,分化大脑
许华哲不认为仿真会因此翻身。Astra 让 Real-to-Sim 变容易,但它只是把三维外观做好了,物理引擎并没有因此更准(约 00:37:32—00:37:47)。
他判断真正受益的是本体和硬件。Astra 出来两三周,斯坦福就有课题组把它接进宇树机器人,在家做家务任务,论文两周就写出来了(约 00:38:00—00:38:14)。
做大脑的公司会分成两派:一派相信会出现更快、更适合具身场景的模型,可以参考 Astra 的思维链和数据标注方式;另一派放弃自研大模型,转做部署,把自己变成 Astra 调用的工具(约 00:38:23—00:38:45)。
研究范式也在变。过去做传统机器人规划的人,现在往 Agentic 和 Harness 的方向走,把各种能力组合起来(约 00:39:29)。
老领域 TAMP 重新被提起。它把任务规划和控制放在一起做长程任务,过去靠传统规划一步步推进,比如要拧开瓶盖,上一步先确认瓶盖是关着的(约 00:39:40—00:40:03)。
数据标注的门槛也跟着抬高了。以前只标注「你做了什么」,现在要把因果和直觉物理标出来:没抓住,是因为位置偏上,还是东西沾了水太滑(约 00:40:29—00:40:49)。
他听到的传闻是,OpenAI 只卖不标注的原始数据,认定外面的标注都是错的,自己内部重标(约 00:41:10—00:41:20)。
数据公司于是分成两类:卖生数据靠起量,管理上千人去采;卖熟数据要懂前沿模型怎么训,能说清「这是 OpenAI 的标注方式,这是 Pi 的标注方式」,单价能翻十倍(约 00:41:23—00:41:58)。
惊艳之后,短板也很具体
三四周试下来,团队的心态是有变化的。最初让它抓东西,很快就成了;再往下试空间要求、语义要求、物理要求,就有了那句「机器人的 GPT 时刻还是 GPT」(约 00:43:31—00:43:52)。
再往里看问题就露出来了。双臂任务几乎做不了,叠衣服完全叠不了。语言不容易描述的任务,它的能力反而弱(约 00:43:56—00:44:10)。
总结能力也不行。第一次做一件事花一小时,第二次 45 分钟,之后就一直停在 45 分钟,从第三次开始变成常数。人和经过充分训练的小模型,会越做越快(约 00:44:17—00:44:34)。
Jev 在机器人上表现很差。它没法输入图像,得先跑一个视觉模型把状态变成文字喂给它;摞方块时经常摞不起来,或者摞上去就倒了。Astra 能看出第一块摞歪了,第二块往另一边靠,Jev 没有这个能力(约 00:45:43—00:46:16)。
所有人都看到了这个局面:你不能回避 Astra,又不能直接用它。剩下的问题是快慢两套系统怎么接,上层给的是调用、还是指令、还是别的界面(约 00:45:12)。
他给的时间表是 2028 年初
他最关心的是零样本的泛化能力(约 01:13:16)。
机器人原来有两条路:一条做部署,一条做泛化,两者几乎正交。部署像是在给上一代机器人加 AI:工厂里的机械臂开环拧螺丝,靠标定位置;加上 AI 之后可以闭环,但仍然要五个博士级的人在现场泡三个月,调稳定性、调速度、定制末端夹爪(约 01:13:22—01:14:00)。
他要的通用机器人,是零样本就能快速部署,五个普通人把它放到位,干些体力活就行,冗余可以接受(约 01:14:00—01:14:24)。
时间上,他给的是 2028 年初开始真正实用,也就是从现在起 18 个月后,人在家里用语言让机器人做掉 90% 的事(约 01:14:33—01:14:47)。
他也承认机器人比大模型慢。2023 年两者同时出发,大模型跑得快,物理世界的东西总要慢一些(约 01:14:58—01:15:07)。
制药:方案能写完,实验写不完
王晟是华盛顿大学计算机学院助理教授,研究方向是用生成式 AI 解决生物医学问题。10
他的判断是这一代是大节点。没有客观基准可以比较,但现实是团队已经把任务从 Claude 系列切到 Astra 上(约 00:09:35)。
好用的地方有两处。一是 Computer Use:生物医学里那些多年前写的老软件,界面差、术语多,跨领域的人上手成本很高,Astra 能按简单的提示词操作,人还能跟着它学怎么用(约 00:09:54—00:10:27)。
Astra 发布时放了一个生物医学的 Computer Use 演示,操作的是常用网页工具 MultiQC,在他们圈子里传得很开(约 00:11:47—00:12:03)。
二是长程任务。生物医学的一个任务常要跑 8 到 24 小时,Astra 能撑下来。它慢,但慢让他更放心,觉得它在深思熟虑(约 00:11:05)。
他现在的用法是切换:白天用反馈快的模型,晚上把长程的流程交给 Astra,让它跑一整夜(约 00:11:19)。
生物医学知识没有变强,拒绝反而变多了
他也点出了这次提升的来源:强在通用的编程能力和长程任务,不在生物医学知识本身。专门测生物医学知识的基准上,Astra 并没有提升(约 00:28:47—00:29:04)。
更麻烦的是拒绝回答。越新的模型对生物医学任务防范越严,实际用起来体验越来越差,团队内部因此改用 Kimi K3 这类小模型;一定要用 Astra 时,得先解释「我不是在做危险的事,我在设计基准」(约 00:29:04—00:29:39)。
他还怀疑现有基准的方向。生物医学的基准大多是给一个明确的数据集预测一个明确的问题,退化成了 Kaggle 式的数据科学比赛,和真正做药物发现差得很远(约 00:30:01—00:30:15)。
从 Computer Use 到 Human Use
他把这件事叫作 Human Use:Computer Use 是 AI 怎么操作电脑,Human Use 是 AI 怎么指挥真实实验室里的实验员(约 00:48:15)。
实验设计只完成三成
这是他给出的最具体的数字。让现在的大模型设计一个实验,完成度「可能只有 30%」,剩下要靠人类专家改(约 00:50:41—00:50:44)。
难点在领域知识。设计一个高效、成功率高又可行的实验,需要长期做这个方向的实验员,教授本人也未必知道(约 00:50:56—00:51:01)。
难点还在资源。每个实验室的器材不一样,模型不会按现有条件设计实验。他打的比方是:厨房里有番茄、鸡蛋、土豆,让它做一道菜,它不理解这些原料,会给你报一道海鲜大餐(约 00:51:08—00:51:35)。
为什么严肃的 AI 制药公司必须自己养实验室
因为验证太慢。设计一个分子,拿到老鼠身上做实验,几周就过去了;这几周里模型可能已经换了一代(约 00:52:18—00:52:38)。
完整的周期更长:细胞和老鼠上的实验几周做完,灵长类动物实验要做四个月,做两次就是八个月。走到这一步,AI 制药公司通常把分子授权给大药厂去做人体实验,授权费一般在一千万美元以上(约 00:53:25—00:54:04)。
所以他认为,前沿的 AI for Science 团队必须有自己的湿实验室,而且要按 AI 的节奏改造:前置条件提前备好,模型一给出预测,立刻把小分子放进去(约 00:52:38—00:53:09)。
AlphaFold 那一轮的教训
上一波 AlphaFold 之后,AI 药物发现公司像雨后春笋。大部分后来没有成功,因为它们只做设计和发现,最后被真实的老鼠和人体实验卡住(约 00:55:06—00:55:29)。
AlphaFold 3 开源之后,社区很快有了 OpenFold 这样的开源版本。真正拉开差距的是数据:一条数据要在真实的动物身上跑出来,价值几万到几十万美元(约 00:56:50—00:57:17)。
开源反而让垂直科学公司更有优势,因为数据是它们的护城河,而这些数据在预训练语料里根本看不到(约 00:57:04—00:57:49)。
新形态:模型出预测,机器立刻做实验
他提到一家叫 Adaptive Bio 的公司,专门和 Anthropic 合作:模型给出预测,它以 MCP 的形式立刻去做实验。这家公司刚刚完成一轮融资(约 00:58:34—00:58:43)。
他预期未来每个湿实验公司都会以 MCP 或 API 的形式直接接进大模型,中间的沟通成本被削掉(约 00:58:43—00:58:56)。
Anthropic 已经明确配备了自己的实验室,最近还办了一场比赛,以湿实验的验证作为最终标准(约 00:59:15—00:59:35)。他也听说 Anthropic 自己在组建湿实验的团队,招的人带着湿实验背景,并推测 OpenAI 会陆续跟上(约 00:59:35—00:59:49)。
他还提到一个人事变动:和哈萨比斯一起拿诺贝尔奖的 John Jumper 加入了 Anthropic(约 01:00:24)。David Baker 自己也有很多家制药公司,但他理解那位科学家更专注研究本身(约 01:00:34—01:00:42)。
好的基准应该没有上限
他给的设计思路是让题目刷不爆。现在最好的药能杀死 30% 的癌细胞,那就问模型能不能做到 40%,让它一直设计下去(约 01:04:14—01:04:17)。
这么做还有一层用处:不停做湿实验,虽然贵、虽然慢,但能积累出可观的数据,形成一个飞轮(约 01:04:28)。
要避开的是简单分类题,比如判断某个基因会不会致癌,这类题很快会被模型解决(约 01:04:38)。
他也解释了 AI 制药为什么还没有一款药被验证:一个药的周期是五到十年,AI 大规模参与是最近几年的事,还没走完一轮(约 01:05:09—01:05:22)。
突破的速度几乎正比于实验周期。酶和蛋白质的实验快,迭代就快;衰老、罕见病这种长周期问题,进展会慢很多(约 01:06:31—01:07:02)。
科学家转向定义问题
他的判断是:如果一个问题定义得很清楚,有明确的测试集和输入,模型解决问题的能力会超过他(约 01:02:41—01:02:53)。
人类科学家留下的事情是定义哪些问题值得解、设计基准和评估方法,以及在关系到病人的决策上背书。他的比喻是飞机:能自己飞,还是希望有个驾驶员在上面(约 01:03:26)。
几处可以对上的数字
| 节目里的说法 | 公开口径 | 来源 |
|---|---|---|
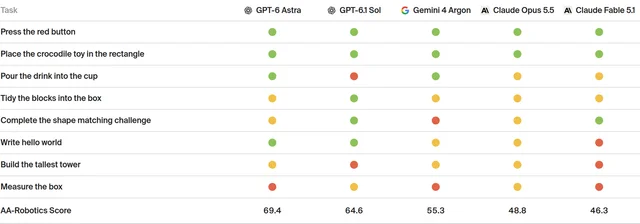
| 很多机器人基准失效了,Astra 都成了第一名 | 对得上,只是榜单晚于录制:8 项桌面任务里 Astra 69.4 分第一,GPT-6.1 Sol 64.6,Gemini 4 Argon 55.3,Claude Opus 5.5 48.8,Claude Fable 5.1 46.3 | AA-Robotics v0.1 |
| 它太慢了,演示要 16 倍或 24 倍速才看得下去 | 数量级对得上:Astra 平均每题约 30 分钟、16.36 美元,人类平均 20 秒,慢了约 100 倍 | AA-Robotics v0.1 |
| Claude 用 21 小时找到一个叫 ART 的新酶系统 | 对得上:约 950 个 agent、2.1 亿 token、21 小时;2026 年 9 月 23 日公布,功能仍未知,预印本 10 月 5 日上线 | Anthropic:Claude discovers a novel enzyme system |
| Biohub 把虚拟细胞计划扩大到 18 亿美元 | 对得上,时间在 10 月 7 日:Biohub 与美国能源部、NIH、Google、Isomorphic Labs、Meta 共同投入 | Biohub · Reuters |
| Meta Muse 两周就冲上美国 App Store 榜首 | 对得上:9 月 8 日上线,22 天下载超过 500 万次;9 月 20 日前后被亚马逊屏蔽,隔天 Shopify 接入了它 | 香港经济日报 · The New Stack |
| Instinct 一个月内估值从 25 亿涨到 100 亿美元 | 对得上:9 月底完成 10 亿美元 C 轮,估值 100 亿美元,公司 14 人,创始人是 23 岁的 Noah Shinn | 腾讯新闻(FX168) |
| Jev 发布 24 天就融了 8.7 亿美元 | 对得上:9 月 15 日发布,10 月 9 日宣布 A 轮 8.7 亿美元,投后估值 75 亿美元 | 爱范儿 |
| Grok Bot 开放了企业部署 | 对得上:官方文档写明每个 Bot 跑在持久云电脑上,并单列了团队与企业的部署方式 | xAI 官方文档:Grok Bot |
三个人的判断
朱哲清:模型、成本与身份
- 这一次在编程上不是大节点。Opus 4.5 到 4.6 才是范式转变,工具调用几乎不出错,长程任务能自主完成(约 00:08:40—00:09:00)。
- Astra 在长程和迭代上有稳定提升,对上下文更清楚、幻觉更少,但跑 24 小时仍会出现幻觉(约 00:07:31—00:08:02)。
- 浏览器操作回潮,是因为第三方应用不愿开 API;云端商用 IP 会被商家封,出路是把浏览器放到用户本地(约 00:13:47—00:15:35)。
- 消费级 Agent 最后会落到软硬件结合,因为身份验证是商家开权限的前提(约 00:20:05—00:21:00)。
- 成本是这一轮的硬约束:Astra 每百万 token 输入 10 美元、输出 50 美元,把一成流量路由过去就会让免费产品亏穿(约 00:23:06—00:23:48)。
- 企业市场正在分叉,走在前面的团队什么都能用,传统企业的员工还困在 Copilot 里(约 00:25:17—00:25:36)。
许华哲:机器人拿到了一个能反思的大脑,还没拿到身体
- Astra 在机器人上是定性变化,前几代升级对机器人几乎没有影响(约 00:30:33—00:30:47)。
- 它能做低层动作控制,把规划与控制的界线往下压,但速度和物理直觉挡住了端到端(约 00:32:30—00:33:37)。
- 本地 10B 比较合适;云端只适合准静态任务,高动态任务必须放在本地(约 00:34:46—00:35:40)。
- 受益最大的是本体和硬件,做大脑的公司会分成自研快模型和转做部署两派(约 00:37:55—00:38:45)。
- 数据标注的门槛从「做了什么」变成「为什么成、为什么败」(约 00:40:29—00:40:49)。
- 通用机器人真正实用要等到 2028 年初,18 个月后家里九成的事可以交给它(约 01:14:33—01:14:47)。
王晟:真正的瓶颈是验证
- 这一代是大节点,团队的实际任务已经从 Claude 系列切到 Astra(约 00:09:35)。
- 它的提升来自通用编程与长程能力,生物医学知识本身没有变强,拒绝回答反而更频繁(约 00:28:47—00:29:39)。
- 实验设计的完成度只有 30%,模型还不理解实验室里现成的器材和原料(约 00:50:41—00:51:35)。
- 严肃的 AI 制药必须自带湿实验室,一条动物实验数据的价值在几万到几十万美元(约 00:52:03—00:57:17)。
- 好的基准应该没有上限,能持续产出实验数据,而不是一道很快被刷满的分类题(约 01:04:14—01:04:38)。
- 人类科学家的工作转向定义问题、设计评估、为重大决策背书(约 01:02:56—01:03:42)。
关键节点
下面的章节标题来自官方单集页,时间按音频里实际出现的位置标注。1
- 00:05|新播客《消费 101》上线
- 00:49|9 月 AI 大事记
- 04:18|各领域实测 Astra 感受
- 09:11|生物医学「古董级软件」有了 Computer Use
- 12:17|Computer Use 是什么?与 API 调用的区别
- 15:47|Meta Muse 会走 Manus 的老路吗?
- 17:31|Meta Muse 破局关键——软硬件结合
- 19:37|商家愿意开 access,前提是确认身份
- 22:21|个人助手 Agent 新一轮烧钱获客大战
- 24:57|Grok Bot,「走在后面的人」
- 25:44|前沿 Lab 最烧 token 的是 AI for Science
- 27:48|小模型追大模型,差距在缩小,但可能追错了 benchmark
- 30:19|未来需要快决策模型 + Astra 的推理能力
- 35:48|筷子夹小球效果:自研模型对比 Astra
- 37:25|Astra 冲击:利好本体硬件
- 39:07|从 TAMP 到 Agentic:机器人规划重回台前
- 40:19|数据标注新门槛:标注因果与直觉物理
- 43:06|惊艳之后,Astra 也有明显短板
- 45:12|Jev「快系统」的潜在价值
- 47:10|实验设计完成度只有 30%,Astra 缺什么?
- 51:39|AI 制药,离不开实验室的验证和数据积累
- 53:15|制药时间线:AI 设计分子快,真实验证慢
- 55:01|从 AlphaFold 开源,看垂直科学公司的数据护城河
- 58:24|未来趋势:湿实验公司用 MCP/API 直连大模型
- 01:02:15|人类科学家的角色转向「定义问题」
- 01:03:47|好的 benchmark,应该是无上限的
- 01:06:31|ART 的启示:酶和蛋白质实验周期短,最先跑出来
- 01:07:48|「蒸馏」是否让普通人失去了价值?
- 01:11:51|Agent、机器人与 AI 制药的核心问题
术语
- Astra:OpenAI 2026 年 9 月发布的旗舰模型,官方主打计算机使用、浏览、软件工程与科学能力。节目里的嘉宾习惯把它当作这一代通用模型能力的上限来对比。
- Computer Use:模型看着屏幕、移动鼠标、敲键盘,像人一样操作一个软件,不需要对方提供 API。王晟用它操作生物医学里那些没人愿意重写的老软件。
- Browser Use:Computer Use 的一个分支,专门在浏览器里点网页。购物、订票这类场景没有 API,只能靠它。
- Harness(工程框架):包在模型外面、让模型能真正干活的一层工程,负责接工具、存记忆、管权限。同一个模型换一个框架,跑分可能差很多。
- VLA(视觉语言动作模型):把看到的画面、语言指令直接变成机器人动作的模型。机器人行业长期用它做任务规划层。
- Sim-to-Real / Real-to-Sim:前者是把仿真里训练的策略搬到真实机器上,后者是把真实场景搬进仿真。Astra 让后一件事便宜了很多,物理引擎并没有因此变准。
- TAMP:把任务规划与控制放在一起做长程任务的机器人研究方向,过去靠传统规划一步步推进,因为通用模型出现而重新被重视。
- 系统 1 / 系统 2:借自快思考与慢思考的划分。系统 1 是快速、直觉式的反应,系统 2 是慢速、推理式的判断。Jev 自称系统 1 模型,机器人行业也常把本体策略归到系统 1。
- 干实验 / 湿实验:干实验是在计算机里做预测和模拟,湿实验是在真实实验室里用试管、培养皿、动物做验证。王晟说瓶颈在后者。
- Human Use:王晟造的说法,指 AI 指挥真实世界里的实验员做事,对应 Computer Use 里的「操作电脑」。
- 零样本(zero-shot):模型在没见过的任务上直接做,不做专门训练。许华哲最关心的就是机器人零样本部署的能力。
- 蒸馏:用强模型的输出训练小模型,把能力压缩过去。节目尾声讨论的是:当强模型只从专家数据里学,普通人的经验还值不值得被学习。
- ART:Anthropic 公布的新酶系统,全称 array-associated reverse transcriptases,与一段重复 DNA 序列相邻,结构和 CRISPR 有相似之处,功能仍未知。Anthropic:Claude discovers a novel enzyme system
几句原话
「整个行业现在分叉非常大,走在前面的人什么都可以随便用,走在后面的人现在还在泥潭里挣扎。」
——朱哲清,谈企业市场的真实分化,约 00:25:36。
「如果我要用这样一个模型去解决一个难的任务,这一次就要调用 3 到 40 美金。」
——朱哲清,谈 Astra 的调用成本,约 00:23:22。
「机器人的 GPT 时刻还是 GPT。」
——许华哲,谈试完 Astra 之后的感受,约 00:43:49。
「在一个语言不太好描述的任务上面,Astra 的能力其实并没有很强。」
——许华哲,谈它的短板,约 00:44:06。
「我觉得完成度是可能只有 30% 吧。」
——王晟,谈大模型设计实验的完成度,约 00:50:41。
「所以我们真正在意的问题都是不能被 Benchmark 衡量的,都是没有答案的。」
——王晟,解释为什么生物医学的问题最后都要落到湿实验,约 00:49:15。
「就像飞机就算能自己飞,我们也希望有个驾驶员在上面。」
——王晟,谈人类科学家为什么还要在回路里,约 01:03:26。
「AI 圈子看到的是能力曲线,那行业里的人看到的就是落地周期。」
——泓君,收尾时对三个领域的总结,约 01:19:08。
完整逐字稿(按说话人)
本稿依据官方单集页的完整音频转写,覆盖 00:00:00 到 01:19:40。为保留现场语感,口语、重复与中英混用都保留,只对明显的识别错误(人名、公司名、产品名、术语与同音错字)做了最小校正。说话人为四位:泓君(主播)、许华哲(破壳机器人创始人、清华大学交叉信息研究院助理教授)、朱哲清(Pokee.ai 创始人兼 CEO)、王晟(华盛顿大学计算机学院助理教授)。时间点为该段话在音频中的起始位置,为近似值。节目开头 00:00:05—00:00:46 是为新节目《消费 101》做的口播。有三处原音不清,保留原样并以〔转写异常〕标出;另有一处极短的插话没被识别出来,以〔此处一句原音不清〕标出。
泓君|00:00:01 嗨,大家好,欢迎收听硅谷 101,我是泓君。
泓君|00:00:05 在我们节目正式开始之前,告诉大家一个好消息。
泓君|00:00:09 过去大家在硅谷 101 节目中听到了很多跟消费相关的选题,比如像跑鞋战争、消失的爱马仕股份去哪了,还有最近我们对超级厄尔尼诺现象的解读。
泓君|00:00:21 那未来呢,我们会把所有这些跟消费相关的商业现象单独推出一档新的播客叫做《消费 101 一周一更》。
泓君|00:00:31 由硅谷 101 很受大家欢迎的消费方向的主持人麻花来主持。
泓君|00:00:36 我们会一起跟大家分享消费商业里的十万个为什么。
泓君|00:00:40 那欢迎对生活方式还有消费感兴趣的朋友来关注我们的新节目。
泓君|00:00:49 好,那说回我们今天的节目,我们来聊一聊 OpenAI Astra 发布对行业的影响。
泓君|00:00:55 那这集我们是选了 Agent、机器人还有制药三个方向去聊。
泓君|00:01:00 对机器人还有 AI for Science 来说,它可能是历次模型更新里冲击最大的一次,所以不少人把它叫做机器人领域的 GPT 时刻。
泓君|00:01:11 从 Astra 发布到今天我们听到这期节目,虽然只过去了一个多月,但是行业的进展实在是太快了。
泓君|00:01:20 有很多的热门产品我们都在这期节目里面会提到,所以我先来讲一讲这个月几个关键的进展还有背景。
泓君|00:01:28 〔此处一句原音不清〕。
泓君|00:01:29 我们先说 Agent 这边,在 Astra 发布 5 天以后,Meta 上线了个人的 Agent Meta Muse,给每个用户一台云端电脑,它两周就冲到了美国 App Store 的榜首。
泓君|00:01:41 那它的对手 Instinct 一个月内的估值就从 25 亿美元涨到了 100 亿美元。
泓君|00:01:47 这是在 C 端。那在 B 端,xAI 它的 Grok Bot 它也开放了企业部署。
泓君|00:01:54 还有在模型层,一个叫做 Jev 的模型,它突然就火了。
泓君|00:01:59 它是怎么回事呢?它不写字、不推理,只给选项去打概率。
泓君|00:02:04 它的母公司 TypeSafe 叫它是一个系统 1 的模型,是借助了快思考与慢思考里面的系统 1。
泓君|00:02:11 它发布 24 天就融了 8.7 亿美元,估值 75 亿美元。
泓君|00:02:17 那这几个是在 Agent 这边。
泓君|00:02:19 我们再来看一看 AI 制药也有两件大事。
泓君|00:02:23 一个是 9 月底,Claude 仅仅只用了 21 小时,自己就找到了一个叫做 ART 的新酶系统。
泓君|00:02:30 它的结构非常像 CRISPR,所以它被怀疑是一种新的基因编辑机制,导致很多基因编辑公司的股价应声下跌。
泓君|00:02:40 10 月初,在旧金山的 Tech Week,我的朋友圈是被扎克伯格夫妇的 Biohub 刷屏了。
泓君|00:02:47 他们打算把虚拟细胞计划扩大到 18 亿美元。
泓君|00:02:51 谷歌的 DeepMind、Meta、Isomorphic Labs 还有美国能源部 NIH 一起出钱出数据。
泓君|00:03:12 目标就是让药还没有进实验室就能在电脑里看细胞是怎么反应的。
泓君|00:03:09 可以说他们是在解决 AI 制药的数据问题。
泓君|00:03:15 刚刚我们提到的这里面的很多产品我们可能会在这期节目里面聊到啊。
泓君|00:03:20 那我们这期节目最后讲到 AI 制药的部分也会非常的精彩。
泓君|00:03:24 所以呢这期我们会聊一聊个人 Agent 商业化卡在哪。
泓君|00:03:32 机器人怎么被像 Astra 这样的底层模型冲击的?还有 AI 制药真正的瓶颈是什么?
泓君|00:03:45 我们说虽然离这个模型的更新时间有一段距离,但是在这么多热点之后,我再听到这集节目里面聊到的行业的底层逻辑,反而是最接近本质和不容易果实的那一部分。
泓君|00:03:48 下面就请收听我们今天的节目。
泓君|00:03:58 今天跟我在一起的嘉宾是破壳机器人的创始人、清华交叉信息研究院助理教授许华哲老师。
泓君|00:03:59 哈喽,华哲你好。
许华哲|00:04:01 哈喽哈喽,泓君你好。大家好。
泓君|00:04:07 对,还有一位是我们的老朋友 Pokee.ai 的创始人兼 CEO 朱哲清,朱。Hello, Bill。
泓君|00:04:08 泓君你好,大家好。
泓君|00:04:14 那还有一位是华盛顿大学计算机学院助理教授王晟。
泓君|00:04:21 Hello, 王教授,您好。
泓君|00:04:22 泓君好,大家好,非常高兴今天来参加这个活动。
泓君|00:04:19 Astra 发布已经三周了呀,你们有没有使用过这个产品,或者说我们来看网上的 Demo,大家觉得最让你惊艳的一个 Demo 跟大家的使用方式是什么?华哲。
许华哲|00:04:31 对,因为我是做机器人的嘛,所以我们肯定还是测了很多 Astra 在做机器人任务上面的一些能力。
许华哲|00:04:38 那我们看到的第一个点就是它的适应能力非常强。
许华哲|00:04:42 我比如说给它一个机器人的某一个本体,让它去做相应的事情,那它很快会发现这个机器人的运动速度比较快,或者这个机器人的运动空间是怎样的。
许华哲|00:04:53 比如它撞到桌子了,它会说那这个桌子还蛮高的,那我是不是应该把手抬得更高一点。
许华哲|00:04:58 那这个地方其实是一个把 COT 把这种反思过程的能力变成一个它实际的动作的一个能力。
许华哲|00:05:05 这是过去的很多机器人的模型不具备的大模型也不具备的。
许华哲|00:05:09 所以在 Astra 上面看到的然后另一个就是它自我更新自我升级的这样的一个能力。
许华哲|00:05:14 因为它有这样的反思所以它可以一次一次做同样的事情每一次做得更好。
许华哲|00:05:18 这个其实在网上大家也看到了有人拿 Astra 去操作一个机器人机械臂去画金门大桥。
许华哲|00:05:25 那他第一次画的还是比较差的,但是他画完了以后他会在想怎么样能画得更好,经过几轮的迭代,他就可以画得非常逼真。所以我们也看到了 Astra 在泛画的这件事情上面是有一个非常好的能力。
泓君|00:05:40 你们后来有复现过这个 demo 吗?
许华哲|00:05:42 我画画的这个 demo 我们没有试过但我们其实试了非常非常多其他的。
许华哲|00:05:47 比如说我们曾经做一个插花就把一个花插到花瓶里这也是比较经典的一个机器人任务。
许华哲|00:05:53 但是我们给它加了一些额外难度就是那朵花是那种下边的它的晶已经被劈开两半了。
许华哲|00:05:59 所以它会有点分叉那在分叉的时候你就不好往里去塞那这个时候它会知道。
许华哲|00:06:04 因为它分叉了所以我要捏住这个分叉把它捏窄一点。
泓君|00:06:13 然后再往里塞。
许华哲|00:06:16 那这样的能力其实还是比较惊艳的。
许华哲|00:06:15 哦,那他这个他其实已经理解了一些物理世界包括操作的规范。
许华哲|00:06:21 我觉得本质上还是理解 3D,因为这件事情他还是从三维尺寸层面就可以做出一些理解。
许华哲|00:06:27 但是确实这样的理解已经能够帮助到非常多的非动态的物理世界操作任务了。
泓君|00:06:36 哦,OK,我看网上还有一些很有意思的 demo 是他们在用 Astra 做生成 3D 的视频,非常的快,然后渲染也很好。
许华哲|00:06:45 对,这个是另一个他在机器人上面很令人震惊的一个能力,就是给他几张图片,然后他可以很快把这个仿真生成出来。
许华哲|00:06:50 学术圈可能把它叫做 Real-to-Sim,从真实到仿真的一个迁移。
许华哲|00:06:56 这件事过去是需要拍大量的视频、照片,并且需要很多人的手工标定修改。
许华哲|00:07:04 但现在的话,他基本上你给 Astra 这样的一个指令,他可能很快的时间就把整个实验室或者办公室的这个环境给你浮现出来了。
许华哲|00:07:09 那你拿着这样仿真可以去训你的机器人,那也会有一个在仿真上面的提升。
许华哲|00:07:10 那 Bill?
朱哲清|00:07:22 我们其实因为做模型公司的,因为 Astra 在发布的时候其实有非常强调他们在比如说后训练啊、模型开发等等上面的一些迭代能力。
朱哲清|00:07:31 其实试下来以后并没有那么那么惊艳,但是它确实在长程任务上面和迭代上面比之前的基本模型有一个比较 consistent 的 improvement。
朱哲清|00:07:40 它相对来说比原来的模型会能够对上下文以及之前完成的任务有更稳定的认知,不会出现太多的幻觉的情况。
朱哲清|00:07:50 所以从我们的目前的体验来说还是比较好的,但可能有几个问题吧,一个是它的速度相对来说会慢一些,也有可能跟现在用量很高有关系。
朱哲清|00:07:58 同时的话,它在更加长程,比如说让它跑一个晚上,24 小时的这种情况下,幻觉这个情况还是会发生。
朱哲清|00:08:02 所以它并没有根本上解决,但是从总体上来说还是提升了不少。
朱哲清|00:08:13 我自己有朋友同时也测了一些别的前端以及设计上面的一些任务,从前端的审美跟认知上面,我觉得还是有比较大的提升的。
泓君|00:08:18 这个可能是在训练的时候对于设计和审美方向有特殊的训练有关系。
泓君|00:08:32 Biohub 这轮 Astra 的发布,你觉得从模型对行业的影响来看,它跟当年 Opus 4.6、4.7 的发布跟 Coding 能力的进化来比,它是一个大的节点吧?
朱哲清|00:08:35 单纯 Coding 来说可能没有那么大的一个节点。
朱哲清|00:08:40 4.5 到 4.6 当时我们的体感是一个几乎犯事式的转变。
朱哲清|00:08:47 原来只能依赖它做短程 Coding 几个 File 的改动,做一些简单的小项目。
朱哲清|00:08:53 到 4.6 那一次模型以后,基本上你会感受到工具调用几乎不会出错了。
朱哲清|00:08:57 它去做一些长程的 Coding 任务可以自主进行了。
朱哲清|00:09:00 而现在只是说比原来……
朱哲清|00:09:11 相对比较长的任务之上可以做到更长,幻觉可以降得更低,审美变得更好,但它没有做到说我能够解决一个完全以前完全解决不了的问题。
泓君|00:09:21 王教授您认同吗?您觉得它在生物的长程任务包括它降低幻觉上是一个大的节点还是说它只是众多升级中的一个?
王晟|00:09:35 我觉得是一个大的节点。其实我们没有说客观的有一个 Benchmark 去比较,但是现实就是我们现在已经都从之前的模型 Claude 的系列模型切换到 GPT-6 Astra 来做我们的 BioMedical 内部的任务了。
王晟|00:09:40 我主要是做 AI for Science 里面核心的就是 AI for Biomedical 的应用。
王晟|00:09:47 我们用 Astra 有两个特别好用的地方,一个是 Computer Use,还有一个是一些长程的任务。
王晟|00:09:54 Computer Use 的话我们会用 Astra 来操作一些生物医学里面那些很多年前大家发明的那些软件。
王晟|00:09:59 那些软件其实是一个现在领域内默认都要使用的软件。
王晟|00:10:10 但它们其实都非常难用,因为编写的时候是很多年之前,那个界面的设计也不好,然后那些软件还有很多的术语,所以对一些跨领域的人来说是使用成本非常高的。
王晟|00:10:15 但是 Astra 它的 Computer Use 功能,它可以直接根据一些简单的 Prompt,它就可以操作得比较好。
王晟|00:10:21 还有一个过程就是我通过 Astra 怎么做 Computer Use、鼠标键盘操作,我还可以学习它怎么用这个软件。
王晟|00:10:27 所以这个是我们领域特别重要的,因为在生物医学很多人对 AI 工具的接受度比较低。
王晟|00:10:39 然后我想 Astra 这个能力可能是它不仅有 Computer Use 能力,它还把这些软件对应的在网上的一些 Tutorial、别人之前用过的一些 User Log、一些反馈全部都文字的形式学进去了。
王晟|00:10:41 所以它真的理解怎么用这些软件。
王晟|00:11:05 另一个就是那种长程的任务,我们生物医学的话一般一个任务都是会比较复杂,这些任务有时候会持续 8 小时到 24 小时,然后 Astra 它会做得比较好,当然了它还有个特点就是比起其他的一些模型要做得比较慢,但是慢的话有时候就挺让我放心的,我觉得做得慢它说明它可能会更深思熟虑一点或者说更考虑的深入一点。
王晟|00:11:19 我们现在一般都是一种切换的形式,白天我会用一些其他模型反馈比较快的,到晚上准备让模型跑,一晚上的时候呢,我就用 Astra 来设计一个比较长程的一个 Pipeline 或者 Prompt,让它来一整晚的执行。
王晟|00:11:24 所以这也是它比较值得信赖的一点,在 AI for Science 这个领域里面的一些表现。
泓君|00:11:30 我没有想到 Computer Use 的这个功能居然在 AI for Science 领域能帮助到大家这么多。
泓君|00:11:36 Astra 在 Computer Use 的能力相比于之前,它的核心提升是什么呢?
泓君|00:11:36 这个其实我们没有做一个个人感知上的对比。
王晟|00:11:39 但在公开的 Benchmark 上它是有个分数的提升的。
王晟|00:11:42 提升的比较大但是我们实际我觉得 Astra 他在这次发布的时候。
王晟|00:11:47 做了两个生物医学的 Demo 其中一个就是 Computer Use Demo。
王晟|00:11:51 这个 Demo 在我们圈子内是出圈了大家发现原来可以直接用 Astra 来操作一个生物医学的 Tool。
王晟|00:11:58 他当时操作的一个 Tool 叫 MultiQC 是一个挺常用的网页工具。
王晟|00:12:03 这样呢让大家能够更好的开始使用这个功能,然后发现它其实比想象的要好用很多。
王晟|00:12:09 其实 Computer Use 的功能我觉得之前的模型也会具备,只是大家没有开始真的思考怎么把它融入我们科研中的一些 Pipeline 里面。
泓君|00:12:17 嗯,对。
泓君|00:12:18 Bioh,你可不可以一句话解释一下什么是 Computer Use?。
朱哲清|00:12:21 Computer Use 现在的话基本上是通过模型对于视觉的理解来决定说这个 Agent 下一步要在屏幕上点击哪个部分或者输入哪些文字来完成一系列的任务。
朱哲清|00:12:34 当它可以串联这么几十个动作的时候可以完成一个最终人类想要达到的一个目的。
泓君|00:12:40 就它跟 API 的区别是你不用给接口不用给密码,它直接像人一样去操作跟使用电脑。
朱哲清|00:12:47 对,就是它看到的是人类看到的屏幕,看到人类看到的 UI,看到人类看到的所有的视觉和可以交互的界面,通过人类可以使用的电脑的输入输出装备来完成这些任务。
泓君|00:13:01 因为我觉得 Computer Use 之前好像也有,但是大家之前说我们去操作 Agent 的方式一般就两种,我要么去调用 API 接口,要么去让 Agent 操作一个浏览器。
泓君|00:13:13 我理解后者它其实就是 Computer Use,这一次为什么 Astra 的发布它又重新把这个 Computer Use 带火了,Bill 你怎么看?
朱哲清|00:13:23 我现在对于 Computer Use 这个方向,总体来说感觉它现在又比原来又火了一波。
朱哲清|00:13:29 之前是觉得说大家所有的工具都会开 API,所有的工具都会有 Agent Access 的接口,很多的 App 也好,系统也好都在做 Agent Native 的 Setup。
朱哲清|00:13:40 但是从最近的一段时间来说,不管是 Instinct 也好,还是 Muse 也好,背后其实都解了 Browser。
朱哲清|00:13:47 有一个比较大的问题就是有很多第三方的 App 或 Amazon 也好,比如说一些 Shopping 的 App 也好,Travel 的一些 App 也好,他们其实是不愿意开放 API 的。
朱哲清|00:13:57 我觉得这又回到了当年 Manus 的情况,就是 Manus 开始做了 Browser Use,后面很多别家也跟上,然后后面大家发现说这个不是很 efficient,然后大家都回到 Coding 和 API 调用。
朱哲清|00:14:12 现在好像有些东西避不开,然后又回到了 Browser Use,所以我觉得最后有很还是个 mixture 的状态。
朱哲清|00:14:19 我自己认为有一个比较有意思的看法是,因为我们目前是 focus on 相对比较小的一些模型,比如说我们基本上现在 release 的 model 都是 30B 左右的模型,30B 左右的模型是可以在端测和本地 computer 上面去进行的,比如说我有一台小的 AI box 或者说我有一个 AI PC,它就可以跑这个模型了,未来如果说这个 browser use 本身发生在你的机器上面。
朱哲清|00:14:47 而不是发生在云端,那这个就会改变 Browser Use 本身可能会给你带来的一个 bottleneck。
朱哲清|00:14:54 因为现在的远程的 Browser Use 都是通过商用机器,最多找一个像 Bright Data 或者说 IP Proxy 去遮掉说我是个 Commercial 的一个 User,再去告诉这个商家或者说 Amazon 或者说 Expedia 说,OK,我有可能其实是一个假装的 Consumer 用户,然后我去绕开这个 IP Check,这些网站一般都说如果是商用的 IP 我不会让你进去。
泓君|00:15:19 是因为他们开始屏蔽一些 AI 机器人,商家不希望它接入。
朱哲清|00:15:23 对,其实你看奢侈品网站,其实很早以前所有的都被屏蔽掉。
朱哲清|00:15:29 如果用的你们家的网就是你自己的 IP,那就不会再被 block 了。
朱哲清|00:15:32 所以这个有可能会是未来一个破局的趋势。
朱哲清|00:15:35 而这个事情有可能会 force 很多的 App 厂商去改变他们 Browser User 机制,也就是说这个 Browser Sandbox 可能是在本地发生,而不是在云端发生。
泓君|00:15:47 你这个观察非常有意思,就是你让我想起了最近非常火的一个 2C 的消费级应用就是 Meta Muse。
泓君|00:15:56 他们的定位是做一个个人的 AI 助手,然后又是面向消费者的。
泓君|00:16:01 再加上今天 Agent 的使用能力的成熟和 Meta 它强大的用户技术包括它广告的投放,所以我很能理解他们为什么在这个时间点爆火。
泓君|00:16:11 但他们还有一个非常特别的设计,就是他们其实相当于给每个人做了一台云端的虚拟机。
泓君|00:16:19 就是你的数据是存在一个在云端属于你的存储的。
泓君|00:16:23 根据你刚刚的这个理论,它这个其实还是商用的一个 IP。
泓君|00:16:28 它如果未来商业化的话,很有可能是会被商家卡住它这个 IP 的。
朱哲清|00:16:34 Meta Muse 这个东西从背后的虚拟机设置来说其实跟当时的 Manus 是很像的。
朱哲清|00:16:39 它也主打一个 Browser Use 因为它很多的 Use Case 其实跟 Travel 有关,跟 Shopping 有关,跟一些客服有关。
朱哲清|00:16:46 在这些 Use Case 之下你是没有办法通过 API 调用来完成这个任务的,基本上都得最后靠 Browser。
朱哲清|00:16:53 当时 Manus 其实走了一模一样的路,一模一样被全部 Block 掉了。
朱哲清|00:16:57 所以 Meta 到后期的时候现在跟 Genspark 很像,都主打白领工作的那一套。
朱哲清|00:17:02 如果你去看 Claude Code 跟 Claude Cowork、ChatGPT Work,最后都往白领工作效率这方面去偏移的核心原因就是因为很多东西一开始能做,但后面很快就被巨头们给全部 block 掉。
泓君|00:17:15 比如说亚马逊现在就把 Meta Muse 给屏蔽掉了。
泓君|00:17:19 如果有更多的网站去加入到他们的话,就是他可能能防卫的网页跟能操作的东西就越少。
朱哲清|00:17:25 对,但是他不可能说把你电脑上的 browser 给屏蔽掉。
朱哲清|00:17:29 那你自己也不要上 Amazon 了。
朱哲清|00:17:31 所以这个可能会是一个破局的机会,但是我怀疑这个事情肯定是会来一个比较大的来回拉扯的过程,就是在 2C 端的这个 Agent。
朱哲清|00:17:42 目前可能还是不是特别 ready,因为你看 Instinct 跟 Meta Muse 他们的 token 的 burn rate 其实非常非常高。
朱哲清|00:17:50 因为他们做 Browse Use 的话,模型的需求其实挺高的,模型的要求也挺高的,所以他不可能用比较便宜的模型去做这些事情。
朱哲清|00:17:57 每个人都 Unlimited Tokens, Meta 是一亿 Token for free 嘛。
朱哲清|00:18:01 它很难在短期内真的非常夸张的拉出一个现象级的,就跟过去 Google Search 或者说 Social Network 这样的一个体量,因为它是完全免费。
朱哲清|00:18:13 我们可能未来需要看到一个完全完全免费,Token 根本不是一个限制的这么一个产品才行。
泓君|00:18:18 一亿 Token 是对应多少美元?
朱哲清|00:18:21 如果全部按照 Input 来算,按照他们成本来算应该是 100 美元左右吧,我估计。
泓君|00:18:26 每个用户 100 美元的免费额度。
朱哲清|00:18:28 每个星期?
泓君|00:18:29 那挺多的。
朱哲清|00:18:30 对,纯少钱嘛。
泓君|00:18:33 我还听到一种说法说,Meta Muse 它里面比较耗钱的不仅仅是这个 Token 的成本,还有它云端虚拟机的成本,因为现在内存跟 CPU 都很贵。
朱哲清|00:18:44 如果你去看我们 RL 训练的过程当中,我们 CPU 跟 GPU 的价格,其实 CPU 我们一开始都用那种虚拟的那些 Service 去做虚拟 Sandbox,然后发现实在是太贵了,然后最后就直接租个大的 CPU Box 然后自己去架 Sandbox。
朱哲清|00:19:01 因为它这套东西其实没有什么太大的门槛,只是 Compute 很关键,资源很关键。
朱哲清|00:19:07 所以我们最后还是决定说自己架这个 Sandbox,不去别人那儿租了。
朱哲清|00:19:11 我们有一次做大型 rollout 的时候,发现 CPU 的价格跟 GPU 的价格一样了,甚至就很离谱。
泓君|00:19:19 你刚刚提到了 Meta Muse 跟 Manus 比,它现在走的路可能是 Manus 最开始,因为最开始 Manus 它也想自己去操作浏览器,最后回到了白领工作。
泓君|00:19:29 那你会看好像 Meta Muse 长远的一个发展吗?还是觉得它的这个现象级只是在一个非常短的时间?
朱哲清|00:19:37 我觉得这波 Consumer 最后一定会 land 到软硬件结合的状态。
朱哲清|00:19:43 我觉得 Meta 如果能够把 Wearable 做得很大,有可能有机会。
朱哲清|00:19:47 就是为什么我觉得最后要有 LAN 到软硬件结合的原因是因为云端这件事情不能代表这个用户本身。
朱哲清|00:19:55 这也是为什么 browser 把他们给完全 block 掉的原因。
朱哲清|00:19:57 因为一旦换了一个云端的虚拟机,它不能够验证说这个人本身就是用户本身。
朱哲清|00:20:05 我觉得用户的 ID 或者使用 Agent 的那个用户的 identity 本身会是这一波 2C 的一个关键。
朱哲清|00:20:11 如果说商家能够去确认这个 Agent 就代表这一个人去做的这么一个操作。
朱哲清|00:20:17 有可能很多商家会愿意做这件事情。
朱哲清|00:20:20 但是现在如果用云端的虚拟机云端的 Browser。
朱哲清|00:20:23 它很有可能是〔转写异常〕 去验证这件事情。
朱哲清|00:20:26 他会觉得说我的流量入口被人剥夺了。
朱哲清|00:20:29 如果说它是一对一比例的话,比如说我有一个用户,他本来就要访问我。
朱哲清|00:20:34 他通过 Agent 还是访问我。
朱哲清|00:20:35 其实对于我来说可能是 OK 的但如果说原本我是一个用户对阵我。
朱哲清|00:20:41 然后他现在搞了 20 个 Agent 这 20 个 Agent 本身的消费能力跟原来可能一个 Agent 是一样的。
朱哲清|00:20:47 然后这 20 个 Agent 还不停地比价不停地去在我这边刷流量。
朱哲清|00:20:50 把我这边的所有的流量全都弄乱了那对我来说是得不偿失的。
朱哲清|00:20:55 所以我觉得软硬件结合可能会是一个机会如果说硬件本身属于这个用户。
朱哲清|00:21:00 他就可以直接确认说,这个 Agent 就是这个用户,是一个代表行为,那我就会愿意把这个 Access 开给你。
泓君|00:21:07 我觉得你这个洞察真的非常厉害。
泓君|00:21:10 我其实前几天跟朋友吃饭,我们也提到了这个观察,因为你云端的那个 IP 是非常容易被商家 block 住的。
泓君|00:21:19 能不能个人访问的 IP 是在本地,在他自己的硬件里,比如说手机,比如说 Mac mini。
泓君|00:21:26 但是其实这个对他们来说也是一个很大的问题,就是你怎么样去绕过苹果,你如何确保他们个人的这个终端设备是安全的,他们怎么干。
朱哲清|00:21:36 对,我觉得现在这个生态本身是很复杂的,比如说我们跟高通英特尔、AMD、联想、惠普等等都有合作。
朱哲清|00:21:45 像我们做硬件、软件结合加模型结合的这一套东西呢,其实也要去找落地方向,以及说哪些场景最容易落地。
朱哲清|00:21:55 而他们做 2C 或者 2B 的场景就会卡在 Access 这件事情上面,以及卡在 Identity 和硬件这个层面上面。
朱哲清|00:22:03 所以双方可能未来从商业行为或者说从生态上面有一个合作的潜在机会在里面。
朱哲清|00:22:11 但是我觉得最后肯定是一个模型、软件和硬件三方都得要合作共饮的一个状态才能够打破这个局面。
泓君|00:22:21 比如 Meta Muse 它后台接的是什么模型你知道吗?
朱哲清|00:22:24 这个东西有 rumor 肯定官方会说用的是 MuseSpark 但 X 上有人扒出来说他们有一些调用 OpenAI 的场景。
朱哲清|00:22:32 我怀疑会有些 routing 存在 如果 MuseSpark 不够 strong 它可能会比如说靠一些 Astra 或者靠一些 Fable 去解决问题。
朱哲清|00:22:42 但我怀疑不太会,因为成本太高了。
朱哲清|00:22:46 如果说我十次 iteration 里面有一次我要去 call Astra 或者 call Fable 才能解决问题。
朱哲清|00:22:51 那它就不是一百刀的成本,它有可能每个用户每个月是两百刀的成本。
朱哲清|00:22:56 这个获客成本有点离谱了。
泓君|00:22:58 OK,所以现在 Astra 跟 Fable 差不多是其他模型价格的两到三倍?
朱哲清|00:23:04 不止,不止,远不止。
泓君|00:23:06 不止。
朱哲清|00:23:06 Astra 现在是 10 美金的 input 吧,我没记错的话。
朱哲清|00:23:10 也就是说你是比 GPT-6 Sol 高五倍的价格。
泓君|00:23:13 Astra 它的定价是每百万 token 10 美元,输出是 50 美元。
朱哲清|00:23:18 对了,差不多 4-5 倍的价格,所以就很离谱了。
朱哲清|00:23:22 如果我要用这样一个模型去解决一个难的任务,这一次就要调用 3-40 美金。
朱哲清|00:23:28 我给你举个例子好了,我之前用 Claude 的 subscription,然后我把 20x 的那个 plan 给用完了。
朱哲清|00:23:34 那次我很急,我必须要把那个任务解决掉,然后我就花了 100 美金加一些 credits。
朱哲清|00:23:41 我仅仅用了两三三次 back and forth 的 agent flow 就全部用完了,100 美金。
朱哲清|00:23:48 你就很难想象如果我做 Muse,然后我去把其中 10%的 Traffic 引到 Astra 上面,是个什么灾难性的一个 Cost。
朱哲清|00:23:57 当然 Meta 可能财大气粗暴没关系,但是它进行对手 Instinct,现在我估计它必须得用至少是 Sol 级别的模型。
朱哲清|00:24:07 它估计会用很多开源模型去打个底座,然后中间再去做一些 Routing 之类的,但它们每个用户的获客成本肯定是非常可观的。
朱哲清|00:24:16 就不只是他们广告上面 marketing 上的获客,在那之后他还是会有大量的获客成本在里面。
朱哲清|00:24:22 所以我觉得这个事烧钱会烧得很夸张。
朱哲清|00:24:27 这是我们的愿景,如果说电脑上自己就可以跑所有的东西,那就没有必要再去跑到云端上。
朱哲清|00:24:33 至少 60%到 70%的 Token 是本地产生的,或者说我自己私有 Computer 产生的,那他就不需要再去花那么多的钱,全都 Route 到 Frontier Model 上面去了。
朱哲清|00:24:43 希望未来这个地方有个 convergence,就看他们能够足以烧多久,比如他们足够的钱可以烧个一两年,那我们这个行业的模型也逐渐成熟了,那最后可以有一个平衡的一个状态出现。
泓君|00:24:57 大家在 2B 的工作流中会用 xAI 的 Grok Bot 吗?
朱哲清|00:25:02 我自己身边用 Grok Bot 的人更多是在尝鲜。
朱哲清|00:25:07 因为它相对比较主动一点,但是你用 Codex 或者用 Claude Code 其实都可以解决这个问题,就真的把它接近工作流的可能相对少一些。
朱哲清|00:25:17 我自己身边好多真正在一线比如说 Legal、Healthcare,真正就是在那些传统 Enterprise 里面在工作的人,现在还纠结于怎么能够脱离 Microsoft Copilot 的泥潭,甚至都不能 freely 使用 Codex 和 Claude Cowork,就更别说要到 Grok Bot 这个级别了。
朱哲清|00:25:36 所以我觉得整个行业现在分叉非常大,走在前面的人什么都可以随便用,走在后面的人现在还在泥潭里挣扎。
泓君|00:25:44 哦,这个很有意思。
泓君|00:25:45 因为 Astra 它里面它也可以调用很多自己的 Agent。
泓君|00:25:49 我们之前看 OpenAI 解数学题,它内部调用了一个更强的模型,大概用了一万个子 Agent。
泓君|00:25:57 我其实最近跟比较前沿的模型的研究员聊啊,我听到一个很有意思的观点,他们认为现在在 2C 跟消费级的 Agent 上,Token 的使用量其实是花不了多少钱的,一个是推理成本在下降,然后是其实这个 Token 的成本比大家想象中要便宜。
泓君|00:26:16 但是现在真正最烧钱的地方包括前沿模型研究员以及 OpenAI、Anthropic、DeepMind 这几家公司在看跟在竞争的核心领域是 AI for Science。
泓君|00:26:26 就是那些未被解决、未被定义的科学问题他们要去解那些数学题或者需要跑像王教授这样的一些生物实验。
泓君|00:26:36 这个是非常非常少 Token 而且是内部消耗量最大的一个方向。
泓君|00:26:41 那比如说我刚刚提到的 OpenAI 去解数学问题,那纳维-斯托克斯方程这一个问题,那 OpenAI 它的 Agent 它就是发了大概有 270 万条信息,消耗了约 1300 亿输出的 Token。
泓君|00:26:58 那第三方按照零售价给它算了一下,就这部分它会消耗多少钱,大概是在 2200 万美元。
泓君|00:27:06 因为现在整个模型的进化,就像 Bill 你刚刚说的,它的使用都分好几个梯队,但是对普通人来说,就比如说我们今天聊 Astra 的发布,普通人可能很难感受到我在 Astra 的使用上跟上一代的模型,甚至我们说跟 Claude 的其他模型有什么非常明显的区别,我觉得这个对普通人的感知来说已经不大了,但是它对前沿的科学家来说。
泓君|00:27:30 他的能力的提升,他的感知是非常大的。
泓君|00:27:32 所以前沿 Lab 在看的这些方向跟我们想象中的方向,它还是不太一样的。
泓君|00:27:38 就是他们觉得做一个非常大的科学突破,或者说如果真的 AI 它能制药了,它能解决很多的疾病,那个利润是更可观的。
朱哲清|00:27:48 我其实这个地方有点想问许教授跟王教授。
朱哲清|00:27:51 我自己因为是主要只做 Post-training 然后同时做一些 Model 的 architecture change。
朱哲清|00:27:56 在 focus on 小模型多一些,因为我们想做很低成本化的模型。
朱哲清|00:28:01 那我们能看到的就是我们这个层次的模型在我们优化之后和 Frontier Model 的差距越来越小。
朱哲清|00:28:07 当然我们没有钱去训练一个 trillion parameter model,但是我们看到这个智能差距是在变小,至少在白领工作和我们自己的工作流动当中。
朱哲清|00:28:17 那从一个 AI for Science 角度或者说从 Robotics 角度。
朱哲清|00:28:22 这个模型在每一代的迭代当中你们觉得会有多大的提升?
朱哲清|00:28:26 比如说我们从 Opus 4.5 到 4.6 的区别。
朱哲清|00:28:29 versus 从我们现在最前,比如说当时应该还没有 Opus 5。
朱哲清|00:28:34 应该是 4.8 到 Fable 之间的区别,或者说 5.6 到 Astra 之间的区别。
朱哲清|00:28:39 这个差距能可比吗?
王晟|00:28:41 我的观点是它的 AI for Science 能力确实是有一个很大的提升在 Biomedical Domain。
王晟|00:28:47 但是这个提升主要来自于它的 Coding 啊,这种 General 的 Coding 查文献,然后做长程任务的能力,并不是它对这种 Biomedical Knowledge 能力的提升。
王晟|00:28:57 它有一些 Benchmark 是专门测 Biomedical Knowledge 的,Astra 上并没有提升,就这种知识层面的。
王晟|00:29:04 我们现在实际用的时候其实很难去使用 Astra 或者去使用 Opus 或 Fable。
王晟|00:29:09 因为它对生物医学的任务都会防范得越来越严吧它都会 refuse to answer。
王晟|00:29:14 这是非常严重的问题所以我们其实内部用的时候都是用 Kimi K3 或者 MuseSpark 1.3。
王晟|00:29:20 当如果要用 Astra 的时候都要用一些比较特殊的方式来跟 Astra 说。
王晟|00:29:24 我这不是在做一个危险的任务我这是在设计一个 Benchmark 等等。
王晟|00:29:39 所以实际这种大模型的使用体验,随着能力的增强吧,其实是越来越差的。
王晟|00:29:44 还有一个点就是刚才比我说的很有道理,其实我也认可,就在各种已经定义的很明确的 AI for Science Benchmark 上,小模型确实是可以和大模型的差距越来越小。
王晟|00:29:53 但是我个人觉得这些 Benchmark 本身就不是定义的那么好,所以大家追赶的方向,包括大模型进步的方向都可能不是完全正确的。
王晟|00:29:57 这些 Benchmark 定义的时候,大家都会定义一个更好让 AI 模型去做的。
王晟|00:30:01 比如说有一个明确的生物数据集,要预测一个明确的问题。
王晟|00:30:05 这和我们真的做的制药发现其实是 gap 非常大的。
王晟|00:30:10 本质上这些现在的生物医学 Benchmark 就是一个 Kaggle 这种 Data Science 的比赛。
王晟|00:30:15 所以它就退化成一个 MLE Bench 这种 Machine Learning 的问题。
许华哲|00:30:19 这种 Astra 在 coding 能力上提升就会有很大的进步。
许华哲|00:30:22 我觉得从 Robotics 角度,Astra 是一个飞跃式的。
许华哲|00:30:33 在过去刚刚提到的几个,无论是 Opus 4.5、4.6,然后还是到 Fable 的变化,都没有 Astra 这次给 Robotics 带来的变化大。
许华哲|00:30:40 因为过去的所有升级,在 Robotics 的测试上面几乎都没有什么太好的表现。
许华哲|00:30:47 原来不能做,现在仍然是不能做,相当于定性上面没有变化,但 Astra 现在带来的变化是它整个定性是有变化的。
许华哲|00:30:58 很多的 Robotics 的 Benchmark 失效了,像 RoboDojo 几个大家相对认可的 Robotics,尤其是仿真的 Benchmark,Astra 都成了第一名。
许华哲|00:31:04 无论是它用了哪种数据,但是它带来的这个能力都是彻底的把原来的这个模型进行一个飞跃式升级。
许华哲|00:31:14 关于刚刚说小模型和大模型这个问题,我倒是觉得长期来说我们一定是需要一个小的跟 Astra 能力相当的模型。
许华哲|00:31:25 原因是机器人的任务它有时间要求,它是需要及时响应,需要有高动态任务,比如说我要抖一个毛巾,这样的能力 Astra 是做不了的,因为它太慢了,对吧?
许华哲|00:31:31 它知道我要快动一下,但是它只能写 code 来做,如果让它直出动作是没有办法去做的。
泓君|00:31:39 在这种情况下,我们一定需要一个快决策的模型,只不过我们需要把现有的 Astra 的 COT 或者是它的 Reasoning 的能力以及 3D 理解要把它加进去。
泓君|00:31:48 所以你觉得未来机器人它的方向会变成比如说大模型去做规划,然后小模型它负责实时控制这样的分层架构吗?
许华哲|00:31:57 这个分层架构大家其实一直都还是比较认同的,只不过这个层的这一刀到底切在哪,怎么样的分层方式是大家一直有辩论的。
许华哲|00:32:13 就比如说原来大家普遍认为 VLA 是做任务规划层,那这个任务规划层大概就是到我跟你说我要吃西红柿炒蛋,那 VLA 规划的可能就是打开冰箱门,拿出什么西红柿,拿出鸡蛋等等,然后底下的小模型或者说巨深的模型。
许华哲|00:32:17 他会去执行打开冰箱门究竟怎么办,打鸡蛋怎么做。
许华哲|00:32:30 但是 Astra 这次他最大的一个变化是他现在能做低层次的动作控制,就相当于他可以给你的指令变成了把手往右伸两厘米,或者把手放在冰箱门的把手上。
许华哲|00:32:34 如果没有抓住的话,他说那你再往前靠一靠,所以他相当于把这个层往下压了。
许华哲|00:32:38 原来是大家边界很清晰的,你负责那块,我负责地毯。
许华哲|00:32:40 但是他现在说我现在能力非常强除了慢以外呢我可以往下压一点点。
许华哲|00:32:46 那底下的这个就更像是一个反射式的对吧我能听懂说往左往右。
许华哲|00:32:50 有点像是一个提线默偶的感觉肯定就是有一些声音就是说。
许华哲|00:32:54 那是不是未来上层的这个模型可以无限往下压那压到最后是不是就变成一个完全端到端的 VLA。
许华哲|00:33:00 就像 Astra 直接控制所有事情我个人的观点是我觉得这个还是不是很合理。
许华哲|00:33:06 现在看起来第一很明显是速度嘛就基本上你在网上看到的 Astra 做控制的。
许华哲|00:33:11 都是要 16 倍速或 24 倍速才能看否则的话就基本上就是在那纯等待。
许华哲|00:33:15 第二个呢就是我觉得现在的 Astra 还是对物理是非常缺乏理解的,尤其是对于人类来说叫直觉,或者叫直觉物理学。
许华哲|00:33:31 我随手可能碰一个物体,它如果有水可能会洒,如果是玻璃可能会碎,这些事情可能 Astra 如果经过很多语言推理是可以理解。
许华哲|00:33:37 但是如果我们希望它去做一个任务当中立刻有这方面理解,它可能效果还不够好。
泓君|00:33:43 这个地方可能还是需要像世界模型或者像快速的模型要去做一些直觉式的反应。
泓君|00:33:50 你刚刚提到了它速度慢,它速度慢是因为什么?是因为它的模型太大了吗?它的推理时间太长了?
许华哲|00:33:54 模型大肯定是有这样的一个原因,然后另一个就是它 COT 很长。
许华哲|00:33:58 虽然它是加密的 COT,给出来的那个 COT 应该是假的,我理解。
许华哲|00:34:04 但是它的内部的 COT 是非常长的,所以它做每一步的决策,做的思考是非常冗余的。
许华哲|00:34:13 尤其是面对简单任务的时候,就是我们观察到面对复杂任务和简单任务,它的思考时长基本上是相似的。
许华哲|00:34:11 这也意味着复杂任务他很聪明对吧但是到了简单任务上他就变成了一个额外开销。
许华哲|00:34:17 使得他看起来非常笨。
泓君|00:34:18 内耗性人格。
朱哲清|00:34:20 是的许教授我想这边也有一个问题想问就是机器人这个模型的大小。
朱哲清|00:34:26 现在基于目前可以在机器人上面搭载的芯片他应该能够做到什么样的模型大小。
朱哲清|00:34:33 是一个比较 ideal 的一个状态以及说如果说这个模型 host 在云端。
朱哲清|00:34:39 它像一个 Jev 一样立刻给你输出所有的 Configuration,在这种情况下什么样的网络延迟是可以被接受的?
许华哲|00:34:46 如果是搭载在本地,这个模型可能最好是在一个较于 10B 这样的一个尺寸,是比较舒适的。
许华哲|00:34:54 当然十几 B 或者是小几十 B 其实也是能做的,但是这个硬件成本可能会要上去,用的芯片可能要升级。
许华哲|00:35:03 如果搭载在云端的话,我们自己在破壳机器人也是两条路都在走,我们自己也会有模型搭载在云端以 API 的形式供大家去用。
许华哲|00:35:13 这样的一个方式的话,我觉得这个模型尺寸其实就没有什么太多的限制了,更多的是网络延迟和你的卡到底是哪一代的卡。
许华哲|00:35:21 网络延迟的话,因为要看任务,就你 API 的形式一定不能做高动态和时间敏感的任务,比如倒水这种就不适合做。
许华哲|00:35:30 如果你卡了一下,水可能就冒出来了。
许华哲|00:35:32 所以我们先假设都做的是准静态的任务,那在这种情况下,我觉得 200 毫秒,甚至更长一点,几百毫秒,我觉得都是可以接受的。
许华哲|00:35:40 但是如果你说做高动态任务的话,我觉得一定是要在本地,没有办法在云端,因为卡一下就完全坏掉了。
泓君|00:35:52 对,有道理。
泓君|00:35:58 嗯,对。许教授,因为我知道之前你们公司的有一个 demo 的场景就是用筷子夹小球。现在比如说你们用自己的模型做跟用 Astra 做,它的区别是什么?
许华哲|00:36:02 用我们自己的模型去做的话,实际上做得快很多。
许华哲|00:36:06 其次呢,它在抓的时候呢,是连续不断地去做尝试的。
许华哲|00:36:09 这个过程中没有太多的逻辑上的思考。
许华哲|00:36:16 我抓了一次失败了,可能我稍微碰到一点它,那我的状态发生了一些变化,那我可以换一个角度去做尝试。
许华哲|00:36:22 但是如果是 Astra 的话,它每做一步以后,它都要分析发生了这个的原因是什么。
许华哲|00:36:29 根据这个原因,他要去给自己指令,相应的我要做什么样的调整。
许华哲|00:36:26 这个过程看起来更像是人类的思考过程但是这个地方也会一个是带来它很缓慢。
许华哲|00:36:32 然后第二个会发现它有时候会陷入到一些僵局里面它有时候无法理解为什么会发生这样的事情。
许华哲|00:36:39 或者是它一旦分析出错了它就没有办法再进一步去推进了。
许华哲|00:36:43 然后还有一个我们看到的点就是如果我们去抓一个桌面上的物体。
许华哲|00:36:47 旋转这件事情,Astra 其实做的相对来说还是弱一些,但是它能做。
许华哲|00:36:52 在旋转的这件事情上面,我们看到的是它要反复地尝试怎么样去转才能去把它,比如抓起东西以后,我再塞到一个墙上的小孔里。
许华哲|00:37:01 这样的能力我觉得目前还是有一定的短板的。
泓君|00:37:06 那你觉得像 Astra 它出来以后,因为我知道现在机器人公司分很多种,就比如说做大脑的,包括这个大脑怎么做,它是 Sim-to-Real 的路径,还是说它用整个物理世界的数据,就它都有分很多的流派,然后还有做本体的,还有做数据的,你觉得它对哪一类的公司的冲击影响会比较大?
许华哲|00:37:25 Sim-to-Real 的路线我一直是认为仿真是没有办法迅出最好的机器人的模型和策略的。
许华哲|00:37:32 就很多人说 Astra 让仿真重新复活了,因为它做 Real to Sim,就是说把真实世界迁移到仿真里面这件事变得非常容易,但是它其实只是把它这个 3D 的外观做得非常好。
许华哲|00:37:43 但是它并没有因为 Astra 出现,然后物理引擎变得更准确了。
许华哲|00:37:47 因此我觉得它在这个地方我觉得是一个 hype 或者是一个虽然它带来了很多变化,但这个变化并不直接导致机器人会变得更好用。
许华哲|00:37:55 第二个呢,就是我觉得 Astra 肯定是利好本体的,利好硬件的。
许华哲|00:38:00 就 Astra 出来这两三周吧。
许华哲|00:38:01 斯坦福已经有一个课题组去把 Astra 接入一个宇树机器人里面,让他在家里面去做一些家庭任务了。
许华哲|00:38:09 这件事情还是非常非常快的,现在他做了一个论文,可能大概就两周时间就做出来了。
许华哲|00:38:14 可以看到在 Astra 有了很强的跨本体泛化能力以后,你的本体如果质量足够好,那可能连接 Astra 直接可以做一部分事情了,尽管他还只能是 Demo 级。
许华哲|00:38:23 对于做大脑的公司,我觉得是有两派。
许华哲|00:38:26 一派是相信会有一个更快的、更好的、具身自己的模型。
许华哲|00:38:31 当然可能可以从 Astra 身上去学到一些比如数据标注的方式、COT 的方式等等。
许华哲|00:38:37 我觉得是会带来一些整个行业的增长的,我觉得是一个好事。
许华哲|00:38:40 当然还有一派就是说,他的去模型能力可能不够强,那可能直接放弃掉这件事了。
许华哲|00:38:45 既然 Astra 好,那我就专注在怎么用它,或者是怎么样把我的东西当作它的一个工具嘛,然后让 Astra 来调用我的这些小的东西来完成任务的闭环,那可能更像是一个机器人部署的公司了,所以我觉得会有一部分公司逐渐走向更偏部署的机器人,有一部分公司会做更小的 Astra 这样的能力,或者超过 Astra 能力的模型训练。
泓君|00:39:08 你觉得它对整个机器人未来它如何去做研究,包括刚刚您提到的分层分到哪个位置,它会有一些新的启发或者带来比较大的变化吗?
许华哲|00:39:19 我觉得会带来非常大的变化。
许华哲|00:39:20 第一个是整个模型训练的范式,我觉得大家未来都不会忽略 Astra 这样的一个范式,所以去模型的人肯定会产生一些新的想法。
许华哲|00:39:29 另一个就是以前做传统机器人规划的人,他们现在可能会往 Agentic 更偏 Harness 这样的方向去做机器人的研究,如何把各种各样的能力组合起来。
许华哲|00:39:40 机器人领域有一个领域叫 TAMP,它会把规划和控制放在一起,然后去做长程任务。
许华哲|00:39:47 过去这个领域我觉得是比较古板的,或者说比较上一个代际的这样的一个能力,因为它很多时候都用传统的规划手段然后去做一步一步的。
许华哲|00:39:57 如果我的下一个任务是拧开瓶盖,那我的上一步要确认这个瓶盖首先是关着的,否则的话我不能到下一步。
许华哲|00:40:03 这些事情其实在过去我觉得是相对有一点过时的,但是到了 Agent 部分它好像又重新焕发生机了。
许华哲|00:40:10 可能是规划去模型,然后现在有了好的模型以后,那又回到规划可能是变得很重要了。
许华哲|00:40:16 所以我觉得对整个研究肯定也会带来一些变化的。
泓君|00:40:19 您刚刚提到了就比如说一些特别好的机器人大脑的公司,他们可以向 Astra 学习数据标注的方式,您觉得您从中间获得的启发是什么?
许华哲|00:40:29 我觉得就是要把里面的因果和直觉物理标注清楚。
许华哲|00:40:33 我做这件事情成功是为什么,失败是为什么,我做了这件事情发生了这个结果,这里面的交互过程需要详细地标注出来。
许华哲|00:40:42 我觉得这个部分是很重要的。
许华哲|00:40:44 过去的机器人很多标注的时候是只标注一句话描述你做了什么,就相当于只做正向标注。
许华哲|00:40:49 没有吧,背后的我没抓住它,原因是我到底是抓的位置偏上了,还是说这个东西沾了水太滑了等等,这些东西要去标注出来,有了这些东西我们才能真正做一个通用的机器人大脑。
泓君|00:41:03 那这是不是说它对整个数据标注公司也会有影响,因为我知道现在还蛮多人做机器人数据标注的。
许华哲|00:41:10 我听说的 rumor 是 OpenAI 现在只卖不标注的数据。
许华哲|00:41:14 就他觉得外面的标注都是错的他们都是自己内部重新在标注。
许华哲|00:41:19 另一方面他们可能也是为了保密就是说我不想把我标注方式透露出去。
许华哲|00:41:23 所以一定程度上对数据公司来说会有两种一种是我卖生数据生肉这种感觉。
许华哲|00:41:30 相当于在卖石油是原材料主要还是要靠起量来做我需要的是管理一千个人或一万个人在那采数据。
许华哲|00:41:38 或者把所有的家都 Map 一遍还有一部分就是做熟肉、熟数据,那他就需要去了解到最前沿的模型是如何去训练的。
许华哲|00:41:49 如果他有一些这方面的知识,他就可以很自信地说,OK,这个是 OpenAI 的标注方式,这个是 Pi 的标注方式,你喜欢哪个,然后我去卖给你。
许华哲|00:41:58 那他这个单价可以翻十倍,甚至更高的价格。
泓君|00:42:01 这个水还挺深的。
许华哲|00:42:03 是的,是的。
泓君|00:42:03 而且要知道这些模型公司研究品位本来就不容易。
许华哲|00:42:07 对,他们需要在交易的过程中获得局部观察来推理对方,也是一个 COT,推理对方到底在怎么样使用这个数据。
泓君|00:42:15 对,那您觉得它对整个未来机器人研究方式会带来变化吗?因为大家之前是在研究机器人方向的垂直模型嘛,那现在说大模型的能力足够好了,它也可以驱动机器人,虽然它有 ABC 的问题,那会不会以后说机器人的训练可能它的底层就还是一个基模,它只用做后训练就可以了?
许华哲|00:42:37 如果我们想要真正意义上部署的话,一个 GT 的模型肯定是很难去做部署的。
许华哲|00:42:43 如果是远程的话,我觉得是可以解决一部分任务的,但是不能解决所有任务。
许华哲|00:42:48 如果我们都是 Astra 这种基础模型,我觉得是不太能成为未来所有机器人去使用的模型。
许华哲|00:42:54 一定是会有一个相比于 Astra 要小得多的这样的一个模型,有相似的能力这样的一个范式。
许华哲|00:43:12 即使它在云端去做服务、去做 host,我觉得仍然是一个机器人专用的模型。
泓君|00:43:25 您觉得从 Astra 发布完到今天已经大概有三四周的时间,您对它的理解,包括最开始我知道它有机器人画金门大桥的那个 demo 的时候,很多机器人的创始人是很慌的,包括后来大家也会自己去试嘛,整个过程您心理上会有一些变化吗?
许华哲|00:43:31 会的会的。首先它出来的时候大家刚开始尝试基本上都是觉得非常的惊艳。
许华哲|00:43:40 最开始尝试当然是让它抓一个东西然后它很快完成了。后面就是会尝试更复杂的比如说刚刚提到的有一些空间上面的要求比如要旋转啊。
许华哲|00:43:49 在后面有一些更复杂的语义甚至到一些物理上面的东西去逐步尝试它的时候我们会觉得机器人的 GPT 时刻还是 GPT。
许华哲|00:43:52 但是再往深入去看的话,还是看到很多问题。
许华哲|00:43:56 比如说它现在仍然像双臂的任务是几乎没有办法去做的。
许华哲|00:44:00 比如说在叠衣服这件事情上,Astra 是完全叠不了的。
许华哲|00:44:06 所以我们有一个感受就是,在一个语言不太好描述的任务上面,Astra 的能力其实并没有很强。
许华哲|00:44:10 所以我们还是看到它在足够灵巧的地方仍然有空间。
许华哲|00:44:13 第二个就是,我们发现它的总结能力还不是很好。
许华哲|00:44:17 比如说第一次做一件事会花一个,比如说一个小时。
许华哲|00:44:19 第二次做这件事可能花 45 分钟。
许华哲|00:44:23 然后我们让它持续不断地去做,它永远都是 45 分钟。
许华哲|00:44:25 它基本上到第三次开始变成一个常数。
许华哲|00:44:31 不会说像人或者是一些更小的模型,它在充分地训练以后,它的时间会越来越短。
许华哲|00:44:34 最后我们可能随手干一件事,就是几秒钟就做完了。
许华哲|00:44:38 所以在这个地方还是可以看到机器人本身的原生模型。
许华哲|00:44:39 还是有很多空间的。
许华哲|00:44:48 再到现在我觉得更多的是我们要想到底我们叫系统一、系统二嘛,就是快慢系统,他们之间到底应该是怎么样结合。
许华哲|00:44:55 上面的 Astra 到底是调用还是说给出一些指令,还是给出什么样的指令作为界面。
许华哲|00:45:12 因为它已经出现了,你不能回避它,但是它自己又有很多问题,你又没有办法直接用它,所以下一个问题是怎么样把机器人公司擅长的东西和 Astra 这样的模型充分地结合起来,然后能做出真正通用的机器人,我觉得到现在还是更多从技术角度去想未来怎么做。
泓君|00:45:23 对,最近还有一个项目也很火,叫 Jev,他可能就是很多的是用系统一、系统二、快思考、慢思考的一套理论去做的,你觉得这个对机器人领域的影响大吗?
许华哲|00:45:26 我觉得 Jev 他自己叫做自己系统一嘛我觉得跟机器人本身的原生模型是很像的。
许华哲|00:45:33 机器人大家一般来说会认为他是一个主要是系统一有一小部分系统二的能力在里面。
许华哲|00:45:38 所以我觉得机器人就应该是一个相对来说的快系统但是 Jev 其实我们也做了尝试,就首先 Jev 在机器人上表现是很差的。
许华哲|00:45:44 为什么?
许华哲|00:46:01 多方面原因,首先当然 OpenAI 好像最近也要发新的东西了,但是 Jev 本身没有办法输入图像,所以你的图像需要以状态的形式给到它,你必须要跑一个视觉的 VLA 也好,或者是跑一个其他的视觉模型,然后把这些状态给到它,然后再让它去做快速决策。
许华哲|00:46:08 我们测试下来,比如说摞方块这种任务,它经常会就摞不起来,或者是就摞了以后就倒了。
许华哲|00:46:07 比如说 Astra 它可以看到说第一个块摞得有点歪,第二块就要反过来一点,往另一边靠一靠,这样子才能平衡。
许华哲|00:46:16 但 Jev 就没有这样的一个能力。
许华哲|00:46:18 但是它可能,现在我看到很多人就说 Jev 可能可以用来标数据,因为它很快嘛。
许华哲|00:46:23 但是我刚刚好像看到 OpenAI 要出一个快的,就类似于 Jev 的东西,而且是有图像多媒体输入的一个快系统。
许华哲|00:46:31 但是好像还没有尝试,应该是快要发布了。
泓君|00:46:34 嗯嗯,对,我们可以期待一下。
泓君|00:46:37 那你整体觉得 Astra 的发布对机器人行业,你觉得它是一个正向的影响,还是一个冲击到大家的影响?
许华哲|00:46:44 它对整个机器人领域的影响肯定是正向的,看到新的能力嘛,但是肯定也有一些冲击,从每个个体来说,尤其是比如说现在的模型能力远远低于 Astra 的这些公司可能会有一些担心,我永远都追不上它这个能力嘛,我整体还是偏乐观的,它相当于是一个新的思路其实照亮了很多我们之前没有看到的地方,所以我个人是觉得它是偏正向的。
泓君|00:47:10 嗯,了解。那接下来来聊一聊我自己非常感兴趣的就是 AI for Science 的环节。那现在你觉得 Astra 还有 Fable 5 这几个模型在 AI for Science 上的能力谁更强呢?
王晟|00:47:23 我觉得 Astra 的能力会更强,因为它做的那种长程任务的能力要稍微强一点。
王晟|00:47:28 对我们的应用来说,首先我们没有一个明确的 Benchmark,很难用现有的这些生物医学的 Benchmark 来衡量一个模型它做生物医学任务的好坏。
王晟|00:47:37 现在模型很缺乏做的一个事情就是它可能做编程或者做一些任务都做挺好,但是我们想要模型是能够指导我们去真实世界中做生物医学实验。
王晟|00:47:50 就如果我有个 Benchmark 叫他预测一个东西,他可以做得很好,预测一个蛋白质的活性。
王晟|00:47:55 但是我们现在最重要的一个场景是 AI 模型能不能出一个实验方案,具体的我要怎么样做实验,在什么温度下,用什么分子,然后在怎么一个湿度,怎么一个情况下做这个实验。
王晟|00:48:08 这是一个现在的模型都做不好,但是非常重要的点。
王晟|00:48:11 我之前说叫 Computer Use,就是 AI 怎么控制 Computer 对吧?
王晟|00:48:15 我们现在这方向我们都叫它叫 Human Use,AI 怎么样控制真实实验中的一些实验员、一些 Technician 去做实验。
王晟|00:48:24 这是我们在对比了 Astra 和之前的一些模型中发现 Astra 还是可以做得比较好的。
王晟|00:48:29 这些任务的语料其实非常少,但是我觉得 Astra 它的更强的能力可能可以在这方面有一个提升。
泓君|00:48:36 我理解它分成两类嘛,一类是 AI 给方案它去预测你的新药可能是一个什么样的结构跟分子组成。
泓君|00:48:44 第二种就是说,这个方案做出来了,我们一定要在真实跟实验甚至是干湿实验的环节去验证这个方案可不可行。
泓君|00:48:54 就是现在它第一个部分做的还可以,在第二个部分的时候它再给的方案还不够好。
王晟|00:49:00 对,我觉得对第一个部分来说呢,其实是我们不知道 AI 做的好坏,这里面有一个悖论。
王晟|00:49:05 如果一个问题啊,比如说我说开发一个治疗癌症的药物,我如果知道答案,那这个问题其实我没有必要去研究了,因为我已经知道这个药物具体是什么了。
王晟|00:49:15 所以我们真正在意的问题都是不能被 Benchmark 衡量的,都是没有答案的。
王晟|00:49:21 所以我们在意的每一个问题,生物医学、AI for Science 的问题,最后都需要去湿实验验证。
王晟|00:49:27 干实验就是所有的预测、所有的分析都在计算机中模拟,无论是 CPU、GPU 都是在计算机中完成。
王晟|00:49:35 湿实验就是我们需要在真实的一个实验室、一个房间里通过试管、通过培养皿对老鼠、细胞等进行一些操作。
王晟|00:49:45 所以这就是计算机之内和计算机之外能达成的区别。
王晟|00:49:49 我给 AI 出一道题,我是不可能知道答案的。
王晟|00:49:52 GPT 给我一个药物的分子式,说这个能治疗癌症。
王晟|00:49:56 Claude 给我另一个分子式,我都得去湿实验,去做这个实验。
王晟|00:50:00 所以在做这个实验之前,它不仅是说给我个分子式,它还有具体的一个实验的计划,怎么样能够合成这个分子式。
王晟|00:50:08 这个小分子应该怎么储存,然后我应该以怎么一个周期给老鼠使用。
王晟|00:50:23 这些特别细节的东西是现在 AI 模型都做得非常差的。
王晟|00:50:28 他能够生成一个分子式,因为世界上有很多这样的数据,但这个分子式怎么合成,怎么给老鼠用这个药等等,这些他们都做得不好,然后这些其实是更重要的。
泓君|00:50:37 后者现在你觉得整个我们放眼下的大模型,它在设计一个实验上大概解决了设计实验的多少的比例,就完成度怎么样?
王晟|00:50:41 我觉得完成度是可能只有 30%吧。
王晟|00:50:44 很多时候是需要人类的专家去来给它修改。
王晟|00:50:50 在设计实验这个领域呢,是 Domain Expertise 需要的特别特别深入的。
王晟|00:50:56 这个领域的一个教授可能也不知道,需要专门针对这个方向做过很多时间的 Technician。
王晟|00:51:01 才能够设计一个高效的而且成功率很高又特别可行的实验。
王晟|00:51:08 还有一个呢,就是每一个实验室啊,它的器材或者它有的设备都是不一样的。
王晟|00:51:12 Astra 这种 AI 模型它没法根据这些设备器材来针对性的设计实验。
王晟|00:51:17 比如说我这个饭店里有一些原材料,有番茄、有鸡蛋、有土豆。
王晟|00:51:24 我让 Astra 来做一道菜,它并不能够理解这个饭店有哪些原材料,它不会针对原材料来设计一道菜。
王晟|00:51:30 它可能说给我做一道海鲜大餐什么什么的,这些就在现实世界中非常难以执行。
王晟|00:51:35 所以我觉得它缺乏的是对现实世界中资源的利用、协调和使用的能力。
泓君|00:51:38 这也是我们现在想要对模型进行改进的。
泓君|00:51:46 所以我理解现在如果说我们真的要让这些大的模型在 AI 制药上有所帮助的话。
泓君|00:51:51 我理解一个严肃的真的想用 AI 去生成药物的这样的一个公司。
泓君|00:51:54 它还是要配备自己的实验室的。
王晟|00:52:03 对,我觉得是一定要配备实验室的,因为现在的通用模型已经很厉害了,配备实验室它可以有自己的验证,可以有自己的数据积累。
王晟|00:52:18 现在 AI 在做这种药物发现,还有一个瓶颈呢,就是它验证的周期很久,我设计了个分子,然后这个分子我拿去老鼠上做个实验,不可避免就要花几周,因为老鼠有新陈代谢,对这个药物进行一些反应。
王晟|00:52:27 几周的时间,可能模型已经进化到下一代了,已经有 GPT-6.1、6.2 的出现了,到时候 AI 模型都进化得比我这些真实实验要更快。
王晟|00:52:38 所以我觉得这种前沿要做 AI for Science 的研究室,它需要有一个湿实验,而且它要对这些实验室进行改造、redesign,让这些湿实验能够更好地配合 AI。
王晟|00:52:42 比如说我一上来就把所有的细胞什么都准备好了,然后只有在 AI 会要预测的那几步。
王晟|00:52:49 我就可以有 AI 预测之后立即把那些小分子放进去。
王晟|00:52:51 把这些前置条件都做好,把湿实验和 AI 模型一起来设计。
王晟|00:52:56 能够把这个闭环走得更快。
王晟|00:53:09 而不是说分开,像我们现在 AI 模型设计一个东西,然后我移交给我的合作者,那合作者呢,他也不知道 AI 模型是怎么设计,也不知道 AI 模型会大概给些什么样的结果,他就把它重新来针对它设计一套湿实验。
王晟|00:53:15 这样分割开的话可能就会比较低效,所以我觉得未来的话,前沿实验室需要有湿实验的一个条件。
王晟|00:53:26 AI 从设计一个分子结构,到最后你的整个的干湿实验做完,达到临床一期的时间周期,它大概是有多长?
王晟|00:53:25 一般我们先做细胞和老鼠上的实验,这个几周就可以做完。
王晟|00:53:29 做完之后呢,一般会做一批比如说在猴子这种灵长类动物的实验,这个怎么样都要一个四个月的周期。
王晟|00:53:36 有时候我们会做两次,那就是四个月再加四个月,八个月。
王晟|00:53:40 作为一个 AI 制药的公司吧,一般我们做完猴子的实验呢,就不一定会推进到人的实验,会把它直接 License 授权给大的药厂,让他们去做人的实验。
王晟|00:53:51 这时候这笔授权费也是非常可观的,一般都是一千万美金以上,甚至可以更高。
王晟|00:53:57 大的药厂它有一个病人的这种网络,所以它可以更好的收集病人,做针对性的人体实验。
王晟|00:54:17 所以我们一般都是走到猴子时间结束,周期可能在 6 个月到 12 个月的时间线上。
泓君|00:54:16 嗯,对,所以就是要验证一个药物它花的时间是远比 AI 设计一个药物更久的。
泓君|00:54:21 但在 AI 给想法的这个问题上啊,现在我们说整个 AI 它已经很聪明了。
泓君|00:54:28 它数学领域发展得很快是因为数学它在很多的环节上它是可以被验证的。
泓君|00:54:31 而且它不需要做实验,所以它发展得很快。
泓君|00:54:37 那在生物学上,就比如说 AI 给你真的设计了一个新的分子、新的药物﹐。
泓君|00:54:41 你怎么去确定它的设计是对的呢?
王晟|00:55:01 对,我觉得这个就是最大的难点,这也是 AI 能够在数学上做出很大的成就,攻克千禧年猜想,但在生物医学上呢,其实到现在也没有一个说是 AI 完全开发的药物的一个根本原因,就是现实世界的反馈太慢了,而且这是受限于自然规律,一个老鼠一个猴子就需要那么久的时间。
王晟|00:55:06 在上一波 AlphaFold 的时期,有很多 AI Drug Discovery 公司当时也是雨后春笋一样冒出来了。
王晟|00:55:12 那时候还是大模型前 AlphaFold 的时期,但是那些公司大部分后面都没有成功。
王晟|00:55:16 就是因为他们还是以 AI 设计和发行药物为主。
王晟|00:55:24 但是这样即使能够把这个 AI 设计一个分子式的周期从半年提升到几天或者是几小时。
王晟|00:55:28 但之后还是会被后期的真实的老鼠人体实验给限制。
王晟|00:55:29 所以我觉得这是一个核心的问题。
王晟|00:55:38 如果能够把这个问题解决,AI 在生物医学制药上的爆发就会和 AI 解决千禧年的数学问题这样,会有一样的非常大的一个爆发。
王晟|00:55:46 我觉得这个问题是不可能从根本性上解决的,但是我们可以加速现实中的反馈,这样来间接地帮助我们解决和提升 AI 在上面应用的效果。
泓君|00:55:49 您指的 AlphaFold 的时期是哪个时期?
王晟|00:55:53 就是 AlphaFold 刚出来,当时蛋白质结构预测有一个很大的台阶。
泓君|00:55:56 AlphaFold 1 跟 2 的时候。
王晟|00:56:04 对对,就刚出来的时候,当时有很多 AI 创业公司决定用 AI 可以预测蛋白质结构,那么有了更好蛋白质结构,我们就可以快速地开发药物。
王晟|00:56:10 当时也可以预测生成很多好的药物结构,但是验证还是最大的瓶颈。
王晟|00:56:12 现在其实还是同样的问题。
泓君|00:56:17 我听说 AlphaFold 3 它是把它的所有的研究包括它的数据都开源了。
泓君|00:56:21 它的开源也带来了一波生物制药公司包括做这种垂直模型的公司。
泓君|00:56:24 做工制的公司崛起因为它开源了以后就相当于你这个行业。
泓君|00:56:29 它就类似于机器人行业派开源一样它有很多的底层的基础设施。
王晟|00:56:32 它已经 ready 了对,我觉得它的开源是非常重要的,然后在当时那个时间线,社区里有很多的机构都在尝试造 AlphaFold 的开源版本,有个叫 OpenFold 的工作,所以如果它不开源,大家也会很快追上,就有一些开源的版本来模仿它。
王晟|00:56:56 在它这些工具开源之后,对社区最好的帮助就是大家更重视数据的积累了。
王晟|00:57:04 它虽然开源了,但是一些垂直科学 AI 公司可以利用自己积累的数据来维护自己的护城河。
王晟|00:57:10 其实这些数据都是非常非常珍贵的,一条数据都是非常高价值,几万或者几十万美金。
王晟|00:57:17 因为它都是会在真实的老鼠、人类上做实验的,不仅是这些实验成本高,而且实验的周期也很久。
王晟|00:57:24 所以反而是开源之后,这些垂直的科学公司它会更具备优势了,所以这是它对 Computer 的一个贡献吧。
泓君|00:57:30 您指的一条数据是什么?就是一个实验在一个完整的动物身上跑通的,这个算一条数据?
泓君|00:57:37 比如说一个分子在老鼠上到底能不能杀掉癌细胞,这么就是一条数据。
泓君|00:57:42 那这个数据还是太便宜了,因为感觉这个大家要工作好久,工作量也挺大的。
泓君|00:57:49 是的,这是一个非常高价值的数据,也是在 Internet 网上大模型预训的语料库中根本看不到的。
泓君|00:57:54 那这样来看是不是生物医药界可能也会未来会兴起很多的数据公司?
泓君|00:58:00 反正你模型负责给想法,我就成立一个实验室就专门负责验证,它可能也是一个很好的商业模式。
王晟|00:58:10 对的,我觉得这是一个非常好的商业模式,因为现在那些 AI 数据的价格,比如说买一道奥数题都要几千美金,Terminal Bench 一道题也会要几千美金。
王晟|00:58:19 现在新出的 Terminal Bench Science 那上面的题也会是一个高价值的题。
王晟|00:58:25 我觉得这些题还仅限于计算机里面的操作。
王晟|00:58:19 那未来如果是有真的生物真实实验数据,那个价值会非常高。
王晟|00:58:24 还有一个很高价值的地方就是搭建一个能够帮助 AI 很方便的去做真实生物实验的接口,仅仅是这一个也会很高。
王晟|00:58:34 现在有个公司叫 Adaptive Bio,它是专门给 Anthropic 合作的。
王晟|00:58:38 Anthropic 生成一个 AI 的预测,它以 MCP 的形式就立即开始做实验。
王晟|00:58:43 它刚刚融资了〔转写异常〕,我觉得这样的公司会越来越多,以后每一个湿实验的公司都会以用这种 MCP API 的形式直接接到 AI 大模型里面,这样来给 AI 大模型直接进行服务。
王晟|00:58:56 这样当中很多人的沟通成本都会减掉。
王晟|00:58:59 所以这当中就又回到我刚才说的问题,最重要的就是 AI 自己知道要做什么实验,怎么设计这个实验,然后湿实验的公司能够和它进行配合。
泓君|00:59:09 现在像 OpenAI 还有 Anthropic 和哪些我们看到的前沿模型研究室配备了自己的湿实验室?
王晟|00:59:15 Anthropic 是明确配备了,它和 Adaptive Bio 是明确合作的。
王晟|00:59:20 它最近出了一个比赛,邀请大家来做一个 Anthropic 定义的蛋白质设计问题。
王晟|00:59:25 它会赞助 Adaptive Bio 这家公司来为大家做湿实验的验证。
王晟|00:59:30 所以 Anthropic 最近定义的比赛也是说最后以湿实验的验证为最后的标准。
王晟|00:59:35 我也听到很多消息,Astra 被自己在构建湿实验的团队,包括他招的一些人也都是有湿实验背景的。
王晟|00:59:43 我想 OpenAI 应该也会有类似的情况吧,也会开始慢慢布局这种湿实验的公司。
王晟|00:59:49 所以我觉得这是未来一个趋势,各个这种 AI Frontier Lab 如果是真的想做高价值发现,不是就刷现有的 Benchmark 的话,不可避免的是要有自己的湿实验实验室。
泓君|01:00:01 那 DeepMind 呢?
泓君|01:00:02 而且现在感觉它的创始人哈萨比斯他也重点是在 Isomorphic。
泓君|01:00:06 就是从 DeepMind 分出去的生物制药的公司上。
王晟|01:00:10 对,我不知道 DeepMind 和 Isomorphic Labs 会是怎么样的合作形式,是 DeepMind 搞 AI, Isomorphic Labs 做验证,还是说我猜测更多的可能 Isomorphic Labs 自己做端到端的,它会用一些模型,然后更多的来自己做验证,来端到端的解决。
王晟|01:00:24 John Jumper 就是另一个和哈萨比斯拿诺贝尔奖的那位科学家,他是加入 Anthropic 了,所以我觉得 Anthropic 在这方面会有很大的优势。
泓君|01:00:34 我看他们一起拿诺贝尔奖的还有一个人是 David Baker,他自己也是做了一个新的制药公司,是叫 Zyre 对吧?
王晟|01:00:42 对,他有很多制药公司,我不知道他的 commitment 有多大,据我理解他应该有几十家的公司吧,我理解他还是更多会专注于自己的科学研究,然后看看之后能不能拓展到商业或者他的 startup 里面。
泓君|01:00:57 你觉得在整个的模型对制药的影响上,对你来说几个比较大的节点是什么?
泓君|01:01:04 就是哪些基础模型能力的提升会让这个行业一下子就有一个质的飞跃或者提升?
王晟|01:01:11 现在我们的提升还几乎是取决于 coding 能力的提升。
王晟|01:01:15 现在因为大家还是没有走到湿实验或者真实世界的控制这一块。
王晟|01:01:19 所以在 coding 的能力上提升之后,我们这些 Biomind 和相关的任务也会做得特别简单。
王晟|01:01:25 所以现在我觉得 Biomedical 上这些 coding 任务,虽然那些 Benchmark 上还没有达到满分,但我个人理解已经是几乎可以认为是解决了,因为它已经比人做的要好了。
王晟|01:01:35 像 Terminal Bench Science 上的一些 Biomedical 问题,我自己去试了一下,我做的都没有 AI 好,虽然很多 AI 的分数,即使是 Astra 也只有六十几分吧,满分一百分就六十几分。
王晟|01:01:46 但是它其实已经做得比我好了,所以我认为它们已经解决了。
王晟|01:01:49 所以比较大的节点就是 coding 能力的提升就会把生物制药这些 DryLab 上的能力的提升都给解决了。
王晟|01:01:57 还有一个问题就是生物医学的数据特别的大、特别的复杂,每个人的数据都可以达到两个 T。
王晟|01:02:04 那么如果未来的模型还需要提升的话,就是这一块,就是这种两个 T 的数据的高效的处理理解,这是一个非常非常重要的领域,也是一个非常大的一个机会。
泓君|01:02:15 您刚刚提到了您觉得现在 AI 在一些能力上已经超过您了,因为您已经算是人类很顶尖的科学家了,也是做学术研究的,我可以理解它已经不是超越平均智商了,而是最顶级的这些智商,那在这个环节中你觉得它未来给你们这些前沿科学家带来的问题是什么呢?就比如说它做的东西你们很难去验证了,会有这样的情况存在吗?
王晟|01:02:41 对,验证的话也是要靠湿实验验证。
王晟|01:02:44 如果一个问题已经定义得很好了,有一个明确的测试集。
王晟|01:02:48 明确的输入,要知道解决什么样的问题,那 AI 解决这个问题的能力会比我强。
王晟|01:02:53 那么人类科学家更多可以做的事情呢,就是定义哪些问题 AI 去解决。
王晟|01:02:58 所以我觉得未来 AI 在生物医学里的趋势呢,不再是解决问题设计模型了。
王晟|01:03:04 更多的是设计 Benchmark,并且使用了很多的技术,设计 Evaluation 的方法,定义一些重要的问题去解决。
王晟|01:03:15 还有生物医学是关系到制药或者治疗病人这些直接和人打交道的。
王晟|01:03:19 所以很多时候还是需要一个科学家参与在其中而不靠 AI 自动化。
王晟|01:03:22 需要一个人类科学家作为一个背书吧就像飞机就算能自己飞我们也希望有个驾驶员在上面对吧。
王晟|01:03:29 AI 能自己看能自己治疗出诊断书我也希望一个医生真的肉眼看下我的报告。
王晟|01:03:42 所以在科学发现这种一下就会投入很多钱、很多时间的重大决策上,还是需要一个人类科学家去一起把关,一起去判断这个问题的价值。
泓君|01:03:46 如果纯粹是解决问题,我觉得 AI 已经会比最强的人类科学家都要强了。
泓君|01:03:59 您刚刚有提到你觉得像 Astra 它在 Benchmark 上,现在整个 Benchmark 它的定义是有问题的,那你觉得未来它的 Benchmark 它应该会怎么样去定义,它会朝什么样的方向去演进呢?
王晟|01:04:14 我觉得未来首先我们要设计那些生物医学的题它是没有上限的,它是一个不可能被刷爆的,比如说现在的 Sota 的药物能够把 30% 的癌症细胞给杀掉,那么 AI 能不能做更好的药物能够把 40% 的癌症细胞杀掉。
王晟|01:04:17 将让 AI 不停的设计,能够有一个没有上限的方式来做这个任务。
王晟|01:04:28 同时在这个任务做的过程中也会形成一个数据的飞轮,就是我不停做湿实验,虽然这些湿实验很贵,比较慢,但是持续对这个任务做湿实验,还是可以收集到可观的数据的。
王晟|01:04:38 但是想避免的就是一些简单的分类任务,比如说分类这个基因会导致癌症还是不会导致癌症,这样的任务就很容易被 AI 解决了。
泓君|01:04:52 我们未来要设计的还是这种比较宏大的、很难有上限的,比如说怎么样把人类的寿命提升,这种没有上限的任务能够让 AI 持续地解决,然后我们可以持续地积累数据,这样积少成多,把一个特定问题的数据给积累得更多。
泓君|01:05:00 您刚刚有提到了在 AI 领域它还没有自己真正做出来的一款药是被验证过然后被可以使用的。
泓君|01:05:04 为什么它是没有被验证过但是它这个领域还是依然很火只是时间还早还是说它未来会被解决。
王晟|01:05:09 对我觉得未来会被解决只是时间还早因为现在 AI 是一个新时代的也就是过去几年才发生的。
王晟|01:05:15 一个药的周期也要五到十年对吧现在还没有走到那个药的周期。
王晟|01:05:22 我觉得未来会有一个 AI 自己发现和更好的验证药物的机会。
王晟|01:05:43 现在的话,它新的药物发现,包括之前有一家公司,它说它的药物是由 AI 高强度参与设计的,但是这些可能更多的是一个 AI 参与吧,或者是一个噱头吧,我觉得,因为从那个药物开始研发都是五年到十年前的时候了,那时候的 AI 和现在完全不是同一种 AI,所以我觉得未来是会的,这更多是一个时间的因素。
泓君|01:05:59 对,然后我看 Claude 他们最近有一个新的成果,就是他们发现了一种新的 ART,它有一点点类似于 CRISPR-Cas9 的这种基因编辑的工具,但是它最后有没有被验证还不太确定嘛,就科学家也在观察这个现象。
泓君|01:06:11 你觉得现在就是模型它在哪些方向已经非常强了,就是在生物医药领域,我们已知的领域,它已经开始有一些突破了,我们看到这些突破它的苗头是什么?
王晟|01:06:31 对,我们观察到这个突破几乎就正比于生物医学实验的周期,周期越短反馈越快,大家其实在过去的几十年中都积累了好多的实验数据,这些实验数据通过各种方式,比如说写在论文里,或者是被一些大模型公司收购,都已经被这些大模型公司所拥有了。
王晟|01:06:35 所以当实验做得越快的领域,它模型就可以做得越好。
王晟|01:06:43 比如说 Anthropic 他们这次做的一个比赛也是对酶、enzyme 的一个设计,这就是实验特别快的一个领域。
王晟|01:06:49 未来像蛋白质、酶这些可以做快速实验的,我觉得都会有很快的一个迭代。
王晟|01:06:54 但如果比如说我们要做一个衰老或者研究一个罕见病这种。
王晟|01:06:58 特别的 rare 特别的一个 domain specific 的特别长周期的问题。
王晟|01:07:00 那我觉得模型的进展还是会很慢的然后也很难有很快的进展。
泓君|01:07:05 每一根蛋白质它带来的是哪些领域的变化有一些特定的领域吗。
王晟|01:07:09 就比如说减肥或者癌症治疗理论上蛋白质是万能的,减肥、癌症治疗所有的病,理论上蛋白质都可以通过一些方式引导我们制药来改变人体,然后来治疗。
泓君|01:07:40 每个人都会有〔转写异常〕,比如说我们以前会设计的一些酶可以把一些地沟油变成一些实用可以用的油,或者把一些洗衣粉让它能够在不同的温度下都能够有活性,所以酶更多的是生活中对各种工业化工的过程中进行一些加工帮助加速的一个过程。
王晟|01:07:38 所以它的商业价值其实是非常大,而且可以快速落地的。
王晟|01:07:42 那蛋白质呢,如果我还是要涉及药物,最后还是不可避免,要做人体实验,还是有一个较长的周期。
泓君|01:07:48 哦,了解了解,对,非常精彩。
泓君|01:07:51 我其实也在跟很多模型的研究员去聊了,因为之前大家一直在说蒸馏这个概念。
泓君|01:07:57 然后很多前沿模型实验室的研究员他就说,其实很多普通人他现在可能就连蒸馏的价值都没有了。
泓君|01:08:04 就这个话听上去很悲哀,但是是不是现在整个训练的信号也正在转向像专家数据还有可验证环境,大家同意吗?
许华哲|01:08:13 机器人这儿很显然不是这样的。
许华哲|01:08:16 机器人这儿每个人都是生活的专家,所以在机器人这儿没有那么悲哀,大家都值得被蒸馏。
许华哲|01:08:22 你擅长做饭,我擅长叠衣服,他擅长走路,他擅长跳舞。
许华哲|01:08:27 当然再往后走也会经历这样的一个阶段。
许华哲|01:08:30 今天的机器人还做不了大模型之于普通人的档次的事情。
许华哲|01:08:35 所以我觉得如果也许一年后两年后才会到这样的一个阶段。
许华哲|01:08:40 就是说必须要是一个舞蹈专家或者必须要是一个 Gordon Ramsay 这样的大厨才值得被蒸馏。
许华哲|01:08:46 我觉得在今天就是家常菜的每个人做的都值得被蒸馏。
王晟|01:08:49 如果知识被蒸馏的话,那确实现在 AI 的知识更全面,单个科学家肯定是比不过的。
王晟|01:08:56 但是呢,有一些科学发现、一些长期投入还是需要科学家或者工程师在那边支持背书,所以这方面是 AI 替代不了的。
王晟|01:09:04 同时也有一个反向蒸馏的问题,因为 AI 这么强,我天天也在蒸馏 AI,我很多新的领域,尤其我们做 AI for Science 交叉学科的很多东西我不知道,我就可以快速地向 AI 学习,学习之后我获取知识的速度也快,有时候有一些新的 idea 新的创意,我可以做更好的一个科研成果。
王晟|01:09:22 所以我觉得这是一个互相蒸馏的过程。
王晟|01:09:25 然后另一方面呢,如果从我们医学这个很 specific 的角度来说呢。
王晟|01:09:29 人的作用永远是非常大的,因为他不仅是解决问题,人还可以定义问题,或者人可以表达一些他想 AI 解决的问题,比如说有一些新的疾病,或者人想要活到 200 岁活到 500 岁,这些问题都是源源不断的,然后每个人会有自己不同的身体状况,不停的提供给 AI 新的问题,新的要解决的方向,所以这些都是普通人绝对不会被 AI 所取代啊,或者去怎么样的一个情况。
泓君|01:09:56 嗯,说得特别好,Bill。
朱哲清|01:09:58 从蒸馏的角度来说,因为我们现在的智力或者说模型的能力还是在非常大的模型可能 Memorize 或者是就死记硬背了很多很多的知识在里面。
朱哲清|01:10:11 以及一些 Know-how 也是在训练当中基本上硬加进去的。
朱哲清|01:10:14 比如说你在 Optimize 这些 Benchmark 在推进固定的一些落地场景上面,你会做很多的 Overfitting 的一个状态。
朱哲清|01:10:23 在这种情况下,其实目前我们 Overfit 的领域可能都还不够,很多领域值得被 Overfit。
朱哲清|01:10:31 虽然我现在都说可能模型已经到了 General Intelligence 的这个级别,但是从我们目前在已经 Overfit 的场景上面来说,我们可能没有到那么 General 的状态。
朱哲清|01:10:42 后面如果我们要真的做到真正非常 general 的 intelligence。
朱哲清|01:10:46 那可能我们还要跳出蒸馏每个场景,蒸馏或者说 overfit 每个场景的这么一个状态。
朱哲清|01:10:52 进入到能不能模拟一个人从零开始学习的这么一个状态。
朱哲清|01:10:57 从这个角度来说,我们其实需要蒸馏人的能力不在于说我能不能把这件事情做好。
朱哲清|01:11:05 而是蒸馏人是怎么学习从零开始学,怎么比人学的还要快。
朱哲清|01:11:11 如果我有一个 Foundation Model 它可能是非常 under fit 的一个状态。
朱哲清|01:11:15 但是我能不能在某一个领域,比如说我这个模型自己想当一个医生,那我能不能在一个月的 interaction 当中成为了一个人类的基础医生水平?
朱哲清|01:11:26 比如说在三个月的 Interaction 过程当中,成为了人类的某一个教授水平,完完全全靠模型自己迭代的方式来学习。
朱哲清|01:11:34 这个我觉得我们远远没有到这个程度的。
朱哲清|01:11:37 我觉得未来可以从人这边得到的 Intuition 其实还是很多的,就是人类还没有到完全被取代的这么一个状态。
泓君|01:11:44 嗯,对,我觉得可能很多是一层表层的技能,而不是底层的思维方式。
朱哲清|01:11:50 嗯,对。
泓君|01:11:51 今天很难得啊,就是我们是把三个不同领域的我觉得做得好的创业者跟学者请来了。
泓君|01:11:57 大家要不要说一下现在在你们领域里面,你自己最关心跟关注的一个问题。
朱哲清|01:12:02 我们现在最关注的问题其实就是目前硬件上面,全世界 Memory 很有限,RAM 非常贵,VRAM 非常贵。
朱哲清|01:12:12 很多人又 concern 说我是不是把所有的数据都上云了。
朱哲清|01:12:16 如果说未来我们认为所有的计算和算力会被铺开,每个人都会有自己的算力,每家公司也会有自己的算力。
朱哲清|01:12:25 算力不再集中于只是在数据中心当中。
朱哲清|01:12:28 我们是不是可以想象到所有人都可以有自己的算力,可以运营自己的模型。
朱哲清|01:12:32 这模型不一定说要做到最大最大,那我们能不能通过这些模型来解决生活当中百分之八、九十的问题。
朱哲清|01:12:40 解决现在 AI 不能够完全无限量普及的这么一个问题。
朱哲清|01:12:45 那我其实还是同意说未来模型还是会需要往大了走,需要往更强了走,但是它可能有个广度跟高度的问题。
朱哲清|01:12:54 比如说 AI for Science 上面我可能需要一个非常高度很高的模型,而在正常的比如说企业工作、个人生活当中你可能需要一个广度很高的模型,但这个模型大小不需要很大。
朱哲清|01:13:07 那这个是一个结合的问题,但是如果做好正确的结合,其实是可以解决目前的硬件需求和电力需求的瓶颈。
许华哲|01:13:16 从机器人角度我们最关心的肯定还是零样本的泛化能力吧。
许华哲|01:13:22 之前的机器人其实有两条路,一条是部署,一条是泛化。
许华哲|01:13:27 这两头路其实有一点正交,就不属的话有点像是 AI 赋能上一代的机器人。
许华哲|01:13:33 我在工厂里面的机械臂原来可能是开环拧螺丝,开环是指我不拿反馈,我把这个位置都标定好,然后过去。
许华哲|01:13:41 然后现在我有了 AI 我可以闭环拧螺丝,或者闭环地去上货,但是这件事情从我的视角来看也还可以。
许华哲|01:13:47 还是有点逆时代的,就是你仍然需要五个 PhD level 的人去到那儿,然后在工厂里面可能睡三个月,然后去把这个机器人的稳定性啊,速度是否要定制末端夹爪,这些事情选择解决。
许华哲|01:14:00 但是今天我们也是聊 Astra 嘛,我觉得最终我们还是希望是一个通用机器人,他零样本的可以做快速部署,这个部署应该是五个任意的人,然后放在那儿,他其实更多就是说有一些体力劳动。
许华哲|01:14:13 或者是懂一些基本的技能,而不是说需要五个非常强的人然后去到那儿。
许华哲|01:14:18 那这样的零样本方法肯定是有冗余,那这样的冗余我们是否可接受?我觉得是可接受的。
许华哲|01:14:24 那在这种情况下,能否有一个足够好的、快的零样本方法的模型仍然是机器人最主要的追求。
泓君|01:14:30 你觉得机器人离那一步还有多远?
许华哲|01:14:33 我觉得 28 年初会是一个通用机器人比较开始真正实用的时间节点。
许华哲|01:14:38 到现在开始,可能 18 个月后,大家可以在家里面可以以语言的形式去让一个机器人做家里面 90% 的事情。
泓君|01:14:47 这个预测还是相当激进的。
许华哲|01:14:50 如果你玩了 Astra,如果你下个月也许可以玩我们的模型,应该觉得这个预测还是比较合理的。
泓君|01:14:56 哦,那机器人进展很快。
许华哲|01:14:58 对,我觉得机器人其实是相对慢的,但是因为二三年的时候机器人和大模型同步出发,大家看到大模型发展得非常快。
许华哲|01:15:07 机器人其实已经慢了一倍的速度了,但是我觉得物理世界的东西总是要慢一点的,就它没有办法像纯软件的东西那样超快速迭代。
泓君|01:15:16 对,我整体上是觉得今天跟您的聊天整个气氛它是乐观了很多,因为在我们从 20 年关注 GPT 到 22 年关注 ChatGPT,然后再到大模型多模态,我觉得在前几轮中整个模型层它的发展是远超机器人的,可能就在过去一两年甚至一年以前大家觉得机器人的 GPT moment 还没有到来,那今天其实我们已经在谈应用了,所以我觉得整个它的进展还是非常的快的。好,那王教授。
王晟|01:15:54 这 AI for Science 如果真的要有突破,那最重要的就是 AI 对真实世界的一个理解,一个真实世界资源的运用、分配等等。
王晟|01:16:08 就像我们研究 Science 它本质就是研究真实世界,物理学就是研究宇宙,生物就是研究生命,化学研究微观世界,那 AI 它还需要对真实世界有理解,并且能够运用真实世界资源。
王晟|01:16:13 这个不是说我设计一个机器人去取代人类来自动地做实验。
王晟|01:16:21 还是说 AI 知道根据现在我实验室有哪些资源,我应该让这个机器人或者是让这个人去做些什么事。
王晟|01:16:25 比如说以后我在 Prompt AI 的时候不是说给我设计个药物能治疗癌症。
王晟|01:16:31 还是说给你十万美金你给我设计个药物并且呢我有这些实验可以做。
王晟|01:16:36 比如说做一个老鼠实验要两千美金,做一个人体实验可能要一个怎么样的周期。
王晟|01:16:43 AI 能够真的这样 Plan 真实世界中的超级复杂的任务,这些都是它的预料中很难见到的。
王晟|01:16:43 这可能需要一个新的范式,就像现在我们都是人来用 AI,人来研究怎么写好的 prompt,可以把 AI 指挥的好,AI 可以做任务做的更好。
王晟|01:16:52 怎么写好的 prompt,怎么搭好的 agent。
王晟|01:16:55 未来可能是 AI 要写出清晰的可执行的一个指令,是 AI 来 prompt 这个真实世界,清晰可执行的指令,非常高效,非常清晰,不 ambiguous。
王晟|01:17:07 然后人或者机器人可以根据这些指令去利用现实世界的资源高效把这些事情完成。
王晟|01:17:13 就像以前我们都说看到 AI 能不能 follow 人的指令。
王晟|01:17:16 未来我们可能要的是比如说 Instruction Generation 来生成指令。
王晟|01:17:20 生成的更好帮助我们调动现实世界的资源。
王晟|01:17:24 甚至我们还会对现实世界进行一些改造,未来的一些实验设备仪器它不是给人看的,不是给人用的,是让 AI 用的。
王晟|01:17:41 我们现在比如说拍 X 光拍 CT,我们还要合成下图片为了让人类医生能看。
王晟|01:17:42 未来可能直接就拿出底层那些波形或者信号,直接给 AI 看就行了,都可以跳过生成图片那一步。
泓君|01:17:55 所以这是我认为最重要的,就是 AI 能够更好地走到真实世界中,无论是通过机器人还是一个真实的人类,但他都要知道怎么样去利用真实世界的资源来解决这种超难的问题。
泓君|01:18:02 好的好的,特别棒。那今天非常精彩,我觉得我学到了很多行业里面非常细分的知识,感谢大家。
许华哲|01:18:03 谢谢。
泓君|01:18:15 上周我们办硅谷 101 Alignment 2026 大会的时候,王晟也是我 AI for Science 内场论坛的嘉宾。
泓君|01:18:26 当时我在台上问了他一个我自己很好奇的问题,我说 Claude 说自己找到了一个像 CRISPR 的新酶系统,这件事出来以后,AI 圈和生物圈的反应有什么不一样?
泓君|01:18:32 他自己的回答非常有意思,他觉得 AI 圈是非常兴奋的,因为 AI 开始做科学发现了。
泓君|01:18:38 但是呢,生物圈的反应是相对平淡的,大家想在实验室里验证了再说。
泓君|01:18:43 我后来一直在想,这是为什么会出现这样两个不同的现象啊?
泓君|01:18:50 因为模型层的进展和一个行业真正的改变,中间隔着的可能不仅仅只是智能,还有验证。
泓君|01:18:54 那机器人它要在真实的世界里反复地去试。
泓君|01:19:02 制药要等猴子和老鼠的新陈代谢,Agent 也要去过商家、过用户的那一关。
泓君|01:19:08 所以,AI 圈子看到的是能力曲线,那行业里的人看到的就是落地周期。
泓君|01:19:16 所以接下来我们也会有更多的节目去关注各个行业它的底层逻辑是什么,AI 如何在各个行业里落地。
泓君|01:19:22 那大家听到我们这一期节目是什么感觉呢?欢迎在评论区给我们写留言写评论。
泓君|01:19:32 那如果大家还没有关注我们,可以通过小宇宙、Spotify、苹果播客、YouTube、还有哔哩哔哩、喜马拉雅、蜻蜓 FM、荔枝 FM、QQ 音乐来关注我们。
泓君|01:19:34 我是泓君,感谢大家的收听。
References
- 1官方单集页:E256|Agent、机器人与制药,谁先被GPT-6 Astra改写?
sv101.fireside.fm
- 2
- 3香港经济日报:Meta Muse 只需 22 天下载量逾 500 万次
inews.hket.com
- 4腾讯新闻(FX168):14 人 AI 公司估值冲上 100 亿美元,一个月翻 4 倍
news.qq.com
- 5爱范儿:24 天估值暴涨 37 倍,这就是 AI 圈年度爽文
ifanr.com
- 6
- 7Biohub:虚拟生物学计划扩张
biohub.org
- 8
- 9Artificial Analysis:Welcome to the era of embodied AI — Introducing AA-Robotics v0.1
artificialanalysis.ai
- 10华盛顿大学:Sheng Wang 个人主页
homes.cs.washington.edu
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.