卡多确实更容易发顶会!CVPR发布算力报告
CVPR 2026 首次公开 16,034 篇投稿的算力账单:录取论文中位 4 张卡、2,000 开发小时,拒稿论文 2 张、1,200 小时——而四分之一的录取论文全程只用了一张卡。

本文转载自微信公众号「量子位」。原文发表于 2026 年 11 月 2 日,作者文婷,《卡多确实更容易发顶会!CVPR 发布算力报告》。
文婷 发自 凹非寺 量子位 | 公众号 QbitAI
11 月 2 日凌晨,CVPR 的官方账号在 X 上贴出一份报告的链接。1
报告叫 CVPR 2026 Compute Report。CVPR 说,这是第一次把投稿者填报的算力数据汇总起来公开。2
新闻稿在 10 月 28 日发出。报告自己的交互页上,标题底下还挂着一行字:DRAFT,数据与设计仍可能变。3
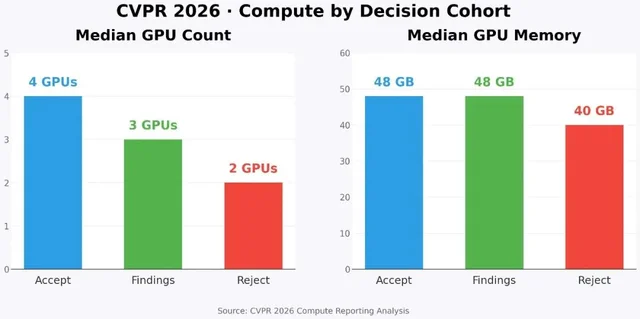
被录取的论文,GPU 数量中位数 4 张,单卡显存 48GB。2
被拒的论文是 2 张、40GB。2
开发阶段烧掉的算力,录取组中位数 2,000 小时,拒稿组 1,200 小时,差了 67%。2
两组的项目周期中位数都是 7 个月。3
一万六千份表,是投稿时就要交的
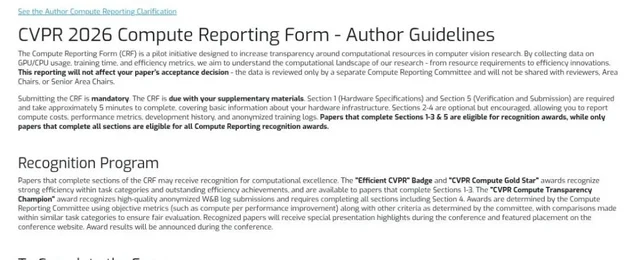
CVPR 2026 把算力披露塞进了投稿流程,这张表叫 Compute Reporting Form。4
必填的只有两节:硬件规格,和确认提交。官方估计五分钟能填完。4
要写清楚的是:用了什么 GPU、几张、单卡显存多大,机器是自建机房、共享集群还是云。4
剩下三节选填,分别对应开发算力、效率指标和匿名的 W&B 训练日志。4
16,034 份表收了上来:录取 3,985 篇,Findings 1,463 篇,拒稿 6,162 篇,撤稿 4,139 篇。3
这四类加在一起是 15,749 篇。另外 285 篇在初筛就被退回,报告只作展示,没算进后面对比。3
按这个分母,录取率是 25.3%,把 Findings 算上是 34.6%。3
原文把 CVPR 提前给作者的一句定心话单独引了出来:5
作者交上来的算力表,只会由一个独立的委员会单独处理,审稿人、领域主席和高级领域主席根本看不到,更不会拿来决定论文录不录。
官方指南里是同一套口径:数据由独立的 Compute Reporting Committee 处理,审稿人、领域主席和高级领域主席都看不到。4
再往下翻常见问题,还有一句更干脆的回答:算力数据不会以任何方式影响论文的录用决定。4
差出来的那一截,落在试过多少条死路
原文把 2,000 小时和 1,200 小时的差距归到迭代上:方向不行就换,基线压不住就推翻重来。5
报告换了个量来描述这件事,叫开发/训练倍数,也就是开发阶段的算力是最终训练算力的几倍。3
录取组 13.6 倍,拒稿组 7.8 倍。3
同样七个月,录取组把更多机器时间花在了最终没写进论文的那些实验上。3
| 队列 | GPU 张数中位数 | 单卡显存中位数 | 开发算力中位数 | 开发/训练倍数 | 项目周期 |
|---|---|---|---|---|---|
| 录取 | 4 张 | 48GB | 2,000 小时 | 13.6 倍 | 7 个月3 |
| Findings | 3 张 | 48GB | 2,000 小时 | 11.8 倍 | 7 个月3 |
| 拒稿 | 2 张 | 40GB | 1,200 小时 | 7.8 倍 | 7 个月3 |
| 撤稿 | 2 张 | 40GB | 1,332 小时 | 4.2 倍 | 7 个月3 |
Findings 这一行的两个数字值得多看一眼。它的开发算力中位数跟录取组一样,都是 2,000 小时。3
拉开距离的是倍数。两边的开发算力都是 2,000 小时,Findings 组的 11.8 倍低于录取组的 13.6 倍,说明它把更大的一块留给了最终那次训练。3
4 张之后,还有一张卡的中稿论文
中位数只说明一半人落在哪边。报告把整个分布也放了出来。3
录取论文的 GPU 张数,5% 分位是 1 张,25% 分位还是 1 张,中位数 4 张,75% 分位 8 张,95% 分位 32 张。3
也就是说,四分之一的录取论文全程只动了一张卡。3
拒稿组的上沿低一截,95% 分位是 16 张。3
原文自己也在给这个数字降温:4 张对 2 张,是论文结果出来之后统计出来的相关性。5
CVPR 2026 的程序主席 Vladimir Pavlovic 讲了做这件事的由头:外界普遍觉得 GPU 是当下 AI 的一大推手。2
他说,他们想拿到具体数据,看基础设施到底起没起作用,让证据自己说话。2
一张 4090,也能把奖抱回家
CVPR 2026 还设了三个效率奖。4
其中 Compute Gold Star 给的是效率上的突破。6
萨里大学的公告说,16,000 多篇投稿里,拿到这个奖的只有 18 篇。6
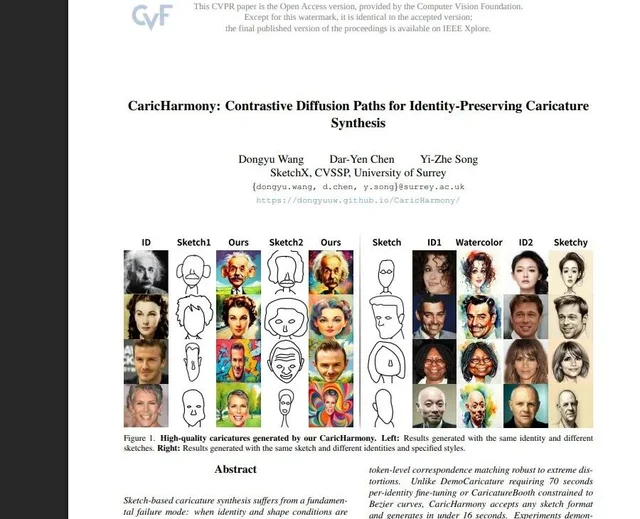
CaricHarmony 是这 18 篇之一,作者是 Dongyu Wang、Dar-Yen Chen 和 Yi-Zhe Song,都在萨里大学 SketchX。7
它做的事:给一张草图,画出一张夸张、但一眼认得出是谁的漫画。7
难在两种条件会互相捣乱。身份和形状同时塞进扩散模型,结果要么是一张平淡的肖像,要么扭曲到认不出。7
论文的做法是开三条路:一条只管身份,一条只管形状,第三条负责把两头调和成一张图。7
三条路各走各的,再用能量函数把调和的那条拉回平衡点。7
整个过程不用重新训练,也不用给每个人单独做微调。7
一张消费级的 RTX 4090,16 秒内出一张。7
论文拿来对照的 DemoCaricature,要给每个身份单独微调 70 秒。7
另一个是 Efficient CVPR Badge,看的是同一类任务内部的效率高低。4
Badge 和 Gold Star 都要求填完第 1 到第 3 节。Transparency Champion 要得更狠,得把匿名的 W&B 训练日志一起交上来。4
谁在交稿,谁在过稿
这批提交来自 69 个国家。3
中国 8,552 篇,占 53.3%,比另外九个投稿大国加起来还多。3
美国 2,185 篇,13.6%;韩国 972 篇,6.1%。3
主要投稿国的录取率都落在 24% 到 34% 之间:中国 25.0%,美国 27.1%,韩国 25.7%,香港 33.2%,新加坡 27.3%。3
两头各有一个例外:瑞士 37.1%,在主要投稿国里最高;印度 16.3%、台湾 13.3%,明显低于平均。3
换成按人口归一化,排序就全变了。3
新加坡每百万人 64.6 篇,香港 53.2 篇,美国 6.6 篇,中国 6.1 篇。3
按研发投入算又是另一幅图:中国每十亿美元研发经费产出 13.8 篇,美国 2.9 篇。3
报告给的解释是结构差异。美国一年 7,550 亿美元研发开支,摊在生物医药、国防、能源和航天上,计算机视觉只占一小块。3
跟录取走得近的,是能反复开工的张数
用了 H100 或 H200 的论文,只占 11.6%。3
大头是更普通的卡:消费级与工作站级 34.6%,A100 占 28.4%,RTX 3090、V100 这一档 17.2%。3
地区之间差别很大。3
美国、英国、德国、法国、澳大利亚的研究者以 A100 级的机构集群为主,H100 使用率在 14% 到 22% 之间。3
中国的众数是 RTX 4090 级,占 37.3%;报 H100/H200 的只有 10.3%。3
日本是反例。H100 渗透率 22.5%,录取率 24.6%,跟中国的 25.0% 基本持平。3
报告的结论写得干脆:H100 渗透率与录取率之间没有显著相关。3
有相关的是另一个量——每篇论文能调动多少张卡。3
机器的来源则相当分散:录取论文里 49.9% 用自建机房,27.9% 用共享学术集群,19.2% 用商业云。3
顶会早就在问这笔账
NeurIPS 的论文检查表第 8 条就是「实验算力资源」。8
这一条要求作者写清用的是 CPU 还是 GPU、机器在自建集群还是云上、内存多大、跑多久,还要估算整个项目的总算力。8
漏交整张检查表的论文会被直接退回。8
AAAI 也把复现检查表写进了投稿要求。9
CVPR 这次多走了一步:不只是每篇交代一句,而是把一万六千多篇摆在一起比。3
一条 DRAFT 提示,一句没定义清楚的话
报告的交互页至今标着 DRAFT,数据与设计还会动。3
X 上有人就在追问,这里的 development time 具体指什么。10
按披露表的定义,第 3 节要的是开发阶段的总算力,包含所有实验、失败的尝试和反复迭代。4
报告表格里这一列的名字是 Median development compute,单位是小时。3
所以 2,000 小时说的是一个项目从试到成的累计开动时间,落在单个模型身上的训练时长要短得多。4
原文最后收在两句话上:卡多不多、算力够不够跑,确实在悄悄给论文加码;而「省卡」本身,也开始有了一块领奖台。5
这份表里对投稿人最好用的一行,大概是那个 13.6 倍。同样七个月,手里能反复开工的卡有多少,决定你能踩完几条最后没写进论文的岔路。3
References
- 1@CVPR 推文
x.com
- 2CVPR 2026 新闻稿
cvpr.thecvf.com
- 3CVPR 2026 算力报告
computereport.github.io
- 4算力披露表作者指南
cvpr.thecvf.com
- 5量子位原文
mp.weixin.qq.com
- 6萨里大学公告
surrey.ac.uk
- 7CaricHarmony 论文
openaccess.thecvf.com
- 8NeurIPS 论文检查表
neurips.cc
- 9AAAI-26 复现检查表
aaai.org
- 10EIFY 的回复
x.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.