Claude Sonnet 5.5 发布:同价、每任务最多省 30%,五项改动会让 Sonnet 5 的代码报错
Anthropic 发布 Claude 5.5 家族第二个模型 Claude Sonnet 5.5:标价与 Sonnet 5 相同、多数工作每任务最多便宜 30%、Terminal-Bench 从 10.3% 升到 70.6%,同时有五项改动会让 Sonnet 5 的代码直接报错。

Anthropic 在 2026 年 9 月 28 日发布 Claude Sonnet 5.5,这是 Claude 5.5 家族第二个模型,接替 Sonnet 5。1官方给它的标价与 Sonnet 5 完全一致:输入每百万 tokens 2 美元、输出 10 美元,但同样一件事要的 token 更少,官方称大多数工作每个任务最多便宜 30%,出字速度比 Sonnet 5 快 30% 以上。1跳得最狠的一项是 agentic coding:Terminal-Bench 4.0 上它拿到 70.6%,Sonnet 5 是 10.3%。1
代价写在迁移上。官方列了五项破坏性变更,其中任何一项都会让沿用 Sonnet 5 写法的请求直接返回 400 错误。2
先说结论
- 定位按任务类型划分。 Sonnet 5.5 负责范围明确的日常活:修 bug、做功能、产出文档、幻灯片和表格;需要长时间判断的开放式任务,官方仍然指向 Opus 5.5。1
- 标价没动,动的是每个任务的成本。 输入 $2、输出 $10 每百万 tokens,缓存读取 $0.20,与 Sonnet 5 相同;官方把「每任务最多省 30%」归因于同样的事花更少 token,加上出字快 30% 以上。13
- 能力跳变集中在编码、长程任务与图表识别。 Terminal-Bench 4.0 从 10.3% 升到 70.6%,CursorBench 4.0 从 34.1% 升到 55.5%,Chartography 从 15.6% 升到 61.6%;多数项目上它仍低于 Opus 5.5,医疗一项反超。14
- 迁移要动手。 五处改动会让旧代码报错:
thinking传disabled、强制工具调用、跨模型的 thinking block、computer_20251124,以及部分 advisor 配对。25 - 独立评测还没出。 Artificial Analysis 的榜单页本次核验时没有 Sonnet 5.5 条目,官方公告里的八项对照中,六项是 Anthropic 自测。6
- 时间窗口宽松。 现在所有平台都能直接调用,不需要申请;淘汰承诺不早于 2027 年 9 月 28 日。3
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与 API id | Claude Sonnet 5.5;Claude API 上是 claude-sonnet-5-5,Amazon Bedrock 上是 anthropic.claude-sonnet-5-5 | 模型页 |
| 发布方与时间 | Anthropic,2026 年 9 月 28 日 | 官方公告 |
| 家族位置 | Claude 5.5 家族第二个模型,接替 Sonnet 5;官方称 Haiku 5.5 将在未来几周内加入 | 官方公告 |
| 参数规模 | 官方未披露 | 模型总览 |
| 上下文与输出 | 上下文 1M tokens,单次输出 128K;Batch API 在 beta 头 output-300k-2026-03-24 下可到 300K | 模型页 |
| 思考与档位 | 自适应思考默认开启;Claude API 默认 effort 为 high,共五档 low / medium / high / xhigh / max;Claude 应用与 Claude Code 里默认 medium | 官方公告 |
| 模态 | 文本与图像进、文本出 | 模型页 |
| 知识截止 | 2026 年 6 月 | 模型页 |
| 价格 | 输入 $2 / 输出 $10 每百万 tokens;缓存写 5 分钟 $2.50、1 小时 $4,缓存读 $0.20;Batch 五折 | 模型页 |
| 可用范围 | Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS,所有客户均可用 | 官方公告 |
| 淘汰承诺 | 不早于 2027 年 9 月 28 日 | 模型页 |
| 时间窗口 | 现在就能切;effort 档位经过重校准,切换前留出一轮自己工作负载上的评测时间 | 迁移指南 |
第三方路由平台上也已经能看到这个模型,标价 $2 / $10、上下文 1M、最大输出 128K,与官方一致。7
官方自测:一份十三行的对照
| 评测 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol | 来源 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0(agentic coding) | 70.6% | 10.3% | 66.4%(xhigh) | — | 公告 |
| FrontierCode 1.1 Main(agentic coding) | 52.1%(xhigh)/ 46.2%(max) | 42.4% | 54.4% | 49.3% | 公告 |
| CursorBench 4.0(agentic coding) | 55.5% | 34.1% | 57.8% | — | 公告 |
| GDPval-AA v2.1(知识工作,Elo) | 1844 | 1449 | 1846 | 1487 | 公告 |
| AA-Briefcase v1.1(长程知识工作,Elo) | 1811 | 1359 | 1822 | 1483 | 公告 |
| Humanity's Last Exam(带工具) | 64.5% | 54.9% | 67.7% | — | 公告 |
| OSWorld 2.1(computer use,partial) | 80.1% | 57.0% | 81.8% | — | 公告 |
| Chartography(无工具,图表识别) | 61.6% | 15.6% | 64.4% | 53.6% | 公告 |
| SWE-Bench Pro | 81.3% | 63.2% | 89.9% | — | 系统卡 |
| SWE-Bench Multilingual | 90.3% | 78.3% | 93.9% | — | 系统卡 |
| SWE-Bench Multimodal | 54.3% | 28.1% | 61.4% | — | 系统卡 |
| HealthBench Professional | 69.2% | 57.8% | 65.6% | — | 系统卡 |
| AutomationBench | 44.7% | 10.7% | 42.5% | 32.0% | 系统卡 |
读这张表有几处口径要先说清楚。系统卡的表 8.1.A 写明配置是自适应思考加
max effort、默认采样参数、跑五次取平均,竞品分数取自各家自己的系统卡或榜单。4公告那八项里,Terminal-Bench 4.0 与 CursorBench 4.0 的 GPT-6 Sol 一栏为空,官方脚注说 OpenAI 没有公开这两个成绩,因此改报 GPT-5.6 Sol 的分数,上表按公告的列名保留了空格。1两处结果和直觉相反。FrontierCode 上 Sonnet 5.5 的
max 档是 46.2%,低于 xhigh 档的 52.1%,官方解释是 max 档更常触发 Claude Code 的代码审查技能,把审查拆给多个子代理,两次运行因此超时或改动了任务范围外的代码,被这项评测扣了分。1HealthBench Professional 上它的 69.2% 高于 Opus 5.5 的 65.6%,是官方所说「少数例外」里的一处。4其中两项确实是第三方跑出来的。GDPval-AA v2.1 与 AA-Briefcase v1.1 由 Artificial Analysis 在 Sonnet 5.5 的预发布部署上执行,官方同时披露那次部署存在一个影响结构化输出请求的缺陷,并称该缺陷对分数的影响可能很小、方向上会让成绩偏低,缺陷此后已修复。1
省在哪、快在哪
成本下降来自两处,官方都给了可核对的对照。第一处是 token 数:官方引用的测试方里,Balyasny 在 2,441 条私有金融任务上测得 Sonnet 5.5 每次回答约 121k tokens,Sonnet 5 是 497k;Box 说它比上一代更准、快 2.4 倍、总 token 少 12%;Slack 的离线评测里少约 14% 输出 tokens;Lovable 的编码评测里工具调用少三分之一、shell 调用约为一半。1
第二处是 effort 档位。档位经过重校准,同一档在 Sonnet 5.5 上产生的思考量与 Sonnet 5 不同,官方要求重跑自己的档位扫描,而不是把旧设置直接搬过来;编码与多步工具调用从
medium 起、任务更难更长再升到 high,聊天这类看延迟的场景从 medium 或 low 起。5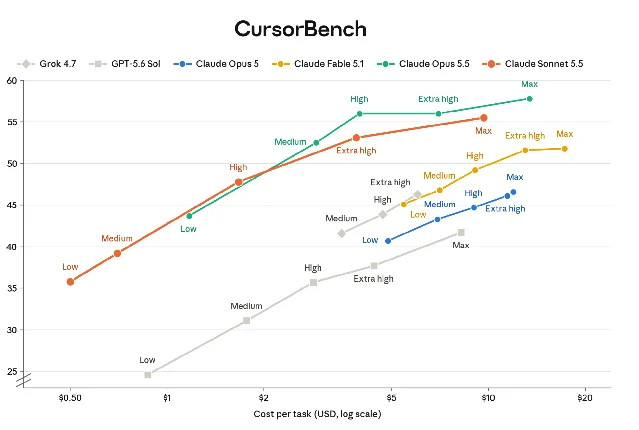
high 档 47.8%、xhigh 档 53.1% 约 $3.7,max 档 55.5% 约 $5。CursorBench 的分数由 Cursor 在其生产 agent harness 里端到端测量并公布,Sonnet 5.5 的每任务成本是 Anthropic 按 Cursor 给出的 token 数在标价下估算的;纵轴从 23% 起,差异在视觉上被放大。出自Claude Sonnet 5.5 System Card 第 115 页。迁移清单:五项会让 Sonnet 5 的代码报错
- 关思考的参数换了名字。 Sonnet 5 用
thinking: {"type": "disabled"}关掉前置思考;在 5.5 上传这个值会返回 400,最低档改成thinking: {"type": "between_tools"}。这一档只在low、medium、high三档可用,xhigh与max下会报错;它不接受display、budget_tokens、block_binding等其他字段。2 - 强制工具调用被拒。
tool_choice传{"type": "any"}或{"type": "tool", "name": "..."}会返回 400;改用{"type": "auto"},把工具标成strict: true,并在提示词里写明什么时候该用这个工具。5 - thinking block 绑定到模型与对话。 Sonnet 5.5 只读 Sonnet 5、Opus 4.8、Haiku 4.5 及更早模型写下的 block,它自己写的 block 也只有自己读得动;对话要保持只追加,改指令或改工具改用会话中途的 system 消息。对 2026 年 8 月 31 日 0 点之后创建的账户,这项检查在 Claude API、Amazon Bedrock 与 Google Cloud 上默认强制执行,改动过历史上文之后再回传 block 会返回 400。2
- computer use 换成工具集。 在 Claude API 与 Google Cloud 上,5.5 只接受
computer_toolset_20260801,传旧的computer_20251124会返回 400;同时要去掉fine-grained-tool-streaming-2025-05-14头,改成在工具上设eager_input_streaming: true。Amazon Bedrock 上仍然接受computer_20251124。5 - advisor 配对范围收窄。 Sonnet 5.5 做执行者时,顾问只接受 Opus 5、Opus 5.5、Sonnet 5.5、Fable 5 / 5.1、Mythos 5 / 5.1;拿 Opus 4.8、Opus 4.7 或 Sonnet 5 当顾问会返回 400,顾问给出的建议也以加密块返回,客户端读不到正文。5
还有一项变化不会让请求失败,但会让界面看起来像卡住:工具调用之间超过一两句的说明文字,现在以 thinking block 返回,默认
display 下这些 block 的文字为空,前端把这些说明流式展示给用户的应用会在工具调用之间安静下来。把 display 设成 "updates" 或 "summarized",或者改用 between_tools,文字就会回来。2两处容易漏掉的计量变化也一并列出。tokenizer 与 Sonnet 5 相同,同一段文字在两代之间 token 数一致,但相对 Sonnet 4.6、4.5 与 Haiku 4.5 会多出约 30%,换模型时要重新核对
max_tokens 与账单。5图像走高清档,长边最多 2576 像素、单图最多 4,784 个视觉 token,一张 2000×1500 的图大约是 Sonnet 4.5 的 2.5 倍 token。5顺带多出来的能力里,三项值得记一笔:按需压缩(beta 头
compact-2026-09-04)、在会话中途的消息里直接定义工具(inline-tools-2026-09-15)、以及按消息调整 effort 与会话中途换 system 消息。最小可缓存提示从 Sonnet 5 的 1024 tokens 降到 512 tokens。2安全与护栏
Sonnet 5.5 是第一个带着 Opus 级网络护栏与回退上线的 Sonnet:它的网络能力接近 Opus 5,官方判定高风险网络安全请求会可见地回退到 Sonnet 5,常规的找 bug 与修 bug 不受影响;生物护栏与 Sonnet 5 维持同一套。1
被拒绝的请求会返回
stop_reason: "refusal",并在 stop_details 里给出五个分类之一:cyber、bio、frontier_llm、reasoning_extraction、general_harms。服务端回退(fallbacks: "default",beta,仅 Claude API)只重试 cyber 与 frontier_llm 两类,另外三类要把重试逻辑写在自己这边。5反蒸馏上,它是第一个带上「推理抽取」防护分类器的 Sonnet,同时把 preserved thinking 扩到账户绑定:它产出的 thinking block 只在产出它的账户或与之关联的账户里可用,别的账户传进来会被丢弃,请求本身仍然成功。1系统卡的责任扩展政策评估结论是,Sonnet 5.5 各方向能力均低于 Opus 5.5,没有越过新的阈值;约 1,850 个场景的自动化行为审计里,它在试探容器边界与擅自联系第三方这两项上是所测模型里最少的一个,同时系统卡写明,没有任何一套评测能可靠覆盖全部失败模式。4
该不该试:三条能自己核对的判断
- 手上是范围明确的编码、文书与表格流。 收益来自每任务成本与出字速度,判断标准是你自己的工作负载:把同一批任务在 Sonnet 5 与 5.5 上各跑一遍,并按各自最优的 effort 档位比总成本,官方给出的 30% 是按它自己的负载算的。1
- 需要长时间判断、开放式、跨多轮的活。 官方与外部测试者的共同结论是 Opus 5.5 在这一类上仍然明显更强,Sonnet 5.5 的价值在更低的档位上有更低的每任务成本。1
- 线上已经用着 Sonnet 5 且关过思考、用过强制工具调用。 这两类写法在 5.5 上是硬错误,会让请求直接返回 400,切模型之前先按迁移清单改代码,再灰度。5
还没有的数字
- 独立智能指数。 Artificial Analysis 的榜单页本次核验时没有 Sonnet 5.5 条目,Sonnet 5 的六个档位在榜,因此「比 Sonnet 5 强多少」目前只有厂商自测这一个口径;同页收录了 Opus 5.5 各档、GPT-6 Sol、Grok 4.7 等对照项。6
- 参数规模。 官方未披露。3
- 发布当天的第三方复测。 截至本期发稿,还没有可引用的独立复测或媒体评测,公告里引用的第三方都是参与早期测试的客户,结论由各自公司给出。1
- 每任务成本的口径。 系统卡第 115 页的每任务成本是 Anthropic 按 Cursor 给出的 token 数在标价下估算的,不属于 Cursor 报出的实测账单;这份图里的分数由 Cursor 端到端测量。4
- 公告对照表里的两处空格。 GPT-6 Sol 在 Terminal-Bench 4.0 与 CursorBench 4.0 上没有公开成绩;Opus 5.5 的 Terminal-Bench 成绩注明取自
xhigh档,也就是它的最高分。1
References
- 1Introducing Claude Sonnet 5.5
anthropic.com
- 2What's new in Claude Sonnet 5.5
platform.claude.com
- 3Claude Sonnet 5.5 模型页
platform.claude.com
- 4Claude Sonnet 5.5 System Card
anthropic.com
- 5迁移指南
platform.claude.com
- 6Artificial Analysis LLM 榜单
artificialanalysis.ai
- 7Anthropic: Claude Sonnet 5.5(OpenRouter)
openrouter.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.