Claude给391行代码找Bug,狂写1.8亿行证明!首次大规模汇编层形式化验证
Anthropic 与 Theorem 让 Claude 在 RISC-V 汇编层为 123 个开源库写下约 1.8 亿行机器检查的证明;本文拆开它证了什么、边界在哪,以及想自己跑一遍该从哪儿进。

本文转载自微信公众号「量子位」2026 年 10 月 23 日 21:47 推送,作者:henry(发自 凹非寺 量子位 | 公众号 QbitAI)。原文:《Claude 给 391 行代码找 Bug,狂写 1.8 亿行证明!首次大规模汇编层形式化验证》
10 月 22 日,Anthropic 和 Theorem 发了一篇研究:Claude 在几周里,给 123 个开源库的 239 个测试入口写完了形式化证明1。
产出的证明代码约 1.8 亿行,全部通过了机器检查1。
这些证明说的是同一件事:在约定的范围内,这些程序收到任何输入都不会崩1。
范围写得明确:输入不超过 64MB,环境是单线程、静态链接的 RISC-V 二进制,跑在 Linux 上1。
团队的说法是「据我们所知,这是第一次用 AI 在汇编这一层,对生产软件做这么大规模的验证」1。
形式化验证这件事以前有人做过,代价摆在那里:seL4 微内核写代码用了两个人年,证明它用了二十年人年1。
那 1.8 亿行究竟证了什么,边界划在哪里,想自己跑一遍又该从哪儿进,得拆开看。
一、把「不会崩」写成一道题
形式化验证的第一步是写规格(spec):先把「正确」定义清楚。
PNG 解码器有现成的标准可依(RFC 2083),文本编辑器、浏览器这类程序就说不清了1。
这批库的规格,来自它们早就有的模糊测试入口1。
开发者在库里留了一个入口,喂进去任何让程序崩的输入都算 bug。把「这个入口永远不崩」写成命题,规格就有了1。
Claude 证的就是这条命题:64MB 以下的任何输入,都不会让程序因内存安全错误或断言失败而中断1。
规模可以横向比。中位数二进制约 18,000 条 RISC-V 指令,一份典型证明约 60 万行 Rocq、1,400 个文件2。
账还有另一头。Claude 在尝试中一共写了约 10 亿行,最后约 1.8 亿行进到了通过检查的证明里2。
一份证明能长到 60 万行,是因为每次都要把 C 运行时、分配器、printf、ASan 运行时和 fuzz driver 重新证一遍2。
cJSON 那个 391 行的解析入口,拿到了 63 万行证明,其中只有约十分之一跟 cJSON 本身有关。51,000 行代码的 fftw3,证明是 48 万行2。
二、fuzz test 是怎么变成证明题的
找软件里的内存安全 bug,主要靠模糊测试(fuzzing):给入口喂海量随机和变异的输入,喂崩了就算找到1。
它的局限在覆盖:试过的路径有结论,没试到的分支仍然开着口子1。
这次的做法把问题倒过来问:与其喂到崩,干脆证明不会崩1。
流程分四步。源码连同 fuzz test 编译成 RISC-V 可执行文件,Theorem 的指令集与 Linux 进程语义再把它变成数学模型1。
接着 Claude 写证明,Rocq 内核逐条核验1。
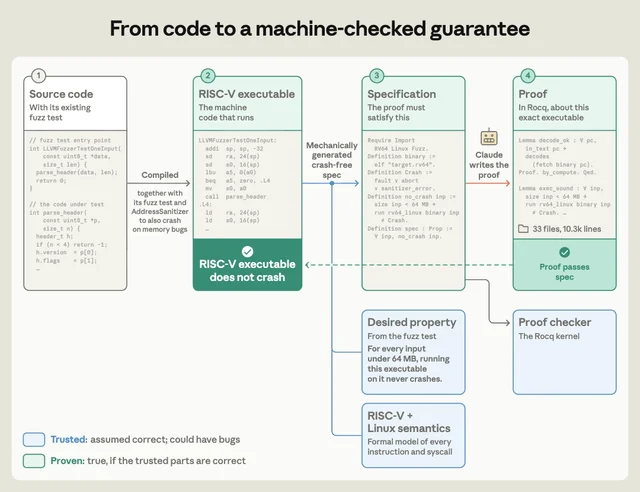
检查一份证明也慢,要 30 分钟到几个小时的 CPU 时间2。
三、证明的过程中挖出了几百个 bug
证不下去的时候,通常意味着真有 bug。团队干脆让 Claude 边证边修1。
一个解压器里,计数器算错会让程序写到分配好的内存外面。触发它需要约 20MB、排布特殊的一份输入1。
模糊测试习惯把输入压在 1MB 以内,这份数据它撞不上1。
同类发现还有几个:图像解码器的越界读,要 64MB 输入和 2GB 以上内存1。
libexpat 的 CVE-2026-56132 被重新发现,另有一个从不崩溃、却让文件加载限制失效的逻辑 bug1。
让 Claude 自己动手修,要防一件事:把程序改成「平凡地不会崩」,证明自然就过了1。
团队的对策是给每次改代码扣分,给「证明改了哪些输入、改了几条」加分,并逐条审计补丁1。
证明和测试的差距,有个实验量得很清楚:往一个 Python 解释器里注入 7 个 bug,随机测试抓到 2 个,证明 7 个全破2。
四、一份证明要烧多少 token
成本是这套方法眼下最大的门槛。
研究里设了 36 个小型验证任务,每个任务给单智能体 5M token 预算,三次独立尝试,任一次完成即计入1。
Opus 5.5 证完其中一半,比 Opus 5 少用约 40% 的 token1。
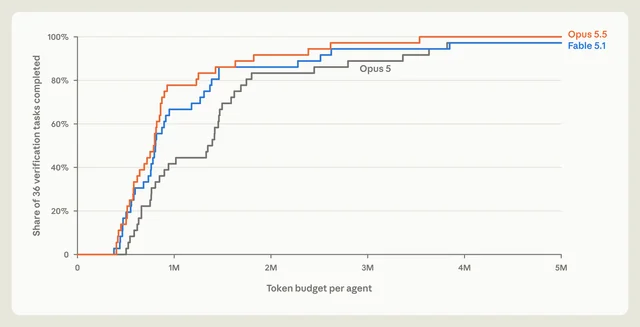
另一笔省下来的是复用。让智能体互相借鉴已经证好的部分,同一组任务少用 17% 的 token,有的任务单干失败、共享工作区之后成功1。
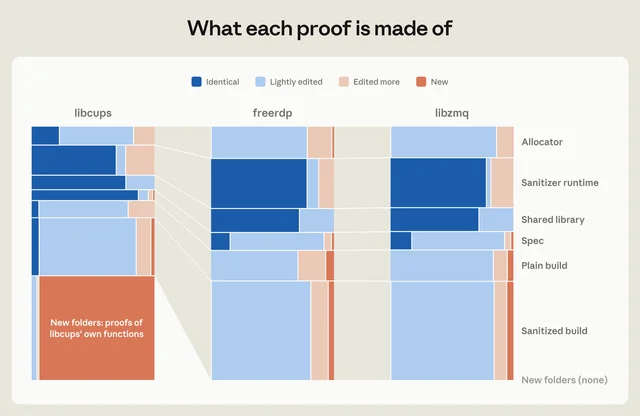
Theorem 把这条路推到包一级:依赖呈幂律分布,先证 glibc、OpenSSL、cURL 这些底座,上层大量软件就跟着受益1。
五、这些证明没有说什么
「已经证明过」这几个字,能放心到什么程度?
证明检查器能确认的,是证明满足了规格;规格本身跟现实对不对得上,它管不了1。
差距落在两处。证的是单线程、静态链接 musl 的 RISC-V 二进制,多数人跑的是 x86 或 ARM、动态链接 glibc1。
另一处在覆盖:ASan 抓不到所有内存安全问题,死代码不在任何入口的范围里,调用方自己用错造成的内存破坏也不在内1。
所以整套东西里,需要你信任的只剩三样:指令集与 Linux 进程模型、被证的那条定理陈述、Rocq 检查器本身1。
其中模型这一环,Theorem 自己在仓库里写明「尽力而为、并不完整」:它只描述了 Linux 的一部分,还带着未经检查的假设3。
公开范围也标出了这个分寸:一共做了 123 个库、239 个入口,公开的是 25 个库、60 个入口3。
官方给的理由之一,是可能暴露尚未修补漏洞的证明不予公开1。
看到「已证明」三个字,该追问的是:证的是哪条性质,在什么假设下,覆盖了哪些代码。
六、想自己跑一遍,从哪儿进
证明和语义模型都放在 GitHub 上,公开的那部分用 Rocq 9.2.0 检查过3。
命题写在一个叫 LPS 的模型里,它就是那套「Linux 进程跑 RISC-V 二进制」的形式化描述3。
Theorem 另外开了个 OSS Verify 项目,对符合条件的开源项目免费4。
报名方式和 OSS-Fuzz 一样:往仓库提一个目录,写 project.yaml、Dockerfile、build.sh4。
门槛在构建:要求静态 riscv64 二进制,现成的项目可能要移植;替项目报名的人得是核心维护者4。
有一点要提前知道:发现和补丁由 AI 生成,官方不承诺送出去之前有人复核,也不设披露期限4。
官方还放了一个 Claude skill,用来给新项目做初始化1。
研究文里那句话说得直接:鼓励所有人去试,尤其是那些以前用能力弱的模型试过、没成的人1。
七、为什么是现在
攻击端同样在提速。
10 月 21 日,微软披露攻击组织 Storm-0940 用一个叫 ARTEX 的智能体框架,把 ConnectWise 的供应链攻击自动化了5。
登录尝试的峰值达到每分钟 2,900 次,仅 10 月 11 日一天就有 11 万次失败登录6。
在多个案例里,从选定目标到拿到云端特权不到 3 小时6。
防守这一侧,Anthropic 在文末承认:找到漏洞之后,确认和修复依然很难;电网、水务、工厂里的设备,没法来一句「更新完成,请重启」1。
证明改变的是另一件事:把「这一类崩溃不会发生」写成一份机器能检查的交代。
八、原文里的几句话
Claude 这家伙,也是把 debug,玩成扫雷硬解了。
这就像在软件里扫雷,扫完还得写份报告,交代清楚:为什么这里没雷?
只要它还能让程序出错,那份「不会出错」的证明就无法成立。
团队还得先为指令和运行环境建立数学模型,再让 Claude 在模型里证明安全要求。
原文开头那句「扫雷」,比任何术语都更贴近这套流程:它要的是一份「这里为什么没雷」的报告。
如果你的项目挂在 OSS-Fuzz 上,可以先翻一遍那 25 个库的清单,看有没有你依赖的。
再看构建是不是静态 riscv64,就知道能不能排队等一份证明。
References
- 1
- 2
- 3GitHub:theorem-labs/oss-verify-proofs
github.com
- 4Theorem:OSS Verify
theorem.dev
- 5
- 6
- 7
- 8
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.