E253|谁在给大模型出题、卖题、判卷:数据公司卖什么、榜单能不能信、专家数据怎么验:完整逐字稿和精华摘要
基于《硅谷101》E253 的完整音频,整理 Scale AI 研究总监何允中与伯克利 ALE 研究者孙一铀对数据公司分类、Rubric 与强化学习环境、榜单与刷榜、SWE-bench Verified 争议、专家数据验证与行业下一步的完整对谈,附按说话人分段的完整逐字稿。

《硅谷 101》第 253 期在 2026 年 9 月 28 日 10:30(北京时间)上线,这一期聊 AI 数据行业。主播是硅谷 101 主持人 Yiwen,嘉宾有两位:Scale AI 研究总监何允中,负责后训练与评测研究;加州大学伯克利分校博士后孙一铀,Agents' Last Exam 评测项目的研究者。1 完整音频长 58 分 04 秒,原始入口是官方 RSS,视频版发布在硅谷 101 播客的 YouTube 频道。
赞助关系需要先说明:这一期由科沃斯赞助播出,节目开头有一段品牌口播(约 02:26—03:32)。1 两位嘉宾跟这个品牌没有关系,他们分别站在数据供应商和学术界两侧。何允中在开场声明,他讲的是个人观点,不代表 Scale AI,也跟客户无关(约 04:23)。
节目从一个正在变热的市场开场。主播 Yiwen 报了几个数字:AfterQuery 今年 4 月宣布 A 轮融资时估值 3 亿美元,到了 9 月,新一轮融资把它的估值推到 32 亿美元,不到半年涨了十倍,创下 YC 系公司从启动到成为独角兽的最快纪录(约 00:24—00:45)。这条线在公开报道里能核到:AfterQuery 2025 年 2 月成立于旧金山,入选 YC 2025 年冬季批次;2026 年 4 月完成由 Altos Ventures 领投的 3000 万美元 A 轮,投后估值 3 亿美元;2026 年 9 月 2 日,《福布斯》援引两名知情人士称它估值已达 32 亿美元,公司已经实现盈利。2
有三处口径可以对照。主播说 AfterQuery 由三名二十多岁的年轻人创办,公开报道里写到的是两位联合创始人——23 岁的斯宾塞·马蒂加(Spencer Mateega)和 22 岁的卡洛斯·乔治斯库(Carlos Georgescu)。2 节目说 Scale AI 在 Meta 入股时估值超过 290 亿美元,这一条对得上:2025 年 6 月,Meta 以约 148 亿美元获得 Scale AI 49% 的无投票权股份,公司估值达到 290 亿美元。3 节目说 Mercor 去年 10 月这轮融资估值达到 100 亿美元,也对得上;到 2026 年 8 月,《The Information》报道英伟达正洽谈参与 Mercor 新一轮融资,若这轮完成,Mercor 的估值会翻倍到 200 亿美元。4
摆出这些估值之后,主播把这一期的问题说了出来:这些高估值背后的数据生意到底怎么做,这些公司究竟在卖什么,模型公司又为什么愿意给这么多钱(约 01:00—01:12)。
这期节目讲了什么
主播在开场先给出了一个三段式的答案(约 00:12—02:20)。最早的数据生意是人工标注,给图片打标签、给模型的回答打分;后来数据公司要请行业专家把工作经验变成模型能学的任务,其中一类是让专家写清楚一份答案或一份工作成果满足哪些条件才算好,也就是 Rubric;再往前一步,数据公司要搭出让 AI 动手的环境,配上任务、工具和反馈机制,让模型在里面操作软件、反复尝试、按结果学习,这就是强化学习环境(RL Environment)。
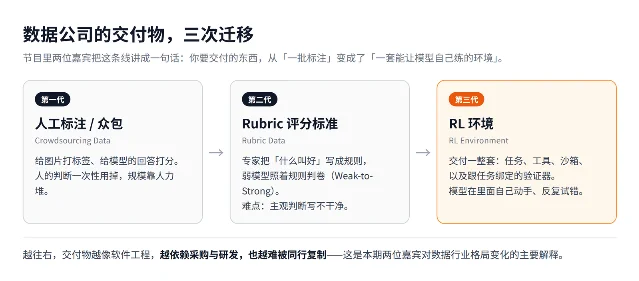
这张图是我们根据节目里两位嘉宾的表述自制的,不是外部证据。图上出现的英文术语节目里都说过:Crowdsourcing Data、Rubric Data、RL Environment、Weak-to-Strong。
按两位嘉宾的说法,这条线上真正在变的是"交付物"。何允中说,一年多前他在 Scale 做的是 Rubric Data,那时候这个概念还比较新;现在 Rubric 听起来已经过时,大家都在讲 RL Environment(约 08:19—08:36)。孙一铀在节目里把这段变化归纳成一个方向:把 vibe coding 的势头推广到 vibe everything(约 12:40)。
数据公司分成几类。 何允中按出身分了几种:有招聘出身的,比如 Mercor 和 Handshake;有从众包网络长出来的,比如 Scale;有做合成数据的;还有垂直行业的公司转行做数据。他也提到了一些更小的角色,比如手里握着大量版权数据、知道怎么把它卖出去的中间人(约 05:15—06:54)。几位大玩家——Mercor、Surge、Scale——什么都想覆盖;像 Bespoke 这类新秀偏研究和工程,主要生产代码一类的环境;还有一些团队专门做垂直领域,由领域专家组成(约 06:13—06:44)。Bespoke Labs 在 2026 年 7 月宣布,种子轮与 A 轮合计融到 4000 万美元,A 轮由 Wing VC 领投,公司做的正是训练智能体的环境。5
招聘型公司与众包型公司的取舍。 何允中把这两条路讲成了一组权衡:自己全职养的人能力强,但灵活度差;更多依赖众包网络,灵活度大,每个人的质量就难保障。质检因此成了核心竞争力。他说 Scale 的优势在于积累了一套质检经验,既用在数据上,也用在人上(约 07:10—07:48)。
模型需要的数据为什么变了。 孙一铀给出的是技术上的原因:过去两年里,预训练仍然是重要的,但圈子里的人把兴趣挪到了强化学习上,因为 O 系列模型让推理这条路跑通了。强化学习需要一个可验证的信号,而这个信号在数学和代码上最好拿——选择题对错、一个数字算出来,检查起来很容易(约 09:36—10:04)。到了医疗、金融、指令遵循这类领域,客观答案就没有那么好定义了。
Rubric 是怎么工作的。 何允中用考试打比方:历史考题是有标答的,但每个人的写法不一样,机器很难直接做模式匹配;于是让助教拿着教授写好的打分规则来给分,因为规则是提前标好的,助教不必特别聪明。这套思路在大模型数据里的名字叫 Weak-to-Strong——用一个弱模型去监督强模型,成立的条件是专家已经把他脑子里的知识写下来了(约 10:26—10:49)。他说这套做法火了很长一段时间,现在仍然重要,只是各个专家领域的 Rubric 被收得比较快、比较干净了(约 10:55—11:08)。
从"判卷"走到"动手"。 何允中说,继续往前就需要模型自己动手:给一些工具,设计更复杂的验证方式。除了 Rubric 和程序化检查(programmatic check),还有让人来选偏好的方式,行业里目前没有形成大的共识,有点像当年 Rubric 时代每家要的都不一样——比如 Terminal Bench 就不要 Rubric,纯用程序化验证(约 11:08—12:12)。
两位嘉宾在 Rubric 上有分歧。 何允中认为 Rubric 这一块差不多做到头了,他后来解释这是指行业趋势:静态的、单轮或多轮对话出一个文本、再用 Rubric 检查它的这类纯知识数据,需求比过去小了一些(约 12:24—14:10)。孙一铀的看法相反,他认为专家主观判断这一块远远没有做够,很多领域的训练还远没到头(约 12:29—14:10)。
主观判断能不能被量化。 孙一铀举了工程产出的例子:除非把输入固定得特别死,否则输出有非常多种可能,让它生成一个游戏、甚至某些数学解法都不是唯一的;这时候用确定性评判去比对标准答案,经常对不上。他给了一个想法:游戏好不好玩、作品好不好看,人类没法直接固化成可量化的指标,但游戏设计的教科书里有奖励曲线是否平滑、是否符合多巴胺机制这类科学指标,说明原则上能量化,只是需要更深的专家参与,而他目前在公开的 benchmark 里还没有看到完整的一套(约 14:16—15:33)。何允中接着讲了验证体系的总思路:大家希望模型变强,验证器也跟着变强,验证器强了,Rubric 就可以写得越来越模糊,把更多知识交给验证器;前提是 Rubric 加验证器的知识和能力总量要超过被训练的模型。他用生图举例:图里有没有猫、背景板上写的字对不对,可以写成 Rubric、甚至跑一遍 OCR 去查;"猫可不可爱"很主观,就得专门训一个掌握了人类主观体验的模型,最后大概率是两者结合(约 15:43—17:45)。
环境与 Rubric 拆不开。 孙一铀说,环境或任务数据只是执行的基准,Rubric 才是最后用来打分、奖励模型做得好不好的东西,两者必须合在一起看。他更愿意从任务分类的角度切入,看人和 Agent 各担任什么角色:早期用 Cursor 的时候,人写代码、Agent 只负责很小的模块;Agent 强了以后,人给一个模糊的指引,它能完成一个大项目;现在的分工大致是人负责决策、Agent 负责执行,人把决策说得越清楚,Agent 做得越好。他还指出,决策这部分很难交给模型:猫可不可爱可以训一个验证器,但一家上市公司领导层的决策每天在变,很难收集到足够的数据去训出替代它的奖励模型(约 17:54—19:36)。何允中补了一个收数据的思路:像 ALE 这样让专家把做过的事情和当时的决策交上来,是一个方案;未来收数据的关键,是找到好的激励方式,让大家愿意把重要的东西交出来(约 19:49—20:11)。
评测和卖数据是两件事。 何允中说,评测体现的是模型离我们想要的理想状态还有多远,本身是科研的基准;但造 benchmark 的人往往对那个领域认识更深,天然就有了卖数据的权威性,大家会比较相信他手上的数据,生意于是长了出来。他还提醒这个生态"水比较深":有多少人在做科学、多少人在做 benchmark,值得仔细权衡(约 20:42—22:10)。孙一铀在这里敲了一记警钟:他私下听说有数据公司踩了红线,把自己做评测用的数据卖了出去;他的判断是 benchmark 面向未来、数据面向现在,做生意的不能污染自己做评测用的那套东西,否则既毁了自己的 benchmark,也毁了别人的模型。他同时说 benchmark maxing 也可以是个好词,前提是刷的榜有意义,而且那个榜足够贴近真实用户的体验(约 22:10—23:34)。他回忆 ALE 在今年 1、2 月做的时候,很担心题出得太难会让评测失去意义,因为当时模型平均分只有 10% 到 20%,很多题目直接拿零分;后来他们想通了,benchmark 本来就是面向未来的模型做的(约 22:49—23:10)。
什么样的 benchmark 才值得看。 何允中的答案分两层:一层是它有没有体现某个具体能力的缺陷,另一层是它测的场景是不是大家在意的。他说一个人蹲在街角旮旯解开一道很奇怪的智力题,这样的题刷出来的提升,反映的往往只是这个场景里的知识;而像个人助理这类大家都想要的场景,benchmark 甚至测的不只是模型,还包括外层的 harness,最后告诉你的可能是"我的 harness 错在哪",这种也是好 benchmark(约 24:46—26:03)。孙一铀把讨论引到了"分布"上:Artificial Analysis 这类体系做的事情就是给各家 benchmark 不同权重、综合成一个分数,但权重本身是不是大家需要的权重、以什么方式迭代,都很主观,所以被质疑的常常是榜单而不是模型。他观察到厉害的模型厂商倾向于自建评测体系,让它更接近自己心目中的分布,第三方榜单主要让对外发布更有说服力(约 26:08—27:10)。他还提到一类 benchmark 曾经声称能测智能:让 Agent 去玩 ARC 这样的小游戏,结果发现这种智力也可以被特化,一个小模型就能刷出来(约 27:13—27:28)。
没上榜单的评测也在被用。 何允中举了 Scale 自己的例子:前一阵子做的 Drug Discovery,以及跟 AI Tutor 相关的评测,都很垂直、不常出现在公开榜单上,但各家实验室负责相关领域的团队会专门把对口的评测收回去看(约 28:00—28:17)。他还讲了一件更随机的事:Scale 做过一套软件工程评测 SWE Atlas,包含代码仓库问答、代码重构和写测试三个部分,是分三个阶段推出的;问答先推出,还没来得及把另外两个合进去,就被 Artificial Analysis 收了,需求突然变大。他说问答其实是里面最简单的场景,"我们花了那么多心血做更复杂的 benchmark,结果因为时间关系,就先上了"(约 28:17—29:21)。6
理想中的分布长什么样。 孙一铀说,真实的分布本质上就是用户的体验,世界上如果存在这样一个基准,它有点像 LM Arena 的模式——同一个问题让多个模型一起去执行,再让人打分。但 Agent 时代一个长程任务动辄几个小时,用户也没有精力每次开着几个 Agent 一起跑,更没有机制把这些反馈收集起来,所以很难拿到真正的基准(约 29:34—30:28)。何允中补充了线上的一面:他听到不少例子,评测 benchmark 和线上 AB test 测出来的结果不一样,用户的反馈和评测有时候也对不上,甚至很难说哪个更好(约 30:41—31:07)。
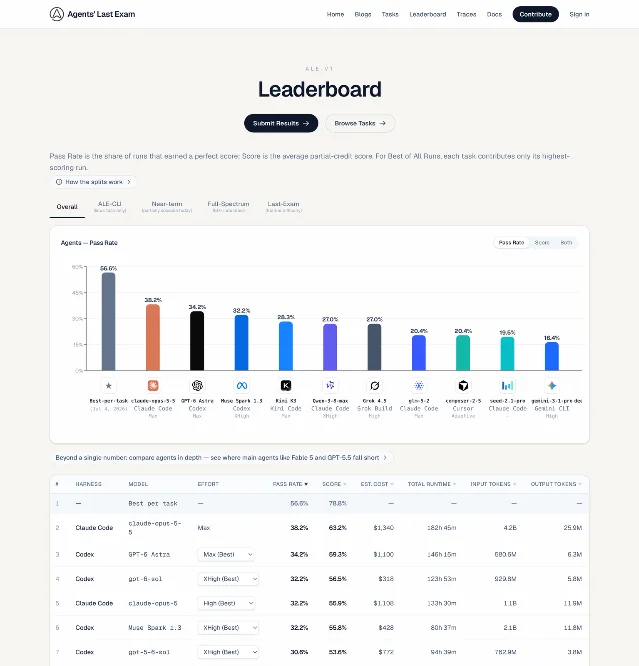
孙一铀在节目里介绍过这个评测的来历:Agents' Last Exam 由 Berkeley RDI 和 300 多位行业专家共同主导,目标是构建覆盖面最广的智能体评测基准,衡量智能体在长期、有经济价值、结果可验证的任务上表现如何;第一版公开的任务有 150 多个,覆盖 50 多个细分行业,下一次发布计划放出 1000 多个任务(约 04:44—05:02)。官方站点上的口径更大一些:目前已收集 1500 多个任务,目标是 5000 个,覆盖全部 55 个目标子行业。7 这条线也有论文:第一作者 Yiyou Sun,2026 年 6 月 3 日提交到 arXiv,任务参照 O*NET / SOC 2018 分为 55 个子领域、13 个行业集群。8
模型公司还看榜单吗。 孙一铀说,外部评价他们肯定在乎:美国几家大厂有能力,倾向于自建评测为主;刚成立或者不在头部的实验室内部评测团队没那么完善,会更依赖外部评测。何允中给的是另一个时间尺度:产品成熟、用户体量上来之后,公司最后关心的是用户增长,会朝"哪些指标跟 DAU 增长最相关"去走;但科学发现这类场景不可能找到足够多的科学家做出显著的 AB test,仍然要靠造 benchmark 来当评价标准(约 31:12—33:30)。
采购买不到的东西,才是卡点。 何允中把后训练数据拆成采购和加工两件事,真正变难的是采购。代码领域要去买私域代码仓库;做芯片设计,得把整个设计环境造出来,中间涉及商业软件,怎么把版权拿到并包进去是个问题;做 DevOps,有一个公司专门做了一整套 AWS 模拟器。他觉得这些小公司抓住一两个垂类做深,就创造出了新的机会(约 33:52—36:07)。孙一铀补充了另一种贵法:ALE 在第二版里尝试收数据,一个名不见经传、几千人体量的手机游戏,源码报价能要到两三百万人民币一条,"哪家数据公司或者做 benchmark 都没有这个财力";何允中接了一句,游戏视频同样是版权数据,采购是个巨大的问题,现在有不少创业公司在专门解决它(约 36:59—37:33)。医疗数据被何允中列为最敏感的品类之一:谁能拿到病例数据,就非常有优势(约 37:42)。
垂类里还有大片空白。 孙一铀说,ALE 团队统计过市面上已有的生命科学和生物医药 benchmark 覆盖了多少,结果大概连 10%、5% 都不到,连一个覆盖面完整的 benchmark 都还没有,更不用说针对它去做数据(约 38:38—39:02)。
合成数据公司的窗口期有多长。 何允中认为需求现在仍然很大,但这一波 coding 做完,公司要抓住下一个品类;下一个机会的运行模式可能跟今天不一样,采购能力弱的会比较难。孙一铀举了数学当反例:以前影印奥数课本就能批量造出数据,这些数据现在"基本上是零价值"(约 39:08—40:14)。
门槛会不会越来越高。 何允中的回答分两面:从第一性上讲,还有巨量的问题没有被解决,这是巨大的机会;只看手上已有的活,一定是越来越难做,玩家越来越多,利润越来越薄。他觉得一个好的数据公司最后解决的是研发问题,像软件公司一样提前投入大家未来需要的东西,赚到钱再投下一个(约 40:23—40:55)。
"实验室未必有最好的基因解决数据问题。" 何允中管这叫暴论,理由有几条。合成数据按理说是各家后训练团队的本职工作,买数据、核数据、验证数据、洗数据占掉了他们大部分时间,可外面懂行的人把数据合完再卖回去这件事依然在发生。更长远的理由是利益冲突:一家实验室一边把工程师派到企业里,一边有一拨人在处理企业数据,企业会不放心把数据交出去,所以采购这件事可能需要第三方。第三是时间尺度:实验室的交付时间卡得很死,一个研究员不太可能有半年去啃一个行业;数据公司把某个行业搞清楚、把问题做成 benchmark 或数据、再证明有效,转手卖给实验室,那就会有市场(约 40:55—43:28)。
同一份数据卖给多家怎么办。 何允中给的答案很直接:通常可以多花点钱把数据买断(约 43:58—44:12)。
数据买回来之后怎么用。 何允中说这里有相对固定的训练配方(training recipe):简单数据直接做 SFT,把对的答案给它;Rubric 那一类拿去做强化学习,因为一直有模型在打分;到了 RL 环境,尤其今年在卷的长程任务,训练方式开始变得模糊,行业里还没有太多共识。他提到今年的一个主题词叫 RSI,也就是递归自我改进(Recursive Self-improvement),有些任务跑一把要几天甚至一个星期(约 44:18—45:12)。
造环境最怕什么。 何允中的回答是奖励投机(Reward Hack):模型没有完成任务,却通过做手脚把分打得很高,训下去只会得到一个耍滑头的模型。业界的做法之一是让比较强的模型去做红队,试着在任务里找捷径。他还提到一个容易被忽略的维度:很多 benchmark 只关心任务有没有完成,验证器也围绕这个设计,但"怎么完成"在训练里同样关键——比如消耗了多少 token、用了多少步。最后是在多个维度上检查奖励、防止作弊,这些加起来才算一个完整的训练配方(约 45:48—47:03)。
数据要按模型的口味定制。 何允中说,最常见的定制是难度:做 benchmark 时通常希望它别太饱和,越难越好,但训练用的数据要适配到模型恰好吃得下的区间——题目太难,模型什么都试不出来;太简单,又学不到东西。他提到一种很具体的合作方式:模型厂商会把还没发布的模型给数据公司,让对方帮忙筛数据。另一种是轨迹采集:把模型的解题轨迹收集起来做筛选,甚至找人写出可解的轨迹,客户拿回去不用做强化学习,直接拿轨迹做 SFT(约 47:18—48:31)。
SWE-bench Verified 为什么被弃用。 主播转述了 OpenAI 在 2026 年 2 月的说明:这是一套让 AI 修复真实开源项目问题、再跑测试判断有没有修好的评测,被点出的问题有两类,一类是测试本身有缺陷,功能上正确的解法也可能被判错;另一类是数据污染,在特定提示下模型能复现部分题目原本的人类修复代码,说明它在训练时很可能见过相关内容(约 48:31—49:11)。这条公开说明的日期是 2026 年 2 月 23 日,OpenAI 审计了 138 个 o3 在 64 次独立运行中都无法稳定解决的问题,发现其中 59.4% 存在测试设计或问题描述上的重大缺陷(35.5% 属于"窄测试"、18.8% 属于"宽测试"、5.1% 属于其他问题),并且建议其他模型开发者改报 SWE-bench Pro。9 何允中对"污染"这个词做了区分:SWE-bench 这类数据有一个可能跟污染无关的问题,就是任务本身没做好——测试脚本要求得太多,或者题目没讲清楚;真正意义上的污染是训练时把题目和答案都训进去了,这类问题有技术手段可以检测(约 49:17—49:40)。孙一铀补了一个数字:他印象里这个 benchmark 在过去六个月里只从 74% 提到 80%,剩下的 20% 集中在脚本写得太苛刻或者题目本身就不可解上,那么它作为对比基准的意义就失去了(约 49:59—50:14)。
专家交上来的数据会不会是编的。 孙一铀说这件事真实发生过:ALE 的奖励机制是提交被接纳就能进入作者名单,于是有人为了提交而提交,用 Agent 合成了一堆数据,甚至肉眼就能看出是编的,对他们的工作造成了很大困扰(约 50:14—50:47)。何允中说,奖励机制本身是个特别难的问题:更原始的做法是按小时付钱,也一样有人偷懒作弊。他把目标说成"把人类的经验蒸馏干净",然后反问怎么设计一套好的机制把大家的目标对齐——在他看来这是个巨大的研究领域,他心里的一个方案是工作量证明(proof of work):要求把做这件事的完整工作流程录下来,必须达到一定时长,不同形式的问题配不同的奖励和验证机制(约 50:47—51:45)。孙一铀把最难的部分指向"编造":公开数据的污染相对好检测,直接问 Agent 就能找出一些;最难的是有人根本没跑过任务,编出一套看上去很真的结果,一个化学模拟看上去很真,可能几个月都查不出来;要等到所有 Agent 的能力都远超这道题、发现它们的答案彼此一致却和真实答案不一致,问题才会暴露,这个周期非常长。而请另一位专家来验证的成本极高,因为专家自己做这道题就要花一两个礼拜——那位验证的专家也可能为了省事说它是对的。他说众包的 benchmark 为什么难做就难在这里(约 51:49—52:57)。
真实工作流数据长什么样。 孙一铀本来想问这个话题,听完之后发现大家卷的还是编码数据:他的理解是 Mercor 这类公司在卖真实工作流数据,但赛道里最卷的仍是 coding。他自己的判断是,真实工作流数据本质上都能被归到编码问题上——比如三维建模,FreeCAD 这类软件提供了现成的 API,他把这跟传统意义上写一段代码解一道题的编码区分开:这是用编码去解决真实工作流;只要有足够的 MCP 接口可以调用,95% 以上的任务都能归到编码上(约 53:15—53:43)。何允中的说法更松一些:可以看任务本身要什么、涉及哪些环节,再把它归到不同领域的工作流去(约 53:53)。
行业的下一步是不是并购。 何允中说他不评论 Scale AI,他听说有一块很大的私募股权生意:过去大家买公司,然后用 AI 提效、把价值做上去再卖掉;现在多了一层,把公司的数据也发掘出来卖钱,于是传统做私募股权的公司也开始研究数据怎么卖(约 54:16—55:12)。
什么信号说明一个赛道能持续长。 何允中的答案是没有解决的问题还很多、玩家越来越多、饼在变大;但这门生意要求数据公司不停地迭代,最后拼的是能不能把研发能力本身固化下来,做成一条能持续发掘新东西的流水线(约 55:31—56:33)。孙一铀听到的说法是,数据公司的估值空间一般没有传统公司大,因为杠杆很难保持住:模型迭代太快,领导者必须持续想下一步在哪里(约 56:09—56:28)。
ALE 第二版最难的地方在采购和激励。 孙一铀说学术上相对容易一些,因为专家给他们的数据很多是无偿的;如果换成一家数据公司去收这些原始项目和代码,都是天文数字,而且很难找到好的激励机制让专家自愿交上来。他拿 Mercor 官网给专家的小时价举例:制造业工程师大概一两百美元一小时,这个价格决定了它招不到特别高级的工程师;学术项目能吸引到更高级别的人,因为他们图的是名(约 56:39—57:21)。
嘉宾的几个判断
数据公司的出身,决定了它擅长什么
- 何允中把现在市面上的玩家按出身分成几类:招聘平台出身(Mercor、Handshake)、众包网络出身(Scale)、做合成数据的、垂直行业转行做数据的,另外还有握有版权数据的中间人(约 05:22—06:32,允中)。
- 在他看来,Mercor、Surge、Scale 这类大玩家试图覆盖所有品类;Bespoke 一类新秀偏研究与工程,主要生产代码方向的环境;小的团队做垂直领域,由领域专家组成(约 06:13—06:44,允中)。
- 招聘型与众包型是一组取舍:自养的人强但灵活度差,众包网络灵活但个体质量难保证;质检能力因此成为差异点(约 07:25—07:48,允中)。
数据的交付物从"一批标注"变成了"一套环境"
- 何允中说,一年多前他做的还是 Rubric Data,现在这个词听起来已经过时,行业里都在讲 RL Environment(约 08:19—08:36,允中)。
- 孙一铀把这条线概括为把 vibe coding 的势头推广到 vibe everything(约 12:40,一铀)。
- 何允中补充,转向动手之后,除了 Rubric 和程序化检查,还出现了让人选偏好的方式,验证手段目前没有共识,各家要的不一样(约 11:53—12:12,允中)。
Rubric 到没到头,两位嘉宾的判断相反
- 何允中认为静态文本那一路的 Rubric 需求已经比过去小,属于行业趋势层面的"过时",不是完全没有空间,各家的水平差异仍然很大(约 12:24、14:10,允中)。
- 孙一铀认为专家主观判断这一块远远不够,很多领域还没有被 Rubric 表征出来(约 12:29,一铀)。
- 两人都同意领域覆盖面本身还差得远(约 13:44、19:49)。
主观判断可以部分量化,但要靠验证器补上
- 孙一铀说工程产出的输出空间很大,确定性评判经常对不上;游戏好不好玩这类判断,教科书里有奖励曲线是否平滑这类可量化指标,只是公开的完整评测体系他还没见过(约 14:16—15:33,一铀)。
- 何允中给出验证体系的思路:模型变强,验证器跟着变强,Rubric 就可以写得越来越模糊;前提是 Rubric 加验证器的知识总量要超过被训练的模型(约 15:43—16:39,允中)。
- 生图的例子:指令遵循可以写成 Rubric、用 OCR 查字,"猫可不可爱"要靠专门训练的模型,最后是两者结合(约 17:00—17:33,允中)。
人负责决策、Agent 负责执行;决策最难变成数据
- 孙一铀回顾分工的演变:早期人写代码、Agent 写小模块,后来人给模糊指引、Agent 完成整个项目,现在是决策与执行分开(约 18:12—18:37,一铀)。
- 猫可不可爱可以训一个验证器,上市公司领导层的决策每天在变,很难收集数据训出替代它的奖励模型(约 19:16—19:36,一铀)。
- 何允中认为像 ALE 这样让专家交出做过的项目和当时的决策是一个方案,更长远的难题是设计出让人愿意交出来的激励机制(约 19:49—20:11,允中)。
benchmark 面向未来,数据面向现在
- 何允中说评测体现模型与理想状态的差距,本身是科研基准;但造 benchmark 的人对领域认识更深,天然获得卖数据的权威性(约 20:42—21:35,允中)。
- 孙一铀提醒有数据公司踩过红线,把做评测的数据拿去卖;他的判断是这两个角色不能混(约 22:10—22:25,一铀)。
- 他同时认为 benchmark maxing 也可以是个好词:刷的是有意义的榜,而且那个榜足够贴近真实用户的体验(约 23:19—23:25,一铀)。
有意义的 benchmark 有两种
- 一种是体现核心认知能力缺陷的,评测要能看出泛化性;一种是贴近大家在意的场景的,后者甚至可能测的是外层的 harness(约 24:01—26:03,允中)。
- 孙一铀把重点放在分布上:Artificial Analysis 给各家榜单加权合成一个分数,权重本身很主观,被质疑的往往是榜单而不是模型;有能力的厂商倾向自建评测体系(约 26:08—26:45,一铀)。
- 他也提醒,号称测智能的 ARC 类小游戏评测已经被证明可以被特化,一个小模型就能刷出分(约 27:13—27:28,一铀—允中)。
榜单的曝光有很大随机性
- SWE Atlas 的三个部分分阶段推出,最简单的问答先被 Artificial Analysis 收录,需求随之变大;何允中说他们当时很不理解,"花了那么多心血做更复杂的 benchmark"(约 28:17—29:21,允中)。
- 没上热门榜单的垂直评测仍然会被对口的实验室收回去看,Drug Discovery 和 AI Tutor 就是例子(约 28:00—28:17,允中)。
模型公司怎么用评测
- 孙一铀说美国几家大厂倾向自建评测,新成立的实验室更依赖外部评测,各家的策略不一样(约 31:45—32:13,一铀)。
- 何允中说产品成熟之后,公司最终关心用户增长,会朝"哪些指标跟 DAU 更相关"走;但科学发现这类场景造不出显著 AB test,仍然要靠 benchmark(约 32:13—33:19,允中)。
采购是数据行业真正的卡点
- 私域代码仓库、芯片设计要用到的商业软件版权、DevOps 要操作的云环境,每一项采购都有很深的门道,抓住一两个垂类做深就是机会(约 35:13—36:07,允中)。
- 一个几千人体量的手机游戏,源码报价能要到两三百万人民币一条,孙一铀说数据公司和做 benchmark 都没有这个财力(约 36:59—37:03,一铀)。
- 生命科学和生物医药的 benchmark 覆盖率算下来连 10% 都不到,孙一铀说连一个覆盖面完整的评测市面上都没有(约 38:38—39:02,一铀)。
好的数据公司最后拼研发
- 何允中认为第一性上还有巨量问题没被解决,但只盯着手上的活一定越来越难,利润会被进来的玩家压薄(约 40:23—40:43,允中)。
- 他把数据公司比作软件公司:提前投入大家未来需要的东西,赚到钱再投下一个(约 40:43—40:48,允中)。
- 他的"暴论"是实验室未必有最好的基因解决数据问题:企业数据的采购存在利益冲突,实验室的交付时间也卡得死,第三方的空间长期存在(约 40:55—43:28,允中)。
造环境最怕奖励投机,难度要按模型定制
- 何允中说最怕模型做手脚把分打高,业界会用强模型做红队去找捷径;验证器不只看任务有没有完成,还要看消耗了多少 token 和步数(约 45:48—47:03,允中)。
- 数据最常见的定制是难度:模型厂商会把还没发布的模型交给数据公司筛数据,题目不能太难也不能太简单(约 47:18—48:02,允中)。
- 另一类定制是轨迹采集,客户拿回去可以直接做 SFT,跳过强化学习(约 48:02—48:31,允中)。
SWE-bench 的两类失败
- 何允中把 SWE-bench 一类的失败拆成两类:任务本身没做好(测试脚本要求太多、题目没讲清楚),以及训练时把题目和答案都学了进去(约 49:17—49:40,允中)。
- 孙一铀补了数字:这个 benchmark 过去六个月只从 74% 提到 80%,余下 20% 集中在脚本太苛刻或题目不可解,对比意义就没了(约 49:59—50:14,一铀)。
- 公开数据的污染相对好检测,编造的数据最难查——一套很真的化学模拟可能要几个月才暴露,而专家验证的成本又极高(约 51:49—52:36,一铀)。
奖励机制是待解的大问题
- 孙一铀说 ALE 用署名做激励,结果有人为了提交而提交,用 Agent 编数据(约 50:14—50:47,一铀)。
- 何允中说按小时付钱也会有偷懒作弊,他的一个方案是工作量证明:要求把完整工作流程录下来(约 51:03—51:45,允中)。
- 他判断"怎么设计一套好的奖励机制把大家目标对齐"是个巨大的研究领域(约 51:07—51:32,允中)。
数据行业的下一步
- 何允中听说私募股权正在把这门生意接过去:买下公司之后,除了用 AI 提效,还能把公司的数据发掘出来卖钱(约 54:32—55:12,允中)。
- 他认为这门生意最后拼的是能不能把研发能力做成一条流水线(约 56:03—56:33,允中)。
- 孙一铀听到的说法是,数据公司的估值空间普遍不如传统公司,因为杠杆很难保持住:模型迭代太快,领导者得持续想下一步在哪里(约 56:09—56:28,一铀)。
关键节点
下面的章节标题来自官方单集页。1
- 05:03|数据公司之间的区别:招聘平台、众包标注、合成数据
- 08:27|从预训练到后训练,模型需要的数据发生了哪些变化?
- 09:32|Rubric 数据:把专业判断变成评分标准
- 10:46|强化学习(RL)环境:从回答问题到动手干活
- 12:18|从 vibe coding,到 vibe everything:详解 Agents' Last Exam
- 14:10|游戏好不好玩、作品好不好看,主观判断能被量化吗?
- 17:33|Rubric 与环境如何配合:人与 Agent 协作
- 20:05|从做评测到卖数据:benchmark 的生意
- 23:25|什么样的评测值得刷?核心能力与真实场景
- 27:29|没上热门榜单的评测,也可能带来真实的数据需求
- 31:39|模型公司如何权衡内部评测、公开榜单与用户反馈
- 33:30|两三个人的数据创业公司,为什么也能找到机会?
- 38:56|模型越来越会自己造数据,外部供应商的机会还能持续多久?
- 40:48|模型公司为什么仍然需要外部数商?研发周期与行业采购的难题
- 44:04|数据买回来之后怎么用?从 SFT、强化学习到模型训练模型
- 47:03|训练数据不是越难越好:为不同模型匹配难度与解题轨迹
- 48:22|SWE-bench Verified 的争议:测试缺陷与数据污染
- 50:04|专家交来的数据也可能造假,如何验证真实的工作过程?
- 54:03|数据行业的下一步:收购企业、获取数据,还是持续投入研发?
术语
- Rubric(评分标准):针对具体任务列出的一组打分条件,用来说明一份答案或一份工作成果满足什么才算好。何允中的比方是教授写好打分规则、助教照着判卷。
- Weak-to-Strong:用弱模型监督强模型的思路。它成立的前提是专家已经把自己的知识写成了规则,弱模型拿着规则就能判卷(约 10:38—10:49)。
- RL Environment(强化学习环境):让模型通过行动和反馈来学习的一整套东西,包括任务、可操作的软件与工具、沙箱,以及判断任务有没有完成、完成得好不好的验证器。何允中说这是今年行业追求的主要方向。
- Benchmark(评测基准):用一组任务和评价规则衡量模型或智能体在特定能力上的表现。孙一铀提醒,评测数据与训练数据要保持隔离,否则评测就失去意义。
- Reward Hacking(奖励投机):模型利用评分机制的漏洞拿高分,却没真正完成任务。何允中说这是造环境时最怕出现的情况,业界会用强模型做红队去找捷径。
- RSI(Recursive Self-improvement,递归自我改进):何允中称之为今年的一个主题词,指 AI 参与改进自己。落到数据上,是那些跑一次要几天甚至一星期的长程任务(约 44:52)。
- Harness:包在模型外面的执行框架。何允中在讲个人助理这类 benchmark 时说,这类评测测的可能不完全是模型本身,还包括 harness,结论会告诉你框架错在哪里(约 25:46—25:57)。
- LM Arena:让多个模型同时回答同一个问题、由人投票比较的模式。孙一铀说这是最接近"真实分布"的形式,但长程任务很难照搬到这套机制上(约 29:42—30:28)。
- Artificial Analysis:把各家 benchmark 按不同权重综合成一个总分的第三方评测体系。孙一铀对它的质疑集中在权重本身是否合理(约 26:11—26:31)。
- SWE-bench Verified:经过人工审核的软件工程评测,让模型修复真实开源项目里的问题。OpenAI 在 2026 年 2 月 23 日宣布不再报告它的分数,理由是测试设计与数据污染。9 节目里两位嘉宾对它失败的原因给出了各自的解释。
- SWE Atlas:Scale 推出的软件工程智能体评测套件,覆盖代码库问答、测试编写和代码重构,三个部分分阶段推出。6
- Agents' Last Exam(ALE):由 Berkeley RDI 与 300 多位行业专家共同构建的智能体评测,关注有经济价值、需要多步骤执行、结果可验证的专业任务。78
- Humanity's Last Exam(HLE):由 Center for AI Safety 与 Scale AI 共同组织的评测,覆盖数学、人文、自然科学等领域的高难度专家问题。10
- 数商:节目里对数据供应商的口语叫法,指专门为模型公司提供训练数据、环境与评测服务的公司。
- 众包(crowdsourcing):把任务分发给大量外部参与者完成的做法。何允中用它来对比招聘型公司——众包网络灵活,但每个人的质量更难保证。
- Proof of Work(工作量证明):何允中提出的一个奖励机制设想,要求专家把完成任务的完整工作流程录下来,用可验证的过程替代只看到结果。这里的用法与区块链中的同名概念无关。
几句原话
「我觉得一个数商真正要做的事情是研发,看看未来还有哪些行业是重要的,这些行业有哪些东西我要值得投入,把东西买回来。」
——何允中,谈数据公司的长期竞争力,约 42:09。
「如果我是一个 Lab 的 Research,如果你让我花半年的时间来解决一个行业,可能有时候大家其实没有自由度。」
——何允中,谈实验室为什么需要外部数商,约 42:30。
「这个时候就是一个 Rubric 的方式,相当于我让一个 TA 拿着教授写的打分规则来给你打分。然后因为这个打分规则是提前标好的,所以这个 TA 也不需要特别聪明。」
——何允中,解释 Rubric 与 Weak-to-Strong,约 10:26—10:38。
「大家希望左脚踩右脚,就是当我的模型变强了,我这个验证器也变强了。验证器变强了之后呢,我就可以允许一些更复杂的 Rubric。」
——何允中,谈验证体系的演化方向,约 15:48。
「benchmark 面向的是未来,做数据面向的是现在。」
——孙一铀,区分评测与卖数据两个角色,约 22:34。
「我们很担心这样的评测它会失去意义,但世界上没有必要担心这个事情,因为 benchmark 本身就是要面向于未来的模型去做的。」
——孙一铀,谈 ALE 早期的担心,约 23:02。
「确实是有人为了提交而提交,然后他甚至用了 agent 去合成了一堆乱七八糟数据,甚至有些数据交上来,我肉眼看出来他就是编的。」
——孙一铀,谈专家数据造假,约 50:42。
「我拿 Mercor 他们官网上给专家一个小时的那个价格来说,比如说制造业的工程师大概是可能一两百刀一个小时。这种价格就限定了,它不可能招到特别特别高级的工程师。」
——孙一铀,谈激励机制决定了上游是谁,约 57:00。
完整逐字稿(按说话人)
本稿依据官方单集页的完整音频转写,覆盖 00:00:01 到 00:57:58。为保留现场语感,口语、重复与中英混用都保留,只对明显的识别错误(人名、公司名、术语)做了最小校正:说话人统一为「主播」「允中」「一铀」,孙一铀的名字在识别稿里出现过多种写法,文中统一为「一铀」。文中「允中」指何允中(Scale AI),「一铀」指孙一铀(加州大学伯克利分校)。时间点为该段话在音频中的起始位置。节目开头约 02:26—03:32 是赞助品牌口播。1
主播|00:00:01 Hello 大家好,欢迎回到硅谷 101,我是 Yiwen。
主播|00:00:04 很多投资人在和我们聊天的时候都提到了他们最近很关注的一个赛道,那就是数据。
主播|00:00:11 随着模型能力的不断提升,模型公司对训练数据的需求也变得越来越复杂,越来越具体。
主播|00:00:17 硅谷因此出现了一批增长很快的数据公司,专门为这些模型公司提供服务。
主播|00:00:24 比如由三名 20 多岁的年轻人创办的 AfterQuery,
主播|00:00:28 今年 4 月宣布 A 轮融资的时候,估值还是 3 亿美元,到了 9 月,新一轮融资就已经把他的估值推到了 32 亿美元,不到半年,涨到了 10 倍之多,创下了 YC 旗下公司从启动到成为独角兽的最快记录。
主播|00:00:45 我们更熟悉的几家大型数据公司估值也已经达到了百亿美元的级别。
主播|00:00:50 去年 Meta 入股 Scale AI 的时候给出的估值超过 290 亿美元,Mercor 去年 10 月这轮融资的估值也达到了 100 亿美元。
主播|00:01:00 但这些高估值背后的数据生意到底是怎么做的,外界其实很难看清。
主播|00:01:05 所以我也很好奇这些公司究竟在卖什么?模型公司又为什么愿意给那么多钱呢?
主播|00:01:12 过去提到数据标注,大家很容易想到给图片打标签,给模型的回答打分这些人工标注。
主播|00:01:19 现在数据公司还需要请来各类行业专家,把他们的知识和工作经验转化成 AI 可以学习的任务。
主播|00:01:27 其中一类重要的数据是请专家写清楚,一个回答一份工作成果,到底满足哪些条件才算好。
主播|00:01:35 这套评分标准也就是我们经常听到的 Rubric。
主播|00:01:39 再往前一步,数据公司还要搭出让 AI 实际动手的环境,配上任务、工具和反馈机制,让它在里面操作软件、反复尝试,并且根据结果学习。
主播|00:01:51 这就是强化学习环境,也就是我们经常听到的 RL Environment。
主播|00:01:57 与此同时,新的 AI 评测也层出不穷,从金融、法律等等垂直领域,到让 Agent 完成一整套工作流程,模型要参加的考试是越来越多了。
主播|00:02:08 但榜单上的分数提高了,究竟代表哪些能力变强了呢?
主播|00:02:13 针对榜单做优化,什么时候会让模型更好用?什么时候又会变成单纯的刷分行为?
主播|00:02:20 这期播客,我们就想把这些问题聊清楚。
主播|00:02:26 今天聊大模型数据范式迁移,人工标注转向可验证的 RL 环境。
主播|00:02:32 但也有观点,对机器人来说,最难构建可验证环境的场景,未必在实验室,反而在实际家庭里。
主播|00:02:40 沙盒里写代码,跑一遍就知道对错,但家务是动态环境开放任务,机器人不仅要完成动作,还要稳定做好,难度极高。
主播|00:02:51 家庭场景验证是行业的最硬命题。
主播|00:02:55 如何让家务不用人操心.科沃斯钻研了 28 年.从扫地、擦窗到割草、泳池清洁.他们没急着把机器人做得像人.而是不断打磨能帮人的机器人.在真实场景稳定解决问题.为此重设清洁决策、搭建验证体系.很多功夫花在看不见的地方.家务难在哪.科沃斯的能力就长在那。
主播|00:03:28 本期节目由科沃斯赞助播出,像人是很迷人的方向,但帮人才是科技最终的目的。
主播|00:03:32 接下来就请收听我们关于 AI 数据的正片。
主播|00:03:42 我请来了两位非常适合聊数据这个话题的嘉宾,分别是在 Scale AI 负责后训练和评测研究的何允中,
主播|00:03:48 以及加州大学伯克利分校的博士后.Agents' Last Exam 项目的研究者孙一铀。
主播|00:03:50 以下就是我们的对话。
主播|00:03:57 Hello 允中,Hello 一铀,欢迎来到硅谷 101,大家介绍一下自己吧。
允中|00:04:01 OK,我叫允中,现在在 Scale 负责 Post Training 和 Eval Research。
允中|00:04:08 大部分人关注我们可能是看我们发布的这个 benchmark,还有一些 RL Data Recipe 的文章,
允中|00:04:14 但是实际上我们其实也是给整个大模型行业提供数据,还有一些方法论的知识吧,
允中|00:04:18 有一点像整个行业的一个外包数据也 research 团队。
允中|00:04:23 观点都是个人观点,不代表 Scale AI,也跟客户没有关系。
一铀|00:04:30 谢谢允中,我是一铀,我现在在 UC Berkeley 读 Postdoc,现在关注的也是 Agent Evaluation 这个方向。
一铀|00:04:44 我们最近推出的工作就是一个 Agent's Last Exam,目标是构建于迄今为止规模最大覆盖面最广的智能体评测基准,是由 Berkeley RDI 和 300 多位行业专家共同领导和牵头的。
一铀|00:04:49 是希望能够衡量智能体在有可验证结果的长期、具备精致价值任务中的一些表现。
一铀|00:04:54 目前的话,公开的任务大概有 150 多个,覆盖了 50 多个细分的行业。
一铀|00:05:00 然后我们目标在下一次发布中直接放出 1000 多个任务,在每个领域上做得更深一些。
一铀|00:05:02 我们可能几个月内就会发布 V2 的版本。
主播|00:05:10 允中要不要跟我们讲一下现在市面上的,因为也有零零总总的数据公司嘛,你觉得大致的一个分类是什么样的?
允中|00:05:15 这里面有几个大的玩家,还有一些新秀,有一些几个人的 shop。
允中|00:05:22 在我看来最有意思的是大家基因可能不太一样,比如说有做招聘出身的,像是什么 Mercor,Handshake。
允中|00:05:29 Scale 是这种传统数商,从众包网络出身的,然后也有一些新的是做合成的。
允中|00:05:34 还有在最新的一些可能是某一些领域公司转行做数据了。
允中|00:05:36 这里面值得说一下是巨生。
允中|00:05:40 巨生现在的行业状况是有很多做模型的公司暂时没赚到钱,
允中|00:05:43 但是他花了很大量的精力投资做数据,
允中|00:05:45 然后就顺便做起了数据生意。
允中|00:05:48 很多各个行各业的人也发现了自己的数据的价值,
允中|00:05:51 然后转行来做这么一个数据公司。
允中|00:05:52 我觉得大致有这么几个分类吧。
允中|00:06:13 几个大的玩家,比如说像是 Mercor、Surge、Scale 基本上试图什么东西都能 cover,除此之外,其实一些新秀玩家把一些领域做得比较好的,像是什么 Bespoke 或者 Snoke,他们可能是比较偏 Research 跟 Engineering 一点的,我猜测他们主要生产代码或者是脱口这一类的环境,就是抓住了今年的这么一个风口。
允中|00:06:18 另外我还看到一些小的公司他们可能是解决了一些垂直领域的问题
允中|00:06:20 甚至他们可能不像我们是做标注数据的
允中|00:06:21 就是一些 broker
允中|00:06:23 比如说可能是好莱坞的一个人
允中|00:06:24 他有特别多的版权数据
允中|00:06:26 然后他知道怎么把这东西卖出去
允中|00:06:29 就是有零零总总的不同领域的东西
允中|00:06:32 然后现在可能在最新兴起的就是做这些垂直领域
允中|00:06:37 把一个领域做得特别好,可能是由一些领域专家组成的,大概是这么几个分类吧。
允中|00:06:44 我会觉得说机会还很多,大的数商有大的数商的优势,就是想进入一个领域,有比较多的资源。
允中|00:06:46 我觉得整个饼是越来越大。
主播|00:06:54 你讲到说像 Mercor、Surge 这样的公司是所谓的招聘公司,这个能不能再给我们具体讲一下招聘是一个什么样的商业模式?
允中|00:07:10 Surge 应该不是,但是 Mercor 它是做招聘几家的,它有自己的一个自动 AI 面试的这么一些产品吧,它可能自己主打的一个重点就是说我能够在比较短的时间内找到足够量的专家,有这么一个专家网络。
允中|00:07:25 然后 Surge 我觉得更多的是把这个东西 in-house 这里反正有一些取舍吧,基本上每个数商可能都需要面临这么一些取舍,就是说如果我是自己完全全职培养的人,那他肯定能力强一点,但是这个灵活度就不够,才能可能会差一点。
允中|00:07:32 如果是更多的依靠众包的网络,那么可能我的灵活性大一点,但是就是每个人的质量就比较难保障。
允中|00:07:40 然后这里面就涉及到一些质检的问题了,比如说像 Scale 这些公司的一些优势,就是说我们有一些质检的经验,不光是在数据上也在人上。
主播|00:07:48 与其同时,我希望您能够分享一下您从何时加入 Scale AI 与当时到现在的整个市场,您觉得数据需求有变化吗?
允中|00:07:50 对,故事还挺好玩的。
允中|00:07:55 当时我是在 Meta 入股之前签的 offer,我一到,人就走了。
允中|00:08:04 所以我经历了整个大模型行业开始,不管从人才的战争,还有薪酬体系都开始 go crazy 的这么一个故事。
允中|00:08:14 当时我来之前,我的老板刘斌跟我说,有这么一个技术,各个家 Lab 都在做,但每个人都做的不太一样,说你赶紧进来,我就能跟你讲,然后我们在这里好好做些研究。
允中|00:08:19 然后我来了,那个时候是 Rubric Data,那个时候还比较新,可能一年多之前吧。
允中|00:08:27 现在 Rubric 感觉已经过时了,大家都在讲 RL Environment,各种各样的东西,就是这一年确实经历了非常多的变化。
主播|00:08:36 其实我们关注这个话题也是因为大概从 2024 年到现在感觉整个对于数据的一个需求发生了一个比较大的变化。
主播|00:08:43 因为 24 年之前我们在聊数据的时候大家想到的很多还是人工标注,就是一些比较基础的数据吧。
主播|00:08:47 我们会需要非常多的数据来做 pre-training 来训练模型。
主播|00:08:55 但是从 2024 年,其实 Mercor 之前有提到过是因为 Deep Search 的兴起导致整个行业转移到了一个所谓的 Agentic Data。
主播|00:09:13 我们会需要像你刚刚说的 Rubric 然后包括 RL 环境啊,现在就是更多真实工作流数据,能不能帮我们先梳理一下这几个概念吧,我们先讲一下这个行业从 Crowdsourcing Data 就是这些人工标注数据到 Agentic 数据这个中间是经历了一个什么样的变化?
允中|00:09:36 对,首先说明一下,Pretraining 还是很重要的,不过就确实从我身边的人的兴趣来说,大家经历了一个 shift,大家觉得 Pretraining 感觉干的有点无聊了,就是在继续 Scale,调数据配比,那个时候是 O 系列模型出来了,大家都在做 Reasoning,发现这个 RL 跑通了嘛,一下子大家兴趣都在 RL 上,然后 RL 比较有意思的一个问题就是说,我需要一个可验证的信号。
允中|00:09:41 可验证的信号在代码或者数学,尤其是最早的推理模型是从数学上做出来,就很简单。
允中|00:09:45 我这个选择题答错答对了就知道了,或者就是一个数字算出来。
允中|00:09:52 但是之后大家就在想说,那我数学可以做二维码了,我在其他领域呢,比如说像是这些什么医疗、金融。
允中|00:09:56 或者就是更基础的指令应遵循,这里我能不能做 RL 。
允中|00:10:04 这里它存在的一个问题就是说,它是有一些客观标答的,不像在之前的一个阶段大家做 RLHF 就是 Reward Model 。
允中|00:10:06 可能没什么标答,只是把大家的喜好学出来。
允中|00:10:10 然后这里面其实就有个标答,只是它这个标答它比较不结构化。
允中|00:10:16 就好像我去答这个历史考题,历史考题是有标答的,但是呢,每个人的写法可能都不太一样。
允中|00:10:20 就我很难做这个 Pattern Match,就是说 ABCD 检查你有没有答对。
允中|00:10:26 这个时候就是一个 Rubric 方式,相当于我让一个 TA 拿着教授写的打分规则来给你打分。
允中|00:10:31 然后因为这个打分规则是提前标好的,是教授写的,所以这个 TA 也不需要特别聪明。
允中|00:10:38 这是整个大模型数据中的一个核心概念,就是叫 Weak to Strong Provision,就是我能不能用弱模型来监督强模型。
允中|00:10:45 那它这里成立的条件就是说我有个专家把他脑海里的知识给写下来了,这样弱的模型拿着它改卷的就行了,这就是 Rubric Data。
允中|00:10:49 这个东西应该是火了很长一段时间,但是现在还很重要。
允中|00:10:55 但是这里面很快就把各个专家领域的 Rubric,就比较容易获得的收集的比较干净了。
允中|00:10:59 看到比如说项目 Core 或者 Surge 的崛起其实跟这一块的专家 Rubric 有关系。
允中|00:11:08 但是再往前走呢,就大家需要动手了,比如说现在做这种代码模型,或者像一铀他们做的 ALE,虽然它不是做代码,但它需要动手,要解各种各样的问题。
允中|00:11:20 这个时候呢,他就不再是说我只是验证你一个聊天的输出了,那我需要是在一个 agent 的这个 setting 之下,那我可能需要给他一些工具,还有一些更复杂的验证方式,但还包含了 rubric。
允中|00:11:33 但是可能我需要一些检查这个环境里面的变量是不是执行了,这个数据库是不是写入了或者被删除了,甚至如果像是我生成了一些文档,里面可能有些图,这个东西我还是需要 rubric,但是我需要一个 agent 来检查。
允中|00:11:34 这些方法就变得更加多样了。
允中|00:11:38 现在可能大家追求的比较大的一个方向就是环境。
允中|00:11:41 它不光是我标注好的一些打分规则了,
允中|00:11:44 而是说我可能包含了一整套我要做什么,
允中|00:11:45 在什么样的环境里面做,
允中|00:11:47 包括了它需要的一些工具,
允中|00:11:49 需要执行的一些沙盒,
允中|00:11:52 以及还有一套跟 task 比较相关的验证方式。
允中|00:11:53 验证方式非常的多样,
允中|00:11:55 比如说有这种 programmatic check,
允中|00:11:57 有这种 rubric,
允中|00:11:59 还有 preference 我让人选我比较喜欢哪一种。
允中|00:12:02 这里面我暂时还没有形成特别大的共识。
允中|00:12:05 我又看到有点像当年 Rubric 时代,每一家要的东西都不一样。
允中|00:12:10 就比如说像什么 Terminal Bench,他们就不要 Rubric,他们就是纯 Programmatic。
主播|00:12:12 这里面又有不同的流派,还挺有意思的。
主播|00:12:18 这个很有意思,一铀你要不要从 ALE 的具体的例子来跟我们讲一下需要哪些要素?
一铀|00:12:20 其实我跟允中的看法其实有一点反过来了。
一铀|00:12:24 允中认为现在 Rubric 差不多已经做到头了。
一铀|00:12:29 但我的看法是,我觉得 Rubric 这一块,以此专家中主观的判断其实还做得远远不够。
一铀|00:12:32 我可以先从 ALE 的初衷讲一下。
一铀|00:12:40 ALE 当时建立的初衷就是跟允中讲的一样,就是我们怎么样把 Vibe Coding 迅速发展的趋势推广到 Vibe Everything。
一铀|00:12:42 当时 Vibe Coding 为什么发展那么快?
一铀|00:12:46 就是因为当时有非常非常多的 benchmark 都在 Coding 这个领域。
一铀|00:12:49 而且 Coding 它比较容易 verify,它是一个确定性的 Rubric。
一铀|00:12:53 大家为了刷这个榜,所以在 Coding 这上面的发展非常迅猛。
一铀|00:13:02 那么用同样的思路呢,我们如果在其他的各个领域上,尤其是工程,能够客观打分的这些领域上,能够建立各种各样的这样评测体系。
一铀|00:13:10 你是刷分,但你只要刷的是有意义的分,是有意义的题,那它模型带来的提升对于人的日常工作来说就是实打实的提升。
一铀|00:13:13 所以这就是我们当时想建立一个这样的初衷。
一铀|00:13:17 当然世界上大家职业各式各样实在是太多了,浩如烟海。
一铀|00:13:23 所以我们只是说在第一个版本里面给出一个相对来说覆盖面比较广的初次的一个尝试。
一铀|00:13:29 然后我们还会继续努力,希望把这个覆盖的更广一些,到某一天希望它能成为真正的 Last Exam。
一铀|00:13:35 当你解决这个 benchmark 的时候,基本上就能解决人类社会在某些领域的真正的有益的问题。
允中|00:13:44 我同意一铀的观点,各个领域的训练肯定是远远没有到头的,然后很多东西都可能还没有被 Rubric 的方式表征出来,所以这里面还有很大的空间。
允中|00:13:57 可能我刚刚说 Rubric 到头了,更多的是个行业趋势吧,就这种静态的单轮或者多轮聊天,出一个文本,然后用 Rubric 来检查它,就是纯知识类的,甚至也不是说到头了,因为毕竟还有不同的 Lab,每家的水平都不一样。
允中|00:14:10 只是说今年的一个大趋势是在做这个 coding,然后 coding 逐渐转向了 Agentic work,大家要动手了,这个时候就是存这种文本的 Rubric,我看到需求量小了一点,但还是很大,还是有很多东西没解决。
一铀|00:14:16 就允中高在提到了对于很多这种文本上的输出,就是说他这个文章写的好不好,你可能有些这样打分的点。
一铀|00:14:26 但是事实上对于工程领域的一些产出,其实有很多的评测我们确实发现了,除非你把输入固定的特别死,不然它的输出其实有非常非常多的可能性。
一铀|00:14:31 我举个例子,你让它生成一个游戏,甚至有些数学解法它都不是唯一的。
一铀|00:14:38 那这种情况下,如果你给一个确定性的评判,就是你一定要跟你这个 Ground Truths 来对比,那很多时候就会造成不一致的这个问题。
一铀|00:14:50 所以说,很多时候说我们怎么样定义这个 Rubric,让它能够兼容这种多事多案的输出,其实这也是我们在构建 benchmark 中遇到的问题,也是未来想要去思考解决的一个方向。
一铀|00:15:04 稍微抛砖引玉一下,我的一个想法就是未来的这个发展走向可能会,比如说人类他对于一些好玩、好看,他没有办法把它固化下来成为一个可以被量化的一个指标,比如游戏好不好玩。
一铀|00:15:16 但实际上有些游戏的入门教科书里其实是有各种各样的评判的方式,比如说它那个奖励曲线是不是平滑,符合大脑的那个多巴胺的,它一些有科学的指标可以去量化这个好玩和好看这个东西。
一铀|00:15:26 但我目前在现在的这 benchmark 上我还没有看到一个做得特别完整的公开出来的评测体系,因为这个东西难度也确实非常高,因为需要专家的更加更加深度的参与。
一铀|00:15:33 所以这一点我也想看看允中那边关于在数据公司里有没有看到这一个趋势或者或者怎么去解决这一类的问题。
允中|00:15:37 对,这个问题特别好,这也是每天我们在绞尽脑汁的问题。
允中|00:15:43 其实整个 Rubric 或者整个大模型的验证体系,我觉得它整体上是有这么一个思路。
允中|00:15:48 大家希望左脚踩右脚,就是当我的模型变强了,我这个验证器也变强了。
允中|00:15:52 验证器变强了之后呢,我就可以允许一些更复杂的 Rubric。
允中|00:15:59 就比如说如果我是一个很弱的验证器,那么我就只能写一些就是一个傻子都能看出来,就知道是对还是错的这个 Rubric。
允中|00:16:06 但是呢,随着这个模型能力的提升,那我的 Rubric 就可以写得越来越模糊,可以把更多的知识交给验证器来解决。
允中|00:16:17 但是,我觉得这里总体的一个思路还是说,这个 Rubric 加上验证,这两块加起来的这个知识和能力应该比我要训练的模型要多,不然就达不到训练模型的目的了嘛。
允中|00:16:22 那么就回到比如说像是这种做 video game 这种特别特别主观的东西,对吧?
允中|00:16:28 我觉得未来可能是这样的,你可能很难把它以很显式的条件一条一条写下来一个好的游戏是怎么样的。
允中|00:16:33 那它可能有多种这样的可能,所以这个时候我的 Rubric 就会被迫写得更加模糊。
允中|00:16:39 这个东西就 by the way,其实不是我们想要的,就通常来说我们会建议这个 Rubric 写得越严谨越好。
允中|00:16:45 但是在某一些领域你可能就必须要写得很模糊,这个时候需要验证的模型来自己做一些主观的判断。
允中|00:16:52 那这个验证的模型我觉得甚至有可能是我要训练一个这个 reward model,我知道比如说在不少 lab 里面,
允中|00:16:55 这不是客户透露给我们的东西,是我自己的一些经验。
允中|00:17:00 比如说生图,生图它有两个部分,一个是 instruction following,有没有遵循我的要求。
允中|00:17:13 比如说我图里面有猫有狗,有一个背景板写了那几个字,这个时候我是会有 rubric,我就写这里要有一只猫,那有一只狗,甚至我跑一下 OCR 把那个字提出来,然后看看是不是我想要的那几个字,就这一块是属于 rubric。
允中|00:17:16 但是还有一块就是说这个字要写得好。
允中|00:17:33 这个猫要是一只可爱的猫,这种东西呢,就是我可以写上 Rubric,但它非常主观,那我可能甚至专门训练一个模型,就这个模型它可能掌握了一些人类的主观体验,这些东西可能跟 Rubric 结合在一起,大概率这个问题如果要解决的话,可能是这么一个混合的方式。
主播|00:17:45 因为我们刚刚好像把 Rubric 和环境这两个事情好像是放在对立面来说的,但是听起来一,它们是可以结合在一起使用的,二,有没有一些任务是用 Rubric 来做会比较好的,或者用环境来做比较好的?
一铀|00:17:54 我觉得这个肯定是不能拆开来讲的,环境或者说任务数据它只是一个执行的基准,但是 Rubric 是最终用来打分,用来奖励模型做得好还是不好。
一铀|00:17:57 所以它肯定是相辅相成,又必须结合在一起来看的。
一铀|00:18:07 我个人更是希望去从一个任务分类的一个角度去看,而且人和 agent 这两个角色如何去合作,他分别担任一个什么角色,这也很重要。
一铀|00:18:12 我们从历史上来看,就是从最早期 Vibe Code 刚出来的时候,就大家用 cursor。
一铀|00:18:15 其实就是一个人类也是参与在执行这个代码当中的
一铀|00:18:19 Agent 他只负责执行很小的一个模块的一些写代码
一铀|00:18:21 但后来随着 Agent 能力越来越强
一铀|00:18:23 Agent 就你给他一个非常模糊的指引
一铀|00:18:25 他能够完成一个非常大的一个 project 的时候
一铀|00:18:28 那这个时候人和 Agent 的决策又产生了一些变化
一铀|00:18:30 那现在可以大致分成这两类
一铀|00:18:31 就是人负责决策
一铀|00:18:33 Agent 负责执行
一铀|00:18:35 人把你决策的东西说得越清楚
一铀|00:18:37 Agent 就能做得更好
一铀|00:18:40 至于这两个分类,我们来看 Rubric 该如何去设计。
一铀|00:18:43 如果我们需要 Agent 参与的角色,它只是执行。
一铀|00:18:47 你如果把一个任务说得很清楚,它的输出基本上是固定的、唯一性的。
一铀|00:18:50 那这个东西 Rubric,它就是一个确定性的 Rubric。
一铀|00:18:55 它打分的话,完全可以基于你自己做出来的一个成品来进行打分,因为一般会有 Ground Truth 基准。
一铀|00:19:02 如果我们咱们讨论未来数据需要的形状,就是当人的决策的这部分会不会也被 Agent 所慢慢去取代。
一铀|00:19:11 这一部分就是我觉得会回到之前允中说的,大家现在反而没太重视这些 Rubric,因为决策很多是非常模糊,很难去量化。
一铀|00:19:16 而且允中说你对于一个具体的 Domain,猫可不可爱,你可以 Train 一个这样的 Verifier。
一铀|00:19:30 但是对于一个,尤其是一个上市公司,一个领导层的一个决策,你该如何去 Train 一个 Reward,它每天的那个任务都在变,你很难去收集到足够的数据,让你来训练出这样一个 Reward Model 来替你做这样的决策。
一铀|00:19:36 所以我个人认为在这一块的模型的发展还有很长的路需要去走,而且这可能是会成为一个未来发展趋势。
允中|00:19:49 这里我特别同意,就比如说 ALE 的这个方案我觉得就是面向未来,比如说像这个猫可不可爱,比如说我要是在这个 Meta,我有一些用户行为的反馈,我可以训这个模型,但是公司的决策我就很难收到这些数据了。
允中|00:19:55 比如说像 ALE 这种,就让大家把以往做过的东西还有决策交起来,其实是一个方案。
允中|00:20:04 我会觉得以后收数据可能是大家怎么样找到好的激励方式,让大家把一些重要的东西交出来,尽量的能够回溯当时这些重要的决策。
主播|00:20:11 非常有意思。我想再追溯一下评测的近几年的整个一个发展,然后以及它和卖数据之间的关系。
主播|00:20:17 因为其实我和两位私下都聊过就是卖 benchmark 和卖数据这两件事情,大家都觉得不能混为一谈嘛。
主播|00:20:28 Scale 之前推出了 Humanity's Last Exam,就 HLE 这个评测,能不能给我们讲一下这个评测,然后以及你觉得它和数据之间是怎么样联系起来的?
允中|00:20:42 这是个好问题,我觉得从原理上来说,评测它体现的是模型距离我们想要的理想状态中间的这个 gap,就是它更多的是一个科学研究这么一个基准,就是我想要模型在哪,它现在没到哪。
允中|00:20:46 但是这个事情跟卖数据联系起来呢,也比较有意思。
允中|00:20:52 因为很多时候它提升这个模型能力的数据和它榜单的评测方式是息息相关的。
允中|00:20:54 这里面可能比较难的是找到一个平衡。
允中|00:21:01 如果我就生产大量的跟这个榜单差不多的数据,那么它可能就在 benchmark maxing。
允中|00:21:04 但是呢,就是这个大模型训练还是有各种各样的维度。
允中|00:21:11 确实如果我想要提升某一类的能力,我需要抓住某一个维度,那么就是说它跟 benchmark 肯定是有一定的相关性。
允中|00:21:14 这个是大家需要找到的一个平衡。
允中|00:21:18 因为大家对 AGI 的期待太高了,觉得人能做到的事情他都能做到。
允中|00:21:25 那么就是说我在各种各样的领域都可以想到一些方式构造一个 benchmark,然后发现它这个模型具体理想象当中还有一些差距。
允中|00:21:32 通常构造这个 benchmark 的人呢,对于这一块的领域可能认识比较深,那么就自然会给他一定卖数据的权威性。
允中|00:21:35 大家会比较相信你手上卖的数据。
允中|00:21:41 这个生意就这么产生了,我就相信一铀应该也,就 ALE 现在做的火的 benchmark 应该也有不少人,
允中|00:21:46 想问你卖不卖数据啊,或者是有可能 VC 想找你投资,结果逐渐逐渐的就成了一个生意。
允中|00:21:54 我觉得就是也有好有坏吧,就是说这个生态其实也还比较野蛮发展,有多少是在做科学,多少在做 benchmarking,
允中|00:22:00 我觉得确实需要仔细权衡一下,但是这确实有很多的利益驱动,所以现在是个挺繁荣的市场。
一铀|00:22:10 对,这里的话我也是要给大家敲个警钟,因为允中提到了现在做 benchmark 的人会受到各种各样的诱惑,就是要去把 benchmark 数据去卖了。
一铀|00:22:25 我甚至私下听到是有一些数据公司他踩了这个红线,就是他把自己在做评测的数据去卖,当然这个是大家千万不能碰那条线,不能让你做的生意污染你这个 benchmark 的权威性,不然的话你不仅毁了你的 benchmark 也毁了其他人的模型。
一铀|00:22:34 我个人认为 benchmark 和卖数据这两个东西角色是不一样的,在这个生态系统的地位上,我就认为 benchmark 面向的是未来。
一铀|00:22:42 做数据面向的是现在,benchmark 是面向于未来大家还失望这个模型公司去解决什么目前还没有解决的什么问题。
一铀|00:22:49 其实 ALE 我们在今年 1 月份、2 月份做的时候,我们特别害怕 benchmark 做得太难,导致这个 benchmark 失去意义,
一铀|00:22:55 因为当时的模型很多基本上平均分只有 10%到 20%,大部分题目它都是只有拿到零分,
一铀|00:23:02 我们很担心这样的评测它会失去意义,但世界上没有必要担心这个事情,因为 benchmark 本身就是要面向于未来的模型去做的。
一铀|00:23:10 数据的话更多是去解决这个 benchmark 所产生的一些需求,所以说更说是现在大家在刷这个榜单,然后怎么样去把这件事做好。
一铀|00:23:19 我认为 benchmark maxing 它有好有坏,你只要面向的它这个数据它不是直接污染你这个 benchmark,然后你这个 benchmark 刷的又是有意义的一个榜单。
一铀|00:23:25 只要这个 benchmark 和人的真实用户的体验非常接近,我觉得这个 benchmark maxing 它不一定是一个贬义词。
主播|00:23:34 对,benchmarking 这件事其实特别有意思,因为一方面我们确实需要一个评测的基准,然后另一方面你又不需要模型公司为了刷评测而去刷评测。
主播|00:23:42 我觉得这里很自然就产生一个问题,就是什么样的评测才是有意义的评测呢?因为我们现在一周就感觉可以看到很多新的 benchmark。
主播|00:23:51 比如说从模型公司的角度来说,他们应该怎么样去选,去刷哪些评测,或者把哪些评测作为他们下一步提升模型能力的目标?
主播|00:23:55 然后从你们供应商还有 researcher 的角度来看,你是怎么样去看待这件事情?
允中|00:24:01 我觉得做模型能力提升最大的 ROI 还是我要放在能力上。
允中|00:24:04 这些能力提升它应该是汇集各个 benchmark。
允中|00:24:09 当然就可能有些人有不同观点,因为就对于一些模型厂商来说应用也非常重要。
允中|00:24:16 就比如说如果我的这个 benchmark 是比较贴近一个应用场景,他们其实有动机就把这个场景做好对他们也是有益的。
允中|00:24:24 最有意义的事情是大家至少口头上还是奔着 AGI 去的嘛,那我应该考虑哪一些核心的这个认知能力是我需要提高的。
允中|00:24:30 那么它体现在 benchmark 上就是说我可以看到一些泛化性,如果我做了一个提高它只长这个别的都不长。
允中|00:24:46 那么可能有一些不好,所以就回到一开始的问题,未必是说怎样的一个 benchmark 是最好的,还是说不同的 benchmark 它测试了不同的东西,我可能要关注的是哪一些这共同的能力能够让他们一起提升,而不是说我只专注于优化同一个 benchmark。
允中|00:24:54 另外再回到 benchmark 本身的问题,我倒是觉得除此之外,大家确实会关心一些贴近场景的 benchmark。
允中|00:25:05 如果这些场景是大家在意的,它确实反映了这个用户体验,这也是个好 benchmark,它未必是那么 universal,未必是那么大的朝着 AGI 去的,但是它就确实体现了大家的体验吧。
允中|00:25:09 在这个角度上来说,那 benchmark 肯定是有千奇百怪的,你总会找到一个场景。
允中|00:25:16 我觉得可能是两个要素,就是说,这个场景的这个 gap,它是不是体现了一个非常具体的能力的缺陷?
允中|00:25:21 如果只是因为这个场景,一些场景知识不太懂,同时这个场景又不太重要,
允中|00:25:25 就是我在一个街角嘎啦里面,我解了一个什么很奇怪的智力题,出了一个 benchmark,
允中|00:25:32 这个能力提升了,未必代表这个模型本身的认知能力提升了,那么可能就不是一个好的 benchmark。
允中|00:25:46 另外一块就是说,就算不反映核心的能力,它至少反映一个大家在意的场景,比如说现在特别火的是 Personal Assistant,就是这个 MUSE,这是一个很具体的场景,大家都希望有这么一个东西,那么这个 benchmark 它甚至未必测的是模型本身,它可能还测了你的 Harness。
允中|00:25:52 最后这个 benchmark 它甚至不是为了卖模型的训练数据,而是告诉你我的 harness 错在哪。
允中|00:25:57 可能我可以做些工程优化,就是贴近大家需求场景的 benchmark 也是好的 benchmark。
一铀|00:26:03 所以在我看来,一个是反映了核心的认知能力,一种是贴合场景,当然两个都有的话是最好的。
一铀|00:26:08 我觉得最重要的,现在大模型公司很看重的一个就是 benchmark 的分布。
一铀|00:26:11 大家应该可能都听说过 Artificial Analysis 这个评测体系。
一铀|00:26:17 他们其实做的事情很简单,就是把各家 benchmark 给不同的权重,然后把它综合到一起来,得到一个分数。
一铀|00:26:24 但这样它就存在一个问题,它这个分布的权重是不是真的是大伙需要的权重?
一铀|00:26:27 每个权重以什么方式去进行迭代,这个都是挺主观的一个事情。
一铀|00:26:31 大家质疑的更多不是这个模型本身,而是质疑这个榜单本身。
一铀|00:26:38 我现在倾向于认为大家,可能 benchmark 还不够好做到大家心目中要的 distribution 那种级别,很难达到一个 ground choice。
一铀|00:26:45 所以现在很厉害的模型厂商,比如 Anthropic 或者 OpenAI,他们都会倾向于去自建一个评测体系,来让它更接近他们心目中的分布。
一铀|00:26:49 只不过第三方的评测可以让他们对外发布的时候更有说服力一些。
一铀|00:27:06 当然比如说允中说的一个垂直领域的肯定是非常重要的,因为这个就是面下一类群体,它这个分布就是那个群体需要每天在做的事情,如果它能把那个分刷高,比如金融啊法律啊,他们律师每天做的事情,能把那个做扎实的,那他们法律只需要看这一个 benchmark 就足够了。
一铀|00:27:10 第二点就是允中提到了有些 benchmark 它并不能代表真实人生
一铀|00:27:13 比如说之前有一些 benchmark 它是测 Agent 智力的
一铀|00:27:15 就是玩那种小游戏那种 Arc Challenge 那种游戏
允中|00:27:16 对 Arc 2、Arc 3 这种
允中|00:27:22 它这个 benchmark 的初衷是是说觉得能解这些游戏是人类的一个智力的体现
允中|00:27:27 但是没想到就这个智力其实也是可以做到特别特化
允中|00:27:28 我一个小模型也能把它搞出来
主播|00:27:29 还挺有意思的
主播|00:27:37 那有没有什么特别 niche 的 benchmark,但是可能大众不太了解,但其实是非常有用的测试这个模型能力的例子?
允中|00:27:42 我可以举个我们的例子,我们有一些 benchmark 可能不太经常出现在大家的榜单上。
允中|00:28:00 比如说我们前一阵子做的 Drug Discovery,还有一个跟 AI Tutor 相关的,他可能关心的是一个比较小的垂直领域,但是跟我和各个 Labs 的交流,负责相关领域的团队,他们通常就会有这么一个人,他们会看市面上跟他领域相关的评测,他都会把它收回来。
允中|00:28:17 另外一个就是说这个 benchmark 最后上不上榜单火不火其实也有很多随机因素比如说 AA 就有一个很好玩的事 AA 用了我们做的一个榜单叫 SWE Atlas 我们当时是做了几个不同风味的 SWE Test 其中有 Q&A 就是代码仓库问答
允中|00:28:37 还有代码重构,还有写 test,只不过我们是分三个阶段推出的,是 Q&A 先推出,推出之后呢,我们还没来得及把另外两个推出,把它们合在一起,然后 somehow 那个 Q&A 就先被 AA 捡去了,Q&A 上了 AA 之后呢,大家就开始 cite 这个东西,突然间就这一块需求就变大了,我们当时想得很不理解。
允中|00:28:48 Q&A 是最简单的一个场景,就是我们花了那么多心血做了更复杂的 benchmark,结果就是因为可能是时间关系,还有的时候是某一个 lab 用了可能是碰巧它的分好。
允中|00:29:03 这里面其实是有一些随机因素,就是你在这个榜单上,就大家 Tech Report 上看到的东西呢,有一定随机性,AA 收这些榜单有一些随机性,最后就是你没看到的东西其实背后可能也有人在用,就这个生态其实水还比较深,还比较复杂一点。
主播|00:29:21 明白,一铀其实我还想再问一下就你刚才提到的大家对于 Artificial Analysis 这样榜单的质疑,然后你觉得说是不接近于大家理想中的分布,这个分布现在有没有一个共识呢?因为我理解每个模型公司对于分布的需求其实也是不太一样的是吧?
主播|00:29:25 如果是在这种情况下的话,我们怎么样去理解这个理想状态下的分布?
主播|00:29:30 它是应该比较接近真实世界的这样一些任务,还是说是别的分布?
一铀|00:29:34 我觉得真实的分布其实本质上就是大家的用户体验。
一铀|00:29:39 就是世界上假设说存在这样一个 Ground Truth,就真实的分布的真实的打分。
一铀|00:29:42 其实有点类似于 LM Arena 这种模式。
一铀|00:29:49 假设说你每天 prompt 这个 agent 的时候,你能够有多条模型一起在执行,然后给他们打分。
一铀|00:29:50 这是最真实的评价。
一铀|00:29:54 但是这个现实生活中能够做到这样的榜单有那么以下这种因素。
一铀|00:30:04 LM Arena 之前做好是因为之前的 QA 它这个很快,它开销很低,你给它一个问题,它能够几秒钟之内给你个答案,你很快就能进行打分。
一铀|00:30:07 但现在在 Agent 的时代,一个长程任务动辄几个小时。
一铀|00:30:15 一个用户也没有那么多的超能力,每次执行一个任务都连着开几个 agent 一起去执行,然后也没有个机制去反馈把它收集起来。
一铀|00:30:20 所以说大家的评价很多都是一个偏主观的,它很难拿到这样一个真正的 ground truth。
一铀|00:30:25 但如果说有哪家公司或者有哪家有某种方式解决了这个问题,那肯定很厉害。
一铀|00:30:28 但我相信他们大模型公司内部肯定是有这样一个机制的。
一铀|00:30:34 就是让它有几个版本的模型,然后有一些用户它是真实用了这个东西,然后去测。
允中|00:30:41 我的意思是假设有这样一个 distribution,然后你这个评测的分数的分布接近于这个东西,那它就是一个很好的 benchmark。
允中|00:30:49 我听到一些比较有意思的,很多评测 benchmark 跟我线上做 AB test 测出来的结果是不一样的。
允中|00:31:07 用户的反馈跟评测其实有时候不太一样,甚至很难说哪个好,因为用户有时候也比较主观嘛,像这种聊天的,你可能给他特别多这种 factual 的东西,versus 给他很多这种 clickbaits,就说他爱听的话,可能这个结果也不一样,所以这块还是挺复杂的。
一铀|00:31:08 对,是这样的。
一铀|00:31:12 就像 Claude Code,我觉得在 LM Arena 那上分数一直遥遥领先,
一铀|00:31:13 就是因为我觉得 Claude Code 它有个特点,
一铀|00:31:15 尤其中文用户或者英文用户,
一铀|00:31:19 它给出来的 output format 更贴近于人们心目中想看到的,
一铀|00:31:20 就非常容易去理解。
一铀|00:31:23 相反的,Codex 它可能执行的更细致一些,
一铀|00:31:26 但是输出的东西就没有那么容易去相对的没那么理解,
一铀|00:31:27 所以说稍微吃了点亏。
一铀|00:31:29 但我个人体验用户下来,
一铀|00:31:30 他们两个可能是不相上下,
一铀|00:31:33 其实我个人还更偏好于 OpenAI 那边一点,
一铀|00:31:34 因为它做的更细致,
一铀|00:31:37 发生的错误更少。
一铀|00:31:35 所以这个确实也是很主观的一个事情,去怎么定义好这个 distribution。
主播|00:31:39 所以在这种情况下,模型公司还会把 benchmark 视为判断自己模型能力的一个标准吗?
一铀|00:31:45 他们肯定也是在乎外部的评价。
一铀|00:31:47 不同模型公司,我先说美国那几家大的,他们肯定是倾向于自建为主,就是自家的 evaluation 团队,因为他们有这个能力去建。
一铀|00:31:54 但是对于一些比如说刚成立的或者相对没有那么有名气的一些 frontier labs﹐
一铀|00:31:58 或者他不是头部的 Frontier Labs,他们肯定是会非常依赖于外部的评测,因为他内部的评测团队可能没有那么有经验或者那么完善,或者说他们的人力资源更希望投入到模型的训练和开发当中,而不是去直接利用,所以每个公司的策略都不太一样。
允中|00:32:13 其实我的个人判断是说,当一个产品逐渐成熟之后,或者当你积累了一定体量的用户之后,最后你其实关心的还是用户增长。
允中|00:32:22 比如说我之前其实做了很多年,在 Meta 做搜索跟推荐,逐渐的就变成了一个类似搜索推荐的问题,就你看什么样的指标跟用户增长最相关。
允中|00:32:31 最后就是朝着赚钱的方向走的。
允中|00:32:34 现在可能真正能够评测到这个能力的 Lab 不太多,需要一定的用户体量,可能在这个聊天的场景就比较成熟了,但是呢在这些 Agent 的场景上呢,能做到这个程度就更复杂一点。
允中|00:32:46 大模型可能跟传统这个收推不太一样的地方就在于说它的场景很复杂,就算我能够在这个 chat 场景做好很好的这个 AB test,甚至训这个 reward model 来朝用户喜欢的方向发展,我总会有新的东西出来,而且大家一直在看新的东西,比如说现在大家都在卷这个科学发现。
允中|00:33:02 科学发现我不可能有足够量的科学家给我显著的 AB test 的结果,必须还是要依靠场景构造 benchmark。
允中|00:33:09 我会说因为大家对这里的应用场景的期待太高了,场景增长的速度赶不上我在这个领域用户沉淀的速度,还是有大量的需求要依靠这个 benchmark 来做评价标准。
允中|00:33:19 但我会觉得在某些领域沉淀下来之后,大家会有更多的线上评测体系,然后可能会像这种传统的互联网增长,看看哪些指标跟用户的 DAU 增长更相关。
主播|00:33:30 对,能不能深入讲一下数据采购这件事情,我觉得就是有几个点非常有意思。
主播|00:33:35 第一,你提到了刚才有很多小的公司其实是现在一个创业机会嘛,
主播|00:33:39 只是为什么我们看到很多最近新起的一些四五个人甚至两三个人的这些数据创业公司拿到了非常高的估值,
主播|00:33:47 这是不是就是因为他们的目标就是这些非常垂直的领域的数据?
允中|00:33:52 对,我觉得这里可能有几块问题。
允中|00:33:55 首先,我觉得最近兴起的这些 RL Environment 公司其实更多的是在做合成,
允中|00:34:02 因为整个数据行业已经从找人标注慢慢地过渡,你要交付的是一整套环境。
允中|00:34:07 然后这个环境可能需要大量的工程工作在里面。
允中|00:34:11 很多在这些合成的技术栈上做得比较好的一个小团队,
允中|00:34:15 其实可以比较短的时间交付大量的合成环境,
允中|00:34:18 这些未必是不好的,
允中|00:34:19 就合成它有时候你也可以基于一些强的模型,
允中|00:34:22 或者说基于一些半成品的这些 artifact,
允中|00:34:26 是可以做出一些好东西来的。
允中|00:34:27 现在这里是一块增长,
允中|00:34:28 但是再往下走,
允中|00:34:30 这里面比较有意思的就是说,
允中|00:34:32 这个东西之所以能成立,
允中|00:34:33 因为大家今年的主题是在卷代码,
允中|00:34:35 软件行业是最奇怪的一个,它非常的 open,有大量的公开资料,而且我们生产数据的公司同时大家都懂代码,所以就这个比较好解决,让一些小的团队有很多机会可以自己造很多数据。
允中|00:34:48 但是我觉得再往后面走,比如说这些其他领域的垂类就更复杂了,这里面我会看到了有一些公司,他们可能解决两个不同的问题。
允中|00:34:57 比如说像我们做后训练数据,其实在我看来是两个问题,第一是采购,就是我要把原材料买回来,就好像 ALE 让大家上传,对吧,这是一个比较新的激励机制。
允中|00:35:06 然后加工,加工就是我们再把它标注或者是通过一些 agent pipeline 把它做成适合大模型训练的环境。
允中|00:35:13 在这个垂直领域问题上呢,其实采购变得越来越复杂,就甚至代码领域,其实采购一些私域的这个代码仓库啊,谁能把这个问题解决好,其实就是一个巨大的优势。
允中|00:35:23
允中|00:35:31 在垂直行业,比如说我如果是做芯片设计的,
允中|00:35:35 我可能要把整个芯片设计的环境给造出来,可能当中涉及到一些商业软件,那我怎么样把这些商业软件的版权拿到,把它包在这里面,就是一个问题。
允中|00:35:53 还有一个就比如说做 DevOps,我要是一个系统工程师,我要操作什么 AWS 之类的,然后我只要有个公司做了一整套 AWS 模拟器,每一个垂类的这个环境都有一些很深的东西,你可能要采购,可能要定制软件,大家抓住一两个垂类,把这个东西做好,其实创造了很多新的机会。
主播|00:36:07 明白,因为刚才我们提到这些垂直场景,比如说在 Drug Discovery 这些生物医药方面的,还有一些具体行业的评测下面,我们可能没有足够的场景,或者没有足够的好的评测,在这种情况下我们有足够的好的数据吗?
允中|00:36:09 这里其实有一个难点。
允中|00:36:18 每个领域它需要一些人把他的专业知识吐出来之外,我还需要这个领域的这个东西,像药物发现,然后可能需要很多一些私有的数据库。
允中|00:36:25 这里面我觉得是目前这个行业一个大的卡点,就是你先要能把这些东西买到,你知道大家手上有什么,才能把它做成 benchmark。
允中|00:36:28 ALE 其实很大程度上是在解决这个问题。
一铀|00:36:34 对,ALE 就是希望大家能够以众包的方式,让专家把自己做过的 project 交上来。
一铀|00:36:45 当然这里面有一些不符合规范的我们都筛掉了,因为他们甚至把一些非常死的东西都交上来了,比如说什么法院的一些证据什么,就是非常,对,然后我们尽量把这个都筛掉了。
一铀|00:36:59 比如说我们现在在 V2 中我们也尝试去收一些数据,比如说 Steam 上的一个游戏库,就游戏开发的一个任务,它一个那种名不见经传的一个大概几千人体量的一个 Mobile 的游戏,它要价能要到两三百万人民币一条。
一铀|00:37:03 我觉得哪家数据公司或者做 benchmark 都没有这个财力去做这个事情。
允中|00:37:07 就是这个游戏公司会要加油到两三万一条。
允中|00:37:09 要这个游戏的源码。
允中|00:37:12 就比如说很多公司想要采一些游戏的视频,
允中|00:37:14 然后做一些标注,游戏视频可能是版权数据。
允中|00:37:17 这里有一个巨大的采购问题,
允中|00:37:19 我觉得这里是一个商业机会。
允中|00:37:21 我现在其实看到不少 Starup 在解决这些问题,
允中|00:37:25 就绝大的数商我们自己也在投入做一些采购方面的工作。
允中|00:37:26 但是总体上来说,
允中|00:37:28 我觉得这里很有巨大的问题没有被解决。
主播|00:37:33 有哪些现在非常热门的垂类是数据非常少的?
允中|00:37:42 我会说至少医疗算一个,就是数据比较敏感,就是谁能拿到大家的病例数据,那就非常有优势。
允中|00:37:55 对,因为其实也有很多新闻讲到说可能在法律或者金融的这些领域会有一些之前离职的员工可能会去分享他们的工作流,不过可能工作流数据和像医疗数据里面这些病人的 data 还是不太一样。
允中|00:38:04 是的,各个领域,我觉得甚至现在大家之所以都在说金融、医疗,只是因为跟大家比较息息相关吧,大家多少还懂一点。
允中|00:38:16 其实这个世界上有很多我都不知道的行业,就是你真的要跟他们聊才知道,就比如说我才知道就做这个药物研发,大家还会交易这些分子,一个分子还能捣腾几套子里面还要做 DDI。
一铀|00:38:18 所以可能没有做只是因为大家不知道。
一铀|00:38:38 大概有 3000 个节点。
一铀|00:38:40 然后我们也做了一下工作,
一铀|00:38:43 就是把现在已有的市面上的 Life 和 Bio 的 benchmark,
一铀|00:38:45 已经覆盖了多少,
一铀|00:38:46 做了一个统计,
一铀|00:38:49 大概是可能 10%、5%都不到。
一铀|00:38:50 现在它连一个成型,
一铀|00:38:53 就是覆盖面完全的一个 benchmark 市面上都没有,
一铀|00:38:55 更别说是针对这个去做相应的数据。
主播|00:39:02 明白,那像我们刚刚提到了这些做合成数据的小公司,他们能赚钱的周期有多长呢?
允中|00:39:08 因为听起来好像都是这几年新出现的这样一些公司,这些数据它的生命周期有多长呢?
允中|00:39:18 嗯,这是个好问题,至少现在需求还是挺大的,然后未来可能说比如说这一波 coding 讲完了,那么他们需要新的品类,大家能不能抓住下一个机会。
允中|00:39:40 而且下一个机会可能跟你现在的运行模式不太一样,比如说我自己也会觉得采购会很重要,那么采购能力比较差的可能就比较难,或者就像 ALE 他们,你可能有些新的激励机制,让大家把东西交进来,对吧,所以可能以前的一个激励机制是招聘平台,或者就给你一个小时工,但是以后可能有新的激励机制,就谁能把这些东西玩了转,可能会继续有一些优势。
一铀|00:40:05 这个地方我想问一种你的看法,因为我个人认为随着模型能力越来越强,模型公司自己内部创造数据的能力也越来越强,这一点你认为这个饼是越来越大的,但有没有可能会出现一个情况,这个饼面向于非头部公司的这个机会反而是门槛是越来越高的,入场券是越来越难拿的,就是数学这块领域,之前的话大家只是要去影印那些奥数课本,
一铀|00:40:14 就能够去批量造出大量数据,但这些数据现在基本上是零价值,所以你是怎么看待这个趋势,就未来的数据公司的这个发展方向,对。
允中|00:40:23 我会觉得从第一性原则上来说,还有巨量的问题没有解决,你要想这个世界上还有多少东西没被蒸馏干净,是巨大的机会。
允中|00:40:30 但是如果你就看现在大家是怎么运行的,这个事情当然会越来越难,因为越来越多的这个玩家进来了。
允中|00:40:34 我觉得大家如果只盯着我手上的工作,这个一定是越来越难做的。
允中|00:40:38 就算这个 Labs 不自己做,越来越多竞争对手进来,你的 margin 也会越来越低。
允中|00:40:43 所以在我看来,一个好的数商其实最后解决的是个研发问题了。
允中|00:40:48 就好像一个软件公司一样,我要提前投入未来大家需要的东西,赚到钱之后再投入下一个东西。
允中|00:40:55 在 Lab 本身呢,我有个暴论,可能 Lab 是未必有最好的基因来解决数据的问题。
允中|00:40:57 这里面可能有几块,比如说合成数据。
允中|00:41:09 合成数据其实按理说很多就是这个 Lab Research 的本职工作了,尤其是搞后训练的,大部分时间都在画在搞数据上,就是买数据、核数据、验证数据、洗数据。
允中|00:41:12 但是这个领域你会觉得为什么外面的人会有机会呢?
允中|00:41:18 SumUp 今年的这一波增长都来自于一些懂行的人在外面把这个数据合了再卖回去。
允中|00:41:20 所以这个事情是存在的。
允中|00:41:23 我觉得一方面是因为大模型公司现在有太多的钱了,
允中|00:41:26 就是你自己造外面买其实也不矛盾。
允中|00:41:31 但是在更长远上来说,其实有很多问题可能模型公司没有太好的基因解决。
允中|00:41:41 比如说,如果我要采购,我要把一些行业的东西先采购回来,蒸馏出来,这个时候我会觉得大的 Lab 可能未必有那么大的优势,它甚至可能会有一些 conflict of interest。
允中|00:41:52 比如说,一方面把你的 FDE 派到了人家企业里面,然后另一方面你有一拨人在搞这个企业数据,那么我会觉得如果我是一个企业,我是不太放心把我的数据交给你的。
允中|00:41:55 出于这些原因,有一些东西可能 Lab 不太适合自己做。
允中|00:42:01 他可能还是需要第三方的人帮他做一些采购,或者深入到一些行业领域里面去。
允中|00:42:09 我会觉得一个数商真正要做的事情是研发,看看未来还有哪些行业是重要的,这些行业有哪些东西我要值得投入,把东西买回来。
允中|00:42:20 然后我自己先投入 R&D,把这个行业的问题给研究清楚,然后再把它做成 benchmark 或者说是数据,甚至证明这个东西的有效性,然后我再转手卖给 Lab。
允中|00:42:22 从 Lab 来说,大家的 deadline 都很死。
允中|00:42:30 如果我是一个 Lab 的 Research,如果你让我花半年的时间来解决一个行业,可能有时候大家其实没有自由度。
允中|00:42:36 就是这个时候你看到,那边有一个数商说,我把那个行业的东西搞清楚了,你要不要?大家通常都会看一眼。
主播|00:42:39 所以我觉得其实长期来说拼的还是一个研发能力。
主播|00:42:43 你觉得这个趋势对于大模型公司来说会持续吗?
主播|00:42:46 因为现在模型公司里面也有自己的数据团队嘛,
主播|00:42:49 但是你觉得他们更愿意去从第三方那里收数据,
主播|00:42:51 而不是自己去造环境造数据?
允中|00:42:53 这里我觉得可能不矛盾吧,
允中|00:42:56 因为最后模型公司最高的优先级还是把东西做好,
允中|00:42:59 如果他们自己能生产好的数据的话,
允中|00:43:01 有可能会倾向于自己生产,
允中|00:43:05 只是现在大方向上来看,
允中|00:43:08 这个世界上还有太多的工作流没有被折腾清楚了。
允中|00:43:12 对外部数商的依赖,我觉得是长期存在的。
允中|00:43:18 甚至一个大模型实验室自己可能未必想要投入那么多的资源,做的这么重,可能更 prefer 灵活一点。
允中|00:43:24 缺点就是说,大家可能希望更多的东西是第一方的,不希望所有人都能从数商中获得这些能力。
允中|00:43:28 所以从这个角度来看,会有一定的动机自己研发。
允中|00:43:34 比如说现在很多 Labs 在做 Expert Matching,就是说你把人拍到我这里来,也有这么一些趋势。
允中|00:43:37 我自己也会觉得说,现在有太多东西没有被解决了。
允中|00:43:41 不管是谁把这些问题解决了,那他一定是有赚钱的机会。
允中|00:43:47 这个东西可能跟在哪里发生不是很有所谓,现在是机会多,比你在变大的这么一个阶段。
主播|00:43:58 但这也是大家对于数据一直有一个问题,也就是说如果一个第三方供应商把同样的数据卖给不同的模型公司,那他中间怎么样去区分呢?
允中|00:44:03 这里通常来说有个比较简单的解决方案,就是说你可以花多点钱把这个数据买断。
主播|00:44:12 你觉得对于模型公司来说,在数据供应商收到那么多数据的情况下,他们怎么样去使用这些数据,这个流程能不能给我们讲一下?
允中|00:44:18 这里面一般来说它是有一些比较固定的训练方式,我们把它叫 training recipe。
允中|00:44:24 比如说像是比较简单的这种数据,可能就是直接 SFT,就是我把对的答案给他就行了。
允中|00:44:30 然后像是 Rubric 这一种,他可能就是在做强化学习,因为就是不停的有一个模型在给他打分。
允中|00:44:37 比较有意思的是现在这些 RL 环境,比如说最近大家在卷的一些特别长省的任务。
允中|00:44:52 现在今年的一个主题是 RSI,就是 Recursive Self-improvement,它其实是个 buzzword,就是说 AI 自己研发自己,大家最近就在看那些我跑一把,可能要跑个几天一个星期,其中你可能要有个 GPU,等等在上面模型训模型的任务。
允中|00:44:56 这里的训练方式其实就开始变得有一些模糊了。
允中|00:44:59 我们也在一起研究这里面的训练方式要怎么搞。
允中|00:45:05 但是我自己就觉得这里面其实还没有太多的共识,所以还有很多有意思的空间。
允中|00:45:12 就对于数商来说,有时候也不完全是就造一个模拟的 task 这么简单,你还要考虑到它模型公司拿去要怎么训。
一铀|00:45:15 然后针对它怎么训,可能还要有一些定制。
一铀|00:45:41 对,这一块我也比较好奇,如果说你就是为了 benchmark,你就是你拿 ALE 的一些任务,你直接去训练,就类似做一批这样的数据,那你怎么保证这个数据它训练出来,它模型能力、泛化能力是能够提升,能够被迁移到其他的任务上去,然后这个东西有没有一些比较系统化的、科学化的方法来做这样的验证呢?如何在不吹一个模型之主上,然后能够评判这个数据能给模型带来怎样的提升?
允中|00:45:48 对,我觉得这里其实有一些技术,比如说现在如果我要造一个环境,大家最怕的就是 Reward Hack,就是它有捷径。
允中|00:46:00 如果明明我没有完成这个 task,我可能是做死了一些手脚,结果 somehow 我的这个分可以打得很高,就是我迅速来这个模型肯定会变成一个耍滑头模型。
允中|00:46:18 这种东西肯定是不希望发生的。那么通常来说会有一些技术我可以用 agent 来做这个 red team,就是我会让一些比较强的模型来试试看能不能在这个 task 里面找到捷径。另外就是这里面很多是我自己的个人猜想就不代表 scale AI 或者任何客户,就是说在
允中|00:46:24 训练这些东西的时候,很多 benchmark 我们可能只关心最后有没有完成这个任务,就是我们验证器是围绕这些东西设计的。
允中|00:46:29 但是我怎么样完成它,这些东西可能也会在模型训练里面有一些关键作用。
允中|00:46:37 一个比较 trivial 的例子就是说,budget,就比如说我训模型的时候,我会关心它是不是消耗了过多的 token 或者用了这些步数。
允中|00:46:48 那么我们在训练它,比如说在拿 ALE 的模型数据训练的时候呢,肯定我最后的 reward 会很复杂,不是说我把这东西解出来就行了,我可能还关注它消耗了多少资源。
允中|00:46:57 最后可能是在各种各样维度的检查 reward,防止它作弊,这些东西结合起来,才能完成一个训练的 recipe,其实就感觉也没那么简单。
允中|00:47:03 这些可能是训练数据更多要考虑的问题,就是说我这些数据能不能导出一个比较好的训练方式。
主播|00:47:15 能不能讲一下像 RSI 或者就因为刚才我们也提到很多 Neolab 嘛,像在这些情况下做这些训练需要的数据有什么不一样吗?或者需要的定制有什么不一样吗?
允中|00:47:18 通常来说最常见的定制其实是难度。
允中|00:47:28 大家做 benchmark 的时候一般来说至少希望它不那么饱和,那就意味着越难越好,但也不一定,比方说一游说的也不要就完全解不出来。
允中|00:47:33 就是 benchmark 的难度更多的是一个客观的反映我这个行业难度的事情。
允中|00:47:38 但是在我续模型的时候需要做一个特化,就是说这个难度对他的模型要是适中的。
允中|00:47:45 我们有时候会做这个事情,模型厂商会把他甚至还没有发布的这个模型给我们,然后我们帮他筛数据。
允中|00:47:53 这个题目对他来说不能太难,也不能太简单,因为现在做这个强化学习是说让模型在上面自己试,如果试对了的话,他就能学到一些东西。
允中|00:47:56 那我给他提太难了,他啥也做不出来,肯定就不行。
允中|00:47:59 所以在这个难度上会做一些适配。
允中|00:48:02 然后另外可能我们会做一些轨迹采集,
允中|00:48:05 就比如说如果你把你的模型的轨迹给我们,
允中|00:48:07 我们可能把这些轨迹采集出来,
允中|00:48:09 然后帮你做一些筛选,
允中|00:48:13 甚至我们想办法用人给你搞一些可以解这些问题的轨迹,
允中|00:48:15 这样你可以拿回去不需要做强化学习,
允中|00:48:17 你可以直接到这个轨迹做 SFT。
允中|00:48:19 针对他的这个训练需求,
允中|00:48:21 其实也有一些特化的这种工作。
主播|00:48:31 接下来还想再聊一下数据污染的这个问题,因为今年 2 月的时候,OpenAI 就宣布停止报告它在 SWE-bench Verified 里面的分数。
主播|00:48:40 这个其实也是一套评测,具体来说就是让 AI 修复真实开源软件里面的项目问题,再通过这个测试来判断它有没有修好。
主播|00:48:49 当时 OpenAI 主要是指出了两类问题,一类是它测试本身可能会有缺陷,比如说有的功能上正确的解法也会被判错。
主播|00:48:59 另一类就是数据污染,这个我觉得很有意思,它们发现是在特定提示下面,模型能够附现部分题目原本的人类修复代码。
主播|00:49:04 也就是说模型很可能在训练过程当中就已经接触过相关内容了。
主播|00:49:07 所以这个分数就变得有点难解释了。
主播|00:49:11 我想问一下两位是怎么理解数据污染这个问题的呢?
允中|00:49:17 就 SWE-bench 这一类数据其实有一个问题,它可能甚至还不是污染,就是它 task 可能就做得不够好。
允中|00:49:29 就比如说有时候有一些错误是假错误,就比如说可能我的测试脚本要求的太多了,或者是我的 task 没讲清楚,有这么一些类型的原因吧。
允中|00:49:34 另外一个污染可能是说模型育训练的时候把这些东西都训练进去了。
允中|00:49:38 这里面其实是有一些技术可以检测到这些东西。
允中|00:49:40 我想这个 ALE 上面应该会有一些这种经验。
一铀|00:49:45 要不然他说不采用 SWE-bench,他是连 SWE-bench Verified 也不采用。
一铀|00:49:59 就是当一个 benchmark,我印象中它是在过去的六个月内只从 74%提升到了 80%,然后剩下的那些问题可能是脚本写得太 harsh 了,或者它的题目本身就是不可解,或者就是会有各种各样的问题。
一铀|00:50:04 然后它剩下的可能 20%都是集中在这个问题上,那这个 benchmark 本身可能就失去了它对比的意义。
一铀|00:50:14 ALE 也没有解决一个问题,这个也想跟云龙探讨一下,就当一个专家他本身提交上来的材料本身是错的时候,我该如何去预防这个问题?
一铀|00:50:28 这个是我们真实发生过的,因为我们专家这个五花八门了,当然这个见的人很少,他是为了提交这个任务,然后为了拿到作者,因为我们的奖励机制就是你提交了这个东西,然后我们接纳了你这个任务,就能被纳为作者的列表的一部分。
一铀|00:50:42 确实是有人为了提交而提交,然后他甚至持了 agent 去合成了一堆乱七八糟数据,甚至有些数据交上来,我肉眼看出来他就是编的,这个东西是确实对我们工作造成了很大的困扰。
允中|00:50:47 这是个特别大的问题,Scale 总是有人,总是可以靠人解决的。
允中|00:50:54 这里有个特别有意思的问题,比如说一铀提到了我给他这个 Authorship 是一种奖励机制,那他会带来一定的问题。
允中|00:50:59 比如说就 Scale,那更原始的,比如说我就给你小时工,那大家也有一些偷懒作弊的方案。
允中|00:51:03 我会觉得这个奖励机制是个特别特别难的问题。
允中|00:51:07 长远来说,比如说我的目标是把人类都蒸馏干净,对吧?
允中|00:51:10 怎么样设计一个好的奖励机制?
允中|00:51:17 把大家的目标都 align,我觉得这里其实有特别大的空间,这里可能是个巨大的 research area,我自己心中可能有一些方案。
允中|00:51:32 Proof of work,就比如说我要求你把做这个东西的一整段工作流程全部都录下来,你必须要做到多少时长或者怎么样,不同形式的问题它有不同形式的奖励和验证机制,这里面其实有很多玩法值得大家探索。
主播|00:51:45 这里面其实也涉及到一个更大的问题,就是很多数据它本来也就是公开数据嘛,就是网上的一些资料啊,公开代码啊,这些东西,所以这些数据是不是本身就注定了会有污染,一般是怎么样处理这些情况呢?
一铀|00:51:49 其实最简单的污染你直接问 agent 他都能找到。
一铀|00:51:52 公开数据其实还好检测,我觉得最难的是编造数据。
一铀|00:51:58 比如说让你去做一个化学模拟,就他根本就没有跑过这个任务,他自己编了一套似是而非的东西。
一铀|00:52:01 你没有个几个月根本查不出来这个问题,因为他看上去很真。
一铀|00:52:10 什么时候能发现这个问题?当所有的 agent 他的能力基本上远超这个问题本身的时候,他发现所有的答案他们都是做出来是一样的,但是跟这个真实答案是不一致的。
一铀|00:52:14 这个时候我们就会查出问题,但这个周期会非常长。
一铀|00:52:21 但是你让另外一个专家去验证这个问题,它成本又非常非常高,因为它本身这个问题它都是要专家花一个多礼拜或者两个礼拜才能做出来的。
一铀|00:52:24 对,然后那个验证的专家你要保证他。
主播|00:52:29 验证的专家他本身也会为了一些东西偷奸耍滑说这个东西,哎,它就是对的。
主播|00:52:32 所以每个涉及到专家评测都会有这个问题吗?
一铀|00:52:36 对,都会有众包的 benchmark,为什么难做,就是难做在这里,人性是非常复杂的。
允中|00:52:57 是,我觉得这里他可能甚至验证是一环,我自己觉得确实在奖励机制上,比如说,如果你就让他真的老老实实待着做 12 个小时,对吧,就你给我合起来假数据,你也要把每一步都给我交出来,要求你必须做这么多的动作,那他可能就没有那么大的动机给你合假数据了,这些是比较值得研究的方向。
一铀|00:53:15 嗯,很有意思。其实我本来是想问一下真实工作流的数据,但是听下来大家现在还是在卷 coding 数据是吗?就不是在做真的 workflow。因为我理解是比如说像 Mercor 这样的公司就是有在卖一些真的 workflow 的数据,但是听下来 coding 现在还是这个赛道最卷的。
一铀|00:53:17 其实你怎么定义真实工作流的数据?
一铀|00:53:21 就真实工作流的数据本质上它都能够被划归到一个 coding 的问题。
一铀|00:53:23 就是说对 3D 建模这个问题,
一铀|00:53:28 其实有很多比如 FreeCAD 什么它都是提供了现成的 API 让你去做这个事情的。
一铀|00:53:30 就是这不是传统意义上的 coding,
一铀|00:53:32 就是让你去写一段代码去解一个 lead code 的这种 coding 题。
一铀|00:53:35 它是用 coding 去解决真实 workflow。
一铀|00:53:38 所以说只要有足够的 MCP API 调用,
一铀|00:53:43 它其实本质上 95%以上的任务都能够被划归到 coding 的问题上来。
允中|00:53:53 对,就是可能有一些小的,可以看它这个 task 本身是要的什么东西,它涉及到的一些环节是什么,能把它归结到不同领域的工作流上去。
主播|00:54:02 但是就我像一铀说的,现在因为你让 agent 来做事情,代码就是他的手跟脚嘛,所以它其实归根结底,coding 肯定是其中的一环。
主播|00:54:16 明白。你们觉得在私有数据需求依然很大的情况下,未来的数据公司会不会从卷采购本身变成卷并购,就是去收购一些垂直领域的公司?
允中|00:54:32 对,不评论 Scale AI。我是听说有一块很大的 Private Equity Business,就是说以前大家是 Flip 公司嘛,现在 Flip 公司的一个新的方式就是说我买了这个公司,然后我用 AI 让它提效,把一些人裁了,之后呢把这个公司的价值做上去再把它卖了。
允中|00:54:41 现在就多了一层,就是除了我买这个公司,可以把它重组打包用 AI 提效之外呢,我还能把它的数据发掘出来,它的数据还能卖一些钱。
允中|00:54:54 所以就是让这些整个买公司的行业又多了一个玩法,就很自然的,大家就是数商或者就传统做 Private Equity 的公司也在看这个数据怎么能够卖钱,然后就兴起了一整个领域。
允中|00:55:00 我甚至觉得说,如果真的未来比如说五年十年还是这个速度发展。
允中|00:55:07 大家还没有遇到瓶颈的话,把各个行业的东西都给拿出来,可能这个东西跟大模型本身就是世界上最大的两个行业。
允中|00:55:12 当然这是比较极端的,这个 AI do, miss, do, view,可能会导出这么一个世界。
主播|00:55:21 嗯,是的,但是听起来其实数据行业本身也是在变化的非常快,因为就像我们刚才提到从这个 Rubric Data 到 RL 环境的这样一个变化。
主播|00:55:27 所以有什么信号会让你觉得有某一个领域或者某一个赛道它可以持续的增长吗?
允中|00:55:31 我会觉得首先还有很多没有解决的问题,机会还是很多的。
允中|00:55:39 另外一方面有越来多的玩家进来了,比如说每年都有很多新的 New Lab,资本市场还是以这个方式运作的话,这个饼是越来越大的。
允中|00:56:03 但是这个数据变化很快,不太像是一个我可以躺在一个地方一直吃老本的生意,数商要疯狂地迭代自己,那么最后可能是拼大家的 R&D 的能力,或者说谁能把这个 R&D 的这个能力本身固化,做成一个 flywheel,我有一个流水线可以一直在发掘新的东西,也许这个是未来最大的优势,但是就这东西上来说,我会觉得现在是百花齐放吧,未来机会还很多。
一铀|00:56:09 这我也是从一些地方听说,就是数商的它估值空间一般没有传统的这个公司来的大,
一铀|00:56:17 就是因为它很难把这个杠杆保持住,然后让你以很轻松的方式在一个积累的用户量情况下就能躺在那里吃老本挣钱。
一铀|00:56:23 就像 Facebook、Google 的一些业务,它已经有积累大量用户,它就能躺在这些 APP 上转钱,但数据生意呢,
一铀|00:56:28 领导者必须持续地去思考下一步在哪里,持续地去迭代,因为模型迭代速度太恐怖了。
主播|00:56:29 嗯。
主播|00:56:33 你觉得你们现在在做 ALE 2.0 的时候最难的是什么?
一铀|00:56:39 我觉得学术上相对容易一些的,比他们 Scale AI 再做上一上,因为他们给我们的数据很多都是无偿的。
一铀|00:56:47 但是我能够想象得出,我如果是一家数商去收这个数据,它这些都是天文数字,就那些搜上来的原始项目和代码。
一铀|00:56:52 而且很难找到一个很好的奖励机制,让这些专家能够自愿地把这个交上来。
一铀|00:57:00 我拿 Mercor 他们官网上给专家一个小时的那个价格来说,比如说制造业的工程师大概是可能一两百刀一个小时。
一铀|00:57:05 这种价格就限定了,它不可能招到特别特别高级的工程师。
一铀|00:57:11 但是为什么学术就好做?因为我们能够自然而然地吸引到一些这种级别的人来帮我们收集数据。
一铀|00:57:16 因为他们不求钱,他们图的是大家一起把这个事情做好,图的是个名。
主播|00:57:21 所以说这个奖励制度不一样就导致你能吸引到的人不一样,你的上游是不一样的。
主播|00:57:22 OK,很有意思。
主播|00:57:24 好呀,那我们就到这里结束吧。
主播|00:57:26 谢谢允中,谢谢一铀参加我们的节目。
一铀|00:57:27 谢谢 Yiwen。
主播|00:57:28 谢谢,谢谢。
主播|00:57:35 好了,以上就是我们这期播客的全部内容了。
主播|00:57:43 国内的听众可以通过小宇宙苹果播客、网易云音乐、喜马拉雅 QQ 音乐、蜻蜓 FM、荔枝 FM 来关注我们。
主播|00:57:51 海外的听众可以通过苹果播客和 Spotify,或者在 YouTube 上搜索硅谷 101 播客来关注我们。
主播|00:57:56 我们部分的文字稿还会收录在硅谷 101 的微信公众号上。
主播|00:57:58 谢谢大家,我们下次再见啦。
References
- 1官方单集页:E253|谁在给大模型出题、卖题、判卷?聊聊AI数据行业的野蛮生长
sv101.fireside.fm
- 236氪(智东西):两个00后给英伟达供数据,估值215亿
m.36kr.com
- 3
- 4华尔街见闻:英伟达拟入股AI数据供应商Mercor,后者估值达200亿美元
wallstreetcn.com
- 5
- 6Scale Labs:SWE Atlas
labs.scale.com
- 7Agents' Last Exam 官方站点
agents-last-exam.org
- 8arXiv:2606.05405 Agents' Last Exam
arxiv.org
- 9
- 10Scale:Humanity's Last Exam results
scale.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.