request-log 关了仍每天写 17 GB 被判不修,替代开关会把错误日志一起带走
两条维护者判了不修的结论、一面 5 并发的本地墙,加上已经落地的重置信号:每条都给出代码位置、一分钟判定和今天就能改的配置。
15:37,CLIProxyAPI 的维护者把「request-log 关了仍每天往盘上写 17 GB」这张单关成 not planned,答复里给的理由是行为本身有意,唯一替代是
server.commercial-mode: true;打开它,请求日志、错误日志、请求体落盘一起停12。15:18 关掉的另一张单同一命运:
/v1/messages 流式里 message_start.usage 报的是本地估算值,维护者同样关成 not planned,理由是 Claude Code 的上下文自动压缩要靠这个数。15:34 开出的 sub2api #8350 是这四小时里最值得先看的新故障,现象是「5 并发就报 too many concurrent requests」。这句文案由 sub2api 自己的用户并发槽位发出,默认值正好是 5。
上期说过要等
reset_observed 再动冷却,这条信号到了:codex-reset 把 10-26 的重置记成已观察落地,累计重置从 59 次变成 60 次。request-log 关了仍每天写 17 GB:判了不修
报障人的实测:
request-log: false 下,每个超过 1 MiB 的请求体仍被写进 logs/request-log-parts-request-body-*/body-*.tmp,请求成功后删掉。长上下文客户端每条请求 1–2 MB,于是磁盘持续写入约 0.2 MB/s,一天约 17 GB,120 秒里留下 25 个 spool 目录1。他把代价也写清了:商业模式下整个请求日志中间件被禁用,请求日志、error-only 日志、请求体落盘三样一起没有,连报障人自己说有用的那批 400 校验错误日志也一并消失2。
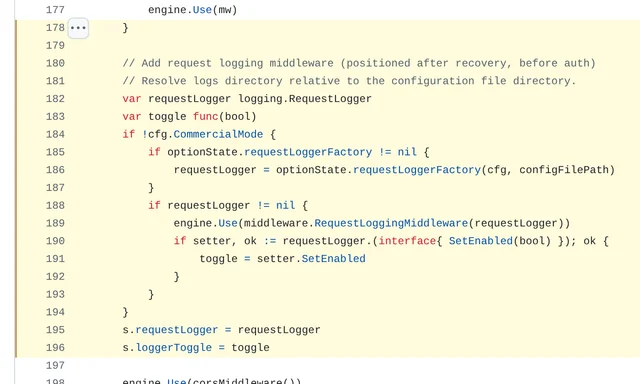
internal/api/server.go 第 184–194 行:if !cfg.CommercialMode 括住的整块只在这个条件下执行,商业模式下 requestLogger 保持 nil,engine.Use(RequestLoggingMiddleware) 那一行不会被调用。3另外两处的作用相同:
server_options.go 第 50 行把 SDK 的 RequestLog 直接置 false;logging_helpers.go 第 61 行与第 66 行各有一处提前返回45。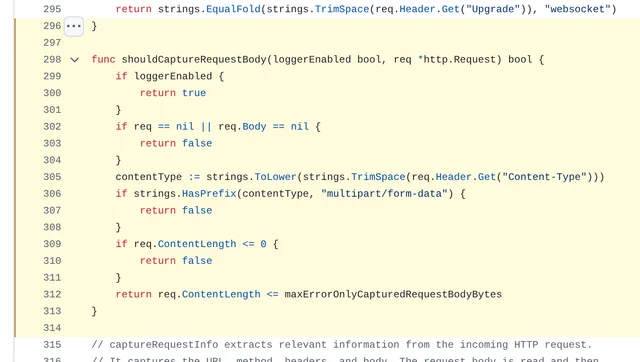
internal/api/middleware/request_logging.go 第 298–313 行:loggerEnabled 为假时继续往下走,最终只按 Content-Length 与 1 MiB 阈值决定是否落盘。6三条路摆在面前:
- 照旧,按自己的日增算盘。17 GB/天是报障人那套长上下文的量,你的量看自己的
logs目录。 - 把 logs 目录挂到 tmpfs:
--tmpfs /CLIProxyAPI/logs:rw,size=512m。报障人实测宿主盘的新 spool 目录从每分钟 8 个降到 0,代价是容器重启丢日志1。 - 打开
server.commercial-mode:盘上清净,代价是上面那三样记录从此都没有。
一分钟判定:
ls -d logs/request-log-parts-request-body-* 2>/dev/null | wc -l 有输出就说明你在写,du -sh logs 看量级。两个日志上限都只管日志文件本身:
logs-max-total-size-mb 默认 0 表示不限,error-logs-max-files 默认 10,管的是错误日志份数9。spool 目录靠请求结束时的那次清理删除10,进程被 OOM 或 docker kill 杀掉时留在盘上,代码里没有启动清理,目录名前缀来自 os.MkdirTemp11。message_start 里的数是本地估的,而且是有意的
/v1/messages 的流式响应里,message_start 带的是一个本地算出来的输入 token 数,没有 cache_read_input_tokens 与 cache_creation_input_tokens;权威的缓存拆分要到 message_delta 才出现12。维护者 15:18 的答复:保留是刻意的。
message_start 若报 0,Claude Code 不会触发上下文自动压缩,它的压缩行为完全取决于这个值。除了 Anthropic Messages,其它上游协议在流开始时都不提供权威用量,那份拆分只有在上游响应完成时才出现,已经在 message_delta 与非流式响应里给对13。代码只有一处:遇到
message_start 事件、且 message.usage.input_tokens 为 0 时,用 state.estimate() 覆写14。估算走 tiktoken 的 O200kBase,只数请求里的 system、messages、tools、tool_choice 文本,连图片与文档块都不数15。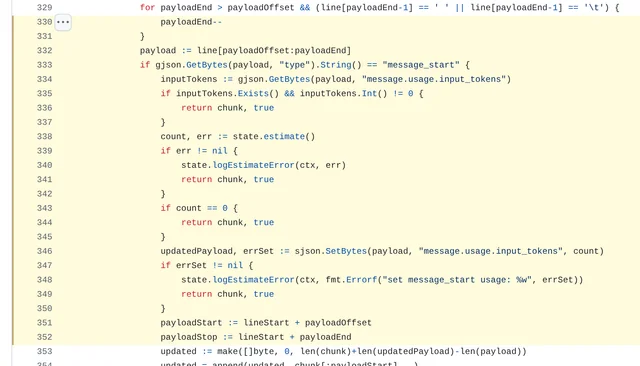
internal/runtime/executor/helps/claude_input_tokens.go 第 334–352 行:先确认 type 是 message_start 且 input_tokens 为 0,再用本地估算写入;其余事件原样放行。14影响落在口径上。报障人那次真实会话:上游
response.completed 报输入 198,325、其中缓存读 197,120;message_start 报 173,188;message_delta 报 1,205 加 197,12012。把 173,188 当「未缓存输入」用,会高出一百四十多倍;当「总输入」用,比真值低 12.7%。记账、命中率、容量规划看
message_delta 或非流式那份,message_start 只适合当客户端进度指示。5 并发就报 too many concurrent requests:墙在本地
#8350 的现场:Pro 200 的号、透传、WebSocket、codex cli、统一出口,并发一到 5 就出现
stream disconnected before completion: too many concurrent requests, please retry later;同一个号直接登录时不复现,报障人于是来问是不是 sub2api 的问题17。问题就出在 sub2api 的用户并发这一层:这句话由自己的并发槽位发出。
v0.2.18 里
too many concurrent requests, please retry later 只出现在三处,全部紧跟用户槽位获取之后;抢账号并发失败时是另一句 account is busy, please retry later1819。看到哪一句,就知道卡在哪一层。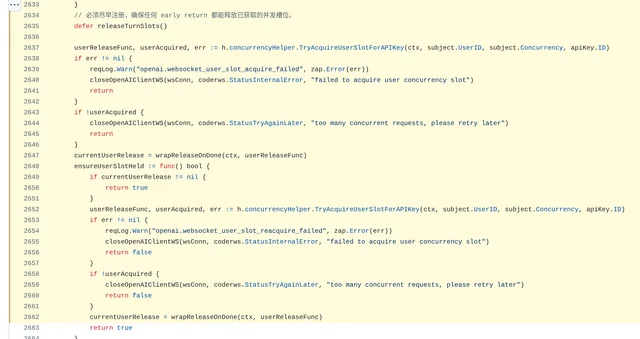
backend/internal/handler/openai_gateway_handler.go 第 2637–2661 行:拿不到用户槽位就用 StatusTryAgainLater 关连接并回这句;下面还有一段一模一样的重取分支。18于是 5 条长连接各占一个槽时,客户端自己的重连也挤不进来。报障截图里连续出现的「正在重新连接 3/5」「正在重新连接 5/5」就是这个循环17。
第二道闸在连接数:
gateway.openai_ws.max_ingress_connections_per_api_key 默认 64,按 API key 算活着的 WebSocket 连接23。用户并发抬上去之后,会先撞这道。改法在管理端:把该用户的并发数调大,接口是
PUT /api/v1/admin/users/:id 的 concurrency 字段,批量走 POST /api/v1/admin/users/batch-concurrency24;填 0 表示不限25。并发数一变,认证缓存随即失效,改完不用重启21。验证一步:改成 10,再跑 6 条并发。若这时报的是
account is busy,那才是账号并发,去调那只号自己的并发数。那条重置信号到了,现在可以清冷却
codex-reset 把 10-26 这条记成
reset_observed,累计重置从 59 次变成 60 次;首页现在写「今天重置过,10-26 6:08 AM UTC」,换算北京时间是 14:082627。按顺序动手:先 sub2api
POST /api/v1/admin/openai/accounts/:id/quota/refresh 把真值写回快照,再 CLIProxyAPI 逐张 POST /v8/management/routing/cooldown/reset,body 带 auth_index。带 401 记录的凭证在第二步空转,清理函数第一行就返回28,这类要等刷新成功。
今天这一步还得手动,因为 429 存下的恢复时刻是固定的,上游提前放开时本地不知道。14:55 开的 PR #6997 想把这件事自动化:10 个文件、+305 行,加一个 opt-in 的
routing.cooldown.quota-reconcile(默认 false、可热重载),后台每 30 秒用凭证自己的执行器请求一次 GET https://chatgpt.com/backend-api/wham/usage,只在 rate_limit.allowed 为真且 limit_reached 为假时清冷却29。版本与上游:这四小时没有新版本
四仓的最新版本没动:CLIProxyAPI v8.0.43(10-25 23:37)、sub2api v0.2.18(10-23 15:44)、codex-proxy v2.1.20(10-23 03:56)、codex2api v3.1.1(10-17 05:42)31323334。
主干这边:CLIProxyAPI 的 main 停在 10-25 22:45,dev 有一笔 10-26 10:09 的
feat(codex): add full-chain compression(064e008b),还没有版本带上它35;sub2api main 停在 10-25 21:4836;codex-proxy dev 停在 10-23 03:5437;codex2api main 停在 10-26 00:3938。References
- 1CLIProxyAPI #6993
github.com
- 2维护者的关闭答复
github.com
- 3v8.0.43 的 server.go
github.com
- 4v8.0.43 的 server_options.go
github.com
- 5v8.0.43 的 logging_helpers.go
github.com
- 6v8.0.43 的 request_logging.go
github.com
- 7v8.0.43 的 config.example.yaml
github.com
- 8v8.0.43 的 config_v8.go
github.com
- 9v8.0.43 的日志上限配置
github.com
- 10v8.0.43 的 response_writer.go
github.com
- 11v8.0.43 的 request_logger_body_source.go
github.com
- 12CLIProxyAPI #6992
github.com
- 13维护者对 #6992 的关闭答复
github.com
- 14v8.0.43 的 claude_input_tokens.go
github.com
- 15v8.0.43 的 claude_input_tokens.go 估算段
github.com
- 16#6992 里的根因走查
github.com
- 17sub2api #8350
github.com
- 18v0.2.18 的 openai_gateway_handler.go
github.com
- 19账号槽位失败的那句文案
github.com
- 20v0.2.18 的用户并发默认值
github.com
- 21v0.2.18 的 api_key_auth.go
github.com
- 22HTTP 入口的排队取槽
github.com
- 23WebSocket 连接上限默认值
github.com
- 24v0.2.18 的用户管理路由
github.com
- 25v0.2.18 的 concurrency_service.go
github.com
- 26codex-reset 的事件接口
codex-reset.com
- 27codex-reset 首页
codex-reset.com
- 28v8.0.43 的 conductor_cooldown.go
github.com
- 29CLIProxyAPI PR #6997
github.com
- 30v8.0.43 的 routing.cooldown 段
github.com
- 31CLIProxyAPI 的发行页
github.com
- 32sub2api 的发行页
github.com
- 33codex-proxy 的发行页
github.com
- 34codex2api 的发行页
github.com
- 35CLIProxyAPI 的 dev 提交
github.com
- 36sub2api 的主干提交
github.com
- 37codex-proxy 的 dev 提交
github.com
- 38codex2api 的主干提交
github.com
- 39CLIProxyAPI #7000
github.com
- 40CLIProxyAPI #6996
github.com
- 41CLIProxyAPI #6998
github.com
- 42CLIProxyAPI #6999
github.com
- 43OpenAI 状态页
status.openai.com
- 44Claude 状态页
status.claude.com
- 45Google Cloud 状态页
status.cloud.google.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.