AI 产品经理面试简报 16:浏览器代操作、法院闸门、默认模型
从 ChatGPT 在 Chrome 里的代操作授权、Anthropic 向国会推介的联邦前沿 AI 安全法案草案、Replit 把 Agent 默认模型转向 OpenAI 这三组 2026 年 10 月中旬的更新出发,拆解 AI 产品交付链上「用户、法院、客户」三处点头位,并整理成可直接用于 AI 产品经理面试的表达、指标与追问。

先看结论
2026 年 10 月 15 日 20:02 UTC(北京时间 10 月 16 日 04:02),ChatGPT 官方账号宣布 Chrome 扩展升级。1
10 月 16 日 21:45 UTC(北京时间 10 月 17 日 05:45),POLITICO 发出独家。3
Anthropic 的政府关系团队向国会山议员推介了一份自己起草的联邦 AI 安全法案草案。3
草案只允许政府在一种情形下阻止模型发布。风险须可预见且迫近,且由生物武器、模型绕开控制、网络攻击三类之一引发。3
损害门槛写得极高:财产损害与损失超过 10 亿美元,或死亡与重伤合计超过 50 人。3
10 月 15 日太平洋时间,Replit 的 CEO Amjad Masad 在 TechCrunch Disrupt 台上被问了一句。4
主持人说:「我没想到这意味着你们不再和 Anthropic 合作了。」他答:「Yeah. Um I mean, yeah.」4
两天后他改口:OpenAI 现在是首选伙伴,Anthropic 的模型仍在平台上可选。5
这三件事分属产品、立法、商务。它们落在同一条交付链上。
交付时谁授权它能碰什么,发布时谁能否决,交付后谁在替客户选模型。
用户点头、法院点头、客户点头。三处同意,都不发生在一次明确的点击上。
| 更新与日期 | 核心机制 | 用户价值 | 行动窗口 | 证据边界 |
|---|---|---|---|---|
| ChatGPT Chrome 扩展升级,2026-10-151 | 授权按站点主机名给一次,四个选项;没有按动作的确认层26 | 一次任务能跨过多个系统做完,省掉来回复制粘贴1 | 先列一张「有后果的动作」清单,逐个指定停下点7 | 成功率、延迟、支持站点数均未公布;商店评分 1.9 分是唯一反映任务表现的公开信号8 |
| Anthropic 向议员推介联邦草案,2026-10-163 | 触发须财产损害超过 10 亿美元、或死亡与重伤合计超过 50 人,且由三类风险引发;商务部不能自己下停令,须向哥伦比亚特区联邦地区法院申请39 | 发布流程多出一份要自己留存的合规档案:自评、系统卡、外部评估10 | 先做一次「我们过不过线」的自查,把口径写进模型卡1011 | 全文不公开,条款细节均为「报道所述」;举证责任与法院审查标准未知12 |
| Replit 承认默认模型转向 OpenAI,2026-10-154 | 默认不是某个模型,是叫 Auto 的路由器;企业策略要求三家各留一个可选1314 | 用户不必逐个比较模型,默认体验由平台统一调优15 | 自己留一份能复跑的评测基线,别只依赖平台公开榜1617 | 「Sol 与 Astra 更好」在公开榜上无法验证,榜单停在 2026 年 5 月16 |
01 代你点:授权按站点给,不按动作给
发生了什么
2026 年 10 月 15 日 20:02:51 UTC(北京时间 10 月 16 日 04:02:51),ChatGPT 官方账号发出升级说明。1
原话是把 computer use 带给所有用 Chrome 的人。computer use 指让模型直接操作浏览器界面的一层能力。1
两条能力被分开写。1
在 Chat 里,它能看你打开的标签页并收集信息。在 Work 里,它能控制你的 Chrome 标签页,去发消息、填表、下载文件。1
侧栏也换了。完整对话历史被搬进浏览器右侧,用户可以一边看页面,一边在 Chat 与 Work 之间切换提问。18
这次不是首发。19
官方更新日志里,侧栏功能挂在 2026 年 7 月 27 日到 31 日那一周。19
computer use 与扩展在 2026 年 6 月 15 日到 19 日那一周开始向欧洲经济区、英国与瑞士放量。19
2026 年 8 月 31 日,扩展扩到 Edge、Brave、Opera、Vivaldi。20
交付物是一枚 Chrome 扩展加桌面端的会话。扩展是手,桌面端是脑。2
要在浏览器里动手,得新开一个 Work 或 Codex 会话(Codex 是面向编码任务的会话),用
@ 点名浏览器。2ChatGPT Atlas 那个独立浏览器已被关停,2026 年 8 月 9 日停止工作。同一批公告里,侧栏被写成了接替方案,这次升级补的是侧栏之上的操作能力。21
商店页给出的公开数字有三个:700 万用户、1.9 分、959 个评分(截至 2026 年 10 月 18 日)。8
产品机制:四道闸门,没有一道是按动作的
第一道在安装时。2
Chrome 索要的权限清单包括:读改所有网站上的全部数据、跨已登录设备读取浏览历史、书签、下载、通知、标签组,以及页面调试器。2
官方紧接着说明:这些权限让扩展能跑浏览器工作流,ChatGPT 仍然用自己的确认、设置与黑白名单。2
第二道是站点闸门,也是产品自己加的那层。2
默认每遇到一个新网站问一次,判断依据是网站的主机名,例如 example.com。2
四个选项:只允许一次、允许这个站点、允许所有站点、拒绝。2
「允许所有站点」被官方标为更高风险,选了之后不再询问。2
至于授权多久过期,答案写在 Codex 托管配置参考里:默认是
thread,即当前会话内有效,不是单轮。6官方没有为扩展单独写一条有效期说明。这是目前最接近的证据。6
第三道只管少数资源。2
浏览历史每次单独询问,而且没有「一直允许」这个选项。2
管理员用
browser_use_external=false 可以把整个能力关掉,包括已有的标签页与已登录会话。6也可以按域名分别规定访问、上传、下载,还可以关掉对浏览器动作的「自动审批复核」。22
这一层在官方配置里叫 automatic approval review,意思是执行前先自动判断该动作是否放行。22
然后是最要紧的一句:这套机制里没有按动作的确认层。2
官方示例提示词里有一条「按活动说明把报名表填完,提交之前停下」。23
这是提示词里的一句要求,不是产品保证。文档里查不到「提交表单前强制二次确认」的条款。2
ppc.land 逐条对照官方线程与报道后给出同一结论:没有任何一方说明助手在发消息或提交表单前会不会弹确认。7
任务跑起来之后,用户能看见的控制点只有一个。8
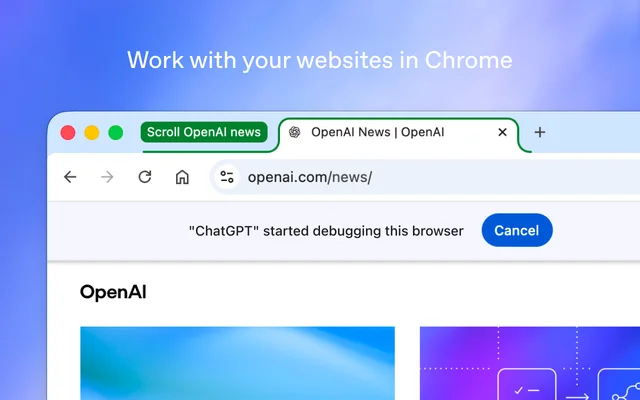
Chrome 顶部会出现「started debugging this browser」的提示条与一个 Cancel 键,标签页被装进一个专门的组里。8
能力边界写在另一页。24
它不能自动化终端类应用,不能以管理员身份认证,也不能替你点系统的安全与隐私授权弹窗。24
同类能力里它不是最早的一个。25
2026 年 1 月 28 日,Google 已在 Chrome 内上线 auto browse,面向美国的 AI Pro 与 Ultra 订阅者。25
它能多步执行订票比价、填表、管理订阅。需要登录时,还能调用浏览器的密码管理器。25
用户价值
对做产品的团队,价值不在「它能点按钮」,而在一次任务能跨过多个系统。1
示例里的活是把三个供应商页面整理成一张对比表,再从邮件里找出单据填进报销单。23
但授权的单位是站点,不是动作。2
用户批准的是「它可以在 example.com 上做事」,不是「它可以替我点提交」。2
这条能力也在遭遇反方向的阻力。26
The Verge 10 月 17 日报道,Yelp 只允许付费数据授权计划内的 AI 代理(agent,能自己调工具完成多步任务的程序)访问。26
达美航空阻止代理代订机票。摩根大通与嘉信理财确认,出于安全原因阻止代理访问账户。26
同一篇没有给出「多少比例的站点在封」或「封禁让多少任务失败」的数字。26
产品经理如何落地
第二步,列一张「有后果的动作」清单。 发送消息、提交表单、上传、下载、支付、删除,每一类都要在自家产品里指定一个停下点。7
「模型会自己停」不是可以依赖的默认行为。7
第三步,把站点白名单当资产管。 一次「允许所有站点」就等于关掉了唯一一道按站点的闸门。2
企业侧可以按域名预设允许位,不要让每个用户自己点。22
第四步,把中止做成看得见的东西。 官方给的是一条浏览器提示加一个 Cancel,这是目前唯一可见的中断手段。8
自家做同类功能,要有一键中止,也要有「任务跑在自己的容器里」的视觉提示。
第五步,自己做一份「它碰了什么」的记录。 官方声明不额外保存完整的浏览行为记录,只有进入对话上下文的内容才被保存。2
需要审计的团队得自己记,等不到平台提供。
可验证指标
- 时间与形态:2026-10-15 20:02:51 UTC 宣布;扩展版本 1.26.1005.11759,同日更新。18
- 支持浏览器:Chrome、Edge、Brave、Opera、Vivaldi;Opera 没有侧栏。2
- 授权粒度:按站点主机名,四个选项;默认有效期
thread。26 - 特殊资源:浏览历史每次询问、没有一直允许;上传下载总是询问。2
- 企业控制:整体关闭、按域名配置访问与上传下载、关闭自动审批复核。622
- 公开装机与评分:700 万用户、1.9 分、959 个评分(2026-10-18 读取)。8
- 未公布:成功率、平均耗时、支持站点数量、支持地区清单。27
风险边界
没有任何效果数字。 官方页面不写成功率、失败率与平均耗时。2
唯一反映任务表现的公开信号是商店评分 1.9 分、959 个评分。8
这组评分没有给出基线,只能当当期读数看。8
这两句不能同时字面成立。
提示注入的对照数字来自另一家。 ppc.land 提起,Anthropic 去年 8 月开放 Claude for Chrome 研究预览时公布过提示注入成功率。7
这是攻击成功率:无缓解一档 23.6%,有缓解一档 11.2%,原文只注明无缓解那档是 123 个测试用例。7
这是 Anthropic 自报的口径,不能当 OpenAI 的数字用。OpenAI 这次没有公布同类数字。7
封禁是真的,但没有被量化。 Yelp、达美、摩根大通、嘉信理财的做法都有直接确认,比例与影响没有数字。26
面试可直接说
10 月 15 日 OpenAI 把 computer use 塞进了 Chrome 扩展:Chat 模式读你已经打开的标签页,Work 模式直接控制标签去发消息、填表、下载文件,侧栏里还带完整历史。它不是首发,侧栏 7 月就有了。我关注的是授权粒度:Chrome 装扩展时要的是「读改所有站点数据」这种全量权限,产品层加的是按站点主机名问一次,四个选项,默认在当前会话内有效;没有按动作的确认层。官方示例里那句「填完就停、不要提交」是提示词写法,文档里查不到提交前强制确认的条款,有第三方逐条核对后得出同样结论。所以我自己做同类功能,会把读和写拆成两个开关,再列一张有后果的动作清单,每个动作指定停下点。边界也要说清:官方没公布成功率、延迟和支持站点数,商店评分是 1.9 分;而且网站那头在收紧,Yelp、达美、摩根大通、嘉信理财都在拦代理。
面试官追问
- 用户已经批准「这个站点可以操作」,你还会在哪些动作上再停一次?
- 一个跑在浏览器里的代理,你会用哪三个指标判断它今天能不能上线?
- 站点开始封代理,你的产品会怎么退化,退化时怎么告诉用户?
02 法院闸门:多大的事才轮得到它说不
发生了什么
2026 年 10 月 16 日 21:45 UTC(北京时间 10 月 17 日 05:45),POLITICO 发出独家报道。3
三名知情人士称,Anthropic 的政府关系代表向国会山议员推介了一份此前未被报道的草案。3
草案的重心不是授权,而是限制授权。3
政府只有在模型构成可预见且迫近的风险、且风险来自生物武器、模型绕开控制、或网络攻击三者之一时,才能阻止它的发布或使用。3
损害要跨过两条线之一:财产损害与损失超过 10 亿美元,或死亡与重伤合计超过 50 人。3
POLITICO 说这套措辞与加州 2025 年签署的 SB 53(《前沿人工智能透明度法》)一致。3
Anthropic 发言人对 POLITICO 说,这就是它 6 月起一直在推的《Advanced AI Framework》的立法版。3
据报道,评估由在商务部注册的独立评估机构做。评估者可以向被审企业收费,但报酬不能取决于结论。9
一旦发现达到门槛的迫近风险,须在完成评估后 72 小时内通报商务部。9
商务部不能自己下停令。9
这不是一份已经提交的法案。12
国会要到 11 月中期选举之后才复会。29
产品机制:阈值从哪来,权力被切成几段
先弄清阈值不是 Anthropic 发明的。11
加州 SB 53 原文写的是超过 50 人死亡或重伤,或超过 10 亿美元财产损害,并且限定「源自单次事件」。11
「单次事件」是硬约束:不是一年累计,是一次事故。11
10 亿美元指财产损害与损失,SB 53 另写明股权贬值不计入。11
主体门槛也写在原文里。前沿模型指训练算力超过 10^26 次运算。11
大型开发者指连同关联方、上一日历年年收入超过 5 亿美元。11
Anthropic 自己那本框架的口径更低也更宽。10
被覆盖的开发者的条件是:训练算力超过 10^25 次运算,且年 AI 相关收入超过 5 亿美元、或每年 AI 研发支出超过 10 亿美元。10
算力线低一个数量级。收入口径换成 AI 相关收入,还多了一条研发支出的替代路径。10
风险类别也更多。10
框架列了四类:生物武器、攻击性网络行动、失控、以及能加速前三类的自动化研发。10
报道中的草案只写三类:生物武器、绕开控制、网络攻击。其中「绕开控制」大致对应框架的「失控」,草案没有「自动化研发」。3
框架正文把灾难性风险定义成「可预见且实质性」,正文里没有人数与金额。10
脚注说这个定义与加州 SB 53 一致。10
草案据报用的是「迫近」。这比「实质性」更严。3
所以这套设计的结构是:门槛极高、触发条件极窄、判定权被切成三段。10
框架自己把这套切法写成了可选项之一:机构不直接下命令,只能起诉寻求救济。迫近风险可先取临时救济。10
框架同时写明这些选项可以混搭。草案取了最保守的一支。10
| 口径 | 覆盖主体门槛 | 触发阈值 | 因果措辞 | 风险类别 |
|---|---|---|---|---|
| 报道中的草案3 | 未写 | 财产损害超过 10 亿美元,或死亡与重伤合计超过 50 人 | 可预见且迫近 | 三类:生物武器、绕开控制、网络攻击 |
| 加州 SB 5311 | 10^26 次运算 + 5 亿美元年收入 | 财产损害超过 10 亿美元,或死亡与重伤合计超过 50 人,限单次事件 | 可预见且实质性 | 化生放核、无有意义人类监督下的网络攻击或特定犯罪、绕开控制 |
| 纽约 RAISE30 | 按算力与规模分档 | 财产损害 10 亿美元及以上,或死亡与重伤合计 100 人及以上 | 造成或实质促成 | 化生放核、有限人类干预下的特定犯罪 |
| Anthropic 框架10 | 10^25 次运算 + 5 亿美元 AI 收入或 10 亿美元研发支出 | 正文无数字门槛 | 可预见且实质性 | 四类,含自动化研发 |
用户价值
对一个做产品的人,这条更新的用处是让你知道流程里多了一格:自评。10
框架要求覆盖范围内的开发者制定并发布安全框架、至少每半年出一份风险报告。10
还要在能力显著变强或保障显著变弱时发系统卡,并定期聘请外部独立评估者。10
这些动作都发生在公开发布之前,也都不需要任何政府批准。10
真正需要法院的那一步,几乎不会出现在一个 B 端产品的日常发布里。10
对买方的含义是:供应商说「我们符合框架」,问的是文档,不是批文。10
产品经理如何落地
第一步,先判断自己过不过线。 训练算力是否超过 10^25 次运算;年 AI 相关收入是否超过 5 亿美元,或年 AI 研发支出是否超过 10 亿美元。10
被并购或合并报表时要按关联方重算。11 产出一行结论加计算依据,写进模型卡。
第二步,先把「单次事件」的边界定下来。 州法用的是单一事件口径,不是一个季度累计。11
一个租户算一次,还是整条攻击链算一次,要在事故前写清。否则事发当天给不出数字。
第三步,把四类风险做成三值判断。 生物、网络、失控、自动化研发,各自给「有、无、不确定」三档与依据。10
诈骗、虚假信息、一般数据泄露不在这四类里,别指望这套法兜底。10
第四步,把系统卡的触发条件写进发布清单。 触发是「任一风险类别上显著更强」,或「在显著更弱的保障下部署同等能力」。10
换模型换得更快但削弱了过滤,就触发。
第五步,别把合规当免责。 框架原文写明,遵守联邦制度本身不构成免责、安全港或推定无责。10
B 端合同的 SLA 与责任限额,不能假设「拿到合规就没事」。
可验证指标
- 草案触发阈值:可预见且迫近;财产损害超过 10 亿美元或死亡与重伤合计超过 50 人;三类风险之一。3
- 判定路径:评估机构注册在商务部;完成后 72 小时内通报。9
- 停令程序:商务部须向哥伦比亚特区联邦地区法院申请命令;其他部门不得单独中止。912
- 加州 SB 53:死亡与重伤合计超过 50 人、财产损害超过 10 亿美元、单次事件、10^26 次运算、5 亿美元年收入。11
- 纽约 RAISE:死亡与重伤合计 100 人及以上;72 小时内向州检察长披露;民事罚款按训练算力成本计算,上限分 5% 与 15% 两档。30
- 框架门槛:10^25 次运算;5 亿美元 AI 收入或 10 亿美元研发支出;四类风险。10
- 报送时限:框架要求关键安全事件发现后 15 天内报。10
- 罚则:SB 53 每次违规民事罚款不超过 100 万美元。11
风险边界
所有条款细节都是「报道所述」。 草案全文在订阅墙后,打开是登录页。3
举证责任、法院审查标准、从通报到起诉的时限、对已部署模型怎么处理,这四项全部无据可查。12
框架是四类风险,报道是三类。这是草案确实改了,还是报道概括,无法判定。3
「与各州法一致」只在加州成立。 纽约 RAISE 的门槛是死亡与重伤合计 100 人,不是 50 人。30
CSIS 的横向比较写,当前美国各州法案用的都是「50 到 100 人死亡 + 10 亿美元」这类高阈值。31
抢占范围只有一个来源。 「风险披露、独立评估、事件报告」这三项是 interestingengineering 一家的表述。9
POLITICO 只写「部分州 AI 安全法」。3
这三项与 FRONTIER Act 里被覆盖的三块几乎逐一对应。这说明它更像当前国会文本的通用骨架,而不是 Anthropic 独有的设计。32
批评集中在阈值,不在程序。 Mother Jones 的说法是这套门槛等于给伤亡定价:死几个人、损失不到 10 亿美元就不触发。33
要注意它的原话是「无法监管」。门槛限制的是阻止发布与使用的权力,SB 53 的披露与罚款义务与门槛无关。11
Brennan Center 的批评是它绕开了「预见与分配 AI 损害责任」这个老问题。34
也有支持的声音。Institute for Law & AI 的 Charlie Bullock 称这份提案「相当合理」,比其他前沿实验室做得更多,但比 FRONTIER Act 弱。29
白宫走的是另一条路。 2025 年 12 月的行政令要求司法部设 AI 诉讼工作组,专门挑战与联邦政策不一致的州法。35
它是厂商在给自己写规则。 Anthropic 发言人确认草案对应自家框架,并说这些是「国会应当采取」的政策。3
判断这套规则时,要知道作者是谁。
面试可直接说
10 月 16 日 POLITICO 报道,Anthropic 向国会议员推介了一份自己起草的联邦前沿 AI 安全法案草案。它最值得说的不是「要监管」,而是「什么时候不监管」:政府只有在模型构成可预见且迫近的风险、单次造成超过 10 亿美元损失或 50 人以上死亡重伤、而且风险来自生物武器、绕开控制、网络攻击三类之一时,才能阻止发布或使用。程序上,评估由注册在商务部的独立评估机构做,发现达标风险 72 小时内报商务部,商务部不能自己下停令,得向哥伦比亚特区联邦法院申请命令。这套阈值不是新发明,50 人和 10 亿美元逐字来自加州 SB 53,还限定单次事件;纽约 RAISE 的门槛是 100 人,所以「与各州法一致」不准确。对产品团队,我的结论是这套规则落在发布流程的第二步,不是最后一步:要准备的是自评、系统卡、外部评估这套档案,而不是一份批文。边界也很明确:草案全文不公开、没有编号也没有提案人,举证责任和法院审查标准都查不到。
面试官追问
- 你的模型要不要按这套门槛做自评,依据是什么?
- 「单次事件」你会怎么定义,为什么这么定义?
- 如果这套草案通过,你们的合规工作会多出哪几件具体的事?
03 默认值:换模型这件事,用户不会重新选一次
发生了什么
2026 年 10 月 15 日太平洋时间(北京时间 10 月 16 日凌晨),Replit 的 CEO Amjad Masad 站上了 TechCrunch Disrupt 的台。4
主持人先给了一个判断:「我没想到这意味着你们不再和 Anthropic 合作了。」引语据 TechCrunch 发布的录像自动字幕。4
他的回答是一句带两次语气词的确认:「Yeah. Um I mean, yeah.」4
理由是在追问之后才给的。4
他说现在 GPT 更好。公司有一个内部基准叫 vibe bench,公开基准也发。4
他的结论是:「Sol 与 Astra 在从零构建 vibe-coded 应用上持续更好。」4
被问到失去 Replit 是否加剧 Anthropic 的收入放缓,他只回一句「我们曾经是前五大客户」。4 然后现场笑了。
10 月 16 日 21:22 UTC,TechCrunch 首发,标题直接写成「Replit 不再与 Anthropic 合作」。36
10 月 17 日 16:29 UTC,Masad 本人在 X 上澄清。5
原话是:「Replit 保持模型无关……我在 Disrupt 上想说的是,OpenAI 现在是我们的首选伙伴。」5
TechCrunch 随后改标题、加作者、加背景,并写明:OpenAI 是默认,Anthropic 模型仍可选。37
同一篇里还有一句记者的判断:多数客户会沿用默认,而不是自己去选模型。37
产品机制:默认不是某个模型,是一个路由器
Replit 文档里,「默认」这个词指的不是模型。13
Free 模式只能走智能路由,用户不能手动选模型。13
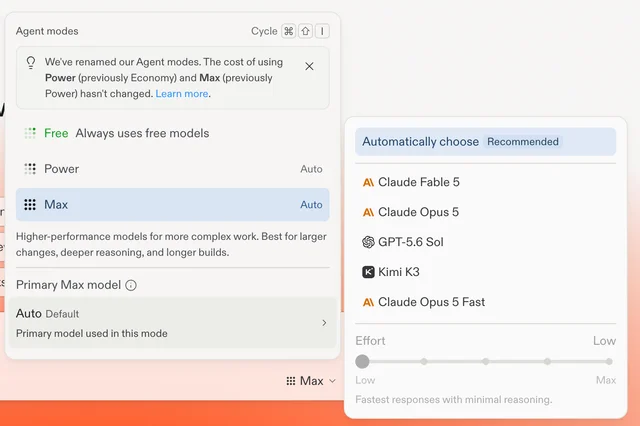
Core 与 Pro 用户在 Power 或 Max 模式里能看到一个「Primary model」,它的默认值是「Auto(Default)」。13
Auto 是什么,官方博客写得清楚:按任务复杂度在质量、速度与成本之间取平衡。15
企业侧把这件事切成两半。14
管理员可以按工作区开关各家模型,但有一条硬约束:OpenAI、Anthropic、Google 三家各自至少要留一个模型可用。14
Auto 能在批准池里自己挑,挑不到被禁用的。14
计费是另一层。38
每次请求记一个 checkpoint。后台调用的第三方 API,按厂商公开价从 Replit 的额度里扣。38
也就是说,路由器把一句话送去每百万输出 token 50 美元的 Astra,还是送去 0.5 美元的 Luna,直接决定这单的毛利。
用户价值
对用 Replit 的人来说,默认值意味着不用比较,也不用承担比较的成本。13
对平台来说,默认值是最强的杠杆。一次调整,就改变了绝大部分请求走哪一家的账单。15
这也解释了为什么「换了默认」比「停止合作」更准确。37
对做产品的人的用处在这里:默认值是产品里最贵的那个决定,而它通常没有对应的确认框。
产品经理如何落地
第一步,把默认当成一次发布来对待。 改默认要不要通知、要不要给回滚、要不要按团队分别设,都是治理问题。39
GitHub 把 Copilot 的默认模型做成了企业管理员可配置项。弃用某款模型时,它会自动启用建议的替代模型。39
第二步,自己留一份能复跑的评测。 「更好」这个词只有在同一套任务集上才有意义。40
Replit 的 ViBench 用的是 20 份来自生产轨迹的需求文档、固定 harness、LLM 评测加人工校准。这套思路可以直接借。40
差别来自输出 token 量:6000 万对 1.9 亿。单价一样,账不一样。41
第四步,把切换成本算进来。 Replit 自己写明,改 effort 与换模型会重建缓存。43
一次切换里,输入 token 从缓存读变成缓存写。这一笔是一次性的。
第五步,别把供应商集中度交给默认值。 企业策略里那条「三家各留一个」就是防这件事的。14
可验证指标
- 事件时间:台上 2026-10-15 太平洋时间。4
- 报道与澄清:TechCrunch 首发 2026-10-16 21:22 UTC;Masad 澄清 2026-10-17 16:29 UTC。536
- 默认形态:Free 强制 Auto;Power 与 Max 的 Primary model 默认 Auto(Default)。13
- 企业约束:OpenAI、Anthropic、Google 各至少留一个模型可用。14
- 公开榜:ViBench 最后更新 2026 年 5 月,榜首 Claude Opus 4.8 为 87.8%,第二 GPT-5.5 为 86.5%。16
- 榜单缺口:没有 Sol、Astra、Fable 5.1、Opus 5.5。16
- 单价:Astra 与 Fable 5.1 都是每百万 token 输入 10 美元、输出 50 美元。4445
- 缓存读价:Astra 1 美元,Fable 5.1 0.25 美元。4445
- 每任务成本:同一智能指数 53 分下,Astra 3.26 美元、Fable 5.1 7.63 美元。4142
风险边界
「更好」在公开侧无法验证。 ViBench 的公开榜停在 2026 年 5 月,Sol、Astra、Fable 5.1、Opus 5.5 一个都不在榜上。16
台上说的内部基准与公开的 ViBench 同名同源。但内部跑分的题版、分数、执行日期都没公开。17
基准的钱从一边来。 ViBench 由 Replit 与 Georgian 联合署名。17
Georgian 是 Replit C 轮与 D 轮的投资方,并写明 Replit 每周跑约 10 次、把它当生产门禁。17
这不改变它的方法说明。但它不是独立第三方评测。40
引用第三方指数必须带版本。OpenAI 页面引的旧版指数里,Fable 5.1 是 65.7、Astra 是 61.2,方向与现版相反。41
「不再合作」这句站不住。 Anthropic 没有任何公开回应,TechCrunch 手里只有匿名信源的否认,双方都没有书面声明。37
Anthropic 那边的数字是知情人士口径。 据报道,三季度收入 168 亿美元,二季度 116 亿美元,环比约 45%。46
多家标题把这个 45% 写成了同比。公司没有公开审计财报,毛利率也没有具体数值。46
截图比正文旧。 模型选择器的正文表格列的是 GPT-6 世代,截图还停在 GPT-5.6。13 别把截图当当前清单用。
面试可直接说
10 月 15 日 Replit 的 CEO 在 TechCrunch Disrupt 台上被问是否不再和 Anthropic 合作,他答了一句「Yeah. Um I mean, yeah.」,理由是 GPT 更好、成本更低、伙伴关系更强。两天后他澄清说 OpenAI 是首选伙伴,Anthropic 的模型仍在可选清单里。真正值得说的是「默认」这件事:Replit 文档里的默认不是某个模型,是一个叫 Auto 的路由器,Free 模式强制走它,Power 和 Max 的 Primary model 默认也是 Auto,候选池和权重一概不公布。TechCrunch 自己也写,多数客户会沿用默认而不去选模型,所以换默认等于替很大一部分客户做了决定。我关心两件事:一是「更好」目前无法验证,他们那个公开基准 ViBench 停在 5 月,榜上根本没有 Sol 和 Astra,而 ViBench 是 Replit 和它的投资方联合做的;二是成本不能只看单价,Astra 和 Fable 5.1 单价完全一样,都是每百万输入 10 美元、输出 50 美元,但同一智能指数下每任务成本是 3.26 对 7.63,差在输出 token 量。产品上的做法是自己留一份能复跑的评测基线,再把默认值当治理项来管。
面试官追问
- 你要改产品的默认模型,会先准备好哪几样东西再动手?
- 平台自己的基准和第三方基准对不上时,你怎么做决定?
- 默认值改完之后,你怎么知道用户是接受了,还是根本没发现?
把三条串起来:三处没有点击的同意
第一条讲的是用户那一处。2
第二条讲的是监管者那一处。3
第三条讲的是客户那一处。13
引用这三条时,证据可以按三层分开。
可以直接引用的是结构与制度类事实。2
需要带上「厂商自报」标签的是效果与成本类数字。16
需要按单一来源转述的是只有一方说过的话。9
三件事都还没有走完。2
References
- 1
- 2Browser extension,OpenAI 文档
learn.chatgpt.com
- 3
- 4
- 5@amasad 的澄清帖,X
x.com
- 6Configuration reference,OpenAI 文档
learn.chatgpt.com
- 7
- 8ChatGPT,Chrome Web Store
chromewebstore.google.com
- 9Anthropic's confidential bill limits federal power to halt models,Interesting Engineering
interestingengineering.com
- 10Anthropic's Advanced AI Framework(PDF),Anthropic
www-cdn.anthropic.com
- 11SB-53 Artificial intelligence models: large developers(2025–2026),California Legislative Information
leginfo.legislature.ca.gov
- 12
- 13Model selector,Replit Docs
docs.replit.com
- 14Agent modes and models(Enterprise),Replit Docs
docs.replit.com
- 15
- 16ViBench Results,ViBench
vibench.ai
- 17
- 18@ChatGPT 的侧栏帖,X
x.com
- 19What's new,OpenAI 文档
learn.chatgpt.com
- 20ChatGPT release notes,OpenAI 帮助中心
help.openai.com
- 21ChatGPT Atlas retirement,OpenAI 帮助中心
help.openai.com
- 22Managed configuration,OpenAI 文档
learn.chatgpt.com
- 23@ChatGPT 的示例查询帖,X
x.com
- 24Computer Use,OpenAI 文档
learn.chatgpt.com
- 25
- 26
- 27
- 28ChatGPT Work and Codex,OpenAI 帮助中心
help.openai.com
- 29
- 30
- 31
- 32FRONTIER Act 法案文本(PDF),U.S. House of Representatives
obernolte.house.gov
- 33
- 34
- 35
- 36
- 37
- 38Replit AI Billing,Replit Docs
docs.replit.com
- 39
- 40
- 41GPT-6 Astra (Max) — Intelligence, Performance & Price Analysis,Artificial Analysis
artificialanalysis.ai
- 42
- 43
- 44Pricing,OpenAI API 文档
developers.openai.com
- 45Pricing,Claude Platform Docs
platform.claude.com
- 46
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.