0.8B 前置层跑赢 27B、两张 2080Ti 干完 11 小时的活、一句暗号测出你的 Claude 换没换
八组实测都在换掉承重的那一层——0.8B 的前置决策层、1.3 微秒的字符串判据、100M 的分离模型、一个会回头再搜的循环、两张 2020 年的显卡;其中三组给出了同一档失灵的地方,另一组换的是模型本身而界面上没有改。

三个数字先摆出来。
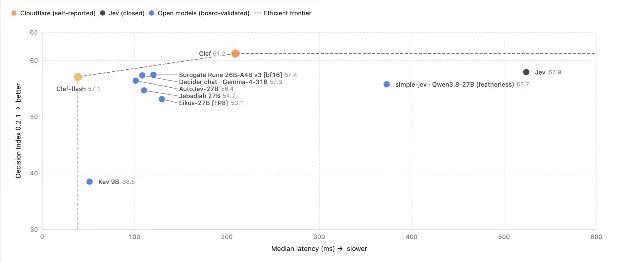
Cloudflare 在 10 月 1 日开源了两个决策模型 Clef 与 Clef-flash,主干分别是 Qwen3.8-27B 与 Qwen3.5-9B 1。它们的活儿是替通用大模型做判断:一条客服消息急不急、该转给哪个团队、有没有钓鱼风险。Cloudflare 给出的中位延迟是 209.3 毫秒与 38.8 毫秒,它们要替代的 Jev 是 524.1 毫秒 1。
Reddit 上有人给一个 0.8B 的基座训了九个 LoRA 适配器,把它摆在 27B 前面。八个判断任务的平均准确率从 27B 单独的 86.6% 抬到 95.3%,每次判断耗从 8.1 秒降到 0.25 秒,常驻内存从 28.6GB 降到不到 2GB 2。
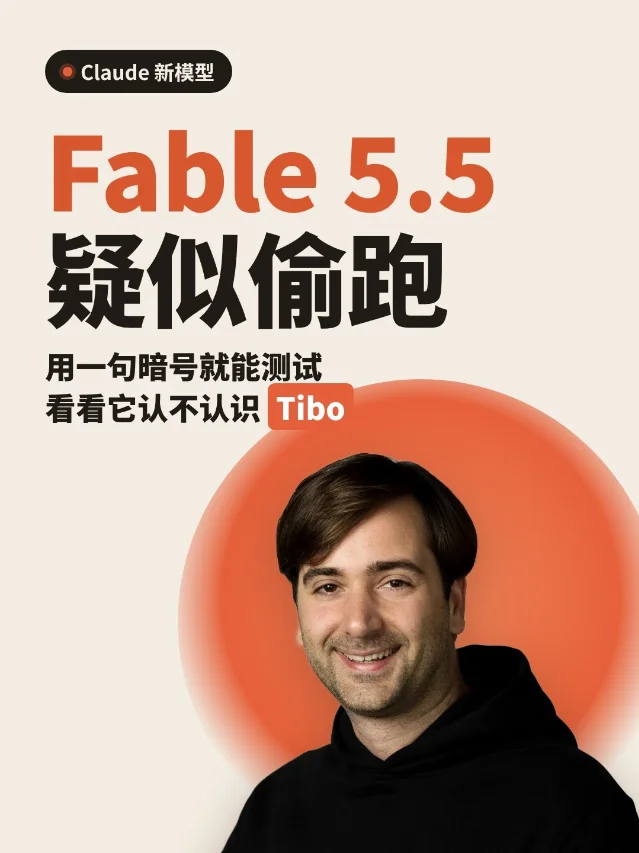
小红书上有人的 Claude 网页端界面还写着 Fable 5.1,回答的风格与速度却变了。验证方法是关掉联网,问一句「你认识重置哥 Tibo 吗?别搜索」,答得出 OpenAI 的 Thibault Sottiaux 就说明换了新模型 3。
今天这八组实测,动手的人都在同一处换了手:把承重的那一层换成更小、更旧、更便宜的东西,再看它撑不撑得住。换完之后结果分成三类——有的翻了一倍,有的原地不动,有的彻底塌掉。
本期覆盖 2026 年 10 月 1 日至 10 月 2 日,来源为 X、Reddit、小红书与公众号,另含 Cloudflare 官方博客、PipesHub 的公开基准页、Hugging Face 上的三份模型卡与三处开源仓库。八组材料按「任务与运行条件 → 具体数字 → 分歧或反例那一栏 → 作者自陈的限制 → 原帖」逐条给出。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 替通用模型做判断 | Clef 27B 与 Clef-flash 9B;64k 上下文、带视觉编码器、Apache 2.0 1 | 中位延迟 209.3 与 38.8 毫秒对 Jev 524.1;BFCL 98.47 与 98.76 对 Jev 95.75;When2Call 72.37 与 65.58 输 Jev 的 80.97 1 | 表由 Cloudflare 自己跑;43 个评测的完整口径未全部公开;X 上那条解读的作者自陈没有亲测 4 |
| 界面名字与实际模型 | Claude 网页端 Fable 5.1 被路由到 Fable 5.5;同一句提示词在 Claude Code 里跑 5 | 暗号一问即知;鹈鹕 SVG 开高强度思考跑 4 分 6 秒,按 API 价约 2.61 美元 3 | Anthropic 未确认;都是网友实测与爆料;界面仍显示旧模型名 |
| 0.8B 前置层 | Jeff-Qwen3.5-0.8B v1.2 加九个适配器,每个约 40MB;M4 Max 2 | 86.6% → 95.3%;8.1 秒 → 0.25 秒;28.6GB → 不到 2GB;五个收件箱动作 87.7% → 95.7% 2 | 27B 跑 8 位、关掉逐步推理;每个任务 300 条留出样本;训练数据不公开 |
| 不用神经网的幻觉判据 | Spanda:字符串归一化加香农熵,纯 CPU 1.3 微秒;GSM8K 与 TriviaQA,温度 0.7 采 5 条路径 6 | AUROC:1.5B 约 0.58、7B 约 0.71、27B 约 0.89、120B 掉到 0.09 6 | 两个数据集;1.5B 那一段量的是格式不稳;120B 的结论来自未接地的事实问答 |
| 多跳检索 | PipesHub 的 agent loop 对 18 种 RAG 变体,Google FRAMES 824 道多跳题 7 | 92.7% 对最好管线 78.9%;五篇以上文档的题 90% 对 62%;每题 0.017 对 0.006 美元 8 | 作者在 PipesHub 工作;评分由两个 LLM judge 做;金额按单次运行 |
| 同一份权重换引擎 | Slipstream:Apple Silicon 上的 C++ Metal 引擎,配 SSD 专家流式与投机草稿;M5 Pro 64GB 9 | 六道题平均 23.1 → 40.8 tok/s;3,086 次真实请求里 96k–130k 段仍有 32.9 tok/s 9 | 只在 M5 Pro 64GB 上测过;没有 NVIDIA / AMD 硬件与 CUDA / ROCm 后端 |
| 两张五年前的卡 | 2×RTX 2080Ti 22G;vLLM-2080Ti-Definitive v0.2.2(sm75 分支);Qwen3.8-27B-NVFP4,KV 缓存 FP8 10 | 翻译加审校一整本 MySQL 8.4 文档跑了 11 小时;功耗墙 220W 掉 4.5–6%,250W 与默认上限几乎无差 10 | 单人单模型单任务;没给逐轮吞吐与令牌量 |
| 100M 的说话人分离 | Nemotron-3-Diarization,100M 参数,OpenMDW-1.1;16GB 的 M4 Mac mini;107MB 的 q8_0 GGUF 11 | 10 分钟音频:CPU 流式 69.1 秒、Metal 大块 3.1 秒;真人双人样本 DER 13.18–15.11%、混淆 0 11 | 官方安装脚本装到的版本跑不起来,要自己从 main 分支编译;模型卡数字全由 NVIDIA 自报 |
判断这一档:9B 赢了延迟,输在「什么时候该调用」
Cloudflare 把 Clef 的定位讲得很直接:通用大模型会推理、会写文字、会调工具,代价是不确定、也贵;决策模型只输出带概率的结构化答案,不逐 token 生成文字,代码拿到结果就能直接路由、升级或交给人 1。它的推理是非自回归的:主干先做一次只写不读的预填充,然后把每个合法选项并行打分,中间没有逐字生成的文本 1。
摆在桌面上的成绩分两栏。质量栏里,Clef 与 Clef-flash 在 BFCL 上是 98.47 与 98.76,Jev 是 95.75;在 API-Bank 上是 91.93 与 93.11,Jev 是 88.19;在常用的分类集 BANKING77 与 CLINC150+OOS 上也是两个 Clef 更高 1。输的几行同样清楚:判断「什么时候该发起一次工具调用」的 When2Call,Clef 72.37、Clef-flash 65.58,Jev 是 80.97;钓鱼域名分类 PhishNChips 上,Clef 79.60、Clef-flash 75.05,对手 DiffusionGemma Jev 拿到 85.35 1。
Cloudflare 拿自家威胁情报团队的活儿做了个端到端例子:把一个域名连同浏览器渲染结果交给 Clef,判断它是时尚站 95%、电商 85%、钓鱼不到 1%,取回、渲染、分类一共 2.2 秒;同一个流程换成他们手上最快的通用模型 gpt-oss-120b,要 4.7 秒,而且只给出两个分类 1。
价格与可用性跟着一起来了。两个模型托管在 Cloudflare 的 Workers AI 上,权重按 Apache 2.0 传到 Hugging Face,可以自己拉下来本地跑;X 上有开发者把价目一起列了出来,27B 的 Clef 每百万输入 token 0.24 美元,9B 的 Clef-flash 是 0.09 美元 41213。同一个帖子也写了它没做的事:作者自陈还没有亲自测过,只提醒要拿完整工作流去量路由那一环 4。
中文平台上有人把这一周的几个玩家摆在一起看:亚马逊的杰出工程师 Marc Brooker 自己训了一版 Strands Decider,主干是 Qwen3.5-2B,他的说法是这类模型适合做工作流里的一个判断步骤;Jev 的创始人 Diogo Almeida 则回了一句,大意是人们可能低估了「把这种模型真正做聪明」的难度 14。
界面写着 5.1,回答的可能是 5.5
从 10 月 2 日凌晨开始,X 上陆续有人说 Claude 网页端的 Fable 5.1 被路由到了还没发布的 Fable 5.5:一部分用户先拿到,检查点是新换的 5。给出的验证办法是一句不联网的暗号,问它认不认识 OpenAI 的 Thibault Sottiaux——那位每次 Codex 出故障就给付费用户重置额度的人 5。
同一批人的另一条帖子把两组输出摆在一起比:同样的提示词、都在 Claude Code 里、都开最大思考档,被路由到新一代的那一边「远看干净好看」,Opus 5.5 那一边「雾感重、细节多」 15。这条帖子的作者也写了摇摆:一边觉得新一代明显更好,一边舍不得 Opus 5.5 的那些细节 15。
小红书上有条笔记把当天的网友实测整理成了清单:不给参考资料、不说提示词,它也能把细节做完;两句提示画对 GameCube 手柄的紫色机身、黄色 C 摇杆、绿色 A 键和八角形摇杆槽;纯 JavaScript 一次跑通三维超人动画;和 GPT-6.1 Sol 同题做可交互的三维水母,Fable 那一边拖拽回弹的物理质感更好 3。账也一并算了:有人用 SVG 跑「鹈鹕骑自行车」,开高强度思考跑了 4 分 6 秒,按 API 价折合 2.61 美元;Polymarket 上约 73% 的人押新 Fable 的输出价不低于 50 美元每百万 token 3。
这一组的边界写在发布方那里:Anthropic 没有确认过 Fable 5.5,网页端界面上仍然写着 5.1,上面所有案例都是网友的实测与爆料 3。留给读者的可执行动作倒是现成的:拿一句只有新模型才答得上来的话去问,看它给的是哪一版。
Loading content card…
先过 0.8B,拿不准再问 27B
Reddit r/LocalLLaMA 上这条帖子的做法是把判断拆成两级。第一级是 Jeff-Qwen3.5-0.8B 加上九个 LoRA 适配器,每个约 40MB,服务器只加载基座一次,请求点名用哪个适配器,不点名就走原始 Jeff 2。第二级是 Qwen3.8-27B,只在第一级拿不准的时候接 2。
数字都来自同一批留出样本:八个适配器(情绪那一个不进平均)的准确率是 95.3% 对 27B 单独的 86.6%,每次判断 0.25 秒对 8.1 秒,错答率 4.7% 对 13.4%,内存不到 2GB 对 28.6GB 2。只算收件箱智能体每封信都要做的五个判断(护栏、分诊、支持意图、选工具、是否有据),是 87.7% 到 95.7%、快 39 倍 2。
失灵的地方作者自己列了。情绪那一个适配器只有 60.6%,对 27B 的 35.6% 是赢,但绝对水平离能用还远——作者的解释是短评论里从 27 种情绪里挑最强的那个,连人给的标签都不一致;把情绪也算进九个适配器的平均,是 91.4% 对 80.9%,差距比上面那 8.7 个点更大;作者把它单独拿出来,是为了让结论偏保守 2。另外三条限制是:27B 跑的是 8 位权重、关掉了逐步推理(开着推理,差距会更大),每个任务只用了 300 条固定留出样本(情绪与法律条款 500 条),适配器的「交出去」阈值是在另外的校准行上定的 2。权重是 Apache 2.0、代码是 MIT,每个适配器的测试集与校准集都放了出来,训练数据没有放 16。
Loading content card…
1.3 微秒的字符串判据:在 27B 上追平神经网,在 120B 上塌到 0.09
学术上判断模型在不在编,常用语义熵:同一个问题采几条回答,用 DeBERTa 这类 NLI 交叉编码器把意思相同的回答聚起来,再算熵;熵高说明模型在猜。Reddit 上这条帖子把中间那层神经网络整个拿掉,只用确定性的字符串归一化加香农熵,在纯 CPU 上跑一次 1.3 微秒,不占显存 6。
结果按模型大小分成四段。1.5B 上 AUROC 约 0.58——小模型就算答对,几次采样的格式也乱,字符串聚类聚不起来。7B 上约 0.71,与跑 DeBERTa 的 0.706 打平。27B 上约 0.89,作者给出的 p 值是 1.89×10⁻²⁸:知道答案的时候,几条独立采样路径给出的 token 完全一样;不知道的时候,错误答案会真的散开 6。
第四段是这篇帖子最值钱的地方。120B 的模型在不接地的事实问答上,AUROC 掉到 0.09:它编的时候,五次采样给出的是同一个错误答案,熵为零。作者把这种现象叫「自信的模式坍缩」——字符串完全一样,所以连笨重的 NLI 也救不回来 6。
作者给出的适用条件是 7B 到 27B、结构化任务(数学、代码、JSON 抽取、SQL、离散问答),做法是温度 0.7 采五条路径、在 Python 里量完全匹配的熵;原始生成日志、评测脚本与完整说明都开源了 617。这一组能确认的范围到 27B 为止:把判据做得更便宜,在中等规模上是划算的,到了最大那几档,判据的失效方式也跟着变了。
Loading content card…
十八种检索管线,输给一个会回头再搜的循环
多跳问题是最能暴露检索短板的一类。FRAMES 里有一道:「如果我未来的妻子,名字与美国第 15 任第一夫人的母亲同名,姓氏与第二位遇刺总统的母亲的婚前姓相同,她叫什么?」答案是 Jane Ballou,要经过四次跳转:第 15 任总统布坎南未婚,第一夫人是他的侄女哈丽雅特·莱恩;莱恩的母亲叫 Jane;第二位遇刺总统是加菲尔德;加菲尔德母亲的婚前姓是 Ballou 8。
PipesHub 在全部 824 道题上跑了 18 种 RAG 变体,再拿自家的 agent loop 跑同一批题。最好的管线答对 78.9%,agent loop 答对 92.7%,与「直接把正确文章交给模型」的 93.0% 基本持平;624 道留出题上是 92.3% 对 78.7% 8。差距随跳数拉开:需要五篇以上文档的题,loop 是 90%,最好管线 62% 8。
两种做法的区别在一个时点。管线只在读之前检索一次,那一次用的是问题本身的词;循环把检索当成模型可反复调用的工具,每读一轮都可以再决定搜什么 8。上面那道题的第二次搜索词——「Harriet Lane 母亲的名字」——在第一次搜索之前根本写不出来 8。
代价那一栏也给了。每题 0.017 美元对管线最好的 0.006 美元;需要一趟就能答的简单题两边差不多,而且循环更快(8 秒对 27 秒);提示词缓存承担了循环 47% 的输入,缓存系统提示与工具定义可以把成本再压近一半 8。
同一个实验里最反直觉的一条是重排器。给混合检索加查询扩展那套管线配上一个小交叉编码重排器,准确率掉了约 9 个百分点;换成大的,只把这 9 个点追回来,没有额外增益 8。唯一加分的技巧是「小到大」:检索时用小片段命中,交给模型时给整篇文章——它把最好管线从 73.4% 抬到 78.9%(79 题赢、33 题输),代价是每题成本涨到约三倍 8。
这一组的限制作者写在帖子里:他在 PipesHub 工作,基准代码与运行手册放在开源的 frames 分支里可以复跑;所有答案是端到端正确率,由两个 LLM 评审按 FRAMES 论文自己的评分提示打分(Claude Sonnet 5 与 Gemini Flash 3.8,一致度 κ 0.93–0.98);每个正确答案都核对过系统真正读到的文本,靠模型记忆答对的不算检索的功劳 818。
Loading content card…
同一份 95.5GiB 权重,换引擎从 23.1 到 40.8 tok/s
Slipstream 是一个跑在 Apple Silicon 上的 C++ Metal 推理引擎,自带 SSD 专家流式与投机草稿。它的作者上一版做的是 llama.cpp 的专家流式分支,解码卡在 23 到 27 tok/s、上下文一长就往下掉 9。
他给的对照是同一份权重、同一台 M5 Pro(64GB 统一内存、温度 0.0)、六道推理与编码题:llama.cpp 分支平均 23.1 tok/s,Slipstream 40.8 tok/s,1.76 倍;首字从 1,863 毫秒降到 1,290 毫秒 9。省下来的时间来自三处:把专家矩阵的同步页读换成非阻塞预读提示,预填充阶段的停顿少了 28%;工具调用与代码生成时用提示词查找草稿,把工具调用的解码从 5.6 tok/s 提到 45 以上;把 26.8GiB 的 n-gram 表直接映射进 Metal 内核 9。
长上下文那一栏是他这篇帖子最硬的部分:真实编码会话的 3,086 次请求按上下文长度分档,1k 以内是 41.5 tok/s,4k 到 8k 是 43.6,32k 到 64k 落到 35.0,96k 到 130k 仍有 32.9 9。他给的解释是模型结构本身:48 层线性递归层只保留固定大小的状态,只有 16 层是全注意力 9。
还有一个可选的 Swift 变体,用 KV 稀疏注意力蒸馏换来更低的显存压力。在 145 道配对题上(温度 0.0、固定种子),原版总分 67.6%、Swift 70.3%,提升集中在 GPQA Diamond 那一行(45.7% 到 54.3%),AIME 2025、GSM8K、HumanEval 与硬逻辑四行完全没有变化 9。
限制都写在帖子末尾:所有测试只在 M5 Pro 64GB 这一台机器上做过,作者手上没有现代 NVIDIA 或 AMD 硬件,也就没有 CUDA / ROCm 后端;引擎的 C++ Metal 投机解码设计来自 Splash 团队,作者准备把这两处扩展提回上游;首次启动要在模型目录里建流式包,要 5 到 7 分钟,之后每次加载 10 到 15 秒 9。权重、引擎仓库与那个可选变体都公开 1920。
Loading content card…
两张 2080Ti,跑了一整本 MySQL 8.4 文档
小红书这条笔记的作者把两台五年前的 22GB 卡配成了一台生产机:2×RTX 2080Ti,引擎用的是社区维护的 vLLM 分支 vLLM-2080Ti-Definitive v0.2.2(对应 sm75 架构),权重是 unsloth 的 Qwen3.8-27B-NVFP4,KV 缓存用 FP8 10。
他只改了作者给的配置里两处:投机解码从另一套草稿方案换成模型自带的 MTP 头,3 个 token;并发槽从 1 开到 8 10。跑起来之后做的事是翻译加审校一整本 MySQL 8.4 文档,一共 11 小时 10。
他自己试过的单变量有几条值得抄:功耗墙压到 220W,性能掉 4.5% 到 6%;放到 250W,与默认上限几乎没有差别;nvlink 在 PCIe 带宽吃紧时帮了大忙,他特别写了一句,这个结论与 strata 部署 next flash 那套正好相反;平台与内存影响不大,因为该装的东西都在显存里 10。
边界同样清楚:单人、单模型、单任务,没有逐轮吞吐与令牌量的记录,作者自陈折腾了好几周才稳下来 10。笔记的第 1、2 页把硬件、软件栈、权重与完整启动参数逐行列了出来,
run.sh 标着原样可跑 10。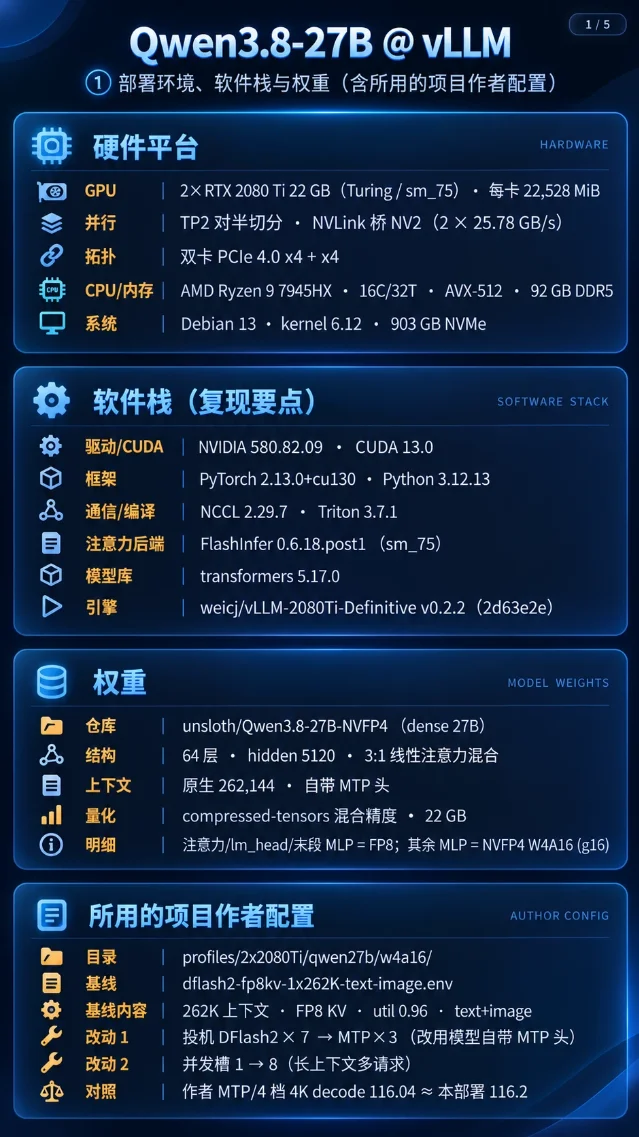
100M 的说话人分离模型,在 16GB 的小机器上跑得比上一代准
公众号「蘑菇研究 AI 开源分析」测的是 NVIDIA 新发的 Nemotron-3-Diarization:1 亿参数、最多同时跟踪 8 个说话人,同一个权重可以在 0.32 秒到 30.4 秒之间切换延迟,许可证是 OpenMDW-1.1,商用不设门槛 11。
测试机是一台 16GB 内存的 M4 Mac mini。第一个坑出现在安装:按模型卡的指引用官方脚本装运行时,装到的是 8 月 19 日的 v0.1.0 版本,比模型发布早一个多月,加载时直接报
pre_ln transformer variant is not supported;要自己从 main 分支编译,这条支持是 9 月 24 日才合进去的 1121。跑通之后的速度是:107MB 的 q8_0 GGUF 处理 10 分钟音频,CPU 流式 69.1 秒、CPU 大块 6.6 秒、Metal 流式 22.4 秒、Metal 大块 3.1 秒 11。还有两条与直觉相反的观察:短文件上 Metal 反而更慢(97.6 秒音频 Metal 25 秒、CPU 12 秒),看起来有十几秒的固定启动开销;默认的流式模式适合实时场景,处理已经录好的文件应该换成大块预设,快十倍左右 11。
准确度那一栏分成两半。真人双人样本上,新旧两代都没有认错人,误差全部来自说话段的起止比参考标注宽一点,Nemotron 3 的 DER 是 13.18% 到 15.11%、混淆为零 11。换到 macOS 自带语音合成的 5 人中文对话,从头到尾被判成 1 个人,上一代也一样;作者对此的判断是别拿系统合成语音来测说话人分离,这类「假会议」会得出错误结论,手上如果是 AI 配音的播客或多角色有声书,要先用自己素材试 11。
模型卡自己的成绩单也要打个折。DER 相比上一代普遍下降三到六成,但全由 NVIDIA 自己用 NeMo 脚本跑出,基线只有自家上一代;说话人计数在 AMI 上反而变差,准确率从 93.75% 掉到 81.25%–87.50%,NOTSOFAR1 单通道流式只有 55%–61% 11。第三方目前只有 NVIDIA 的推理合作方 Baseten 发过对比,它在 AISHELL-4 上比上一代大幅提升,却只在 AMI 上输给了 pyannote community-1 11。中文真人会议这一档他们没有测到,只能引用 AliMeeting 与 AISHELL-4 的自报数字,而这两个数据集的训练集都参与了训练 1122。
今天能带走的三句话
第一句,先看这一步是不是只要求一个判断。是判断,就先用小的一档试。Clef-flash 用 9B 换来了 38.8 毫秒的中位延迟,Jeff 用 0.8B 换来了 38 倍的速度,这两个数字在需要实时路由的场景里比多出来的几分准确率更值钱 12。
第二句,小的一档有它自己的天花板,而且失效方式会随规模改变。字符串判据在 7B 与 27B 上追平了神经网,到 120B 掉到 0.09;18 条检索管线靠调优把上限从 73.4% 推到 78.9%,剩下的 13.8 个百分点要靠让模型读完之后能再搜一次 68。
留一个今天就能做的核对项:从你手上的一个判断任务里抽 300 条真实样本,先拿大模型跑一遍当基线,再把同一个判断交给一个 10 亿参数以内的前置层,两边各记三项——准确率、每次判断的耗时、常驻内存。三项都记下来,换不换档这件事才有得比。
References
- 1Cloudflare:Introducing Clef
blog.cloudflare.com
- 2
- 3小红书:一句暗号,就能测出Claude新模型
xiaohongshu.com
- 4
- 5
- 6Reddit:不用 VRAM 检测本地模型的幻觉\
reddit.com
- 7Reddit:我们拿 18 条 RAG 管线对了一个 agent loop\
reddit.com
- 8PipesHub:Agent Loop vs Traditional RAG\
pipeshub.com
- 9
- 10小红书:qwen3.8 27b 双2080ti22G 部署经验\
xiaohongshu.com
- 11公众号 蘑菇研究 AI开源分析:英伟达 Nemotron 说话人分离模型 Mac 实测\
mp.weixin.qq.com
- 12Cloudflare Workers AI:Clef 模型页
developers.cloudflare.com
- 13Hugging Face:Cloudflare/clef
huggingface.co
- 14小红书:决策模型成了新品类,Cloudflare 开源 Clef
xiaohongshu.com
- 15X:@vikktorrrre 的同题对照
x.com
- 16GitHub:firelex/jeff
github.com
- 17GitHub:nayakbhupen/Spnda
github.com
- 18
- 19GitHub:npanj/slipstream
github.com
- 20Hugging Face:nitinpanj/qwen38-flash-next-v3
huggingface.co
- 21GitHub:NVIDIA/NeMo-Speech.cpp
github.com
- 22Hugging Face:nvidia/Nemotron-3-Diarization
huggingface.co
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.