3%、纪录低位:彭博情报说中美最好的模型相差 2.3 分
彭博情报把中美顶级模型的基准分差量到 3% 的纪录低位,这篇拆开这个数字量的是什么、它自己的读数序列长什么样,以及从它引出的出口管制与盈利结论各自有多少证据。

10 月 4 日,彭博社发出一篇报道:美国 AI 公司对中国的性能领先,在过去几个月收窄到了有记录以来的最低。1
它给出的数字是:按基准分数算,中国最好的模型落后美国最好的模型 3%。
这个数出自彭博情报(Bloomberg Intelligence,彭博旗下的研究部门)高级分析师 Robert Lea 的一份报告。彭博社这篇报道的发布时间是 10 月 4 日 21:03 UTC,即北京时间 10 月 5 日凌晨 5 点过。1
本篇的原文是完整可读的,未订阅也能拿到全文;本刊另核对了《海峡时报》同日刊出的彭博社授权转载版,两份正文文字一致,转载版在导语上方多出三条摘要。下文凡用到转载版独有的内容,单独标注。2
先说清 3% 量的是什么:它是两边最好的那一个模型、在一张榜单上的相对分差。同一份报告里,那张榜单的前 15 名中来自中国的模型是 3 个。1 头部在靠近,版图的其余部分仍在另一边。
01|原文说了什么:一份用几个数字搭起来的研究笔记
彭博社这篇的结构很简单,把人名、机构和数字摆出来就够了。
数字一:3%,以及它的来路。 彭博情报称,中国最好的模型在基准分数上只落后美国最好的模型 3%,这是纪录低位;5 月这个差距约为 9%,今年更早的时候是 15%。1
数字二:让分差走到这一步的模型。 DeepSeek 的 V4.1 Flash 在 9 月发布后,于 LiveBench 上排到全球第 6,是该创业公司 2025 年凭推理模型 R1 打开局面以来排名最高的中国模型。1
数字三:81.1 与 83.4。 DeepSeek 该模型最近一次在 LiveBench 上的得分是 81.1,低于 Anthropic 最好的 83.4。Lea 由此判断,这个中国模型与 Anthropic、OpenAI 的领先系统之间是「可比的表现」(comparable performance)。1
数字四:15 名里的 3 个。 报告同时指出,LiveBench 评出的前 15 名模型中只有 3 个是中国模型。1
在这四个数字之外,原文写了两段判断。一段指向美国:中国的进步「进一步让人怀疑美国在 AI 上的技术优势能否长期维持」(casts further doubt on the long-term sustainability of US technological supremacy in AI)。1 彭博社把这句接在一个推论后面——中国的进展让人怀疑,美国对英伟达等芯片的出口限制,以及用这些限制阻止华为等公司推进自研替代方案的打算,究竟有多大用处。1
另一段指向中国自己:这个行业可能到 2030 年都难以盈利。原因是供给过剩与价格战——低价 token 的供给模式,加上一个涌入 1,100 多个大语言模型、谁也很难取得竞争优势的国内市场。1
原文还记了一个应用层的名次:字节跳动的豆包是 AI 应用变现的领跑者,而 DeepSeek 与腾讯的聊天机器人仍然免费。1
02|3% 是怎么算出来的:四个零件
零件一:分母是「每一边最好的那一个」。 报告比的是每个国家最好的那一个模型:中国的 DeepSeek V4.1 Flash,美国的 Anthropic 模型。这个口径下,差距指的是两支尖子的距离。1
零件二:2.3 分除以 83.4 分。 81.1 与 83.4 相差 2.3 分;以 83.4 为基准,相对差约 2.8%,四舍五入即 3%。这个百分数因此是一个相对差,量的是两支尖子之间的距离。1
零件四:广度停在原处。 前 15 名里中国模型 3 个,美国实验室的模型占去绝大多数。本刊按 10 月 5 日的 LiveBench 榜逐行核对,中国模型排在第 7、第 12 和第 14:
| LiveBench 名次 | 模型 | 归属 | 总分 |
|---|---|---|---|
| 7 | DeepSeek V4.1 Flash Max Effort | 深度求索 | 81.1 |
| 12 | Kimi K3 | 月之暗面 | 79.2 |
| 14 | Qwen 3.8 Max | 阿里巴巴 | 78.5 |
同一张榜上排在首位的是 Anthropic 的 Claude Fable 5.1 Max Effort,83.4 分。3 报告说 V4.1 Flash 上月排第 6,而本刊今日取到的榜上它排第 7,中间是一位 81.6 分、标注为 Muse Spark 1.3 的模型——榜单会随新模型上线而移动,这一点 Lea 自己也提醒过。13
把四个零件拼起来,可以画成一条线:这条线描述的是头部两支尖子的距离,而它已经走了很长一段。
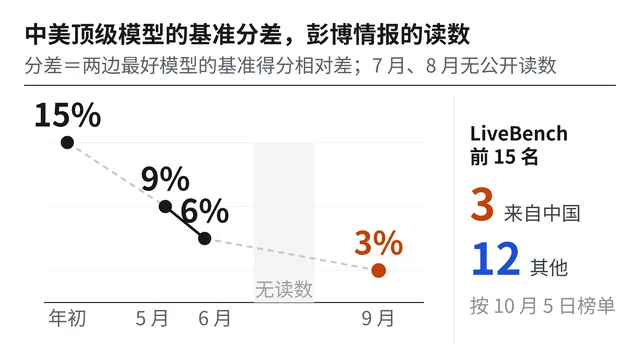
本刊自制。读数出处:彭博社 2026-07-23 与 2026-10-04 两篇报道所引彭博情报报告;LiveBench 前 15 名按本刊 2026 年 10 月 5 日取到的榜单。
这条线里有一处对齐问题,读者自己核的时候会碰到。10 月这篇笔记把 3% 说成低于 5 月的约 9%,而彭博情报 7 月的笔记已经把 6 月的读数称为 6% 的「纪录低点」。45 两处相隔三个月,7 月和 8 月都没有公开读数。所以下面的表里,6 月那一格和 9 月那一格之间是空的。
| 时间 | 分差读数 | 当时的措辞 | 出处 |
|---|---|---|---|
| 2025 年年中起 12 个月 | 平均约 10%—15% | 智谱 GLM-5.2 登上智能体编程榜首后的回顾 | 彭博社 7 月笔记 |
| 2026 年更早 | 约 15% | 「今年更早的时候」 | 彭博社 10 月报道 |
| 2026 年 5 月 | 约 9% | 同上 | 彭博社 10 月报道 · 彭博社 7 月笔记 |
| 2026 年 6 月 | 6% | 「纪录低点」 | 彭博社 7 月笔记 · The Next Web |
| 2026 年 7—8 月 | 无公开读数 | — | — |
| 2026 年 9 月 | 3% | 「纪录低位」,V4.1 Flash 发布后 | 彭博社 10 月报道 |
彭博情报这条线已经做了不只一年。2025 年 6 月,Lea 与同事 Jasmine Lyu 在彭博专业服务上写过一篇同一题的笔记,当时 DeepSeek 的推理模型把公司推到 LiveBench 全球第 4。6
让分差走到 3% 的那个模型。 DeepSeek 于 9 月 10 日发布 V4.1 Flash,官方称它在性能、费用、速度、总用时上全面超过上一代旗舰 V4 Pro。它采用公司称为「因果编码器-解码器」(Causal-Encoder-Decoder)的新结构,总参数 5520 亿,用混合专家(MoE)方式每个请求只激活 80 亿参数处理输入、160 亿参数生成回答。7 它同时下调了价格,并把周一至周五的 9:00—12:00、14:00—18:00 划为高峰,其余时段为空闲,空闲时段输入缓存命中 0.02 元/百万 tokens、未命中 1 元、输出 4 元,高峰翻倍。8
03|出口管制这一半:报告顺带推出的结论,证据到哪一步
原文把「管制的用处」当成一个由分差引出的疑问。要判断这个疑问成立到什么程度,得看同一位分析师和他的同事此前摆过什么。
中国的进展从哪来。 原文自己的解释是两句:AI 专业能力的加深,以及研究人员为本国硬件优化模型的能力。1 也就是,跑分的提升有一部分来自在国产算力上把模型调得更省、更快。
另一把尺子给出的图景不同。 彭博社 8 月 19 日发过一组题为《美国对中国的 AI 领先正在迅速收窄》的图解,同一批数据里另有一条对比:智库「进步研究所」(Institute for Progress)技术研究员 Saif Khan 称,美国的算力约是中国的 10 倍;如果出口管制被完全执行,这个倍数会再扩大 10 倍。同一篇里还写着,华为的昇腾与阿里的平头哥在供给上仍落后于国内实验室增长的需求。9
还有一条解释在报告里只出现了一次。 原文在讲风险时提到,中国模型正面临越来越严的美国监管审查,甚至潜在的禁令,起因是模型蒸馏的指控。1 这条线今年一直在走:美国网络安全和基础设施安全局、国家安全局与联邦调查局 9 月 8 日联合发布公告,点名 6 家中国公司做「工业规模的」模型蒸馏。10 9 月 30 日,彭博社报道 OpenAI 把一次大规模数据提取归因于月之暗面。11
这几样东西量的是不同的事。 基准分数量的是模型在题目上的表现;算力倍数与产能量的是训练下一代模型的条件;蒸馏指控量的是模型能力的来源。把一张榜上的 3% 换算成「管制是否有效」,中间要跨的正是后者这几样。彭博社在同一时期还发过一篇解释稿,把两国在 AI 上的分歧拆成算力、模型、标准、数据与人才五条线,其中任何一条的进展都可以单独检验。12
04|盈利这一半:1,100 多个模型与「到 2030 年」
原文给出的第二个判断更具体,也更容易核:中国的 AI 产业可能到 2030 年都难以盈利。1
1,100 多个这个数可以对上官方口径。 国家网信办 9 月 14 日发布公告:2026 年 7 月至 8 月新增 124 款生成式人工智能服务完成备案,其中含 7 款手机端侧服务;截至 8 月 31 日,累计 1,112 款服务完成备案,另有 731 款应用或功能完成登记。13 报告里那个「超过 1,100 个大语言模型」,落在的就是这个备案口径上。
豆包变现领先这件事,有公开动作可查。 2026 年 5 月,豆包在苹果 App Store 更新付费订阅说明,设标准版 68 元、加强版 200 元、专业版 500 元三档连续包月,包年最高 5088 元,付费功能聚焦 PPT 生成、数据分析、影视制作这类高算力消耗的场景。14 6 月 24 日,豆包又推出面向个人专业用户的专业版。15 字节跳动在 6 月披露,豆包大模型的日均 token 调用量当时已突破 180 万亿。15
为什么这些规模换不来利润。 报告的判断是结构性的:大量算力花在低毛利的 token 供给上,价格战又让任何一家都难以取得竞争优势;要让它走上可持续的盈利轨道,需要竞争压力降温、行业出清,以及更理性的定价。1
这段判断与彭博情报的旧结论一脉相承。2025 年 6 月那篇笔记里,Lea 与 Lyu 已经把「变现前景艰难」写在同一份报告里,理由是应用市场缺乏差异化,用户对免费产品的接受度高。6 一年后,结论从「变现艰难」走到了「2030 年前难盈利」。
05|原文引用
下面几段都来自彭博社这篇报道的正文,附中文译文。
关于技术优势,Lea 的话被原文直接引用:
The Asian country's progress "casts further doubt on the long-term sustainability of US technological supremacy in AI," Lea said.译:这个亚洲国家的进展,「进一步让人怀疑美国在 AI 上的技术优势能否长期维持」。1
关于 81.1 与 83.4 的关系:
That means the DeepSeek model delivers "comparable performance" to leading AI systems from Anthropic and OpenAI, Lea said.译:这意味着,DeepSeek 这款模型与 Anthropic、OpenAI 的领先系统之间是「可比的表现」。1
关于榜单本身靠不靠得住:
Such rankings shift, Lea cautioned, and it could be difficult to monetise regardless of leaderboard scores.译:Lea 提醒,这类排名会变动,而且无论榜单分数如何,变现都可能很难。1
关于盈利的前提:
"Putting China's AI sector on a sustainable profit footing will require a cooling of competitive pressures, an industry shakeout, and a more rational approach to pricing," he said.译:「要让中国的 AI 行业走上可持续的盈利轨道,需要竞争压力降温、行业出清,以及更理性的定价方式。」1
以及原文对低价策略的一句概括:
A focus on low-margin token supply and a brutal price war may make it impossible for any firm to gain a competitive edge in a domestic market flooded with more than 1,100 large language models.译:集中在低毛利 token 供给上的经营方式,加上一场惨烈的价格战,可能让任何公司都无法在一个涌入 1,100 多个大语言模型的国内市场里取得竞争优势。1
06|接下来看什么
| 看什么 | 为什么它能验证 | 出处 |
|---|---|---|
| 10 月、11 月的 LiveBench 榜 | 分差是逐月读出来的,下一个月就是这条序列的下一格,也能看出榜单本身的波动幅度 | LiveBench |
| 彭博情报会不会补出 7、8 月的读数 | 这条序列在 6 月与 9 月之间空了两格;补上才知道 3% 是一路平滑下来,还是中途有过反复 | 7 月笔记 · 10 月报道 |
| DeepSeek V4.1 Pro 上线后的分数 | V4.1 Flash 是 DeepSeek 新结构中「最小尺寸」的那一个,下一档上线后,中国这边的头部会再换一次 | 南华早报 · 新浪财经 |
| 美国下一轮的管制动作与豁免 | 原文把「管制有多大用处」当成疑问提出;此后每一次收紧或放行,都是对这个疑问的一次回答 | 彭博社解释稿 |
| 中国 AI 公司的收入与利润率 | 「2030 年前难盈利」可以用财报与招股书逐季对照,第一批反例会先出现在头部公司的毛利率上 | 彭博社图解 |
References
- 1
- 2
- 3LiveBench
livebench.ai
- 4
- 5
- 6
- 7
- 8新浪财经:DeepSeek V4 Pro 被淘汰:V4.1 Flash 上位,价格最低 0.02 元
finance.sina.com.cn
- 9
- 10
- 11
- 12Bloomberg:Five Ways the US and China Clash Over AI
bloomberg.com
- 13
- 14新华网:『豆包』收费,国产大模型会像美国一样全面付费吗
xinhuanet.com
- 15北京商报(经百度百家号):180万亿Token之后,豆包要算「经济账」
baijiahao.baidu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.