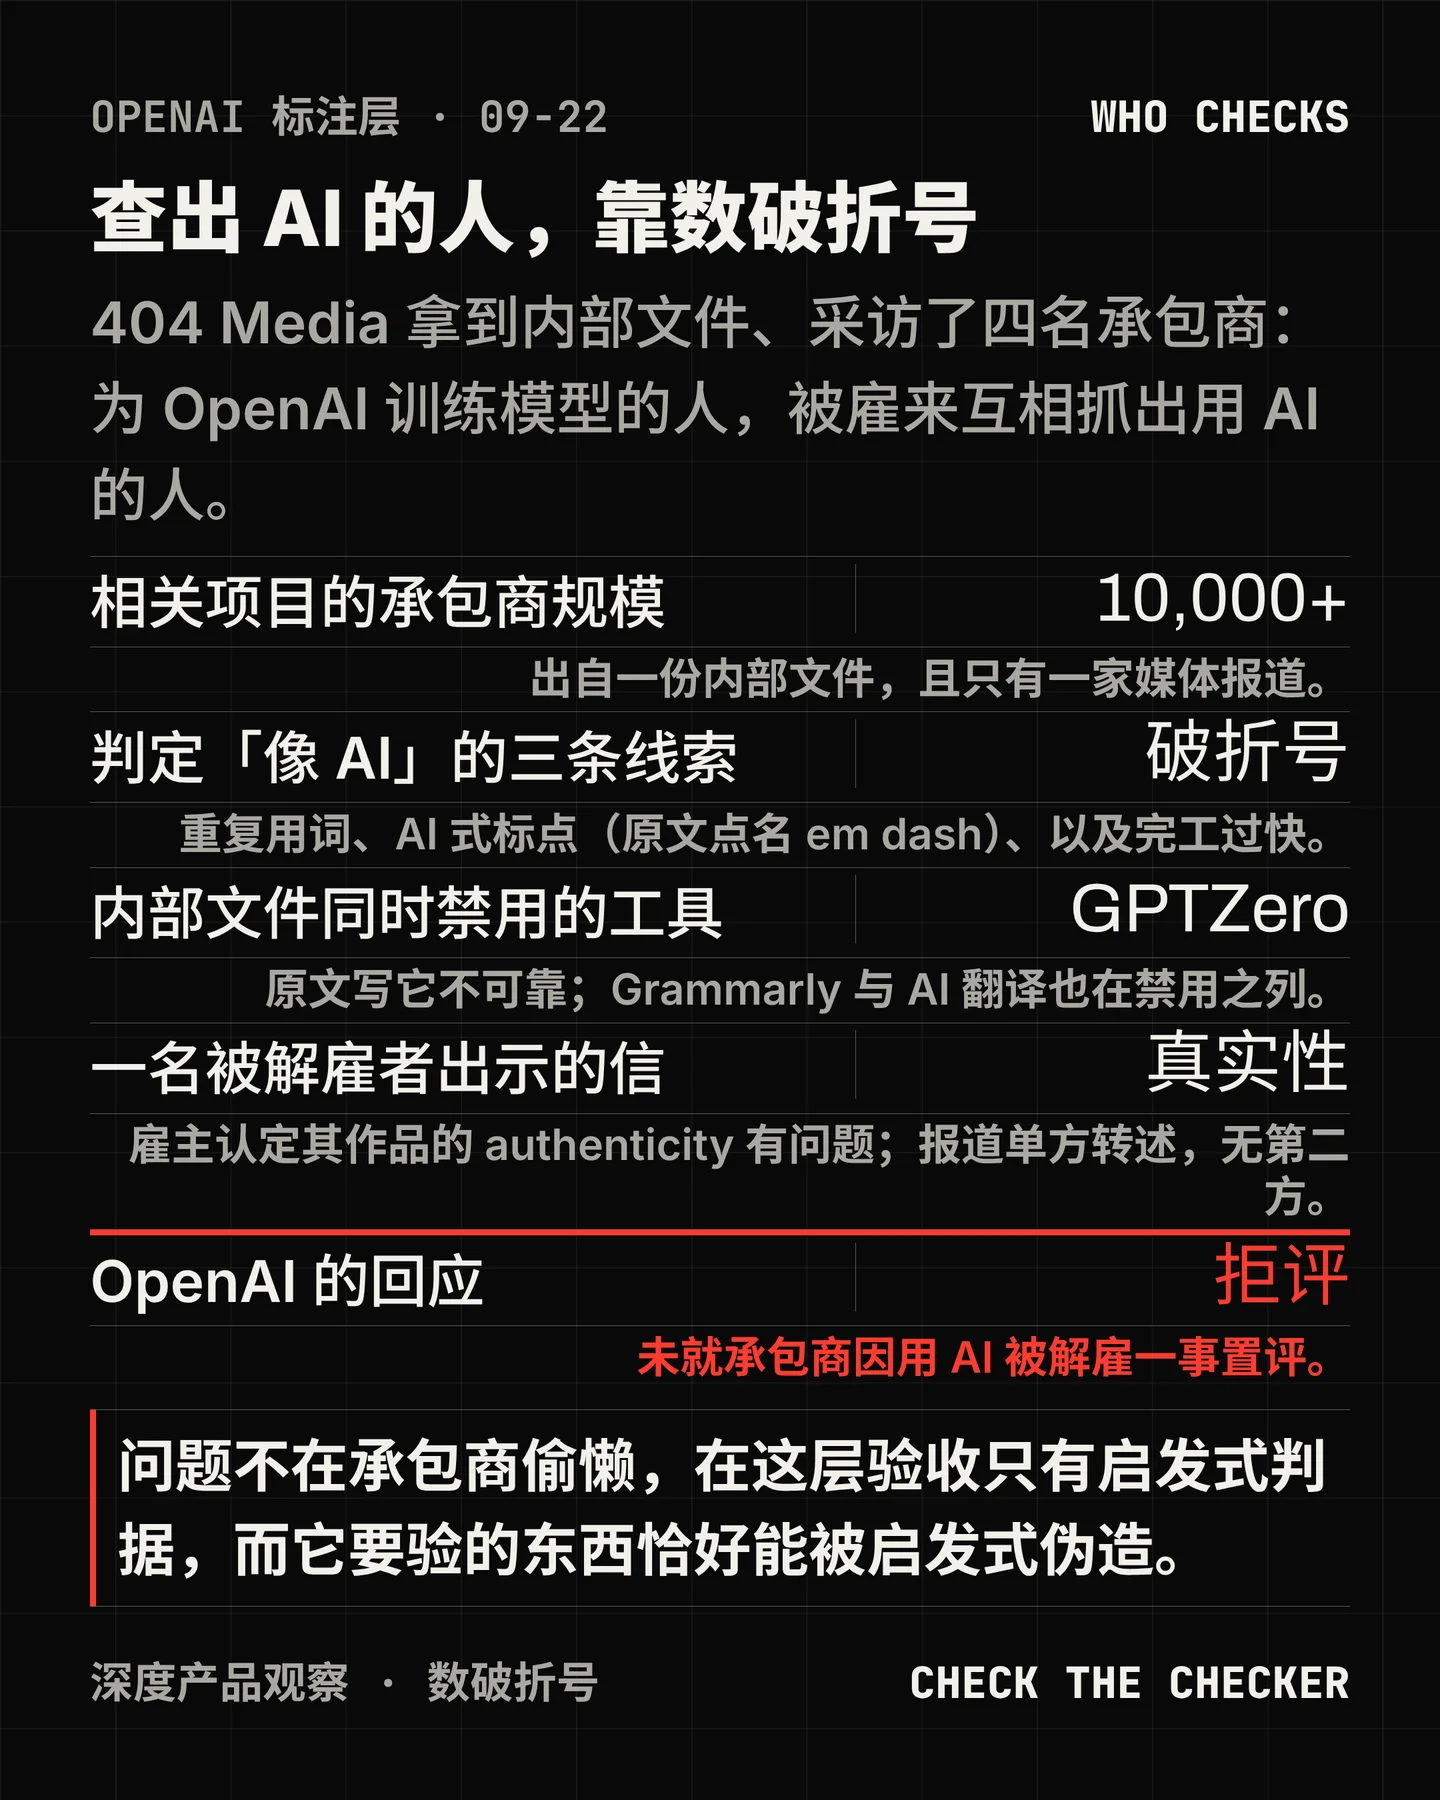

关于「是不是人写的」这个问题,OpenAI 的承包商们在一周里得到了一个共同的答案。404 Media 在 9 月 22 日的报道里写:OpenAI 有成千上万名承包商在帮它改进模型,其中多名承包商因为在训练里使用 AI 而被解雇。报道拿到了内部文件,并采访了三名为 OpenAI 工作的承包商;据其中一份内部文件,相关项目「可以包括一万名以上承包商」。1
这份内部文件里最有用的一句,是它给审核员定的判据。它要求那些被雇来复核其他承包商工作的人留意「AI 的迹象」,并列出三条:重复用词、AI 式标点(原文特别点了破折号用得过多)、以及完工过快。同一份文件禁止他们使用检测工具:「不要使用 AI 检测工具,也不要用 AI 本身」「不要使用 GPTZero 或任何其它 AI 检测工具,它们不可靠」;Grammarly 与 AI 翻译同样在禁用之列。它还叮嘱不要把怀疑的理由告诉被评估的人——「他们知道你看什么就更容易藏起来。判断整体模式,不要只看一条线索」。1
三名受访承包商都说审核员被告知不得使用 AI,其中两人说有人因此被解雇或移出项目。一名承包商出示了他所称的解雇信:雇主认定他作品的「真实性」(authenticity)有问题。他说,「我不是坏人也不是坏员工。我只是需要一点助力,转向了 AI,最后毁在这上面。」在相关的工作群组里,人们会贴一段文字互相问「这是 AI 写的吗」;用他的话说,「答案通常是是」。两名受访者供职于 Mercor,一家为 OpenAI 等项目提供专家的 AI 训练公司;其发言人的声明是:专家的价值在于专业判断,合同「严格禁止使用大语言模型完成任务」,公司「投入大量工具与系统检测滥用」,一旦确认就「立即把此人移出项目」。OpenAI 拒绝就此事置评。1
这条线要连到上周那一篇才完整。9 月 14 日,同一家媒体披露了 Project Lily:OpenAI 有数百名承包商在阅读真实用户的提示与对话,其中可能包含个人信息;他们为回答打分,确认回答不至于过于谄媚、也不至于把 ChatGPT 说成人。后续报道补上了法律角度:对话先经过一个脱敏模型,但那个模型自己的说明页承认会出错、会漏掉不常见的标识符;个人方案的「为所有人改进模型」默认开启,企业与教育版默认关闭。234
把它读成一个机制问题,事情就不像操守问题。任务队列按件结算,照着模版交一段比判断一段便宜得多;验收这一层的判据是启发式——重复用词、破折号、速度——而文件自己承认连检测工具都不可靠;执行验收的审核员同样是承包商,同样按件取酬,同样被禁止使用 AI。谁验收验收者,在这份材料里没有答案。1
这里还有一条方向相反的失效。第四名受访者没有供职于被点名的那家公司,他说自己有时故意挑最差的回答,因为他想破坏这次训练——「我要么完全不管结果、随机挑,要么故意挑最差的那条……感觉像是拿了钱在把 AI 变差。」根因在这条路径上同样成立:没有人能分辨屏幕前的人是在认真判断,还是在省力。1
机制侧的参数其实已经写清楚了。最早那篇关于「模型崩塌」的论文说的是一件更窄的事:反复用模型自己生成的内容训练,会让原始数据分布的长尾消失,造成不可逆的缺陷。后续研究里有一派明确反驳这个概念被讲得过宽;另有一篇给出了更贴近本案的结论——只要注入信息的外部验证者可靠(无论是人还是更强的模型),用合成数据重训并不会导致崩塌;但「除非验证者完全可靠,这些早期收益会见顶,甚至反转」。这一层验收的问题正在这里:它的验证者是一组按件取酬、被禁止使用工具、并且主要靠破折号与速度来怀疑的审核员。5678
能核的和不能核的,要分开写。能核的:内部文件的关键三句与公司声明全文都随报道刊出;这家公司的政策页明文允许用语言模型检查语法、在保留自己想法的前提下微调措辞与语气,同时禁止用它评估模型回答、写理由或预测代码行为——也就是说,它对外的说法是「严格禁止使用大模型完成任务」,对内的政策页却有一张允许清单,两者不是同一句话;它的行为政策还写明用桌面监控工具在工作时记录时间与截图,处置分三级:减付或追回、移出项目、停用平台权限。不能核的同样明确:解雇信只有一家媒体的转述;被解雇人数、时间跨度、项目名与文件名称都没有公开;截至报道发出后数小时,没有第二家媒体报道这件事,OpenAI 唯一的表态是拒绝置评。1910
这一层工人自己的数字,另一份材料给了参照。一份由美国通信工人工会与 TechEquity 发布的调查访问了 160 名美国数据工人:中位时薪 15 美元,中位每周有薪工时 29 小时,折合年收入 22,620 美元;87% 的人说经常被派到自己没有受过充分训练的任务上;52% 认为自己在训练会替换别人工作的 AI,36% 认为会替换自己的工作。11
「人类数据」这句话能验到什么程度,是有可查参数的。一项 2023 年发表于同行评审期刊的实测把 GPTZero 放在 50 篇人类医学文本与 20 篇机器文本上,灵敏度 0.65、特异度 0.90,作者的结论是高漏报;另一项 2025 年的论文测了 28 篇 AI 文章与 50 篇人写文章,AI 侧识别率很高,人写侧出现若干假阳性,作者提醒不要只靠检测工具下结论。更早的一项研究在亚马逊的众包平台上重跑了一个摘要任务,用键击检测与合成文本分类估计,33% 到 46% 的众包工人使用了语言模型;它的结论是一句话:「平台、研究者与众包工人需要找到新办法,确保人类数据还是人类的」。121314
采购侧的口径也在变。OpenAI 自己的帮助页写着:少量授权员工与「受保密与安全义务约束的可信服务提供者」,可以在调查滥用、提供支持、处理法律事务、以及「改进模型表现」(用户未选择退出时)这些目的下访问用户内容,并明确提到内容「可能被发送给可信服务提供者用于数据标注与安全目的」。它的招聘页则直接写出了这条外部供应链:Human Data 团队的工作包括与「外部供应商、训练师与内部研究者」合作收集、复核与交付数据,并负责「定义成功标准、校准 AI 训练师」。换句话说,这条链的存在是官方文件写明的,能验到什么程度才是要问的。1516
谁会受影响。正在采购标注、评估或红队数据的人,和正在内部搭建同一条流水线的人。你们手上握着的不是「人类撰写」这个事实,而是一份流程主张;这份主张的强度,大约是判据的可靠性乘以执行的独立性。1
落到动作,这周能定五件事。第一,先要判据:请供应商写出它用什么判「像 AI」,以及这条判据的假阳与假阴。第二,把禁止写成白名单:哪些辅助能用、哪些绝对不行,分列清楚;口号式的严禁验不了。第三,别把检测器当闸门——供应商自己说它不可靠,同行评审的灵敏度是 0.65。第四,用不可伪造的过程信号:时间、跨评分者一致性、抽检复评;同时要防盯屏与计件本身把诱因做大。第五,交付要求改口径,写「数据出处可核」,不写「人类撰写」;按欧盟人工智能法案第 10 条,高风险系统的数据治理本来就要求写清数据来源、标注(annotation)、打标与偏见检视。91017
最后压成一句:问题不在某几个人偷懒,而在这层验收只有启发式判据——而它要验的东西,恰好能被启发式伪造。被解雇的人数、涉及的项目名、内部文件的名称都还没有公开;换句话说,这一层能做到什么程度,目前只有它自己的说法。1
References
- 1
- 2404 Media:Inside 'Project Lily'
404media.co
- 3The Next Web:人工复核与告知义务
thenextweb.com
- 4Forklog:Project Lily 的流程细节
forklog.com
- 5
- 6
- 7
- 8
- 9Mercor:LLM 使用政策
talent.docs.mercor.com
- 10Mercor:账号安全与行为政策
talent.docs.mercor.com
- 11CWA / TechEquity:Ghost Workers in the AI Machine
cwa-union.org
- 12JKMS:GPTZero 在医学文本上的实测
pmc.ncbi.nlm.nih.gov
- 13arXiv:2506.23517:GPTZero 在作文上的准确率
arxiv.org
- 14
- 15OpenAI 帮助页:消费级服务的数据使用
help.openai.com
- 16OpenAI 招聘页:Human Data 项目经理
openai.com
- 17EU AI Act:Article 10 - Data and Data Governance
artificialintelligenceact.eu
Comments