AI 全景情报 0804:OpenAI 重写实时语音栈,AWS 与 Amazon 把 AI 交付推向系统效率
OpenAI 将实时语音拆成连续媒体与异步推理路径,AWS 同时补齐模型定制和应用防护,Amazon 则继续上调 AI 云资本开支;本期把这些动作还原成工程、采购与投资决策中的四段系统账。
先看结论
本期覆盖 2026 年 8 月 3 日 00:00 至 8 月 4 日 08:00(Asia/Shanghai)。四条新增信号来自 OpenAI 的实时语音工程、AWS 的模型定制和应用防护、Amazon 的云资本开支,合起来指向一个更具体的变化:AI 交付的竞争单位,正在从「模型能不能回答」变成「实时链路能不能稳定、模型能不能按业务训练、应用能不能持续防护、算力能不能按期上线」。
OpenAI 把 GPT-Live 的语音路径拆成连续媒体流和异步推理路径;AWS 把 25 个以上开源模型的全量微调接入 serverless 服务,并把 AI/ML 应用防护做成可订阅的 WAF 规则;据 CIO Dive 转述 Amazon 财报电话会,Amazon 将 2026 年资本开支预期从约 2000 亿美元上调到 2200 亿美元,且仍预计短期容量无法满足全部需求。1234
| 信号 | 事实变化 | 对从业者的直接含义 |
|---|---|---|
| OpenAI GPT-Live | 从 turn detector 驱动的轮流对话,改成 full-duplex 语音模型加异步调用 GPT-5.5、工具和业务逻辑。1 | 语音 Agent 要把实时媒体路径与推理、工具、持久化路径分开设 SLO |
| AWS SageMaker | Serverless model customization 支持 25 个以上开源模型的 full fine-tuning,覆盖四个区域。2 | 「定制模型」的基础设施门槛下降,但数据、评测、版本回滚仍是交付成本 |
| AWS WAF + Miggo | 通过 Marketplace 提供持续更新的高风险漏洞和 AI/ML 应用防护规则。3 | WAF 可以成为 AI 应用的第一层防线,但不能替代 Agent 权限、工具授权和行为审计 |
| Amazon / AWS | 据报道 2026 年 CapEx 预期升至约 2200 亿美元,主要投向 AI 与 AWS,容量仍可能供不应求。4 | 采购模型要把 GPU、内存、机房、区域和交付时间一起计价,不能只看 token 单价 |
1. OpenAI:实时语音先解决系统节奏,再谈 Agent 能力
OpenAI 8 月 3 日发布的工程文章,披露了 GPT-Live 背后的系统重构。此前的语音架构依赖 turn detector 判断「用户是否说完」,判断早了会打断,判断晚了会拖慢响应;GPT-Live 的 voice model 改为 full-duplex,可以同时听和说,并把更深的推理、搜索和工具调用交给异步路径。1
这不是把一个更大的模型塞进语音产品。OpenAI 把音频输入、输出和会话连续性留在实时媒体路径里,把 GPT-5.5、工具调用、业务逻辑与会话持久化放到另一条路径。慢工具可以晚一点返回,但不应堵住音频流。这个边界决定了语音 Agent 的产品体验:用户可以容忍「稍后给出更深的答案」,很难容忍每句话都等一轮请求响应。
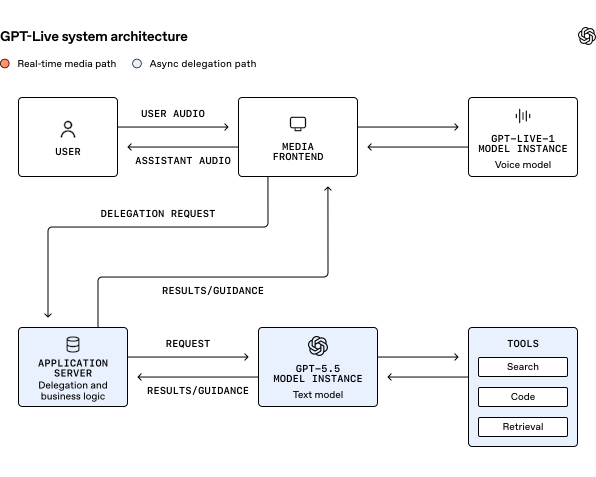
OpenAI 还披露了两个容易被忽略的工程细节。第一,媒体前端和推理逻辑从 Python
asyncio 改用 Go,公司的说法是新系统的 p95 帧交付表现达到旧系统 p50;第二,WebRTC 连接建立被其 WARP 方案从 6 次网络往返压到 1 次,目标是把「用户点击」到「开始听见」的等待压进实时体验预算。两项数字都是 OpenAI 自有工程口径,不是独立评测。1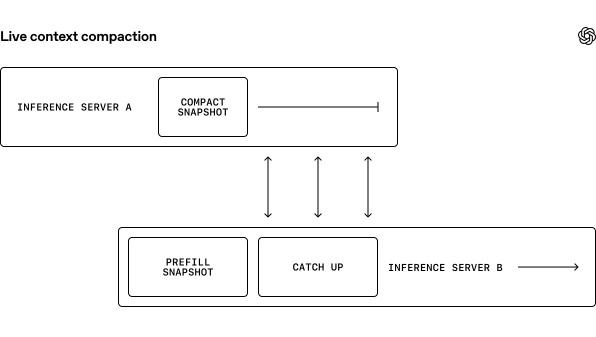
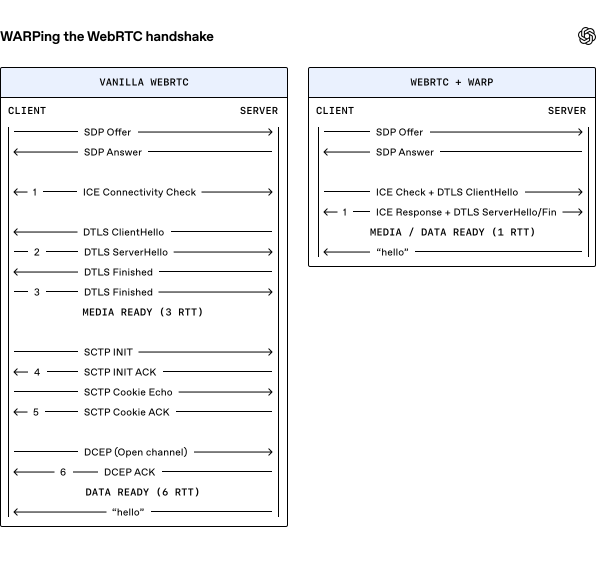
这对 AI 从业者意味着什么: 语音 Agent 的核心架构不应再只有一个「模型延迟」指标。至少要拆成媒体帧是否按时到达、异步推理多久返回、工具调用是否阻塞、长会话如何迁移、不同地区的网络路径是否稳定五组指标。OpenAI 的生产影子测试还暴露了一个现实问题:并发语音会话的瓶颈不一定先出现在 GPU,也可能先出现在 CPU 流处理、队列和网络组件。
对产品经理,下一步要把「用户插话」「工具迟到」「模型实例切换」「连接重试」写进验收用例;对工程师,实时路径和业务逻辑要有独立的降级开关。OpenAI 文章提到 GPT-Live API 将在后续提供,但没有在这篇文章里给出价格、开放范围或地区可用性,因此不宜把它当成已经全面开放的 API。
2. AWS SageMaker:全量微调被托管,模型定制进入成本工程
AWS 8 月 3 日宣布,Amazon SageMaker AI 的 serverless model customization 支持对 25 个以上开源模型做 full fine-tuning,模型家族包括 gpt-oss、Gemma、Llama、Nemotron 和 Qwen。此前的 LoRA 等 parameter-efficient 方法只更新部分权重;full fine-tuning 会更新全部参数,适合需要学习专有术语、复杂输出格式、领域知识或更深层任务模式的场景。2
新变化不只是「可以微调更多模型」,而是 AWS 把基础设施配置和训练编排从使用者的责任中拿走。客户从 SageMaker Studio 的 JumpStart and Models 页面,或 SageMaker Python SDK 发起定制任务;官方称按使用量付费,不需要自行配置和管理训练基础设施。当前页面列出的区域是美国东部(弗吉尼亚北部)、美国西部(俄勒冈)、亚太(东京)和欧洲(爱尔兰)。2
这降低了「定制模型」的启动门槛,却没有消除定制的其他成本。full fine-tuning 需要更严格的数据版本管理、训练集与评测集隔离、失败任务重跑和模型回滚;如果业务只是改变语气或固定格式,LoRA 可能更省资源;如果目标是让模型掌握企业内部知识或复杂任务结构,full fine-tuning 才有更强的理由。AWS 的这则更新没有披露具体价格、训练时长或完整支持模型清单,采购时不能只凭「serverless」三个字估算总成本。
这对 AI 从业者意味着什么: 模型定制会从少数平台工程团队的项目,变成更多产品团队可以直接调用的云能力。工程师要先建立一条可比较的基线:同一数据集下,prompt、LoRA 和 full fine-tuning 在准确率、延迟、上下文长度、部署区域和每次更新成本上的差异。产品经理则要把「模型什么时候需要重训、谁批准新版本、旧版本如何回滚」写进发布流程,而不是把微调当成一次性配置。
接下来观察: AWS 后续是否扩大区域和模型覆盖,是否给出更透明的训练成本与作业时长,以及 full fine-tuning 后的模型能否在 SageMaker 推理、日志和权限体系里保持同一套治理边界。真正的竞争不是谁先开放一个微调按钮,而是谁能把数据、训练、评测和上线连成一条可重复的生产路径。
3. AWS WAF:AI 应用安全开始以规则更新速度竞争
同日,AWS WAF 新增了两个可从 AWS Marketplace 订阅的 Miggo Security 托管规则组:一个面向正在被利用或已有公开 PoC 的高风险应用漏洞,另一个专门面向 AI/ML 应用防护。后者覆盖 AI Agent 框架、LLM gateway 和模型服务基础设施等生成式 AI 应用栈;规则支持版本管理,价格由 Miggo 在 Marketplace 设定。3
它的价值在于把一部分防护工作从「团队自己写规则」改成「订阅持续更新的规则」。AWS 页面说明,High Emerging Application Threats 规则组关注活跃利用漏洞、已有公开概念验证代码的漏洞,以及 CISA Known Exploited Vulnerabilities(KEV)目录中的漏洞;AI/ML 规则组则把保护对象直接写成 Agent 框架、LLM 网关和模型服务基础设施。3
但要分清边界:WAF 规则解决的是应用入口和已知威胁模式,不等于它理解了一个 Agent 此刻是否有权调用某个工具,也不等于它能替代身份、权限、沙箱、审计和人工审批。对企业来说,它更像是 AI 应用安全基线的一层,而不是完整的 Agent 控制面。规则的误报率、更新时延、覆盖哪些框架版本,以及在真实流量下会不会阻断正常请求,仍需团队自己验证;官方更新没有提供效果 benchmark。
这对 AI 从业者意味着什么: AI 应用的安全预算会从「上线前做一次渗透测试」,转向入口规则、模型网关、工具权限和运行日志的持续组合。做平台的团队可以把 WAF 规则作为默认防线,但仍应保留对高风险工具的显式授权、请求级审计和一键停用路径。做采购的人要问的也不只是「支持哪些 AI 框架」,还包括规则更新 SLA、版本回滚、误报处理和区域可用性。
接下来观察: AWS Marketplace 上的 AI/ML 规则是否形成多个供应商的竞争,Miggo 的收费和更新频率如何,AWS 是否把类似能力进一步接入 AgentCore、Bedrock 或身份与观测产品。若规则层和运行时权限层开始打通,企业 AI 安全才会从外围防护进入执行链。
4. Amazon:云资本开支继续上调,但容量仍是约束
据 CIO Dive 8 月 4 日凌晨发布的报道,Amazon 在第二季度财报电话会上把 2026 年资本开支预期从约 2000 亿美元上调到 2200 亿美元,增量主要投向 AI 和 AWS。报道援引 Amazon CEO Andy Jassy 的说法称,公司预计服务器部署后大约两年开始看到回报,同时即使按上调后的投资速度,2026 年仍不足以满足全部客户容量需求,紧张状态可能延续到下一年。这里的金额、回报周期和容量判断均为公司在财报电话会上的口径,由 CIO Dive 转述。4
同一报道援引 Synergy Research Group 数据称,2026 年第二季度企业云基础设施服务支出达到 1430 亿美元,环比从 1000 亿美元上升,年增长率为 43%;AWS、Azure 和 Google Cloud 的市场份额分别为 28%、20% 和 15%。这些是研究机构的市场统计,不是 Amazon 单独的财务数据;正文引用它们只为说明云需求的量级,不能把市场份额直接当成 AI 工作负载份额。4
这条信号比「Amazon 又多投了 200 亿美元」更值得看。Amazon 同时说 AI 需求会带动核心云服务增长,也承认短期容量仍不够,意味着云厂商的资本回报模型仍然依赖两个变量:设备能否按时放进数据中心,客户能否把实验负载变成可持续生产负载。钱已经写进 CapEx 预期,不等于 GPU、内存、电力、网络和可计费工作负载已经同步到位。
这对 AI 从业者意味着什么: AI 项目的预算表要从「每百万 token 多少钱」扩展到五个交付变量:目标区域是否有容量、模型和加速器是否可用、预留或按量资源能否覆盖峰值、内存和网络是否形成新的瓶颈、以及工作负载多久能达到稳定利用率。对创业公司,云容量不足会直接改变上线计划和现金流;对大客户,区域和供应商冗余比单次价格折扣更可能决定项目能否按期交付。
接下来观察: Amazon 的 2200 亿美元有多少在 2026 年内转化为已上线容量,AWS 的 AI 相关收入是否继续快于基础云服务,内存成本是否改变服务器交付节奏,以及客户预留是否能把云 CapEx 转成稳定利用率。CIO Dive 的报道没有提供合同级或机房级产能明细,因此当前能确认的是资本投入与需求压力同时上升,不能据此断言所有 AWS 区域都会持续缺货。
风口判断:从模型能力转向四段系统账
四条信号的连接点很具体:
- OpenAI 把实时音频、深度推理和工具调用拆成不同路径,说明用户体验的瓶颈已经进入系统编排层。
- AWS 把 full fine-tuning 变成托管能力,说明模型定制的差异会更多落在数据质量、评测和上线流程,而不是谁能手动搭训练集群。
- AWS WAF 把 AI/ML 防护做成持续更新的规则订阅,说明安全正在进入应用运行期,且规则覆盖会成为采购维度。
- Amazon 提高 CapEx 却仍预计容量不够,说明基础设施扩张的短期瓶颈仍是交付与利用率,不是公告上的投资数字。
因此,未来 1-2 个季度更值得跟踪的机会,不是一个更大的「AI 平台」概念,而是能把四段账对上的产品:实时 Agent 的低延迟运行时、可回滚的模型定制流水线、能接入权限和审计的 AI 安全层,以及把算力预留、区域交付和实际利用率放在一张表里的基础设施软件。
对工程师,先把实时路径、异步路径和状态迁移分别设指标;对产品经理,先把模型版本、权限边界和异常降级写进验收;对投资人,先追问 CapEx 是否变成可计费容量、规则订阅是否形成续费、微调是否带来更高的云用量。今天最值得下注的,不是又一个能演示的模型,而是能在延迟、权限、成本和容量四个外部约束下稳定运行的系统。
References
- 1
- 2
- 3
- 4

This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.