Google 116 页报告:智能体隐私与安全拆成 51 个开放问题,判据是「情境完整性」
解读 Google Research 2026 年 10 月 5 日的工作坊报告:116 页、51 个开放问题,把智能体的隐私与安全收束到「情境完整性」这一个判据上,并提出在动作落地前先过一遍的情境策略引擎;本文拆开它的机制、报告自己标出的三处证据缺口,以及同一批作者对这套判据给出的边界证明。

10 月 5 日,Google Research 发出一份 116 页的工作坊报告《Open and Emergent Problems in Agentic Privacy and Security: A Contextual Angle》1。材料来自 2025 年 11 月在纽约办的 CAPS 工作坊(Contextual Agent Privacy and Security),署名作者六十余人,机构横跨 Google、Cornell Tech、NYU、CMU、UC Berkeley、牛津、爱丁堡、UCL 等2,正文 76 页,第 14 节把讨论整理成 51 条开放问题,编号从 OP 5.1 排到 OP 12.43。
它提出的东西可以收成一句:智能体的隐私与安全共用同一个判据——在具体情境里,这条信息流或这个动作是否适当。
判据从保密与最小权限,换成「是否适当」
隐私工程的传统判据是保密与用户授权,安全工程的传统判据是最小权限、数据最小化、隔舱化。报告采纳的是 Helen Nissenbaum 的情境完整性理论(Contextual Integrity,CI):隐私是「信息流动是否适当」,适当性由情境规范裁定4。一条情境规范由五个参数说清:发送者、接收者、信息主体、信息类型、以及约束这次流动的传输原则(transmission principle),取值如保密、互惠、经同意、依法律要求3。报告举的例子是购物清单:你愿意把它交给购物助手,未必愿意给亲友看。同一个「分享」动作,在两种情境下判得相反,这正是 CI 想抓住的东西1。
报告把 CI 从信息流动扩到非共享类动作,称「情境安全」(contextual security):把账号隐私设置从私密改成公开,这类动作是否适当,同样由情境规范裁定13。这个选择有代价——判据一旦取自社会规范,系统就必须回答「谁规定适当」,而按传统安全原则搭建的智能体安全框架不必回答这个问题3。
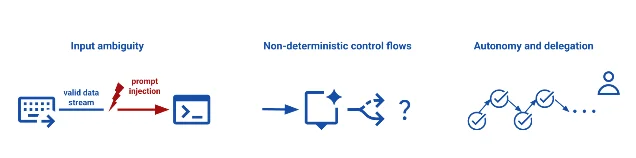
- 非结构化接口与输入歧义:指令以自然语言、图像这类形式进入,系统的控制流由这些形式定义,「预期行为」难以事先写清,提示注入这类对抗操纵也就难以封死;
- 概率化、动态的控制流:计划由生成式模型现场产生,执行路径随模型表现的起伏而变,传统测试方法覆盖不了这种临时生成的控制流;
- 自主与委派:任务变长、子任务转包给别的智能体之后,逐个动作弹窗确认会迅速变成确认疲劳,用户反而不再逐条看。
报告把「可信的智能体系统」定义成三条性质同时成立:效用(可靠准确地完成任务)、隐私(信息共享类动作适当)、安全(非共享类动作不造成伤害),并且要在有攻击和无攻击两种条件下都成立3。后面所有的分歧都挂在这句话上。
落地骨架:先于动作执行的策略引擎
CI 落到系统里,报告要求智能体走完五步:识别动作造成的信息流与状态变更、定位相关情境规范、用规范判定适当性、消解判定里的不确定性、按判定调整行为3。
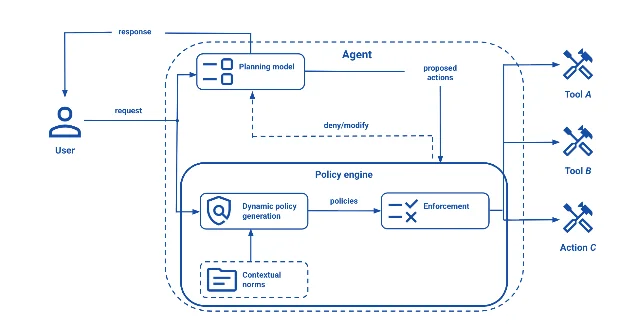
机制上,报告主张在监督层里放一个情境策略引擎:动作在离开用户工作区之前先送进引擎,引擎内含一个动态策略生成环,按用户请求和运行期才出现的新工具现场生成策略,再由执行环节放行、拒绝或退回修改13。报告认为 CI 理论提出以来,技术条件第一次到位——大模型能把高层的情境规范翻译成低层系统权限,填上两者之间长期存在的语义缺口,而手工权限与专家撰写策略在长时程、工具随时新增的场景里无法扩展13。
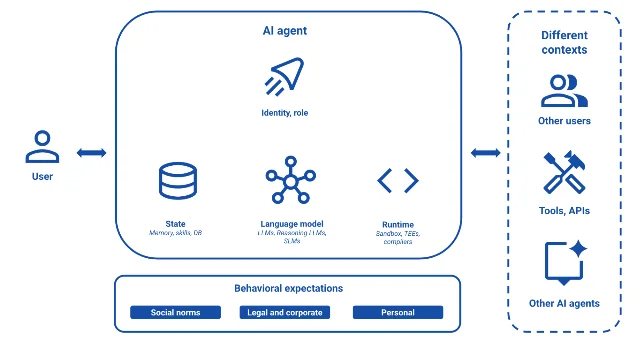
博客把整套主张摊成五层:系统级沙箱、模型级推理、用户中心控制、多智能体交互、生态治理1。报告正文按另一种切法展开——系统、模型、用户是三个组件层,评测、多智能体与治理归入部署与生态3。两种切法描述同一条链上动作从判定到落地的不同位置,值得一并记住的是这条链的顺序:判定在前,执行在后。
支点没验:模型懂不懂「适当」
整套方案压在「模型能理解情境规范」这一个支点上。报告在 6.3 节用三类工作交代证据:评测类工作看模型能否判断信息流动是否适当,隐私感知智能体类工作看情境推理能否指导信息披露,训练类工作尝试用微调或强化学习把规范内化3。三类工作指向同一个观察——大模型带有一定的情境规范知识,能认出情境里的角色、推断合适的接收者、给出常与人一致的评价。紧接着的一句是「对 CI 理论完整意义上的能力仍不清楚」3。
报告随后自审了自己这一侧的家底。附录 D 表 2 逐项比较 16 个既有的情境完整性基准,得到三处共性局限3:
- 传输原则与歧义被大幅简化——除 Camber 之外,多数基准为保证标签确定,刻意把模糊边界过滤掉;
- 依赖合成人设与标注——数据集用前沿模型批量生成用户画像,或让众包标注者对虚构情景打分;
- 把 CI 参数当作静态的单会话快照——即使 PrivacyLens-Live、AgentDAM、PrivacyBench 这类多轮智能体基准,也把轨迹限制在单个任务或最多十轮对话,捕捉不到持久的系统上下文、累积的泄漏与随时间移动的规范。
用户那一侧的缺口更大。报告判断对智能体而言「通知与选择」框架已经不够用:自主智能体的行为概率化、高频、生成式,用户无法事先预见每一项后果3。替代方向是动态、情境化、贴合个人心智模型的控制机制,而报告紧接着承认,针对真实任务的大规模用户研究目前还没有,既有研究只到虚构场景、隐私倾向采集和常识评测3。
这三处缺口都写在报告自己的正文里,因此它们的性质是可执行的待办清单,而不是被忽略的漏洞。落到读者手里,它决定的是这份材料的身份:研究议程。
同一主笔的边界证明
报告的首席作者 Eugene Bagdasarian 与共同作者 Sahar Abdelnabi 在 2026 年 5 月 17 日提交过一篇论文《AI Agents May Always Fall for Prompt Injections》,用的正是同一套情境完整性视角5。
那篇论文先指出,主流的「数据—指令分离」防御既漏掉经由情境操纵的攻击,又损害了情境适当的行为;随后把提示注入重述成 CI 问题,并给出一个不可能性结果:攻击者总能构造出一个情境,使一条本该被拦下的流动看起来合法;而防守方若收紧规范,又会挡住真正合法的流动。论文自己的总结是,当前研究处理的只是未来攻击面中正在收缩的一部分5。
报告的 OP 6.5「防止有害情境污染策略生成」,承认的正是这件事——策略生成这一步本身就暴露在不可信的上下文里3。两处材料对同一件事给出了两个强度的判断:论文把它推到一个边界,报告把它列成待研究的问题。取更弱的那个——存在边界,是否不可解尚无定论。
51 个开放问题分布在哪
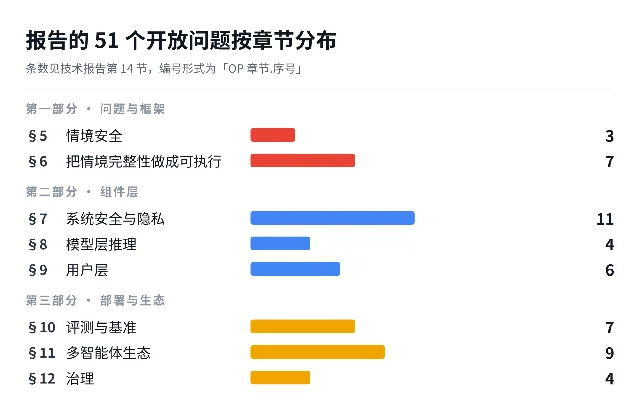
按技术报告第 14 节与各章正文整理自制。§5、§6 属第一部分(问题与框架),§7 至 §9 是三个组件层,§10 至 §12 属部署与生态;右侧数字为该节列出的开放问题数。
分布里有一处值得一提的倾斜。条数最多的是系统安全与隐私(§7,11 条)和多智能体生态(§11,9 条),而这两层要处理的身份、授权、委派链上的约束传播、智能体之间的合谋与规范漂移,都依赖模型层对「适当」的判断质量;模型层自己只列了 4 条3。地图的重心与支点的强度并不匹配。
几条能看出分量的条目:
- OP 7.5 要造出把智能体动作绑定到用户原始意图的可验证凭证,例如「50 美元以内买好菜」,好让幻觉或提示注入造成的误操作能归因到用户、开发者或模型3;
- OP 7.8 把隐私目标从「删除数据」改成「功能可撤销」——数据可能已被模型记住或聚合进别处,删除命令未必真能收回它的影响力3;
- OP 10.7 要评测面对演进环境的智能体:公司改了数据共享政策,或政府换了政治倾向,智能体该主动回头修改过去替用户做过的数据共享决定3;
- OP 11.2 要防止反复互动的智能体之间形成合谋,或让规范慢慢漂移,而这类漂移可能在任何单次交互里都看不出来3;
- OP 12.4 要设计出既激励、又能验证「遵从规范」的机制3。
最具体的一节在治理
报告里最接近可执行建议的部分是治理那一节。它把问题先定义成责任怎么分配,给出的原则是按能力、视角、风险暴露来定:谁有能力管住风险,义务就压给谁3。两个历史类比都指向「定性能、不定技术」:1974 年《公平信用计费法》把消费者承担的信用卡欺诈责任封顶在 50 美元,把剩余成本转给发卡机构,换来的是发卡机构自掏腰包投资欺诈侦测,而立法没有规定用什么技术;1990 年《美国残疾人法案》给建筑定的是性能底线,例如能承受给定荷载、公共空间可进入,没有指定材料与布局3。
这条逻辑把「规范从哪来、由谁维护、冲突怎么裁决」推向治理流程,而报告明确把「规范怎么被采集、怎么正式更新」列为开放问题 OP 12.2,没有给答案3。
有一处官方口径需要如实标出。博客写的是「more than 50 academic and industry leaders」参与撰写或参加了研讨,报告执行摘要写的是「more than 30 academic and industry leaders at the CAPS Workshop」13。两个数字可以并存:到会的三十余人,署名或参与讨论的五十余人。要引用参与人数,得说清指的是哪一个。
要读原文,先翻哪几页
116 页里值得直接翻的并不多,按目的分四条路径:
- 只要判断框架:第 6 节讲怎么把情境完整性做成可执行,第 14 节的清单给全貌,两处合计约 12 页3;
- 做系统或做智能体产品:第 7 节(认证、授权、记账、隐私四根柱子)与第 11 节(多智能体与委派链)细节最密;
- 做评测:第 10 节与附录 D 表 2 是现成的基准盘点,表 2 把 16 个基准按属性列成对照矩阵;
- 做政策与合规:第 12 节,以及附录 A 的术语表——它把 context、norm、transmission principle 这些词逐条定义,跨学科协作时最省事的就是这张表3。
这份报告的作用,是把 51 条问题第一次放进同一个判据下排了一遍;它给出的正是这些问题之间该怎么分层的骨架。
References
- 1
- 2
- 3技术报告 PDF,116 页
storage.googleapis.com
- 4情境完整性理论的原始论文(Helen Nissenbaum)
nissenbaum.tech.cornell.edu
- 5
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.