唐杰重写Scaling:GLM-5.3显示后训练还有余量
唐杰将 Scaling Law 从参数竞赛改写为资源配置问题;GLM-5.3 的同基座对照显示后训练仍有明显余量,但离一条可外推的新规律还差多点曲线与独立复测。

作者丨 AI 科技评论
每次模型发布,参数量总是最先被追问。
这个数字简单、醒目,也最容易被做成一场谁更大的比赛。
2026 年 8 月 19 日,唐杰发布长文《Thoughts About Scaling Law》,开头就把这个问题拆掉了:参数只有和数据量、算力投向、部署条件放在一起,才有意义。1
这篇长文把衡量 Scaling 的尺子,从参数量换成了一组相互牵制的资源指标。
唐杰列出决定 Scaling 的多只旋钮:预训练数据、总参数、每次前向计算激活的参数、有效深度、后训练环境,以及推理时愿意花掉的计算。
GLM-5.3 是他拿出的最新证据。
5.3 与 5.2 的前后对照显示,后训练还能提高长程任务表现;这组结果没有给出总参数在什么规模后收益会普遍转弱。1
Scaling, but not only of parameters.——唐杰1
Loading content card…
01|20:1 也会过期
唐杰先把时间拉回 2020 年。
Kaplan 等人当时发现,算力增加 10 倍时,计算最优的参数规模大约增加 5 倍,训练数据只增加 2 倍。2
唐杰把参数增速与数据增速的比例概括为约 2.7:1。1
两年后,DeepMind 用 400 多个模型重做实验。3
Chinchilla 论文给出的修正很直接:参数翻倍,训练 token 也应翻倍。70B 参数的 Chinchilla 训练了 1.4 万亿 token,由此得到常被转述的约 20 token/参数。3
| 阶段 | 优化的对象 | 当时得到的最优方向 |
|---|---|---|
| Kaplan | 固定训练算力下的损失 | 参数增长快于数据;10 倍算力对应约 5 倍参数、2 倍数据。2 |
| Chinchilla | 训练一次的计算最优 | 参数与训练 token 同速增长;70B 参数配 1.4 万亿 token。3 |
| 大规模部署 | 训练加长期推理的总成本 | 高频调用把最优解推向更小、训练更久的模型。1 |
唐杰的关键补充落在第三行。
Chinchilla 的目标函数是训练计算。
模型被高频调用后,训练阶段多花算力、用更多 token 训练较小的模型,可以减少此后每次推理要调动的参数规模。1
训练成本增加,长期推理成本可能降低。1
Llama 2 的 7B 模型用了 2 万亿训练 token,约合每参数 286 个 token。4
Gemma 2 的 9B 模型用了 8 万亿 token,约合每参数 889 个 token;Gemma 团队还明确写道,2B 与 9B 模型使用的训练量超过 Chinchilla 理论预测的 50 倍。5
每条 Scaling Law 背后都藏着一个目标函数。目标从训练成本换成全生命周期成本,最优点就会移动。
20:1 只是一张针对特定模型结构、硬件价格和优化目标画出的地图。
02|MoE 拆开了「大」
稀疏 MoE 模型让「多少参数」变得更难回答。
一个 MoE 模型可以拥有很大的总参数量,但每个 token 只调用其中一部分专家。
总参数像仓库能放多少货,激活参数像一张订单同时能调动多少工人。
仓库变大,不会自动让同一张订单处理得更快、更深。
唐杰给出了一种粗略分工:总参数更多关系到知识、事实和长尾容量;激活参数与有效深度更多关系到模型能把一条因果链走多远。1
他用「roughly」说明这只是一种工程近似。
2025 年,Roberts 等人比较知识问答与代码生成后发现,计算最优的缩放方式会随技能变化;如果研究者拿不匹配的验证任务来估算,得到的计算最优参数量会和目标任务的最优值相差近 50%。6
另一项 MoE 研究进一步发现,在固定 token/参数比时,继续增加总参数会让推理表现变差;增加每次激活的专家数量,则在各组实验中都提高了推理表现。7
AI 科技评论注意到,这两项研究都在把同一个问题说得更具体:模型要记住更多东西,和模型要把更长的推理链走完,需要的预算并不相同。
| 旋钮 | 它直接改变什么 | 光看它还回答不了什么 |
|---|---|---|
| 总参数 | 模型可容纳的参数容量 | 每个 token 实际用了多少计算 |
| 激活参数与有效深度 | 一次前向过程调用多少专家、经过多少有效计算 | 训练数据是否足够,任务是否匹配 |
| 预训练数据与算力 | 基座获得的通用模式与知识 | 长程任务是否经过专门练习 |
| 后训练环境与 RL 算力 | 模型在可执行、可验证任务上的行为 | 增益能否跨任务复现 |
| 推理时预算 | 单次任务能走多少步、生成多少 token | 全生命周期成本是否更低 |
唐杰把漏洞发现当作分界案例。
他认为,记住更多已知漏洞(CVE)属于容量问题。
模型能不能沿着二十步推理链找到完整利用路径,考验的是每一步能否保持状态、调用工具并继续往前走。1
在他的论证里,GLM-5.3 要检验的正是长链任务能否从后训练获得额外增益。
03|只拧后训练
唐杰把 GLM-5.3 称作一次「控制实验」。
他写道,5.3 与 5.2 使用同一基座、同一架构、相同的总参数与激活参数,变化集中在一个月的长程环境和强化学习。1
官方发布帖把这个基座标为 743B 参数。9
在 Z.ai 的评测中,GLM-5.2 到 GLM-5.3 的 Terminal-Bench 3.0 得分从 4.6 升到 28.3,DeepSWE v1.1 从 46.2 升到 66.9,ExploitBench 从 24.4 升到 54.4。8
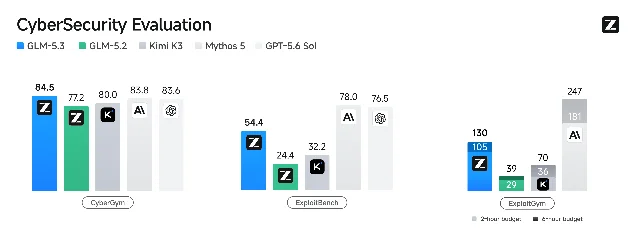
5.2 与 5.3 共用基座,差异集中在后训练阶段;这组前后对照表明,Z.ai 在环境、任务和 RL 算力上的组合投入带来了明显的长程任务增益。
这组证据还缺少拟合 Scaling Law 所需的多个投入—产出点。
Z.ai 同时增加了环境数量、任务多样性和训练算力。
这些变量都装在「后训练」这个大盒子里,公开材料没有逐项消融,也没有给出投入继续增加时的完整收益曲线。8
GLM-5.3 把「后训练可继续提高长程任务表现」变成了一项可复测的主张;它没有给出总参数达到何种规模后收益转弱的曲线。
04|能不能成为一条律
同行的即时回应,分歧也落在这里。
阶跃星辰研究员 Xiuyu Li 把 GLM-5.3 放进一条更长的路线:从监督微调到强化学习,再到推理时 Scaling,新一代模型正在不同阶段继续增加计算。10
这支持唐杰的「多旋钮」判断。
独立 AI 分析者 Yanhua 则保留了三点:总参数的阈值没有可测定义;「总参数管知识、激活算力管推理」更像工程近似;两个模型版本不足以拟合一条可外推的新 Scaling Law。11
两个模型版本只能证明后训练有余量,还不足以拟合一条可外推的新 Scaling Law。——Yanhua11
AI 科技评论注意到,两边都接受训练阶段可以继续增加计算,分歧在于这组收益是否已经表现为一条可预测、可外推的规律。
唐杰给出了方向:每次寻找余量最大的旋钮。
一条真正的 Scaling Law 还需要更多点:投入翻倍时收益怎样变化,边际回报何时变平,换任务和换部署条件后曲线是否还成立。
05|还要看五份记录
参数量从此仍有用,只是不能单独充当模型能力和成本的替身。
实验室如果要证明「多旋钮 Scaling」成立,发布材料至少要把五类记录补齐。
- 权重与参数口径。 GLM-5.3 权重公开后,独立团队才能核对 5.3 和 5.2 的总参数、每 token 激活参数是否分别相同。8
- 同预算复测。 5.2 与 5.3 需要在同一 harness、同一时间、同一 token 预算下接受第三方测试。复测若能重现各项分数和版本差值,发布方报告的增益才有可复现性。
- 后训练规模曲线。 环境数量、任务难度、RL 算力和收益要有多个中间点,外界才能判断后训练是否接近自己的「Chinchilla 时刻」。
- 跨任务迁移。 Coding 与 Cyber 上的增益要扩展到不同长程任务,才能排除模型只学会了更窄的环境分布。
- 推理账单。 质量提升对应的输出 token、延迟和实际成本必须一起公开,才能验证全生命周期最优,而不是只把榜单分数推高。
AI 科技评论接下来会追踪唐杰留下的下一步。
Well, scaling has more than one dial. We turned the post-training one this time because it had the most slack left in it — not because the others are finished.——唐杰1
下一代 GLM 如果扩大 mid-training 或 pre-training 投入,比较重点应该是每个阶段新增了多少计算、换来多少跨任务收益,以及推理账单怎样变化。
继续判断模型 Scaling,参数量只能是多份记录中的一份。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9Z.ai 发布 GLM-5.3
x.com
- 10
- 11
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.