谷歌TPU跑Kimi比英伟达GPU快57%!用的还是DeepSeek推理框架
量子位报道 vLLM 原班人马创办的 Inferact 为谷歌 TPU 手写 megakernel,用 16 块 TPU v7 把 Kimi K3 跑到每秒 709 token、比同配置 GB200 快 57%,并给出官方博客与开源仓库的复现入口。

转载说明:本文转载自微信公众号「量子位」2026 年 9 月 26 日 11:20 发布的文章,作者克雷西(发自 凹非寺 量子位 | 公众号 QbitAI)。原文链接。量子位官网同题文章:谷歌 TPU 跑 Kimi 比英伟达 GPU 快 57%!用的还是 DeepSeek 推理框架。原标题、作者署名与报道内容均保留原文;正文图片取自原文并附简短图注,原文之外的核对入口以引用形式标出。
16 块谷歌 TPU v7 跑 Kimi K3,每秒跑出了 709 个 Token,比英伟达(老黄)的 GB200 快了 57%。
Kimi K3 是月之暗面的模型,TPU v7 是谷歌的芯片,把两者凑在一起跑出这个成绩的,是一家叫 Inferact 的推理创业公司。它的创始团队就是 vLLM 的原班人马,2026 年 1 月宣布创业时拿了 1.5 亿美元种子轮。1
他们给 TPU 写了一种叫 megakernel 的推理内核,把模型推理时原本要调度的几百个小程序焊成一个大程序。配合 TPU 独特的片上内存架构,megakernel 把内存带宽利用率逼到了硬件理论峰值附近;再配上 DeepSeek 提出的 DSpark 加速框架,就有了前面每秒 709 token 的成绩。这套代码现在已经开源。2
同样 16 块芯片,TPU 快 57%
Inferact 把 TPU 和英伟达 GPU 放在完全相同的条件下跑了一轮 benchmark。
测试用 16 块 TPU v7 Ironwood 对阵 16 块英伟达 GB200,两边都跑 Kimi K3,都用 vLLM 推理引擎,唯一的变量是芯片和底层的 kernel 实现。2
最终,TPU 跑出的成绩是每秒 709 个 token,GB200 跑出每秒 452 个,TPU 快了 57%。
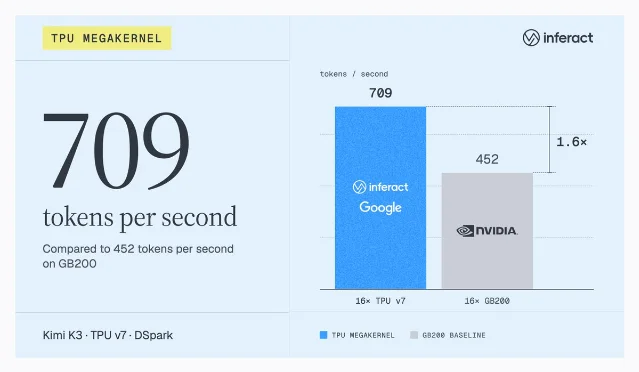
原文引用的结果信息图:同一轮测试里 16 张 TPU v7 对应 16 张 GB200,蓝色为 TPU megakernel、灰色为 GB200 基线,右侧标出 1.6 倍差距,页脚写明测试模型是 Kimi K3、加速框架是 DSpark。
这个速度里有 DSpark 推测解码的功劳。DSpark 由 DeepSeek 提出,原理是让一个小模型先快速猜出一串候选 token,大模型再对这串候选做批量验证,猜对的直接跳过,猜错的回退重来;论文称它在 DeepSeek-V4 的真实流量下把每用户生成速度提升了 60% 到 85%,作者名单里梁文锋排在末位。3 Inferact 在 TPU 上跑通了这套流程,acceptance length 达到 6,也就是每轮猜出的 token 平均有 6 个能直接通过大模型的验证,单步 decode 耗时约 8.5 毫秒。2
关掉推测解码看裸速,差距同样拉得开。batch size 为 1 时,TPU 每秒能跑 249 个 token,GB200 只有 127 个,接近一倍;batch size 放大到 8,TPU 达到每秒 865 个 token,GB200 是 636 个。2
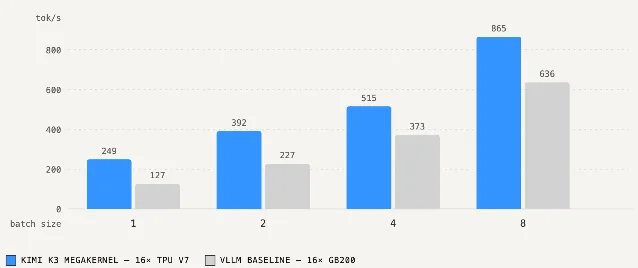
原文引用的裸速对比图:batch size 1、2、4、8 四组,TPU megakernel 依次是 249、392、515、865,GB200 基线依次是 127、227、373、636,单位 tokens/s。
在 Qwen 上,两种芯片的差距更大。Inferact 用 4 块 TPU v7 跑 Qwen 3.8 27B,每秒跑出 1515 个 token,同样配置的 GB200 是 695 个。4
提速的同时保住了精度。用 greedy decoding 验证,Kimi K3 在 TPU 上的 GPQA-Diamond 得分 94.4%,GSM8K 得分 97.2%,和 GPU 上的结果一致。2
推理引擎一样,模型一样,芯片换一下,速度就差出了 57%。这种程度的差距,按理说应该能从硬件规格表上找到解释,实际情况恰好相反:两款芯片的算力在同一个量级,TPU v7 的 HBM 带宽是每秒 7380 GB,而 GB200 的 HBM 带宽反而更高,达到每秒 8000 GB。5 带宽更大的那块芯片,跑出来的速度反而更低。
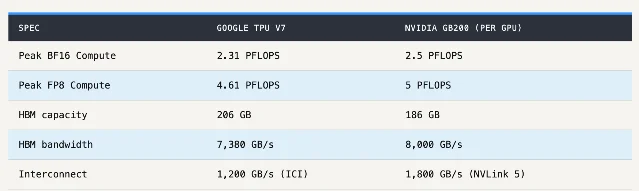
原文引用的规格对比表:Google TPU v7 与 NVIDIA GB200(单 GPU)在 BF16 算力、FP8 算力、HBM 容量、HBM 带宽、互联带宽五项上的并列数值,其中 HBM 带宽一栏 GB200 高于 TPU v7。
这种速度的差距,实际上来源于芯片上面跑的那层软件。
把几百个小 kernel,焊成一个大程序
大模型推理的速度瓶颈在数据搬运。每生成一个 token,模型的全部权重都要从 HBM 主存搬进芯片内部的高速缓存里算一遍;算完这一轮,下一个 token 再重新搬一遍。2
传统做法是把一次推理拆成几百个独立的 kernel,每个 kernel 负责一小块计算。这些 kernel 排着队一个接一个执行,带宽就在上一个干完、下一个还没启动的交接间隙里空转。CUDA Graphs 和英伟达最新的 PDL 技术能缩短这个间隙,但 kernel 之间的边界还在。2
Inferact 的 megakernel 直接消除了这个边界。Kimi K3 一共有 92 层 MoE 计算,他们把这 92 层的计算逻辑从头到尾塞进一个 Pallas 程序里,一次调用就走完整个模型的前向传播。2
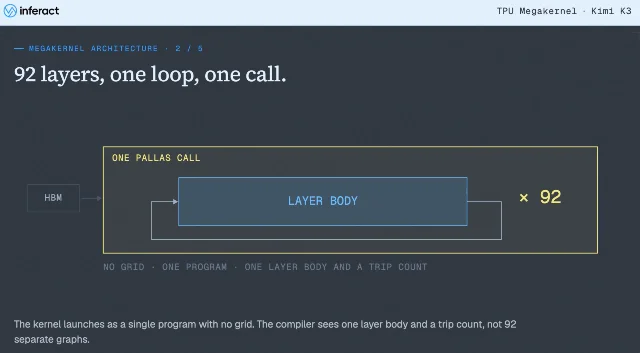
原文引用的架构幻灯片:一次 Pallas 调用里只有一个层体(layer body)和 92 次循环,注释写明 no grid、one program、one layer body and a trip count,也就是编译器看到的是一个程序加一个循环次数。
边界消失之后,跨层权重预取就变得顺理成章。第 N 层还在算 MoE 的时候,第 N+1 层的 attention 权重已经开始从 HBM 往片上缓存搬,计算和数据搬运同时进行,内存带宽几乎没有空转的时刻。2
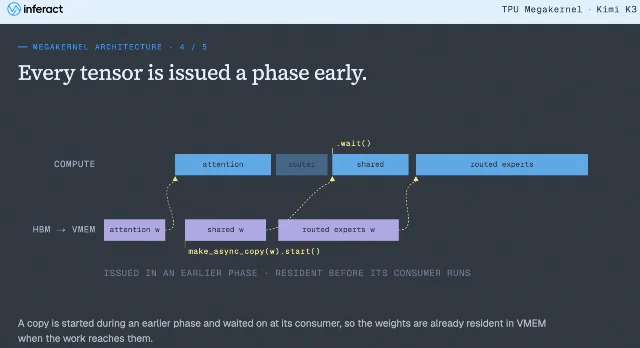
原文引用的时序图:上面一行是 attention、router、shared、routed experts 四个计算阶段,下面一行是 HBM→VMEM 的权重搬运,权重的异步拷贝在更早的阶段发起,等使用它的计算到达时已经常驻片上缓存。
TPU 的硬件特性让这种编排做起来格外顺畅。TPU v7 的每个 TensorCore 带有 64 MiB 的 VMEM 片上内存,这块内存的生命周期完全交给软件来管理,工程师可以精确控制什么时候往里面装什么数据、什么时候把空间腾出来;64 MiB 的容量足够同时装下当前层的计算数据和下一层预取的权重。英伟达 Blackwell 架构的片上内存分散在 152 个 SM 里面,总量大约 38 MiB,由硬件自动调度,要做类似的跨层编排限制更多。2
整个 megakernel 是 Inferact 用 Pallas 手写的。Pallas 是谷歌给 TPU 做的底层编程语言,角色类似英伟达 GPU 上的 CUDA;TPU 默认的编译工具链 XLA 擅长优化单层计算,跨 92 层协调数据搬运的决策分支太多,自动调度找不到最优解,Inferact 于是绕过 XLA,由工程师自己决定每一步搬什么数据、存在哪块缓存、什么时候释放。这样还带来一个额外好处:编译耗时从 XLA 的 30 分钟以上降到了不到 90 秒,工程师改完一版 kernel 一分半钟就能上机验证。2
这份 kernel 把模型摊在 16 块 TPU v7 芯片上,合计 32 个 TensorCore:attention head 切给全部 32 个 rank,路由专家按 TP4 × EP8 切分。2
目前这套 megakernel 是针对 Kimi K3 的模型结构做的定制优化,换一个模型架构还需要重新适配。Inferact 在博客里提到,团队接下来会把 megakernel 的支持扩展到更多模型架构上。2
vLLM 原班人马的创业公司
Inferact 在 2026 年 1 月宣布创业,团队几乎就是 vLLM 的原始开发者——一群靠给英伟达 GPU 写推理引擎成名的人,转头把 TPU 的推理速度做到了 GPU 前面。公司这一轮完成 1.5 亿美元种子轮融资,估值 8 亿美元,由 a16z 和 Lightspeed 联合领投。1
vLLM 目前支持 500 多种模型架构、200 多种加速器类型,由 2000 多名贡献者共同维护,是开源推理引擎领域的重量级框架。6 CEO Simon Mo 是 vLLM 项目的原始维护者,伯克利 EECS 毕业,之前在 Anyscale 工作;联合创始人 Woosuk Kwon 是整个 vLLM 项目的发起人,伯克利计算机科学博士,导师是 Ion Stoica,他提出的 PagedAttention 算法解决了 GPU 显存管理中的碎片化问题,至今仍是 vLLM 的核心技术。7 首席科学家游凯超曾获清华大学特等奖学金,在 vLLM 中主导了分布式推理功能的开发。6
这次的 TPU megakernel 来自 Inferact 与 Google Cloud 的一项联合工程合作。双方的目标是让 TPU 成为 vLLM 的一流支持对象,所有优化成果都会回馈给上游的开源社区,tpu-megakernels 代码仓库是这次合作的第一个公开成果。8
想自己核对的,官方工程博客《700 TPS on Kimi K3: A Case for TPU Megakernels》已经把测量设置、结果图和复现脚本写了出来,配套的 Inferact/tpu-megakernels 仓库同步公开,里面是 Kimi K3 与 Qwen 两份 megakernel 实现和一组 CPU 正确性测试。2 仓库说明里,K3 那一份要跑在四台主机、32 个 TPU 设备上;Qwen 那一份用一台主机上的 8 个 TPU 设备就能跑起来。4
References
- 1
- 2
- 3
- 4Inferact/tpu-megakernels
github.com
- 5TPU7x (Ironwood)
docs.cloud.google.com
- 6Inferact
inferact.ai
- 7vllm-project/vllm
github.com
- 8
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.