解码 27% 的时间在等 SSD、两片 FPGA 撑到 4.5 万上下文、9.3B 的生图模型要 17GB
八组材料的读数都由同一件事决定:权重放在哪儿、一次要搬多少。

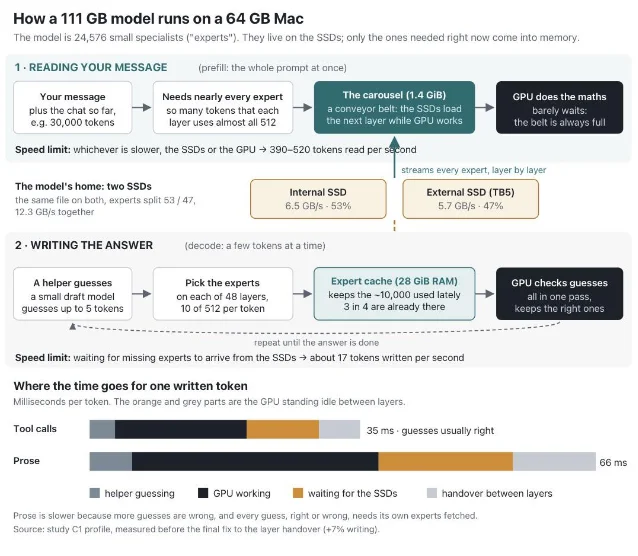
一台 64 GB 的 Mac mini 上跑着一个 111 GB 的模型。24,576 个小专家住在两块 SSD 里,当前要用的那批才进内存;预填阶段的读取上限是每秒 390 到 520 个 token,解码阶段一边猜一边取专家,实测约 17 token 每秒,其中大约 27% 的时间 GPU 在等盘 12。
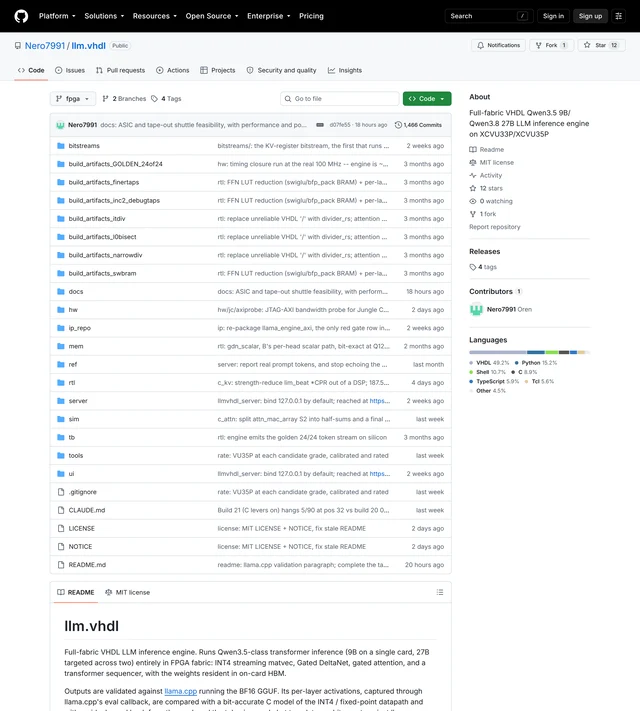
同一周,有人把 Qwen3.5 的推理引擎整个写进了 FPGA。已经跑起来的是 9B:两片老矿卡上的 FPGA,预填约 6 token 每秒,生成 3.2 token 每秒;27B 那一栏全是按 9B 的逐算子画像推出来的,一片不许跑,而且两片卡最多只撑到约 4.5 万上下文——因为 14.5 GB 的权重旁边放不下 27B 的 KV 缓存 3。
还有一个 9.3B 的生图模型,带两份必须同时在场的孪生权重加一个编码器,一共 17 GB,要在一张 8 GB 的卡上出图:靠流式加载,显存峰值压在 7.7 GB,1024 见方的二十步约 70 秒,2048 见方要 683 秒 4。
这三件事放在一起,本期八组材料量出来的其实是同一件事:一次要搬多少。权重放在哪儿、每个 token 要唤醒多少参数、KV 缓存要占多大、模型文件大小和运行占用差多少——今天这些读数几乎都能在这四个数上对上。
本期覆盖 2026 年 10 月 4 日至 10 月 5 日,来源为 Reddit、公众号与小红书,另含三处 GitHub 仓库、一处 Hugging Face 模型页与四条 X 帖子。八组材料按「任务与运行条件 → 具体数字 → 分歧或反例那一栏 → 作者自陈的限制 → 原帖」逐条给出。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 64 GB 的 Mac mini 跑 111 GB 的模型 | Qwen3.8-Flash-Next Q4,专家放 SSD 流式加载,MTP 开启 1 | 内盘 6.5 GB/s(53%)加外置 5.7 GB/s(47%),合计 12.3 GB/s;热缓存命中 75%;解码 17.5 token/s,其中 27% 在等盘 2 | 作者自测、自建方案;写答案时数据来自修层级交接前的一次画像 |
| 一张 GGUF 跨两张不同品牌的卡 | RX 6900 XT 16GB 加 RTX 3080 10GB,llama.cpp,Vulkan + CUDA,Qwen3.6-35B-A3B UD-Q4_K_M 5 | 按层切分,预留 8,192 token 上下文;验收只到加载与短答(MTP 开、关各一次) 5 | 持续吞吐与满上下文没测;两张卡的标称显存加起来不等于能用 |
| Qwen3.5 搬进 FPGA | 全 VHDL 实现,INT4 流式矩阵向量乘,权重常驻片上 HBM,用两张便宜矿卡上的 FPGA 3 | 9B 实测预填约 6、生成约 3.2 token/s,逐层对过 llama.cpp;27B 全为推算,四片 200 MHz 下约 25 token/s、262K 上下文约 1 3 | 27B 一次没跑过;两片卡到约 4.5 万上下文就停 |
| 29B 的模型装进一张 24GB 卡 | 中国电信 Xing4.0-29B-A4B,29B 总参 / 4B 激活,4-bit 量化 6 | 64 个路由专家选 4 加 1 个共享专家;4-bit 权重约 15 GB;全程昇腾 910C 集群加 MindSpore 训练 6 | 榜单全部为厂商自报,第三方未独立复测 |
| 同一台机器上把 27B 换成 35B-A3B | 两张 RTX 5070 Ti 16GB 加 64 GB 内存,Ollama,agent 跑在 WSL 里 7 | 两套自建测试都是满分,速度约 180 对 55–70 token/s;41 层里只有 10 层是全注意力,128K 加到 256K 只多约 2 GB 7 | 两套测试都已打满,只能证明不比原来差;厂商数字未核 |
| 8 GB 内存的家用 NAS 跑本地模型 | Intel i3-7100 加 8 GB DDR4 加机械硬盘,飞牛 fnOS,Ollama 容器,全部 Q4 8 | Qwen2.5 7B 文件 4.7 GB、运行占 6.5 GB、5–6 token/s;Llama 3.1 8B 文件 5 GB、运行占 7 GB、4–5 token/s 8 | 单人两周体验,评分是作者自己的十分制 |
| 9.3B 的生图模型塞进 8 GB 卡 | Ideogram 4 开源权重加编码器共 17 GB,流式加载 4 | 显存峰值 7.7 GB;1024² 二十步约 70 秒,2048² 683 秒;提示词写成固定结构 JSON 才出图 4 | 单卡单次;许可不可商用;中文排版仍不如 Qwen-Image 2.1 |
| 395M 的编码器替掉一次大模型调用 | DecisionTune 1.0,ModernBERT-large 加一个 4 KB 打分头,一次编码器前向 9 | M5 Pro 上中位 9.6 毫秒、占 1.7 GB 显存;CPU 上约 65 毫秒、最多 4.5 GB;权重 fp32 1.58 GB 9 | 概率未校准;只认英文;只会在给定选项里选 |
一台 64 GB 的 Mac mini:111 GB 的模型住在两块 SSD 上
这个项目的做法是:把模型的专家全部留在 SSD 上,内存里只放最近用过的那批,再让一个小模型提前猜下一步要用哪些专家。作者给出的结构是 24,576 个专家、48 层、每个 token 从 512 个里取 10 个,两块 SSD(内部 6.5 GB/s 占 53%、外置雷电 5 的 5.7 GB/s 占 47%)合起来 12.3 GB/s 2。
两侧的速度上限由不同的东西决定。预填阶段,模型一次要看完整段提示,几乎每个专家都可能被用到,于是瓶颈是盘:那条 1.4 GiB 的传送带一边加载下一层、GPU 一边算,官方口径的读速是每秒 390 到 520 个 token 2。作者说自己给预填做了轮转缓冲之后,这一侧快了约 30%,再挂第二块外置 SSD 做并行读取,预填与解码各再快约 15% 1。
解码阶段是另一回事:一次只写几个 token,热缓存里存着最近用过的约一万个专家,四分之三的取用能直接命中,miss 的那部分才回盘上拿;作者在后续帖子里说,写一个 token 的时间里 GPU 仍有 27% 是在等专家从 SSD 过来,工具调用那一步平均 35 毫秒,写散文 66 毫秒,橙色那两段就是等待 2。他列的下一步方向是扩大预取范围、给猜取的专家单独开一块暂存,免得把它们塞进热缓存时挤掉真正热的那些;代码放在自己的仓库里,MIT 之外的说明不多 10。
他自己交代的口径有三条:所有数字是在他自己的用法上量的;那张时间线图取自修层级交接之前的画像;他也承认这条路线里还有大量 GPU 空转的时间没有用掉,Metal 侧的内核也还没优化 1。
Loading content card…
一张 GGUF 摊在 AMD 与 NVIDIA 两张卡上
Infermeld 是一个把 llama.cpp 包了一圈的 Linux 工具,做的是「手上正好有一张 AMD 卡和一张 N 卡,能不能不买配对的两张」。作者测过的组合是 RX 6900 XT 16GB 配 RTX 3080 10GB,AMD 侧走 Vulkan、NVIDIA 侧走 CUDA,模型选 Qwen3.6-35B-A3B 的 UD-Q4_K_M GGUF,按层切分,预留 8,192 token 的上下文 5。
验收项目只有两项:能不能加载,以及 MTP 开、关各答一句是否正常。作者把边界写得很清楚:持续吞吐没测、满长度的 8K 提示没测,短答成功不等于性能达标;他也明确写了两件事——不承诺两张卡合起来比一张快,标称显存相加也不代表都能用 5。
这一组值得留意的不是数字,而是它公开的方式:仓库里带一张结果页,历史测量都标注了当时的配置,免得被当作当前 Q4 组合的成绩;作者还专门说要收集失败案例 11。
Loading content card…
Qwen3.5 搬进 FPGA:实测的是 9B,27B 全是推算
这个项目的目标是把整套推理放进 FPGA 的硬件逻辑里:INT4 的流式矩阵向量乘、Gated DeltaNet、门控注意力,权重常驻在板载 HBM 上,9B 跑在一片卡里,27B 计划跨两片 12。
真正跑起来过的只有 9B:两片 FK33 在 75 MHz 下,预填 256 token 的提示约 6 token 每秒、2.3K 的提示约 5.5,生成开头约 3.2、到 2–3K 上下文掉到约 2.4;输出是逐层对着 llama.cpp 校验过的 3。作者把「27B 怎么算出来的」也写明白了:全部是从 9B 的逐算子画像推的,一次没跑过——一片两 die 的板在 75 MHz 下约 2 的预填与 1.1 的生成,把同一份 RTL 放大到更大的 die 上约 6 与 3,再拉到 200 MHz 约 16 与 8,四片四路张量并行在 200 MHz 下约 25 与 25 3。
卡住的地方也是算出来的:两片 die 只到约 4.5 万上下文,因为 14.5 GB 的权重旁边放不下 27B 的 KV 缓存,要跑满 262K 得上四片 3。帖子里另有一段把这套 RTL 做成 ASIC 的估算,是在 TSMC 2023 年的 N3 上、配六摞当年 HBM3 与 2 GHz 主频,短上下文约 294 token 每秒、16K 约 106、262K 约 10,功耗 125 到 340 瓦;这一段作者注明了是让模型估的,不是他测的 3。
29B 装进一张卡:靠的是 86% 的参数待命
中国电信人工智能公司在 9 月下旬开源了 Xing4.0-29B-A4B:290 亿总参数、每个 token 只激活 40 亿,64 个路由专家里选 4 个再加 1 个常驻的共享专家,Apache 2.0、可商用 6。这套稀疏度直接决定了它能装在哪:同样 290 亿参数如果按 BF16 稠密算要占约 58 GB,量化到 4-bit 之后权重约 15 GB,加 KV 与系统开销,一张 24 GB 的消费级卡就能把它常驻着当 agent 用 6。
这张卡上真正被搬动的只有四分之一不到:架构里用了 MLA 压缩 KV 缓存、MTP 多 token 预测给推测解码留抓手,原生 256K 上下文可扩到 512K,40 层、隐藏维度 3584,官方同时放了 FP8 与 GGUF(含 4-bit)两种权重 6。它区分于同级模型的那条是训练底座:官方称这是首个在这一体量上完全跑在昇腾 910C 集群、基于 MindSpore 与 MindFormers 训完的开源模型,训练吞吐比开箱基线提升约 96%——这两句都是厂商口径 6。
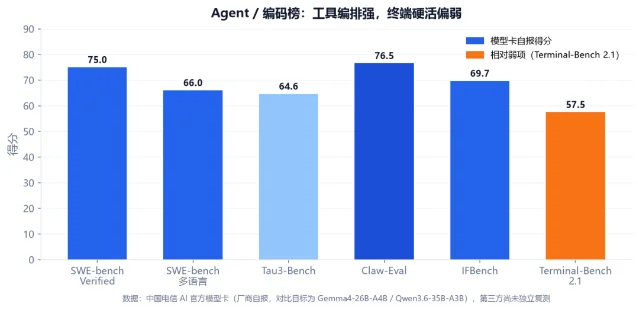
模型卡里的榜单对比对象是 Gemma4-26B-A4B 与 Qwen3.6-35B-A3B:Claw-Eval 工具调用 76.55、SWE-bench Verified 75.0、IFBench 69.67、SWE-bench 多语言 66.0、Tau3-Bench 64.63,最低的一项是 Terminal-Bench 2.1 的 57.50 6。写这篇的人自己把口径放在文末和正文里各说了一遍:榜单与架构数据都来自官方模型卡,第三方尚未独立复测,数据截至 9 月 29 日;「已在客服工单场景上岗」这类表述来自官方发布与媒体报道 6。
同一台机器上,把 27B 换成 35B-A3B
这位作者有两张 RTX 5070 Ti 16GB(第二张挂在 OCuLink 扩展坞上)与 64 GB 内存,Ollama 跑在 Windows 上,agent 跑在 WSL 里。他每周用一个脚本去试新出的开源模型,跑两套自己搭的测试:一套是九步的长会话,包含工具调用、读文件、做一次判断,以及上下文压缩三次之后的记忆召回;另一套是十道小编码题。原来的主力 Qwen3.8 27B UD-Q4_K_XL 在 128K 上下文挂 MTP 时是 55 到 70 token 每秒,两套测试 9/9 与 10/10 7。
这一周脚本挑中的是 Ornith 1.5 35B-A3B(Ollama 里的 Q4_K_M):两套测试同样是 9/9 与 10/10;同期的 Laguna XS 2.1 也过了两套,North Mini Code 1.0 只拿到 4/9。差别在速度:128K 上下文下模型占 24.4 GB,完整压在两块卡上,生成约 180 token 每秒(两次分别 176 与 183),大约是原来 27B 的三倍 7。
速度的来源是他自己贴出来的架构:每个 token 只激活约 3B,256 个专家里用 8 个;41 层里只有 10 层是全注意力、2 个 KV 头,其余走线性注意力,于是 KV 缓存几乎不涨——128K 加到 256K 只多出约 2 GB。256K 也放得下,但因为有 1.2 GB 落到系统内存里(第一张卡还接着显示器),解码掉到约 139 token 每秒,所以他默认留在 128K 7。他在帖子末尾补的长上下文测试更极端:按模型卡把 YaRN 设成两倍、KV 用 q8,512K 能全放进两张卡,他在 41.9 万 token 的提示里、约 33.5 万处埋的那句备注被找到了,读的时候平均约 1060 token 每秒,在这个深度上生成约 35;再拉到 1M(四倍 YaRN、q4 KV),要放行 llama-server 把一部分专家挤到系统内存才装得下,84.9 万 token 的提示里 72 万处那句备注也找到了,但读一遍花了约 24 分钟,平均 570 token 每秒,生成约 16 7。
分歧那一栏有两处。第一处是他自己的测试已经打满:两套题都满分,所以这只能说明它不比原来的 27B 差,不能说明它更聪明;厂商给的 79(SWE-bench Verified)与 68.5(Terminal-Bench 2.1)他没有核,Artificial Analysis 也还没给它打过分 7。第二处是别人在同一批硬件上的读数并不一样:有人用一台 RTX 3090 把三个模型放在同一套本地编码任务上,说 Ornith 1.5 的 AWQ 版「自信地答错」,Qwen 3.6 35B-A3B 两比特约 160 token 每秒、快但偶尔会替自己的错误假设背书,Qwen 3.8 27B 三比特约 40 token 每秒、更谨慎,可在高档思考下想了 45 分钟一次工具调用都没发出来,作者由此得出「哪个模型最快」这个问题正在失去意义 13;另一条说在 8GB 的卡上、Q4、20 万以上上下文还能跑到 40 token 每秒,做法是把不活跃的 agent 挪到内存、只让活跃的留在显存,那个上下文下显存只占约 6 GB 14。同一张卡的并发读数则说明「峰值」两个字要看怎么聚合:有人在一台 DGX Spark 上按并发数给峰值吞吐,1 路 130、2 路 196、4 路 259、8 路 364、12 路 456、26 路 613、30 路 525,每一路都预留了完整的 262K 上下文 15。
还有一条读的时候要小心的例子:一条 X 帖子把同一个模型的分数写成「Qwen 3.8 27B (Ornith 1.5) 在同一指数上 34 分、全模型占 6GB 内存」,把 Ornith 1.5 挂在了 Qwen3.8 27B 的名字后面 16。昨天本栏目刚记过一次同类的事:一份日更把某个分数挂到了另一版模型名下。看到转述里的数字,先回原帖对一遍名字再读结论。
Loading content card…
8 GB 内存的家用 NAS:模型文件大小不等于运行占用
这位作者用的是一台最普通的家用配置:i3-7100、8 GB DDR4、机械硬盘,系统是飞牛 fnOS,没有独显,模型全部走 Ollama 容器跑 Q4 量化。他挑出五档可用的,速度和运行占用是这样的:Qwen 0.5B 文件 400 MB、20 token 每秒、运行占 1.2 GB;Qwen2.5 3B 文件 1.8 GB、12 token 每秒、占 2.5 GB;Phi-3 mini 3.8B 文件 2.3 GB、9 token 每秒、占 3 GB;Qwen2.5 7B 文件 4.7 GB、5 到 6 token 每秒、占 6.5 GB;Llama 3.1 8B 文件 5 GB、4 到 5 token 每秒、占 7 GB 8。
这一组最该拿走的是那两条提醒:模型文件大小不等于运行占用,8B 的 Q4 就是 8 GB 内存的硬件极限,再往上直接卡顿;作者的主力选择是 7B,因为它跑起来还剩 1.5 GB 左右给系统,不爆 Swap 8。要打折的地方也在文里:这是单台机器、两周的个人体验,评分是他自己的十分制,同一段文字里也承认 7B 的上下文只有 8K 到 32K、不支持多模态、文案偏模板化 8。
9.3B 的生图模型要 17 GB,而卡只有 8 GB
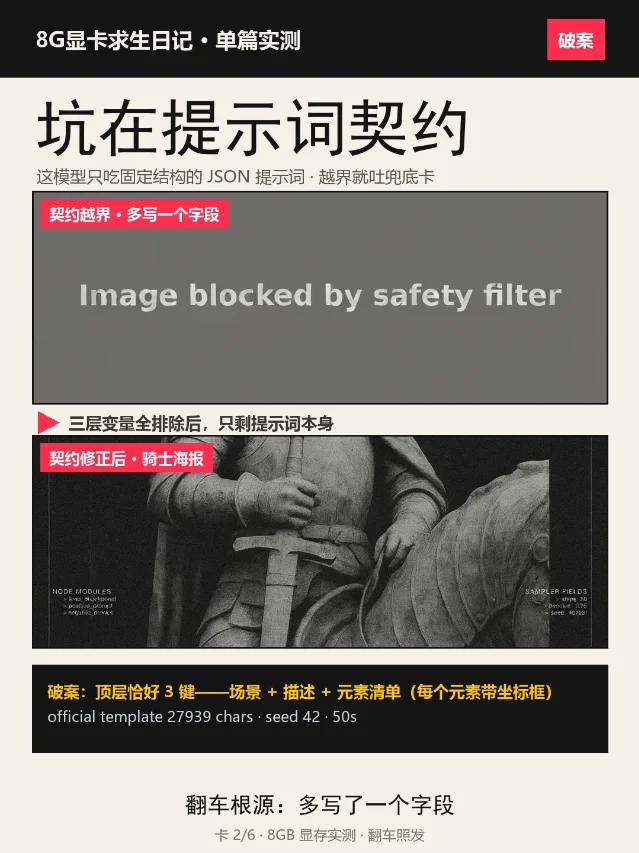
Ideogram 4 开源之后,官方给的显存门槛是 12 到 16 GB。这位作者手上只有一张 8 GB 的 RTX 5060 Ti,于是他先把体积账算清楚:9.3B 的模型带两份必须同时在场的权重(主模型与无条件模型),加编码器一共 17 GB,靠流式加载进场,出图时显存峰值 7.7 GB,没有 OOM 4。
装得下之后是出不了图。前三张全是写着「被安全过滤拦截」的灰色占位卡:换种子、换提示词、把编码器换成官方件,三次都拿到同一张。他把变量一层层排除,最后落到提示词本身——这个模型不吃普通提示词,它要求一段固定结构的 JSON(场景、背景、元素清单,每个元素带坐标框),多写一个字段或少写一段结构,模型就吐兜底卡;按官方模板把格式写全之后,骑士海报立刻出来 4。
速度账也一并在同一批图上量了(全部用同一个种子):1024 见方的二十步约 70 秒,与 Qwen-Image 2.1 同档;2048 见方要 683 秒,比 Qwen-Image 2.1 的 390 秒慢近一倍 4。强项确实在英文排版上:瑞士风杂志封面自评 9 分,指定四个十六进制色号出来分毫不差,坐标框在象限级全对,但具体元素会换座位、文字会自作主张转 90 度;中文那边小字全对,大标题丢了一个字而且变成了竖排。作者列的边界是:许可不可商用、小字会幻觉填充、只有文生图、中文排版依旧交给 Qwen-Image 2.1 4。
395M 的编码器:不写字,一次前向出概率
DecisionTune 1.0 是一个 395M 的决策模型:一个 ModernBERT-large 加上一个 4 KB 的打分头。它不生成任何文字,你给它一段状态、一个问题、一组选项,它做一次编码器前向,直接给出每个选项的概率,或者一个是非题的概率 9。
它要替掉的是 agent 一天里那些小判断:调哪个工具、工单进哪个队列、这条回复有没有回答问题。作者的本地读数是:M5 Pro 上用 MLX,短判断中位 9.6 毫秒、占 1.7 GB 显存;只用 CPU 约 65 毫秒、最多 4.5 GB;跑完整套 Decision Index 的一遍,中位 25.9 毫秒、p95 407.8 毫秒。权重 fp32 是 1.58 GB,上下文上限 8,192 token,超了直接拒绝、不做截断 9。
分数与短板都在同一段里:Decision Index 0.2.1 上 29.57(另一次换种子是 29.13),最强的一项是工具与自动化 46.5,比 0.9 预览版的 28.1 高;作者自己写明的边界是概率未校准、只认英文、在知识与数学上很弱、只会在你给的选项里选,问题问得含糊(「shipping」而不是「Shipping: delivery, lost or damaged packages」)结果就弱 9。跨后端的口径他也给了:在 2,755 个问题上,PyTorch 与 MLX 给出相同答案的比例是 99.85%;下载过一次之后完全离线,每个文件按 SHA-256 清单校验 9。权重与代码分开放在两个地方,许可为 Apache-2.0 17。
Loading content card…
今天能带走的三句话
第一句,先问这条链路上一次要搬多少。Mac mini 上 111 GB 的模型,专家从两块 SSD 上搬,合起来 12.3 GB/s 是上限,于是写一个 token 的时间里有一大段在等盘;同一个作者把热缓存放进 28 GiB 内存、命中七成五,这个数才站得住 12。
第二句,显存与内存的账面数字要按运行占用算。8 GB 的 NAS 上,5 GB 的模型文件要 7 GB 才跑得动;9.3B 的生图模型官方说 12 到 16 GB,实际是 17 GB 的权重加编码器;两张卡标称 16 加 10 GB,作者自己也不敢说这些都能用 4811。
References
- 1
- 2Reddit:解码里还有 27% 的时间在等专家从 SSD 进来
reddit.com
- 3Reddit:把 Qwen3.5 的 9B/27B INT4 搬进 FPGA 跑
reddit.com
- 4小红书:开源 Ideogram 4 翻车三次才出图,8GB 实测
xiaohongshu.com
- 5
- 6公众号 AI研习驿站:中国电信 Xing4.0-29B-A4B\
mp.weixin.qq.com
- 7
- 8公众号 人间一日闲:飞牛 NAS 本地部署大模型,8G 内存实测\
mp.weixin.qq.com
- 9
- 10GitHub:skeggsguy/Flash-next-ssd
github.com
- 11GitHub:5p00kyy/infermeld
github.com
- 12GitHub:Nero7991/llm.vhdl
github.com
- 13
- 14
- 15
- 16
- 17Hugging Face:decision-tune/decisiontune-1.0
huggingface.co
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.