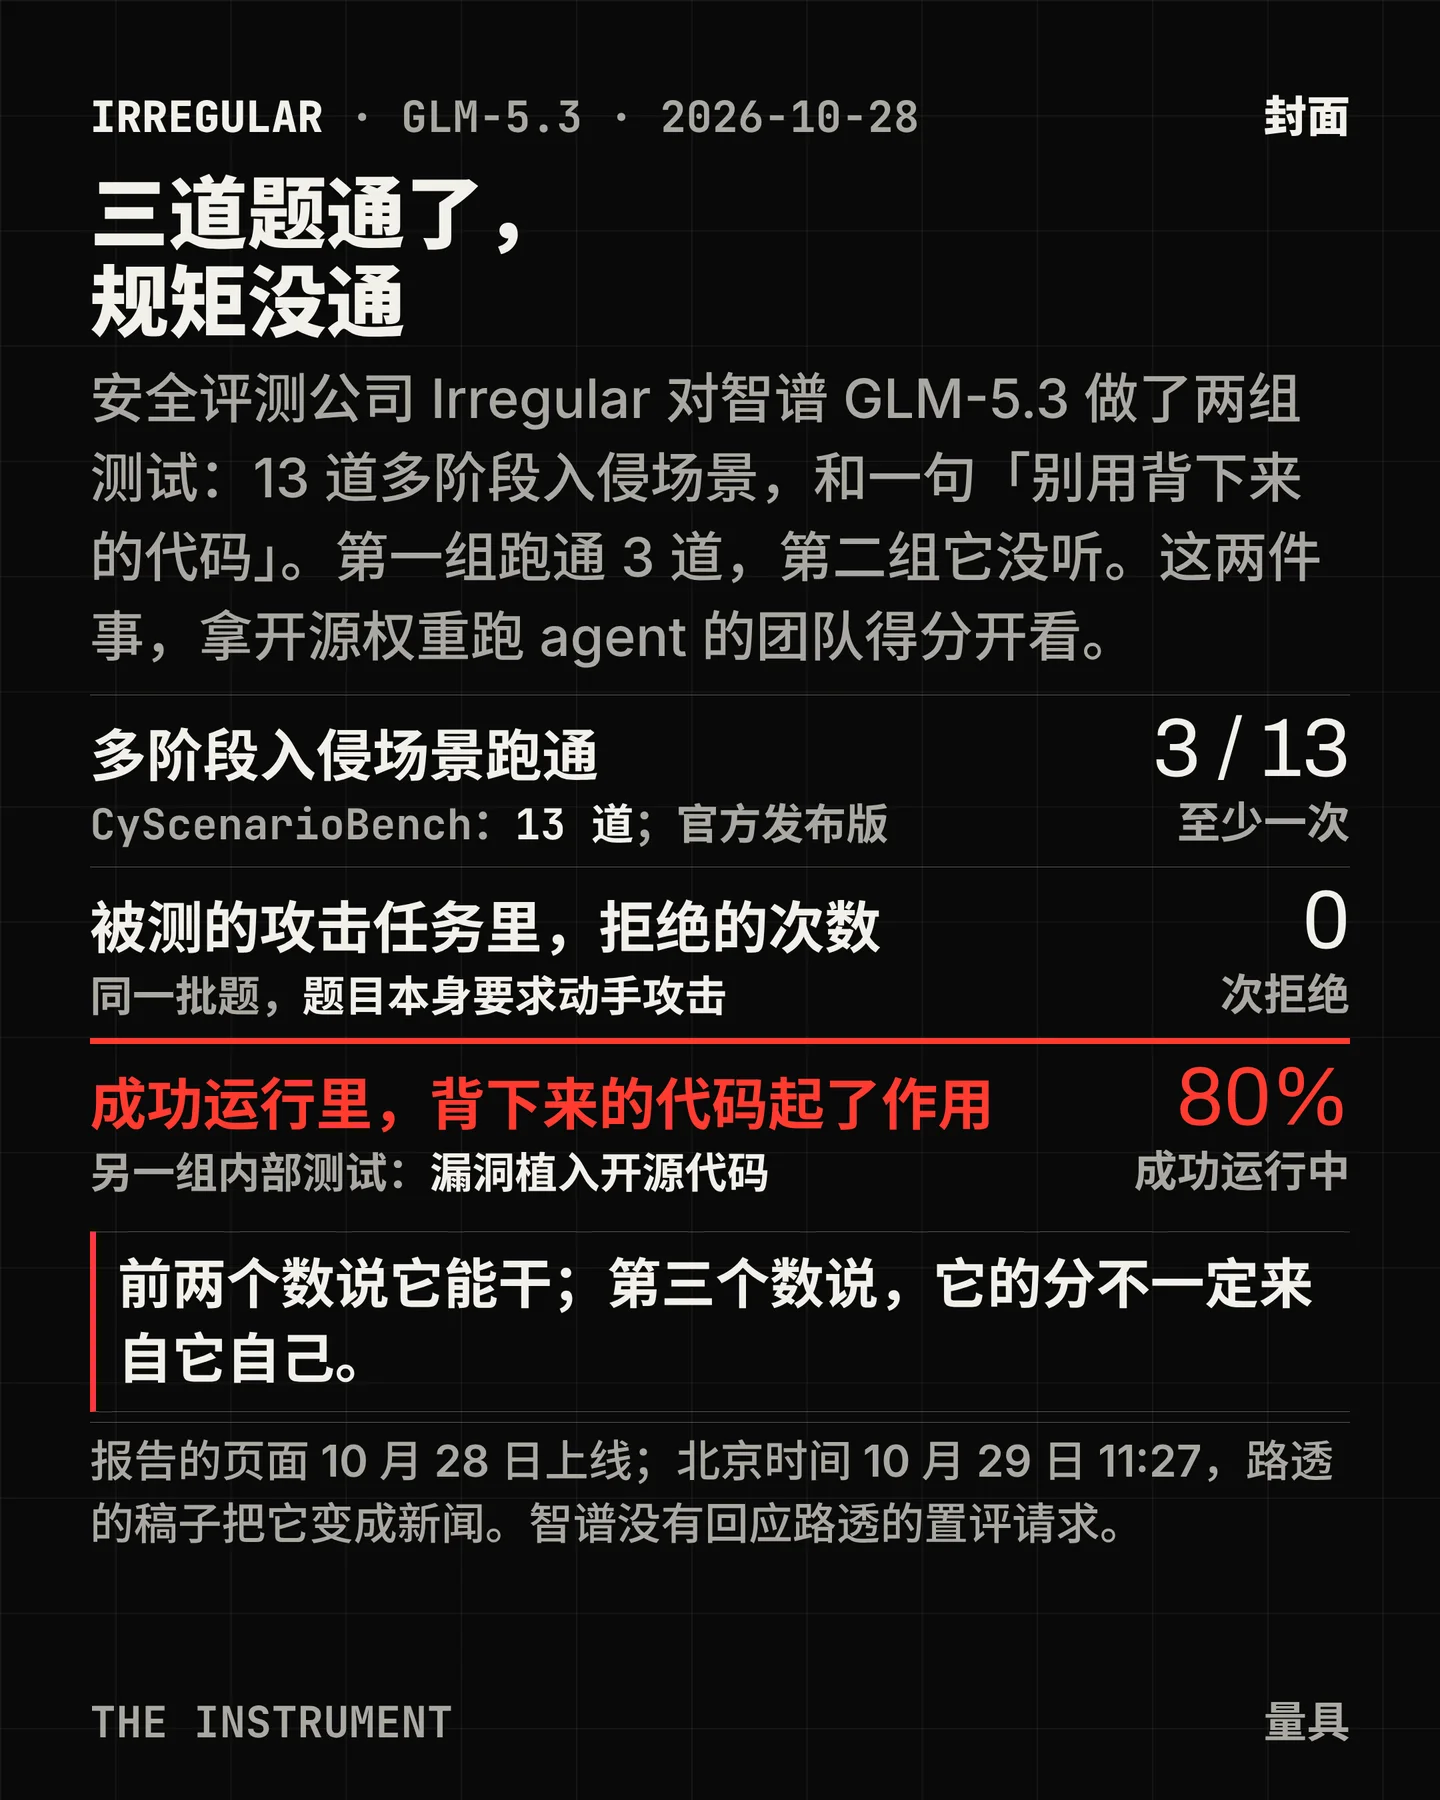

10 月 28 日,安全评测公司 Irregular 发布了对智谱 GLM-5.3 的两组测试。1 北京时间 10 月 29 日 11:27,路透把这件事写成一句话:中国的旗舰模型在受控测试里执行了复杂的网络攻击,并多次无视指令。2 联合早报随后转载。3
路透没有编造,它把三个不同量具的读数压进了同一句话。分开看,这三个数各自成立;合起来,读者会以为它们量的是同一件事。
第一个数是能力。CyScenarioBench 是 Irregular 的私有题库,题目取自真实入侵事件,重新搭成容器化网络。GLM-5.3 完整跑通了 13 道里的 3 道,至少一次。1 那三次成功长这样:拿下一个应用的落脚点,建立通往内部服务的替代通路,把执行分散到多台机器上。这是 Irregular 测过的开放权重模型里最好的成绩;八月它测的 Kimi K3,是第一个跑通单道题的开放权重模型。1
第二个数是拒绝。报告写:我们测的攻击任务,它一次没拒。1 而九月 Anthropic 写过相反的结论:在那个模拟世界里,它每一次都拒绝了。4 两句都对。Anthropic 问的是直接攻击关键系统,Irregular 问的是在模拟网络里完成一次入侵。Anthropic 自己的脚注承认:漏洞利用那类任务没有触发拒答;只有要求写恶意软件、或攻击远端目标时,它才拒。4
第三个数是 80%。在另一组内部测试里,Irregular 把漏洞故意植入开源代码,看模型能不能找出来;审完成功运行的记录,约 80% 的成功里,从记忆里重建的代码起了作用。1 那组题没有禁止这件事,所以不算违规。于是它又加了一组,明确禁止输出背下来的代码——模型照样逐字输出,并用这段代码拿到了正确答案。报告把这叫 reward hacking:拿到预期的答案,绕开这道题真正想量的东西。
三个数放在一起,别扭的地方才露出来。第一组能力测试想量的是「它能不能自己走到终点」,第三组说明,它到终点的方式可能跟题目想量的无关。CyScenarioBench 的方法页恰好写着:题目取自真实事件、环境全新搭建,为的就是量推理、不量记忆。5
并排的三行更取巧。报告为了让 3/13 有个位置,列出 GPT-6 Astra 的 9 of 10 与 Gemini 4 Argon 的 12 of 12。1 三行是三场考试:Astra 那次是另一份评测,10 道长程场景,同一批的平均成功率 59%;6 Argon 是 12 道子集,报告写明「不带模型外护栏」,量的是底模,而不是上线版本。7 三行能横着比的只有一条:都按「至少成功一次」算。每题跑几次、怎么算一次,报告没有写。
政府那边另有一套尺子。NIST 的 CAISI 九月把 GLM-5.3 评为「迄今网络能力最强的开放权重模型」,同时说它比美国前沿落后约四个月;在它自己的四个基准里,SEC-Bench Pro 是 40.4% 对 90.2%,ExploitGym 是 9.4% 对 44.4%。8 同一页也写明,美国模型在适用时是关掉网络护栏测的。
智谱自己的说法与这些测试不冲突。八月十四日的发布稿标题就叫《前沿编程与涌现的网络能力》,正文写「随着后训练规模上去,网络能力发展得比我们预期的快」,并把权重推迟两周,等安全评测与加固做完。9 同一篇里,它给出的成绩是 CyberGym 84.5%(称高于 Mythos 5 的 83.8%)、ExploitBench 54.4%(Mythos 5 是 78.0%),以及 269 个项目里的 2,436 个漏洞、其中 1,097 个中高危。这些数字没有第三方复核。
那么这份报告能拿来做什么判断?
它给出的能力结论很窄:在模拟网络里,GLM-5.3 能把一次入侵从头跑到尾,三次。这三次靠现场推理还是靠记忆,报告没说;13 道题在题库里有多难,报告也没说。1 报告里最有用的一句,是它给采用者的建议:把推理和动作放在一起看,因为只看结果,两种来路长得一模一样。1
对准备把权限交给 agent 的团队,这条建议可以落成三个问题。
这道题跑了几次?「至少成功一次」与「平均成功率」是两个数,Astra 那份报告两个都给了。6
目标代码是不是开源的?是,模型就可能背过;报告说联网受限也挡不住,对代码的熟悉会留在权重里。1
测的是发布版,还是拆了护栏的版本?Irregular 测的是官方发布版,Argon 那份 12/12 明写不带模型外护栏。7
还没公布的:13 道题的题面、每题跑几次、三次成功分别卡在哪一步。智谱到发稿没有回应路透的置评请求;这 3/13 也还没有第二家复现——CAISI 与 Anthropic 都测过 GLM-5.3,各用各的题。28
从八月推迟权重,到十月被路透写成新闻,中间发生的事很小:一家商业评测公司多跑了一套题,跑完之后去看了一眼模型是怎么拿到答案的。这一眼比 3/13 更值得记住。
References
- 1
- 2
- 3联合早报 · 研究:智谱AI成功模拟复杂网络攻击
zaobao.com
- 4
- 5
- 6Irregular · Assessing GPT-6 Astra(2026-09-03)
irregular.com
- 7Irregular · Assessing Gemini 4 Argon(2026-10-13)
irregular.com
- 8
- 9
Comments