
10 月 15 日,404 Media 的 Joseph Cox 发了一篇报道:他用五分钟在 ChatGPT 里投出一条广告,并且把这条广告投给了"正在问隐私、AI、聊天内容是否私密的人"。广告文案是"ChatGPT isn't private. OpenAI hires humans to read users' chats. Learn more",链向 404 Media 自己 9 月揭出 Project Lily 的那篇报道。一条攻击 OpenAI 隐私做法的广告,通过了 OpenAI 广告系统的审核,被展示给了它的用户。1
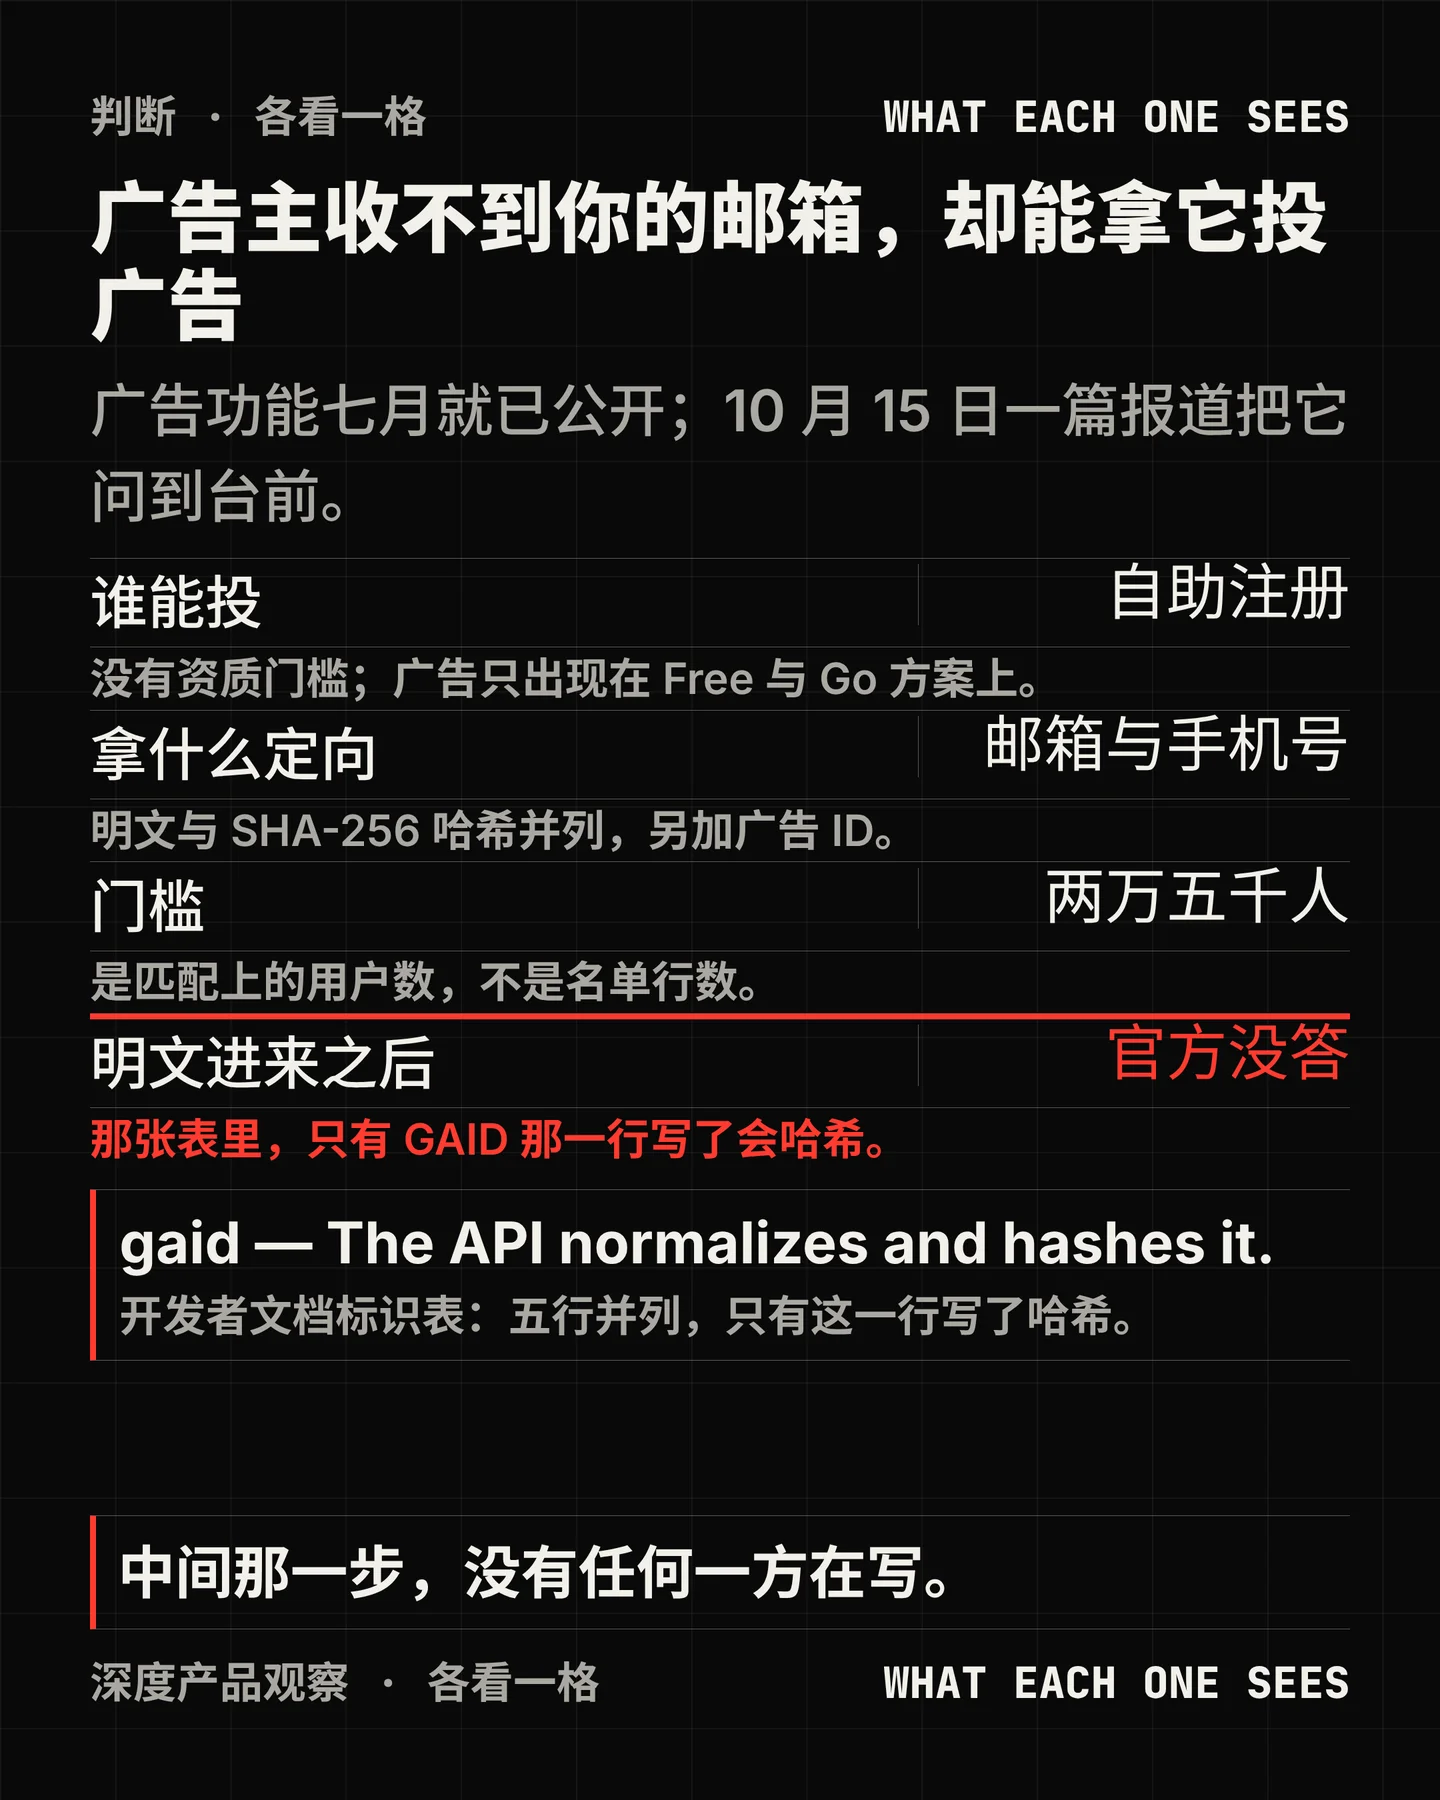
同一篇报道还讲了另一件事:OpenAI 允许广告主上传一份名单——邮箱、手机号或者安卓广告 ID——由平台判断这份文件里的人对应哪些 ChatGPT 用户,然后只把广告投给他们。
这两件事的分量不一样。第一件是一次实测,第二件的证据是官方产品文档。而真正值得读的,是官方文档把这件事写得比报道更清楚,同时在一处关键的地方没有写。
先把"新"这个字说准
自定义受众不是 10 月 15 日上线的功能。
帮助中心那一页最早的一次网页存档是 2026 年 7 月 28 日;开发者文档里那套受众接口最早的一次存档是 8 月 21 日;8 月 25 日,接口补上了新增、移除、替换与合并四类操作。到 8 月 31 日,OpenAI 公布广告业务年化收入十亿美元时,这份名单功能已经被当作既有能力写进了公告里。234
广告接口本身更早。开发者文档那一节最早的存档出现在 2026 年 5 月 6 日,和自助版 Ads Manager 上线同期。带日期的接口变更最后一次停在 9 月 30 日;面向市场的产品发布最后一次是 10 月 5 日——那天 OpenAI 开始测试"在图片生成结果旁边展示广告"的新格式,并公布了一批度量与归因合作方。56
10 月 5 日到今天,广告产品面没有新东西。所以这一天真正变的是两件别的事:一是这套名单功能第一次被推到普通读者面前;二是它被直接问了一个问题——广告主上传原始邮箱和手机号之后,OpenAI 会不会替广告主把这些值哈希掉。OpenAI 没有回答这个问题。1
发言人回答的是另外两件事:上传的文件在处理完成后会被删除,通常不超过 24 小时;以及"上了一个广告主的名单,本身并不会导致一条广告被展示"。1 这两句后来都能在帮助中心找到逐字对应的条款。
从一份 CSV 到一次展示
把广告主能做的事拆开看,是一条五步的流水线,四步写在公开文档里。
第一步,交名单。 广告主准备一份 UTF-8 的 CSV 或 TXT,上限 500 MB,单行一条记录。文件的表头可以是
email、phone_number、email_sha256、phone_number_sha256 或 gaid,一枚受众可以超过五百万条,不够就分批追加。这五种标识可以混在同一份文件里。78第二步,处理。 平台处理这份文件大约要二十到三十分钟,取决于文件大小。这里有一条容易被跳过的规定:上传的行数与最终匹配出的人数不是一回事,无效值、重复值、匹配不上的标识都不计入匹配人数。7
第三步,匹配。 平台判断这份文件里的哪些条目对应真实的 ChatGPT 用户。这一步产生的结果,只有平台自己有。
第四步,过门槛。 想用名单来"并入"(只投给这些人)或者做出价调整,匹配上的用户数至少要两万五千;低于这个数的名单只能用于"排除",也就是把人挡掉。官方还建议并入定向用十万以上的规模。7
第五步,展示。 广告出现在回答末尾,本月起也出现在图片生成结果旁边。这一步里还可以叠一层"上下文提示",让广告朝着某些话题去。5
广告主在这一整条链上看得见什么?官方文档写得很干净:受众是群体级的控制项,Ads Manager 不显示具体匹配到了哪些人,也不允许从名单里挑人。接口层面,成功响应里连匹配人数都不返回一个数,只有"区间"。78
这就解释了 404 Media 报道里那个数字为什么容易被读错。
两万五千人是"匹配上的人",不是"名单上的行"
404 Media 的报道把门槛写成"上传的名单必须超过 25,000 条"。官方的原文不是这样。帮助中心那一句是:并入受众和受众出价调整要求至少两万五千名匹配上的用户;低于两万五千匹配用户的受众只能用于排除。7
这个差别不是文字游戏,它决定了一份名单有没有用。一份二十万条的客户邮箱表,匹配率可能只有三成,结果还是够;一份三万条、但大多是企业通用邮箱的名单,匹配出来的可能远远不够,落到"只能排除"那一档,唯一的用处反而是把人挡在外面。
同一个数字还有一层:广告主看不到是谁被匹配上。官方条款在这一点上写得很直接——OpenAI 不保证受众可用、不保证匹配率、不保证受众规模、不保证覆盖与投放效果,甚至不保证"某一个人属于或不属于某个受众"。9
同一张标识表里的五行
这一层是本期真正要说清楚的地方。
OpenAI 的开发者文档里有一张标识表,五行并排:
email、phone_number、email_sha256、phone_number_sha256、gaid。前三行与后两行的差别写在同一个位置,那就是这一行进来之后平台会拿它怎么办。明文邮箱那一行,文档写的是"含有一个 @ 的邮箱地址。接口会去掉首尾空格并转成小写"。明文手机号那一行,写的是"E.164 格式的号码,含 + 与国家码"。两种哈希写法,写的是广告主要自己先算好 64 位十六进制摘要再上传。而 GAID 那一行写的是:"接口会把它规范化并哈希。"8
一份文档里,五行的说明长度差不多,位置也相同,唯独 GAID 这一行多了一句话。这句话讲的是平台自己会动手。另外四行没有这句话,其中两行(哈希邮箱、哈希手机号)本来也不需要——那两种值进来时就已经是哈希;剩下两行是明文的邮箱和手机号,文档只承诺去空格和转小写。
这不等于"官方说它不哈希明文"。一个人的沉默不等于一句话的否定。但它把 404 Media 那个问题为什么值得问,摆得很清楚了:同一张表里,恰好只有那一行写了。
同行把这一步写在同一个位置
把这一步放到行业里看,"平台接受明文"本身一点都不特别。
Meta 的广告主上传页面接受明文邮箱,页面上写着"在使用之前,Meta 会对这些信息做哈希"。Google 的 Customer Match 页面接受明文,并且写明"如果你选择以明文上传,文件里的私人客户数据会在你的电脑上用 SHA256 算法完成哈希,再安全地发往 Google 的服务器"。LinkedIn 的 CSV 接受"未哈希的普通邮箱地址",未哈希的部分在浏览器里完成哈希。TikTok 的帮助中心写着"TikTok 同时接受哈希值与原始值",以及"如果你的文件里是原始值或未哈希的值,它会被自动哈希"。X 的口径是"你可以选择是否预先哈希",如果不预先哈希,平台在"上传过程中自动哈希"。1011121314
六家里要求广告主自己在上传前先做哈希的,只有 Amazon 一家,它写的是"所有个人身份信息必须在上传前完成 SHA-256 哈希",并且补了一句"Amazon 不存储原始个人身份信息"。15
这就是为什么那五行值得逐字读。不是"接受明文"这件事特别——那几乎是行业默认;特别的是说与不说。同一个位置,别家写了自己会在哪一步动手,OpenAI 写了四行没有这句话,其中两行手里拿的是明文。
还有一个更细的分岔:接口路径与页面路径的要求经常不一样。Meta 的营销接口写着"你必须以哈希格式提交数据",并且只支持 SHA-256;Google Ads 的接口写着"通过 API 上传时,你的数据必须是哈希后的"。OpenAI 那套接口的说明,是这次逐字读下来唯一一处:明文列存在、哈希列也列着,而哈希那句话只挂在 GAID 上。
你手上那个开关的射程
用户在设置里能动的部分,官方文本写得很清楚,也很有限。
帮助中心那一页在解释"我们怎么决定给你看哪条广告"时,列的是这样一串信号:当前对话的语境与意图、广告的落地页、标题、文案、广告主提供的上下文提示与定向选择,以及——当广告个性化打开时——你更广泛的使用信号。16
关键在于这句话的结构。前面几项是无条件列出的,"广告主提供的上下文提示与定向选择"就站在这个无条件的位置上;那句"当广告个性化打开时"的条件,只加在最后一项上。
所以关掉个性化这件事的实际射程是可以逐字确定的。官方写的是:如果你关掉广告个性化,你仍然会因为当前这条对话的语境看到广告,但我们不会再使用其他对话、广告历史或话题来影响展示给你的广告。设置页面上另外还有一个"过往对话与记忆"开关,关掉之后,历史对话与记忆不再参与。16
官方还写明了两件容易误会的事。关掉个性化不等于不看广告——页面上的原话是,关掉个性化会让广告不那么贴合,但它不会移除广告;想完全不看广告要换方案。16 广告只出现在 Free 与 Go 两类方案上,Plus、Pro、Business、Enterprise 与 Edu 不看广告;被系统判定为未满十八岁的账号也不看广告。16
而读者最想问的那一句——广告主上传的那份名单,和这两个开关是什么关系——公开文本里没有一处把它们连起来。能查到的最近的一处,是广告工具条款:它要求广告主不得向 OpenAI 提供"已经选择退出、反对或撤回同意相关处理的个人的个人数据"。这句话把责任放在了广告主那一侧,而且它写的是"相关处理的同意",不是"广告个性化开关的位置"。17
那句话打开了一个合理的问题:如果一个人关掉了广告个性化,广告主怎么知道该把这个人从名单里去掉?条款没有回答。帮助中心也没有一个开关写着"不要用我的邮箱找到我"。
举证责任在谁那边
把条款读完,会看到一个很清楚的分工:OpenAI 在这件事上主要是收件方,而合规的举证责任被整体放在广告主那一侧。
广告工具条款要求广告主声明并保证:上传的受众数据是第一方数据,不是从数据经纪商、数据市场或其他第三方数据供应商买入、授权、接收或以其他方式获得的;上传方已经提供了所有必要的告知,并且取得了把这份数据提供给 OpenAI 所需的全部权利、同意、许可与合法依据;上传方不会提供被禁止的数据。9
"被禁止的数据"在同一份文件里有定义:与面向儿童的服务有关的数据、法律定义的敏感信息、以及可能构成健康数据的信息,涵盖性取向、跨性别或非二元身份、种族或族裔、宗教或哲学信仰、财务困境、工会成员身份、政治观点或党籍、公民或移民身份、犯罪受害者身份、基因或生物识别数据、残障状态等类别。9
值得注意的是三处细节。
一是数据处理附件的口径。附件把"通过受众工具匹配受众数据,以判断这份名单里哪些记录对应 OpenAI 的用户"定义为"受限处理",并且写明:只有在这种受限处理里,广告主是数据控制者、OpenAI 是数据处理者;其余情形下双方各自是独立的数据控制者。17 这个划分意味着匹配这一段在法律形态上是"替你做",而不是"和你一起做"。
三是执行方式。条款没有承诺 OpenAI 会核查这份名单的来路,只说广告主需要声明与保证;也没有承诺匹配率。品牌方要自己判断的是:手上这份 CSV 的每一行,当初是以什么名义收集的。
谁会受影响
投放广告的人。 这是第一个能同时拿到"一份具体的人"与"这一次对话的意图"的自助投放面,而且门槛不在名单长度上,在匹配人数上。增长团队该算的是一笔新账:手上的第一方名单,匹配出来到底有多少人。低于两万五千的名单在这套系统里只能用来排除,做不了并入。
产品与法务。 清单要多一条。过去问的是"这份数据能不能用于营销",现在还要问"这份数据能不能交给一个广告平台去做匹配"。这两问的答案不一定相同:前者看的是收集时的告知范围,后者看的是把数据交给第三方这件事在不在那个范围内。OpenAI 的条款把这件事的举证责任完整地放在上传方一侧。
用 ChatGPT 的人。 值得知道三件事:广告只出现在 Free 与 Go;设置里有两个开关,它们管的是历史与记忆;关掉它们不会减少广告的数量。另外还有一件事值得知道:广告主永远不会收到用户的对话、聊天记录、记忆、姓名、邮箱、精确位置、IP 地址或敏感信息——这是官方逐字写的,而它和"广告主可以上传你的邮箱"并不矛盾,因为这两件事的方向相反。16
在企业里管数据的人。 如果公司的 CRM 名单被投放过,或者员工的联系方式散落在各个业务系统里,那么"我的数据在哪些地方"这个问题的答案,比一年前多了一处。
还不能确定的
明文进来之后那一步,没有公开说明。 官方没有说它会不会把明文邮箱和手机号哈希掉、在哪个环节哈希、哈希之后保留什么。在同一张标识表里,只有 GAID 那一行写了平台会哈希。404 Media 直接问过,OpenAI 没有回答。18
关掉个性化是否覆盖名单匹配,没有公开说明。 官方那句信号清单把"广告主提供的定向选择"放在条件之外,条款又要求广告主不要上传已选择退出者的数据——两条放在一起,读者可以自己判断它们是不是同一件事,但公开文本没有把它们连起来。1617
这次实测证到哪一步,需要说清楚。 404 Media 的报道讲的是他们投了两条广告,用的是上下文提示定向;Cox 在自己帖子里写的是"我把广告投给了正在问隐私、AI、聊天是否私密的人",在他同日的付费通讯里,写的是"我在 ChatGPT 上做了自己的广告(没有使用他人的个人数据)来测试这套系统"。1819 也就是说,这次实测证明的是"一个没有投放经验的人可以把广告投进 ChatGPT 的会话里,并按话题去选人";按上传的邮箱或手机号去定向这件事,证据来自产品文档与广告后台里的选项,不是一次"上传名单、观察命中"的实测。要那样测,需要一份两万五千人以上、且能匹配上的名单。
没有人独立复核过这件事。 截至这篇文章写下的时刻,报道发出后的几个小时里,没有第二家媒体或机构发出独立验证或独立报道;404 Media 之外唯一一条公开摘要是聚合站的转述,而它把产品文档的存在写成了"404 Media 的测试发现"。20
投放规模只有第三方观测。 一个叫 ChatGPT Ad Library 的站点自称用真实消费者提问去探测 ChatGPT 并记录返回的赞助卡片,声称已收录至少 43,410 条素材、415,289 次投放、11,103 个广告主。这些数字是它自己的抓样,不是 OpenAI 的数据,也不是独立审计过的口径。21
这次的问题不是格式问题。 把邮箱和手机号交给一个广告平台做匹配,没有任何一条成文法要求必须先哈希。欧盟《通用数据保护条例》把假名化列为一种"适当的技术措施",而不是义务;美国联邦层面没有针对"上传个人身份信息做定向"的成文规则,联邦贸易委员会近两年的动作集中在敏感位置数据的数据经纪;加州的要求是"合理的安全程序",而邮箱与手机号本身在该法下并不属于"敏感个人信息"。真正有争议的一直是另一件事:同意覆盖到哪里,以及合法依据是什么。所以这一页最后落回的还是那个问题——不是"能不能传",而是"这一份能不能传"。
References
- 1
- 2
- 3ChatGPT Ads quietly added a custom audiences feature
grayvaultconsulting.com
- 4OpenAI Says Sponsored Chats Are The Future
adexchanger.com
- 5
- 6Testing ads in ChatGPT
openai.com
- 7Set up Custom Audiences for your Campaign
help.openai.com
- 8Custom Audiences – Ads
developers.openai.com
- 9Ad Tools Terms
openai.com
- 10About customer list custom audiences
facebook.com
- 11Create a Customer Match list by uploading a data file
support.google.com
- 12Contact list targeting in Campaign Manager
linkedin.com
- 13About Customer File audiences
ads.tiktok.com
- 14List Custom Audiences
help.x.com
- 15Ads Data Manager FAQ
advertising.amazon.com
- 16Ads in ChatGPT
help.openai.com
- 17OpenAI Ad Tools Data Processing Addendum
openai.com
- 18Joseph Cox 的帖子
x.com
- 19ChatGPT Ads Target Your Phone Number, Email
404media.co
- 20
- 21ChatGPT Ad Library
chatgptadlibrary.com

Comments