「接口超时了」和「这单到底成没成」,中间隔着那个几秒
超时是等的那一方自己掐的表,它只说了「我等够了」,没说这一单成没成;那个几秒由每一层各自定。三句话问清这次该重发、该先查,还是该去治慢。

上一篇的落点是:线程等不到东西的时候会超时。工程师说「这个接口超时了」,那个几秒是谁定的,没人往下说。
周三下午,群里先是一句:「支付接口超时了,刚才那三单都没回来。」
半分钟后跟一句:「我重试一遍。」
重试这个词,听起来像电梯按钮:按一下没反应,再按一下,不亏。
超时之后再按一下,可能亏掉一单。
先说清被超时的是什么。
接口是两台机器之间说好的一个约定:你到这个地址来、带上这几样东西,我按这个格式回你。
工程师嘴里的「下单接口」「支付接口」,指的就是一份这样的约定。
页面是给人看的,接口是给另一台机器用的。
一次按约定发出去的问话,叫一次请求。发出请求的那一头叫调用方,收下请求、负责给答案的那一头叫被调用方。
请求发出去之后,调用方要决定等多久。超时就是这条线:到点还没回话,就先不等了。
它回答的是「我等够了没有」。对方收没收到、做完没有,它一个字都没交代。
所以听到「接口超时了」,当天真正要定的是:这一单到底成没成,要不要再来一次。
问三句就够。
一、这个几秒是谁在等?
二、到点之后,它停手了吗?
三、再发一次,会不会做第二遍?
三句问完,处置落在三种里:让他安全地重发、先拦住去查这一次的结果、或者先别动,去查慢在哪。
01 掐表
超时这条线,是等的那一方画的。
被调用方不知道你在数秒。它收到的是一个请求,不是一只秒表。
AWS 的工程博客把这件事写得很平:超时是客户端等待请求完成的最长时间,他们的做法是对任何远程调用都设一个。1
「客户端」在这里就是发起调用的那一方,可能是你手机里的浏览器,也可能是另一台服务器。
和报错放在一起看,差别就出来了。报错是对方回了话,说这件事没做成。超时是对方一直没回话。
一个有人签字,一个连回执都没有。
所以「接口超时了」这句话,字面上只说了一件事:等的人先走了。
你会听到:「客户端设的 3 秒。」「600 毫秒没回来就算失败。」
问什么:这个几秒是哪一方设的?
02 各掐各的
一次点击背后,掐表的不止一个人。
页面等后端,后端等网关,网关等下游,下游等数据库,一层等一层。
后端是那些不直接给用户看页面、专门干活的程序。下游是行话,指一个服务转过头去问的下一层。数据库是存数据的地方,订单和余额最后都落在它那里。
网关是挡在这堆服务前面的那台机器:请求先到它手上,它再转给真正干活的那些。
Nginx 是最常见的一种网关。它转发请求时默认给连接 60 秒、给读响应 60 秒,到点就不等了。2
不等了,它回一个 504。规范里 504 的写法是:服务器作为网关或代理,没能在合理的时间内从上游服务器拿到回应。3
数据库那一层可以是另一个极端。PostgreSQL 的 statement_timeout 默认是 0,也就是不设上限,它压根没打算替谁掐表。4
所以同一个故障,你在三个地方听到三个不同的数:60 秒、3 秒、不设。它们各说各的表。
层与层之间有个要求:里面那层要比外面那层短。
外面先放弃、里面还在埋头干,你拿到的是一个空结果,那笔活还在继续。
你会听到:「网关返回 504 了。」「数据库那边根本没超时。」
问什么:这是哪一层在等,它等的是谁?
03 落空
到点之后,对方在干什么?
调用方走了,被调用方多半不知道。它按自己的节奏把活干完。
所以一次超时之后,真实发生的事是三种之一。
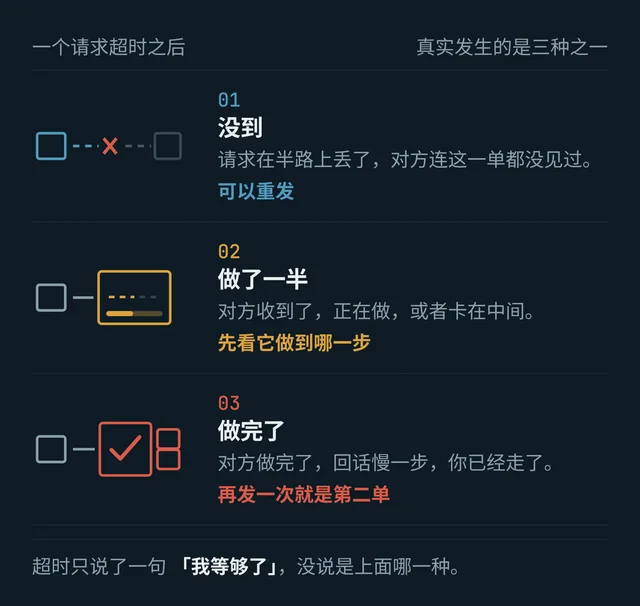
示意图由本文绘制。这三种结局当天只有一处能分清:服务端那份日志里,这次请求最后留下了什么。
第一种,请求没到。半路上丢了,对方什么都没做,重发是干净的。
第二种,到了,做了一半。比如款扣了,订单还没写进去。这时候重发,会撞上一个做了一半的局面。
第三种,到了,也做完了。它算完正准备回话,你这边到点走了。你手上没有任何凭证,那笔活是真的。
AWS 那篇的原话是:超时或失败,并不一定意味着没有产生副作用。1
副作用在这里的意思很朴素:它真的改动了什么,多了一单,或者少了一笔钱。
日志是机器自己记的流水账:谁来过、做了什么、什么时候。上面三种结局,在日志里各是一副样子。
你会听到:「日志里其实有一条成功的记录。」「用户说被扣了两次钱。」
问什么:这个请求在服务端最后是什么结果?
04 重来
重试的诱惑在于,故障常常是临时的。
AWS 的说法是:系统很少整体坏掉,多半是一部分请求失败,或者短时间里失败,重发一次就过去了。1
代价有两个。
第一个是放大。AWS 举过一个例子:一次点击一路往下调五层,每层都重试三次,最底下那层要挨 3 的 5 次方,243 次。1
第二个代价就是上一节说的第三种结局:活已经做完了,你再发一次,单就下了两单。
能安全重发的接口有个名字,叫幂等:同一个请求发一次和发三次,结果一样,副作用只发生一次。
只读的接口通常天然幂等,查一次和查三次,数据不会变。创建类的接口不一定,每发一次多一条。1
要让它安全,得有个记号。Stripe 的做法是让调用方带一个幂等键(Idempotency-Key):同一个键重发,服务端认出这是同一次请求,返回第一次的结果,不再做第二遍。这个键至少保留 24 小时。5
你会听到:「我重试了三次。」「这个接口加个幂等键吧。」
问什么:这个接口重试安全吗?有没有幂等键?
05 定数
那个几秒到底该怎么定?
AWS 给了一个能直接抄的做法:先定一个能接受的失败率,比如千分之一,再去查下游服务在这个分位上的耗时,拿它当超时。1
千分之一对应 p99.9:把这些调用按耗时从短到长排好队,取排在第 999 位那次的耗时。
定得太大,等待本身要占着东西。线程、连接都被这条慢调用按在手里。1
定得太小,一次抖动就会让一批请求同时超时,然后同时重试,把一个小问题放大成一场故障。1
调大超时买到的是「我多等一会儿」,慢的原因还在原处。
如果每次都卡在同一个数上,说明那一段本来就慢。表调长,用户等得更久,问题一点没动。
你会听到:「超时调到 60 秒先顶着。」
问什么:这个数是照着哪一段的耗时定的?
存下来当一张表
| 你听到的 | 多半指什么 | 你接着问 |
|---|---|---|
| 接口超时了 | 等的人先走了,对方做没做还不知道 | 这是哪一层在等?几秒是谁设的? |
| 网关返回 504 | 网关等上游等到自己的表到点 | 上游那一层自己超时了没有? |
| 数据库没超时 | 那一层压根没设上限 | 应用那层等它等多久? |
| 我重试一下 | 同一个请求再发一次 | 这个接口幂等吗? |
| 重试了三次 | 请求量按层数翻着番往上放大 | 重试加在哪一层? |
| 加个幂等键 | 让同一个请求只生效一次 | 键存在哪儿,留多久? |
| 超时调到 60 秒 | 等待变长,慢的原因还在 | 慢的是哪一段? |
怎么用
超时之后先问结果,再决定要不要重发。
结果说不清,就先别重发。让对方翻一眼服务端日志,或者用同一个幂等键去查那一次到底做了没有。
同一笔订单真被写了两遍,要按住它得回到数据存下来的那一步——下一层从那里讲起。
References
- 1AWS:超时、重试和抖动回退
aws.amazon.com
- 2Nginx:ngx_http_proxy_module
nginx.org
- 3RFC 9110:HTTP Semantics
rfc-editor.org
- 4PostgreSQL:Client Connection Defaults
postgresql.org
- 5Stripe:Idempotent requests
docs.stripe.com

This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.